Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Usługa Data Wrangler, narzędzie oparte na notesach do eksploracyjnej analizy danych, obsługuje teraz zarówno ramki danych Platformy Spark, jak i ramki danych pandas. Generuje on kod PySpark oprócz kodu w języku Python. Aby zapoznać się z ogólnym omówieniem platformy Data Wrangler, opisem sposobu eksplorowania i przekształcania ramek danych biblioteki pandas, odwiedź główny samouczek. W tym samouczku pokazano, jak używać narzędzia Data Wrangler do eksplorowania i przekształcania ramek danych platformy Spark.
Wymagania wstępne
Uzyskaj subskrypcję usługi Microsoft Fabric. Możesz też utworzyć konto bezpłatnej wersji próbnej usługi Microsoft Fabric.
Zaloguj się do usługi Microsoft Fabric.
Przełącz się na Fabric, używając przełącznika nawigacji w lewej dolnej części strony głównej.

Ograniczenia
- Niestandardowe operacje kodu są obecnie obsługiwane tylko dla ramek danych pandas.
- Wyświetlacz Data Wrangler działa najlepiej na dużych monitorach, chociaż można zminimalizować lub ukryć różne części interfejsu, aby pomieścić mniejsze ekrany.
Uruchamianie aplikacji Data Wrangler z wykorzystaniem ramki danych Spark
Ramki danych Spark można otwierać w narzędziu Data Wrangler bezpośrednio z notatnika Microsoft Fabric, przechodząc do tego samego monitu rozwijanej listy, w którym są wyświetlane ramki danych pandas. Lista aktywnych ramek danych Spark pojawia się w rozwijanej liście pod listą aktywnych zmiennych pandas.
Ten fragment kodu tworzy ramkę danych Spark z tych samych przykładowych danych, które są używane w samouczku pandas Data Wrangler:
import pandas as pd

# Read a CSV into a Spark DataFrame
sdf = spark.createDataFrame(pd.read_csv("https://raw.githubusercontent.com/plotly/datasets/master/titanic.csv"))
display(sdf)
Na karcie "Narzędzia główne" na wstążce notesu użyj opcji rozwijanej Data Wrangler, aby przeglądać aktywne DataFrames dostępne do edycji. Wybierz ten, który chcesz otworzyć w narzędziu Data Wrangler.
Wskazówka
Nie można otworzyć narzędzia Wrangler danych, gdy jądro notesu jest zajęte. Wykonanie komórki musi zakończyć działanie przed uruchomieniem programu Data Wrangler, jak pokazano na poniższym zrzucie ekranu.

Wybieranie przykładów niestandardowych
Usługa Data Wrangler automatycznie konwertuje ramki danych Platformy Spark na przykłady biblioteki pandas ze względu na wydajność. Jednak cały kod generowany przez narzędzie jest ostatecznie tłumaczony na PySpark podczas eksportowania z powrotem do notesu. Podobnie jak w przypadku dowolnej ramki danych biblioteki pandas, możesz dostosować domyślny przykład. Aby otworzyć niestandardowy przykład dowolnej aktywnej ramki danych z elementem Data Wrangler, wybierz z listy rozwijanej pozycję "Wybierz przykład niestandardowy", jak pokazano na poniższym zrzucie ekranu:

Spowoduje to uruchomienie wyskakującego okienka z opcjami określającymi rozmiar żądanej próbki (liczba wierszy) i metodę próbkowania (pierwsze rekordy, ostatnie rekordy lub zestaw losowy), jak pokazano na poniższym zrzucie ekranu:

Wyświetlanie statystyk podsumowania
Podczas uruchamiania Data Wrangler wyświetla się baner informacyjny powyżej siatki podglądowej. Ten baner wyjaśnia, że ramki danych platformy Spark są tymczasowo konwertowane na próbki biblioteki pandas, ale cały wygenerowany kod jest ostatecznie konwertowany na PySpark. Następnie użycie elementu Data Wrangler w ramkach danych platformy Spark nie różni się od używania ich w ramkach danych biblioteki pandas. Przegląd opisowy w panelu "Podsumowanie" zawiera informacje o wymiarach próbki, brakujących wartościach i więcej. Wybranie dowolnej kolumny w siatce Data Wrangler powoduje zaktualizowanie panelu "Podsumowanie" i wyświetlenie opisowych statystyk dotyczących tej konkretnej kolumny. Szybkie szczegółowe informacje o każdej kolumnie są również dostępne w nagłówku.
Wskazówka
Statystyki i wizualizacje specyficzne dla kolumny (zarówno w panelu "Podsumowanie", jak i w nagłówkach kolumn) zależą od typu danych kolumny. Na przykład histogram z grupowaniem danych dla kolumny liczbowej pojawi się w nagłówku kolumny tylko wtedy, gdy kolumna jest rzutowana jako typ liczbowy, jak pokazano na poniższym zrzucie ekranu.

Przeglądanie operacji czyszczenia danych
Listę kroków czyszczenia danych można znaleźć na panelu "Operacje". W panelu "Operacje" wybierz krok czyszczenia danych z monitem o podanie kolumny docelowej lub kolumn wraz z wszelkimi wymaganymi parametrami do ukończenia kroku. Na przykład monit o liczbowe skalowanie kolumny wymaga nowego zakresu wartości, jak pokazano na poniższym zrzucie ekranu:

Wskazówka
Możesz zastosować mniejszy wybór operacji z menu każdego nagłówka kolumny, jak pokazano na poniższym zrzucie ekranu:

Wyświetlanie podglądu i stosowanie operacji
Siatka Data Wrangler automatycznie pokazuje wyniki wybranej operacji, a odpowiedni kod automatycznie pojawia się w panelu poniżej siatki. Aby zatwierdzić przeglądany kod, wybierz pozycję "Zastosuj" w dowolnym miejscu. Aby usunąć podgląd kodu i wypróbować nową operację, wybierz pozycję "Odrzuć", jak pokazano na poniższym zrzucie ekranu:

Po zastosowaniu operacji siatka wyświetlania i podsumowanie statystyk usługi Data Wrangler zostaną zaktualizowane w celu odzwierciedlenia wyników. Kod pojawia się w bieżącej liście zatwierdzonych operacji znajdującej się w panelu "Kroki czyszczenia", jak pokazano na tym zrzucie ekranu:

Wskazówka
Zawsze można cofnąć ostatnio zastosowany krok. W panelu "Kroki czyszczenia" zostanie wyświetlona ikona kosza, jeśli umieścisz kursor na tym ostatnio zastosowanym kroku, jak pokazano na poniższym zrzucie ekranu:

Ta tabela zawiera podsumowanie operacji obsługiwanych obecnie przez usługę Data Wrangler:
| Operacja | Opis |
|---|---|
| Sortowanie | Sortowanie kolumny w kolejności rosnącej lub malejącej |
| Filtr | Filtruj wiersze na podstawie co najmniej jednego warunku |
| Zakoduj metodą one-hot | Utwórz nowe kolumny dla każdej unikatowej wartości w istniejącej kolumnie, co wskazuje obecność lub brak tych wartości w wierszu |
| Kodowanie jednokrotne z ogranicznikiem | Rozdzielanie danych kategorialnych i ich jednohotowe kodowanie przy użyciu ogranicznika. |
| Zmienianie typu kolumny | Zmienianie typu danych kolumny |
| Upuść kolumnę | Usuń co najmniej jedną kolumnę |
| Wybieranie kolumny | Wybierz co najmniej jedną kolumnę do zachowania i usuń resztę |
| Zmienianie nazwy kolumny | Zmienianie nazwy kolumny |
| Usuń brakujące wartości | Usuwanie wierszy z brakującymi wartościami |
| Usuwanie zduplikowanych wierszy | Usuwanie wszystkich wierszy, które mają zduplikowane wartości w co najmniej jednej kolumnie |
| Wypełnianie brakujących wartości | Zastąp komórki brakującymi wartościami nową wartością |
| Znajdowanie i zastępowanie | Zastąp komórki o dokładnym wzorcu dopasowania |
| Grupuj według kolumn i agreguj | Grupowanie według wartości kolumn i agregowanie wyników |
| Usuń odstępy | Usuń białe znaki od początku i końca tekstu |
| Podziel tekst | Dzielenie kolumny na kilka kolumn na podstawie ogranicznika zdefiniowanego przez użytkownika |
| Konwertowanie tekstu na małe litery | Konwertowanie tekstu na małe litery |
| Konwertowanie tekstu na wielkie litery | Konwertowanie tekstu na WIELKIE LITERY |
| Skalowanie wartości minimalnych/maksymalnych | Skalowanie kolumny liczbowej między wartością minimalną i maksymalną |
| Wypełnienie błyskawiczne | Automatycznie utwórz nową kolumnę na podstawie przykładów pochodzących z istniejącej kolumny |
Modyfikowanie wyświetlania
W dowolnym momencie możesz dostosować interfejs za pomocą karty "Widoki" na pasku narzędzi znajdującym się nad siatką wyświetlania Data Wrangler. Pozwala to ukryć lub pokazać różne okienka na podstawie preferencji i rozmiaru ekranu, jak pokazano na poniższym zrzucie ekranu:

Zapisywanie i eksportowanie kodu
Pasek narzędzi powyżej siatki wyświetlania Wrangler danych zawiera opcje zapisywania wygenerowanego kodu. Możesz skopiować kod do schowka lub wyeksportować go do notatnika jako funkcję. W przypadku ramek danych Spark cały kod wygenerowany na przykładzie pandas jest tłumaczony na PySpark, zanim wróci do notatnika. Przed zamknięciem narzędzia Data Wrangler wyświetlany jest podgląd przetłumaczonego kodu PySpark i udostępniana jest również opcja eksportowania pośredniego kodu pandas.
Wskazówka
Funkcja Data Wrangler generuje kod stosowany tylko podczas ręcznego uruchamiania nowej komórki i nie zastępuje oryginalnej ramki danych, jak pokazano na poniższym zrzucie ekranu:
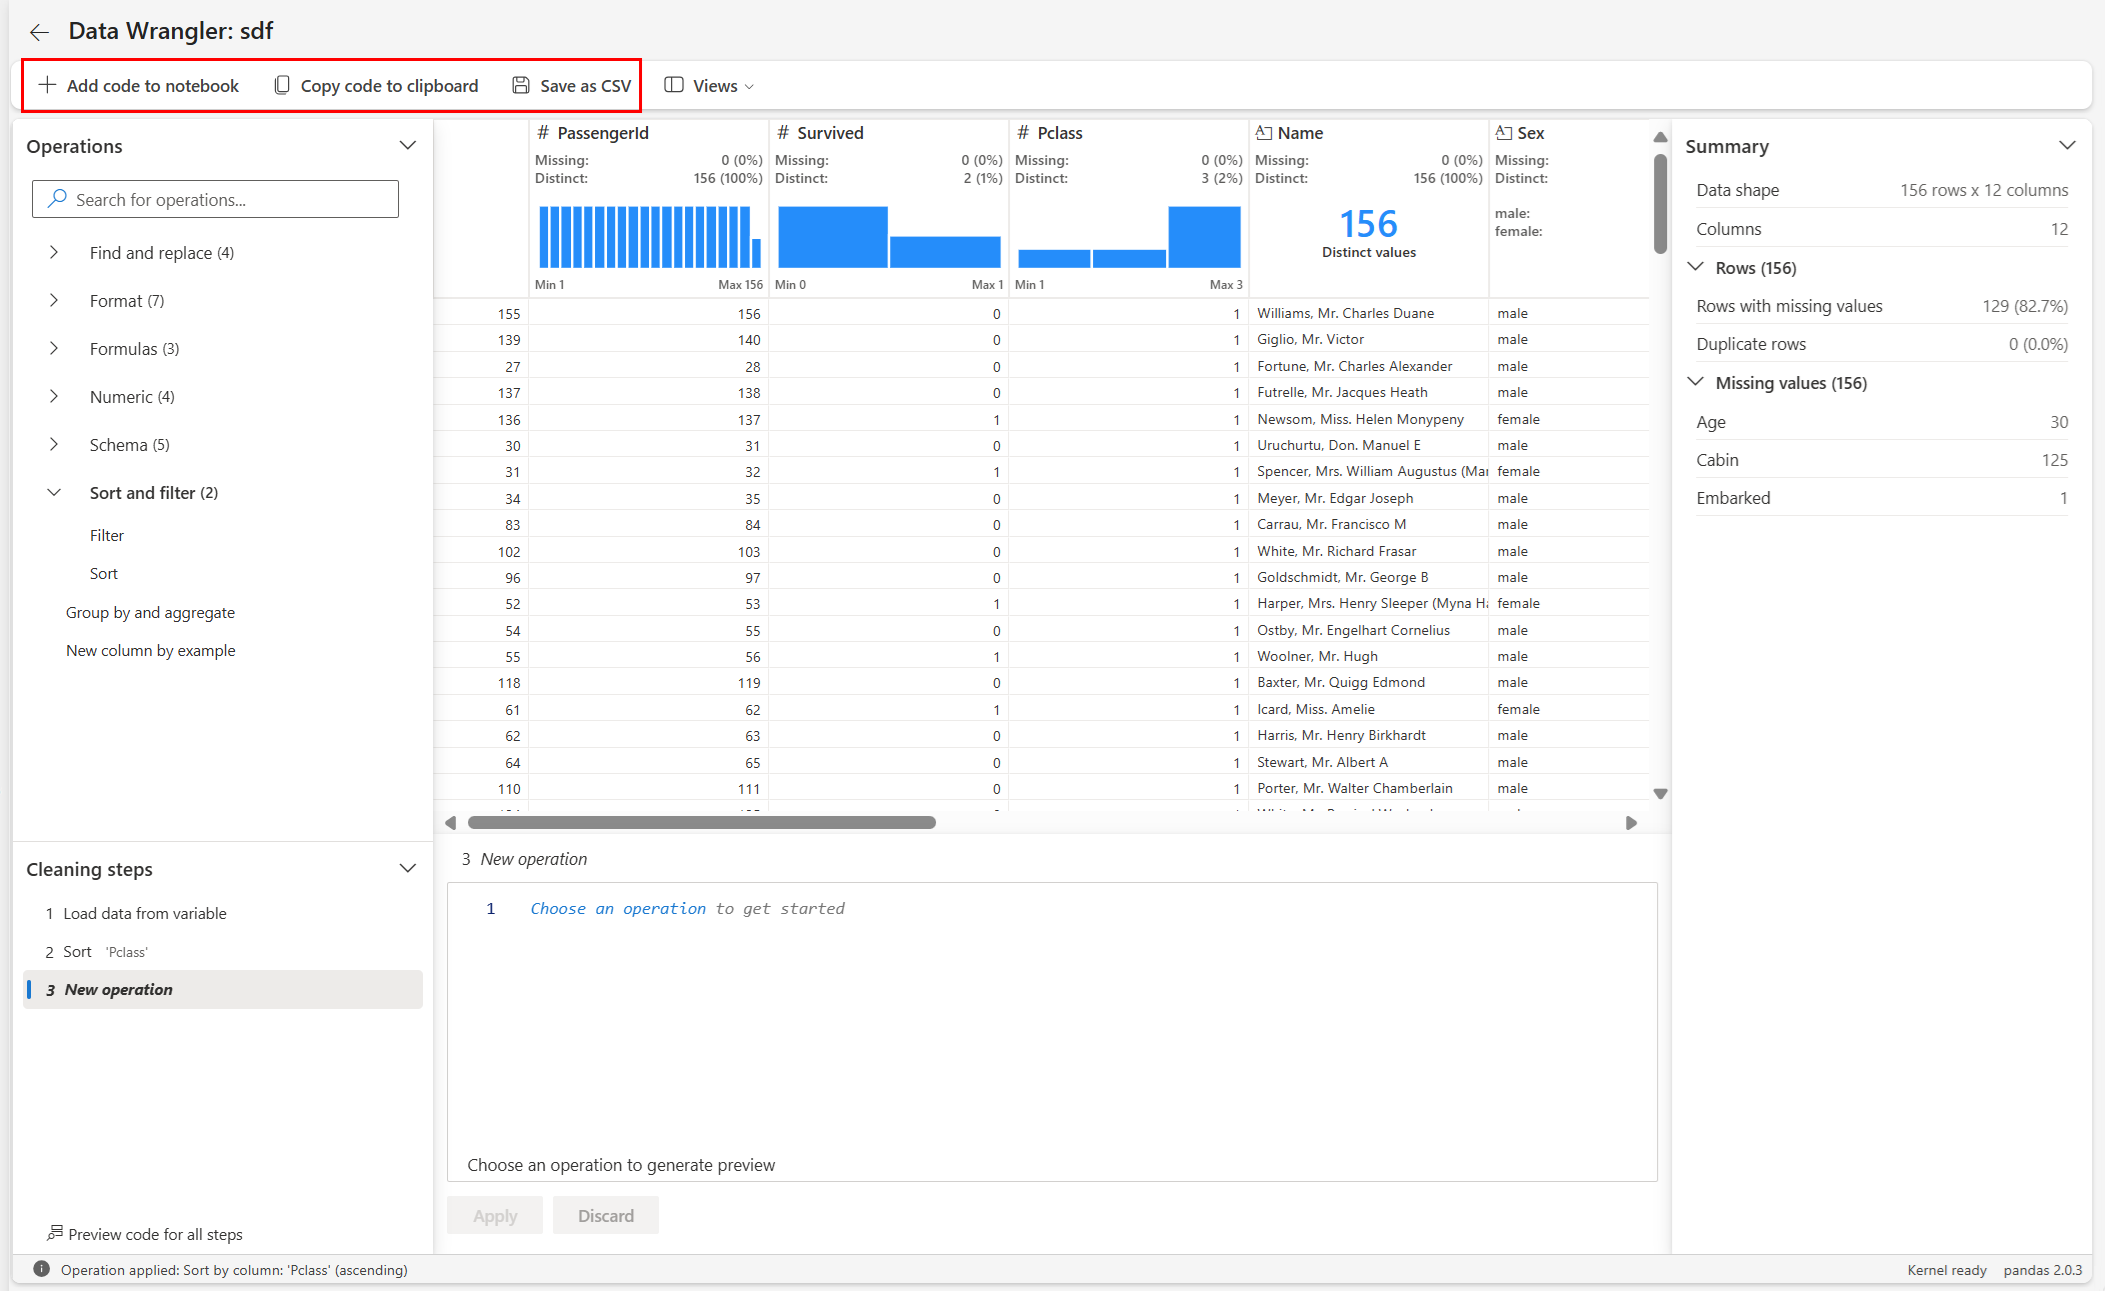
Kod jest konwertowany na PySpark, jak pokazano na poniższym zrzucie ekranu:

Następnie możesz uruchomić ten wyeksportowany kod, jak pokazano na poniższym zrzucie ekranu:

Powiązana zawartość
- Aby zapoznać się z omówieniem narzędzia Data Wrangler, odwiedź ten artykuł towarzyszący
- Aby wypróbować narzędzie Data Wrangler w programie Visual Studio Code, przejdź do tematu Data Wrangler w programie VS Code
- Czy brakowało nam potrzebnej funkcji? Powiedz nam o tym! Zasugeruj to na forum pomysłów Fabric