Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Antywzorce to praktyki, które wydają się korzystne, ale prowadzą do problemów z wydajnością, nieefektywności zasobów i potencjalnych awarii w przepływach pracy. Rozumiejąc i unikając tych antywzorców, można zoptymalizować przepływy w chmurze w celu uzyskania lepszej wydajności i niezawodności.
Unikaj zagnieżdżania pętli Dla każdego
Zagnieżdżone pętle Dla każdego mogą być operacjami intensywnie korzystającymi z zasobów w przepływach w chmurze i wpływać na wydajność oraz zużycie zasobów.
- Czas wykonywania: Zagnieżdżone pętle mogą szybko zwielokrotnić całkowitą liczbę iteracji. Na przykład, jeśli masz dwie pętle, każda z 10 iteracjami, całkowita liczba iteracji wynosi 10 x 10 = 100. Ten wykładniczy wzrost może wydłużyć czas wykonywania przepływu, zwłaszcza jeśli każda iteracja przetwarza duże zestawy danych lub wykonuje złożone operacje.
- Limity i przydziały: Power Automate wymusza limity i przydziały, takie jak maksymalna dozwolona liczba iteracji w pętli i ogólny czas wykonywania. Zagnieżdżone pętle mogą szybko zbliżyć się do tych limitów, co prowadzi do awarii przepływu lub ograniczania przepustowości, szczególnie w przypadku dużych zestawów danych lub częstych wykonań.
- Wpływ na wydajność: każda iteracja w zagnieżdżonej pętli zużywa moc obliczeniową i pamięć. Wraz ze wzrostem liczby iteracji wzrasta zapotrzebowanie na zasoby systemowe, potencjalnie spowalniając cały przepływ.
Więcej informacji: Współbieżność, limity pętli i dzielenia partii na elementy
W zależności od scenariusza można uniknąć pętli zagnieżdżonych, przetwarzając powiązane rekordy z tabeli nadrzędnej. Zaleca się uwzględnić następujące elementy:
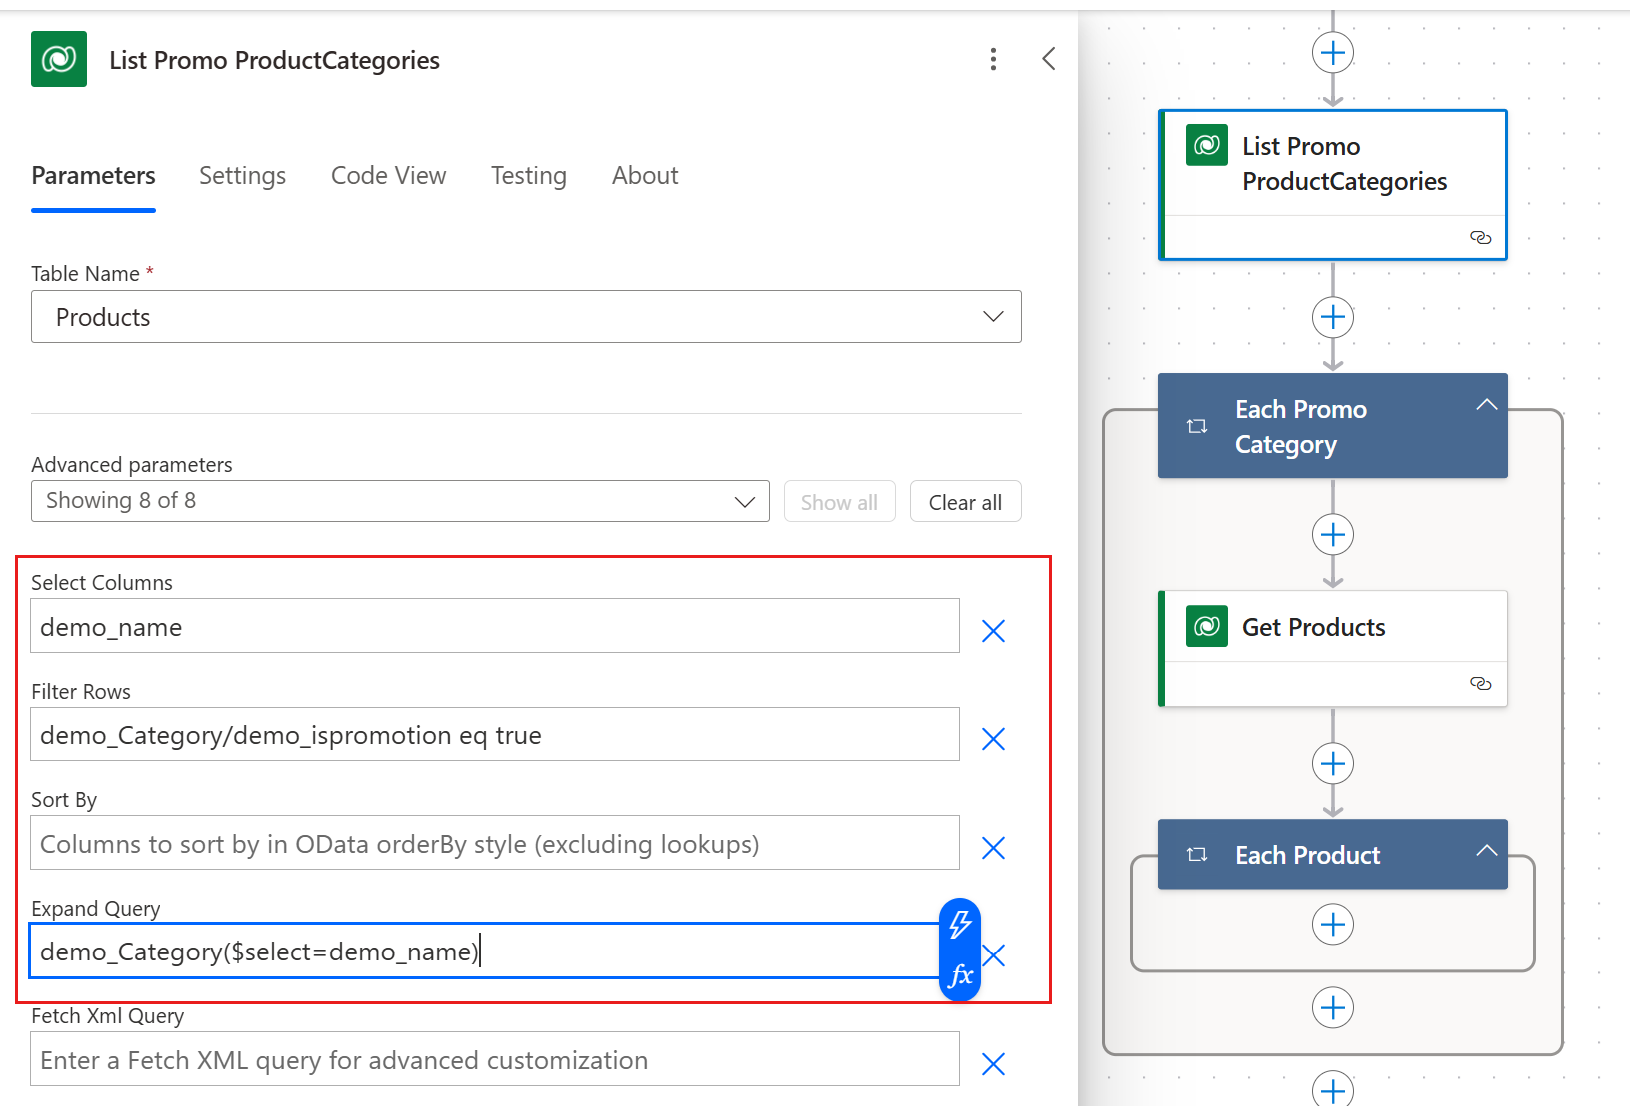
Scenariusz: Pętla zewnętrzna używa akcji Wyświetl wiersze w celu pobrania listy kategorii produktów z tabeli ProductCategory, w której kolumna IsPromotion ma wartość true. Następnie pętla wewnętrzna przetwarza powiązane rekordy z tabeli Product dla każdej kategorii pobranej przez pętlę zewnętrzną.
Alternatywne podejście: Użyj rozszerzenia zapytań OData, aby usprawnić ten proces. Ta metoda umożliwia pracę z pojedynczą pętlą For each, zmniejszając łączną liczbę żądań do Dataverse tylko jednego wywołania RetrieveMultiple .
Aby zaimplementować rozszerzanie zapytań OData:
- Użyj parametru Expand Query , aby określić nazwę kolumny wyszukiwania, która łączy tabelę ProductCategory z tabelą Product. Takie podejście powoduje pobranie powiązanych rekordów w ramach jednego zapytania. Na przykład ustaw parametr Expand Query na
Products($select=ProductName,Price). - Użyj parametru $select do ograniczania kolumn zwracanych z powiązanej tabeli.
- Pobieraj i przetwarzaj odpowiednie rekordy, stosując warunki bezpośrednio w kolumnach tabeli odnośników przy użyciu parametru Filtruj wiersze . Na przykład ustaw parametr Filtruj wiersze na
IsPromotion eq true.
Unikaj nieskończonych pętli
Przepływy Power Automate mogą być wyzwalane w nieskończoność, na przykład gdy przepływ aktualizuje tę samą tabelę, która go wyzwala.
Po zapisaniu przepływu, który może spowodować nieskończoną pętlę wyzwalania, Power Automate ostrzega Cię.

Unikaj nieskończonych pętli:
- Użyj warunków wyzwalania: Warunki wyzwalania zapewniają, że przepływ jest uruchamiany tylko wtedy, gdy zostaną spełnione określone kryteria, co zapobiega niepotrzebnym wykonaniom. Zaimplementuj warunki wyzwalacza, dodając warunek do wyzwalacza, aby sprawdzić określone wartości lub stany przed kontynuowaniem przepływu. Jeśli na przykład przepływ aktualizuje pole stanu, możesz ustawić warunek wyzwalacza, aby przepływ był uruchamiany tylko wtedy, gdy stan nie został jeszcze ustawiony na żądaną wartość.
- Zakończ przepływ: Alternatywnym podejściem jest zatrzymanie kontynuowania przepływu, jeśli wykryje warunek, który spowodowałby nieskończoną pętlę. Zakończ przepływ po spełnieniu określonego warunku przy użyciu akcji Zakończ. Takie podejście może służyć jako zabezpieczenie, aby zapobiec dalszym działaniom, jeśli przepływ ma wejść do nieskończonej pętli. Jeśli na przykład przepływ wykryje, że rekord został już przetworzony, może zakończyć swoje działanie, aby uniknąć ponownego przetwarzania.
Unikanie dużej liczby operacji przekształcania danych
Podczas pracy z przekształceniami danych na dużą skalę rozważ użycie procesu wyodrębniania, przekształcania i ładowania (ETL). Na przykład zamiast używać przepływu w Power Automate chmurze do odczytywania danych z dużego arkusza kalkulacyjnego programu Excel, wykonaj formatowanie lub walidację danych, a następnie wprowadź dane do Dataverse. Bardziej odpowiednie może być użycie Power Platform przepływów danych lub innego narzędzia ETL.
Przepływy danych efektywnie obsługują duże ilości danych i zapewniają lepszą wydajność zadań ETL niż przepływy w chmurze. Narzędzia ETL oferują wyspecjalizowane funkcje transformacji, walidacji i ładowania danych, które mogą uprościć złożone zadania przetwarzania danych.
Aby zarządzać ładowaniem danych za pomocą logiki aranżacji w przepływach w chmurze, połącz przepływy w chmurze z przepływami danych. Oto jak to zrobić:
Odświeżanie przepływów danych
- Akcja: użyj łącznika przepływu danych w Power Automate , aby wyzwolić akcję odświeżania i zainicjować proces ETL zdefiniowany w przepływie danych.
- Przykład: Skonfiguruj przepływ w chmurze, który wyzwala odświeżanie przepływu danych na podstawie harmonogramu (na przykład codziennie) lub zdarzenia (na przykład po przekazaniu nowego pliku do folderu SharePoint ).
Akcje po ETL
- Wyzwalacz: użyj wyzwalacza Po zakończeniu odświeżania Power Automate przepływu danych, aby wykonać akcje po zakończeniu procesu ETL.
- Przykład: Po zakończeniu przepływu danych użyj przepływu w chmurze, aby wysyłać powiadomienia, aktualizować rekordy lub wykonywać przetwarzanie danych.

Unikaj używania pętli Dla każdego do aktualizowania dużej liczby rekordów
Użytkownicy często muszą tworzyć lub aktualizować tysiące rekordów w źródle danych po wyzwoleniu Power Automate przepływu. Wielu użytkowników używa pętli Dla każdego do sekwencyjnego przetwarzania każdego rekordu, co powoduje opóźnienia i zwłok.
Aby poprawić wydajność, wypróbuj następujące dwa podejścia:
Operacje wsadowe
- Opis: Tworzenie lub aktualizowanie rekordów w wsadach. Wiele łączników i usług udostępnia punkty końcowe interfejsu API, które obsługują żądania wsadowe. Takie podejście umożliwia grupowanie wielu operacji w jednym żądaniu HTTP.
- Implementacja: Użyj funkcji operacji wsadowej, aby wysłać wiele żądań utworzenia lub aktualizacji jednocześnie. Te operacje są wykonywane sekwencyjnie w kolejności określonej w żądaniu wsadowym. Kolejność odpowiedzi jest zgodna z kolejnością żądań w operacji wsadowej.
- Korzyści: Zmniejsza liczbę pojedynczych żądań wysyłanych do źródła danych, minimalizując opóźnienia i poprawiając wydajność.

Równoległość w pętli Dla każdego
- Opis: Włącz przetwarzanie równoległe w pętli Dla każdego , aby obsługiwać wiele rekordów jednocześnie.
- Implementacja: Skonfiguruj pętlę Dla każdego tak, aby przetwarzała do 50 rekordów równolegle. Takie podejście jest przydatne w przypadku usług, które nie obsługują operacji wsadowych.
- Korzyści: Znacznie skraca całkowity czas przetwarzania dzięki jednoczesnej obsłudze wielu rekordów.
Aby uzyskać informacje na temat wykonywania żądań wsadowych, zapoznaj się z następującą dokumentacją interfejsu API REST:
Użyj operacji zbiorczych w Dataverse
Podczas pracy z Dataverse można używać internetowych interfejsów API operacji zbiorczych w celu zmniejszenia liczby wymaganych akcji, usprawnienia procesów i zwiększenia wydajności.
Internetowe interfejsy API operacji zbiorczych oferują wyraźną przewagę nad operacjami wsadowymi. Oto, czym się różnią:
- Operacje wsadowe: Mimo że operacje wsadowe są księgowane w jednym żądaniu, są wykonywane jako wiele pojedynczych operacji. Każda operacja w ramach operacji wsadowych jest przetwarzana oddzielnie.
- Operacje zbiorcze: Z kolei operacje zbiorcze są księgowane i wykonywane jako pojedyncza operacja. Całe żądanie zbiorcze jest liczone jako jedna operacja, co może znacznie zmniejszyć liczbę akcji i poprawić wydajność.
Aby wywołać operacje zbiorcze:
- Użyj protokołu HTTP z identyfikatorem Microsoft Entra : Internetowy interfejs API operacji zbiorczych można wywołać przy użyciu żądań HTTP uwierzytelnionych przy użyciu Microsoft Entra identyfikatora.
- Użyj łącznika HTTP z głównymi usługami: alternatywnie możesz użyć łącznika HTTP podczas Power Automate pracy z głównymi usługami, aby wywołać te interfejsy API.
W tym przykładzie przygotowujemy rekordy w formacie JSON przy użyciu akcji Wybierz :

Następnie użyjemy protokołu HTTP z identyfikatorem Microsoft Entra , aby opublikować żądanie przy użyciu internetowego interfejsu API CreateMany:

Jeśli masz 100 rekordów w danych wyjściowych JSON, takie podejście wiąże się tylko z jedną akcją zamiast 100 akcji Utwórz wiersz w Dataverse.