Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Dotyczy: Program SQL Server w systemie Linux
W tym artykule wyjaśniono koncepcje związane z wystąpieniami klastra failover SQL Server w systemie Linux.
Aby utworzyć SQL Server FCI na Linuksie, zobacz Konfiguruj instancję klastra awaryjnego na Linuksie (RHEL).
Warstwa klastrowania
W Red Hat Enterprise Linux (RHEL) warstwa klastrowania opiera się na dodatku RHEL HA.
Note
Dostęp do dodatku Red Hat HA i dokumentacji wymaga subskrypcji.
W systemie SUSE Linux Enterprise Server (SLES) warstwa klastrowania jest oparta na rozszerzeniu SUSE Linux Enterprise High Availability Extension (HAE).
Aby uzyskać więcej informacji na temat konfiguracji klastra, opcji agenta zasobów, zarządzania, najlepszych rozwiązań i zaleceń, zobacz SUSE Linux Enterprise High Availability Extension 15.
Zarówno dodatek RHEL HA, jak i SUSE HAE są zbudowane na Pacemaker.
Jak pokazano na poniższym diagramie, pamięć masowa jest przedstawiana dwóm serwerom. Składniki klastrowania — Corosync i Pacemaker — koordynują komunikację i zarządzanie zasobami. Jeden z serwerów ma aktywne połączenie z zasobami magazynu i programem SQL Server. Gdy program Pacemaker wykryje awarię, składniki klastrowania są odpowiedzialne za przeniesienie zasobów do innego węzła.
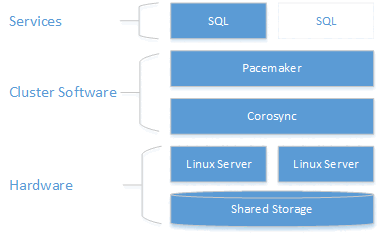
Integracja SQL Server z Pacemakerem na Linuksie nie jest tak sprzężona jak z Windows Server Failover Clustering (WSFC) na Windows. Program SQL Server nie ma wiedzy na temat obecności klastra. Cała orkiestracja odbywa się z zewnątrz do wewnątrz, a usługa jest kontrolowana jako autonomiczne wystąpienie przez Pacemaker. Ponadto nazwa sieci wirtualnej jest specyficzna dla usługi WSFC, która nie ma odpowiednika w aplikacji Pacemaker. Oczekuje się, że @@SERVERNAME i sys.servers zwróci nazwę węzła, podczas gdy dynamiczne widoki zarządzania sys.dm_os_cluster_nodes klastrem i sys.dm_os_cluster_properties nie zwracają żadnych rekordów. Aby użyć parametry połączenia wskazujący na nazwę serwera i nie używać adresu IP, muszą zarejestrować na swoim serwerze DNS adres IP użyty do utworzenia wirtualnego zasobu IP (jak wyjaśniono w kolejnych sekcjach) z wybraną nazwą serwera.
W wersji SQL Server 2025 (17.x) z Cumulative Update (CU) 3 i nowszymi, nowy agent Pacemaker HA v2 jest dostępny dla Red Hat Enterprise Linux (RHEL) i Ubuntu w mssql-server-ha pakiecie.
Agent Pacemaker HA w wersji 2 wprowadza ulepszenia niezawodności i wydajności w porównaniu do wcześniejszego agenta, w tym:
Zwiększona wydajność przełączania awaryjnego w celu skrócenia zarówno planowanych, jak i nieplanowanych czasów przełączania.
Obsługa elastycznych zasad automatycznego failoveru, w tym konfiguracji limitu czasu testu kondycji i poziomu warunku awarii.
Obsługa protokołu TLS 1.3 na potrzeby komunikacji między klastrem Pacemaker i programem SQL Server.
Agent pacemaker HA v2 jest obecnie w wersji zapoznawczej. Istniejący agent pacemaker HA (wersja 1) pozostaje w pełni obsługiwany w przypadku wdrożeń produkcyjnych.
Liczba wystąpień i węzłów
Jedną z kluczowych różnic w programie SQL Server w systemie Linux jest to, że może istnieć tylko jedna instalacja programu SQL Server na serwer z systemem Linux. Instalacja ta nazywana jest instancją. W przeciwieństwie do Windows Server, który obsługuje do 25 FCI na WSFC, FCI oparte na Linuksie będzie miało tylko jedną instancję. To pojedyncze wystąpienie jest również wystąpieniem domyślnym; w systemie Linux nie ma pojęcia o nazwanym wystąpieniu.
Klaster Pacemaker może mieć maksymalnie 16 węzłów, gdy jest zaangażowany program Corosync, więc pojedynczy interfejs FCI może obejmować maksymalnie 16 serwerów. Wystąpienie klastra trybu failover zaimplementowane przy użyciu programu SQL Server w wersji Standard Edition obsługuje maksymalnie dwa węzły klastra, nawet gdy klaster Pacemaker może mieć do 16 węzłów.
W SQL Server FCI instancja SQL Server jest aktywna tylko na jednym węźle naraz.
Adres IP i nazwa
W klastrze Pacemaker systemu Linux każdy węzeł FCI programu SQL Server potrzebuje własnego unikatowego adresu IP i nazwy. Jeśli konfiguracja FCI obejmuje wiele podsieci, wymagany jest jeden adres IP na podsieć. Unikatowa nazwa i adresy IP są używane do uzyskiwania dostępu do instancji klastra trybu failover, dzięki czemu aplikacje i użytkownicy końcowi nie muszą wiedzieć, który serwer węzłowy klastra Pacemaker.
Nazwa FCI w DNS powinna być taka sama jak nazwa zasobu FCI, który zostanie utworzony w klastrze Pacemaker. Zarówno nazwa, jak i adres IP muszą być zarejestrowane w systemie DNS.
Wspólna pamięć
Wszystkie wystąpienia klastrów trybu failover , niezależnie od tego, czy znajdują się w systemie Linux, czy Windows Server, wymagają jakiejś formy magazynu udostępnionego. Ta pamięć jest dostępna dla wszystkich serwerów, które mogą obsługiwać FCI (klaster trybu failover), ale w danym momencie tylko jeden serwer może używać pamięci dla FCI. Dostępne są następujące opcje dla magazynu współdzielonego w systemie Linux:
- iSCSI
- Sieciowy system plików (NFS)
- Blok komunikatów serwera (SMB)
W systemie Windows Server dostępne są nieco inne opcje. Jedną z opcji, które nie są obecnie obsługiwane w przypadku instancji klastrowania trybu failover opartych na systemie Linux, jest możliwość korzystania z dysku lokalnego węzła dla tempdb, który jest tymczasowym obszarem roboczym programu SQL Server.
W konfiguracji obejmującej wiele lokalizacji to, co jest przechowywane w jednym centrum danych, musi być synchronizowane z innymi. W przypadku przejścia w tryb failover interfejs fcI może przejść do trybu online, a magazyn jest postrzegany jako taki sam. Osiągnięcie tego celu wymaga pewnej zewnętrznej metody replikacji magazynu, niezależnie od tego, czy odbywa się to za pośrednictwem podstawowego sprzętu magazynu, czy narzędzia opartego na oprogramowaniu.
Note
W przypadku SQL Server, wdrożenia oparte na Linuksie, wykorzystujące dyski prezentowane bezpośrednio serwerowi, muszą być sformatowane jako XFS lub ext4. Inne systemy plików nie są obecnie obsługiwane.
Proces udostępniania pamięci masowej jest taki sam dla wszystkich obsługiwanych metod:
- Skonfiguruj magazyn udostępniony
- Zamontuj magazyn jako folder na serwerach, które będą pełnić rolę węzłów klastra Pacemaker dla wystąpienia klastra trybu failover (FCI)
- W razie potrzeby przenieś systemowe bazy danych programu SQL Server do magazynu udostępnionego
- Testowanie działania programu SQL Server z każdego serwera połączonego z magazynem udostępnionym
Jedną z głównych różnic w programie SQL Server w systemie Linux jest to, że chociaż można skonfigurować domyślne dane użytkownika i lokalizację pliku dziennika, systemowe bazy danych muszą zawsze istnieć w /var/opt/mssql/datalokalizacji . W systemie Windows Server masz możliwość przenoszenia systemowych baz danych, w tym tempdb. Ten fakt wpływa na sposób, w jaki konfigurowany jest współdzielony magazyn dla instancji klastra trybu awaryjnego.
Domyślne ścieżki dla niesystemowych baz danych można zmienić za pomocą mssql-conf narzędzia . Aby uzyskać informacje o zmianie domyślnych danych, zobacz Zmień domyślne dane lub lokalizację katalogu log. Możesz też przechowywać dane SQL Server i logi transakcji w innych miejscach, o ile mają odpowiednie zabezpieczenia, nawet jeśli nie jest to domyślna lokalizacja; lokalizacja musi być określona.