Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Dotyczy do: SQL Server 2016 (13.x) i nowsze wersje Azure SQL DatabaseAzure SQL Managed InstanceSQL database in Microsoft Fabric
Wirtualizacja danych umożliwia uruchamianie zapytań Transact-SQL (T-SQL) na danych zewnętrznych bez ładowania ich do bazy danych. Zdefiniujesz zewnętrzne źródło danych, opcjonalny format pliku i tabelę zewnętrzną, a następnie wykonasz zapytanie względem tabeli zewnętrznej, tak SELECT jak każda inna tabela.
Ten przewodnik ułatwia:
- Dowiedz się, które funkcje PolyBase są obsługiwane przez Twoją platformę SQL i wersję.
- Wybierz między
OPENROWSET, tabelami zewnętrznymi lubBULK INSERTna potrzeby wykonywania zapytań lub pozyskiwania danych. - Postępuj krok po kroku, używając dostępnych linków w typowych scenariuszach.
- Zapoznaj się z wydajnością, rozwiązywaniem problemów i najlepszymi rozwiązaniami dotyczącymi obciążeń produkcyjnych.
Obsługa platformy
- PolyBase to funkcja Microsoft SQL Database Engine, która implementuje wirtualizację danych.
- PolyBase jest wspierany w wersjach SQL Server 2016 i nowszych na Windows oraz w SQL Server 2019 i późniejszych wersjach na Linuksie.
- PolyBase nie jest wspierany w SQL Server 2017 na Linuksie.
- PolyBase nie jest wspierany w Azure SQL Database, ale Azure SQL Database oferuje powiązane możliwości wirtualizacji danych poprzez
OPENROWSETi zewnętrzne tabele. Aby uzyskać więcej informacji, zobacz Wirtualizacja danych z użyciem Azure SQL Database (wersja zapoznawcza). - PolyBase nie jest funkcją w Azure SQL Managed Instance z nazwy, ale Azure SQL Managed Instance ma funkcje wirtualizacji danych, które działają podobnie. Aby uzyskać więcej informacji, zobacz Wirtualizacja danych za pomocą usługi Azure SQL Managed Instance.
- PolyBase nie jest wspierany w bazach danych SQL w Fabric, ale baza SQL w Fabric oferuje własne możliwości wirtualizacji danych w OneLake. Więcej informacji można znaleźć w artykule Wirtualizacja danych w bazie danych SQL w usłudze Fabric.
- PolyBase nie jest funkcją w Fabric Data Warehouse. Do wirtualizacji danych w Fabric Data Warehouse rozważ Fabric OneLake Shortcuts. Artykuły dotyczące ładowania danych w usłudze Fabric Data Warehouse można znaleźć w artykułach Data ingestion with T-SQL oraz Dimensional modeling: Load tables.
Typowe przypadki użycia
W poniższej tabeli opisano możliwe scenariusze użycia.
| Scenario | Użyj |
|---|---|
| Eksploracja plików ad hoc | OPENROWSET(BULK ...) |
| Wielokrotne odpytywanie plików na potrzeby BI i raportowania | Tabele zewnętrzne nad plikami |
| Wykonywanie zapytań między bazami danych (SQL Server, Oracle, Teradata, MongoDB, ODBC) | Łączniki polyBase z tabelami zewnętrznymi |
| Eksportowanie wyników zapytania do plików |
CREATE EXTERNAL TABLE AS SELECT (CETAS) |
| Zbiorczy import do tabel |
BULK INSERT lub OPENROWSET(BULK ...) z INSERT ... SELECT |
- Do doraźnego przeglądania plików użyj
OPENROWSET(BULK ...), aby sprawdzać pliki bez tworzenia tabeli wielokrotnego użytku. - Do ponownego użytku zapytań plików w BI lub scenariuszy raportowania używaj tabel zewnętrznych zamiast plików, aby utrzymywać schemat i dzielić się wynikami między zapytaniami.
- Do zapytań międzybazowych używaj konektorów PolyBase z zewnętrznymi tabelami, aby uzyskać dostęp do źródeł SQL Server, Oracle, Teradata, MongoDB lub ODBC.
- Do eksportowania wyników zapytań do plików użyj
CREATE EXTERNAL TABLE AS SELECT(CETAS), aby zapisywać dane wyjściowe w formacie Parquet lub CSV poza bazą. - Do zbiorczego importu do tabel użyj
BULK INSERTlubOPENROWSET(BULK ...)zINSERT ... SELECT, aby załadować dane z plików do tabel bazy danych.
W jakich miejscach są dostępne funkcje?
Poniższa tabela pokazuje, które kluczowe funkcje PolyBase i wirtualizacji danych są dostępne na każdej platformie SQL, począwszy od SQL Server 2019. Aby dowiedzieć się o dostępności funkcji w SQL Server 2016 i SQL Server 2017 na Windows, zobacz funkcje i ograniczenia PolyBase. Użyj tej tabeli, aby określić, co można zrobić na platformie przed użyciem szczegółowych przewodników.
| Funkcja | SQL Server 2019 | SQL Server 2022 | SQL Server 2025 | Azure SQL Database | Azure SQL Managed Instance | Baza danych SQL w usłudze Microsoft Fabric |
|---|---|---|---|---|---|---|
| Tabele zewnętrzne | Yes | Yes | Yes | Yes | Yes | Yes |
| OPENROWSET (ZBIORCZO) | Tak 1 | Yes | Yes | Yes | Yes | Yes |
| CETAS (eksport) | Nie. | Yes | Yes | Nie. | Yes | Nie. |
| Pliki CSV/pliki rozdzielane separatorem | Tak 2 | Yes | Yes | Yes | Yes | Yes |
| Pliki Parquet | Nie. | Yes | Yes | Yes | Yes | Yes |
| Tabele Delta Lake | Nie. | Yes | Yes | Nie. | Nie. | Nie. |
| Nawiązywanie połączenia z innym programem SQL Server | Yes | Yes | Yes | Nie. | Nie. | Nie. |
| Nawiązywanie połączenia z usługą Azure SQL Database lub usługą Azure SQL Managed Instance | Tak 3 | Tak 3 | Tak 3 | Nie. | Nie. | Nie. |
| Nawiązywanie połączenia z bazą danych Oracle/Teradata/MongoDB | Yes | Yes | Yes | Nie. | Nie. | Nie. |
| Nawiązywanie połączenia z usługą Azure Blob Storage | Yes | Yes | Yes | Yes | Yes | Nie. |
| Nawiązywanie połączenia z usługą ADLS Gen2 | Tak 5 | Yes | Yes | Yes | Yes | Nie. |
| Połącz się z magazynem zgodnym z usługą S3 | Nie. | Yes | Yes | Nie. | Nie. | Nie. |
| Nawiązywanie połączenia z usługą OneLake (Fabric) | Nie. | Nie. | Nie. | Nie. | Nie. | Yes |
| Obliczenia wypychane | Yes | Yes | Yes | Nie. | Nie. | Nie. |
| Uwierzytelnianie za pomocą tożsamości zarządzanej | Nie. | Nie. | Tak 4 | Yes | Yes | Nie. |
Program SQL Server 2019 (15.x) obsługuje OPENROWSET(BULK...) ścieżki plików lokalnych i sieciowych. W programie SQL Server 2022 (16.x) i nowszych wersjach OPENROWSET(BULK...) obsługuje również odczyt z magazynu w chmurze za pomocą systemów FORMAT = 'PARQUET', FORMAT = DELTAi FORMAT = 'CSV'.
Obsługa CSV w programie SQL Server 2019 (15.x) wymagała usługi Hadoop. W programie SQL Server 2022 (16.x) i nowszych wersjach wolumin CSV jest natywnie obsługiwany bez usługi Hadoop.
3 Używa łącznika programu SQL Server (sqlserver://). Poświadczenie w zakresie bazy danych jest przeznaczone dla punktu końcowego SQL. Stosuj te same kroki, co przy łączeniu z inną instancją SQL Server.
4 Uwierzytelnianie tożsamości zarządzanej jest obsługiwane w przypadku nawiązywania połączenia z usługami Azure Blob Storage (ABS) i ADLS Gen2. Wymaga ona programu SQL Server z obsługą usługi Azure Arc lub programu SQL Server na maszynie wirtualnej platformy Azure dla lokalnego programu SQL Server. Jest ona natywnie dostępna w usługach Azure SQL Database i Azure SQL Managed Instance.
5 SQL Server 2019 CU11 i późniejsze wersje obsługują Azure Data Lake Storage Gen2 z prefiksem abfs orabfss. W wersjach SQL Server 2022 i nowszych używaj prefiksuadls.
- Zewnętrzne tabele są obsługiwane w SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database, Azure SQL Managed Instance oraz bazie danych SQL w Microsoft Fabric.
-
OPENROWSET (BULK)jest obsługiwany w SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database, Azure SQL Managed Instance oraz bazie danych SQL w Microsoft Fabric. SQL Server 2019 obsługuje lokalne i sieciowe ścieżki plików, a wersje SQL Server 2022 i nowsze obsługują również odczyt z magazynu w chmurze przy użyciuFORMAT = 'PARQUET',FORMAT = DELTAiFORMAT = 'CSV'. - Eksport CETAS nie jest obsługiwany w SQL Server 2019, Azure SQL Database ani w bazie danych SQL w Microsoft Fabric. Eksport CETAS jest obsługiwany w SQL Server 2022, SQL Server 2025 oraz Azure SQL Managed Instance.
- CSV i pliki ograniczone są obsługiwane w SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database, Azure SQL Managed Instance oraz bazie danych SQL w Microsoft Fabric. SQL Server 2019 wymaga Hadoop do obsługi CSV, podczas gdy SQL Server 2022 i późniejsze wersje natywnie obsługują CSV bez Hadoop.
- Pliki Parquet nie są obsługiwane w SQL Server 2019. Pliki Parquet są obsługiwane w SQL Server 2022, SQL Server 2025, Azure SQL Database, Azure SQL Managed Instance oraz bazie danych SQL w Microsoft Fabric.
- Tabele Delta Lake nie są obsługiwane w SQL Server 2019, Azure SQL Database, Azure SQL Managed Instance ani bazie danych SQL w Microsoft Fabric. Tabele Delta Lake są obsługiwane w SQL Server 2022 oraz SQL Server 2025.
- Łączenie się z inną instancją SQL Server jest obsługiwane w SQL Server 2019, SQL Server 2022 oraz SQL Server 2025. Łączenie się z inną instancją SQL Server nie jest obsługiwane przez Azure SQL Database, Azure SQL Managed Instance ani bazę danych SQL w Microsoft Fabric.
- Łączenie z Azure SQL Database lub Azure SQL Managed Instance jest obsługiwane przez SQL Server 2019, SQL Server 2022 oraz SQL Server 2025 za pomocą konektora SQL Server. Poświadczenie o zakresie bazy danych wskazuje punkt końcowy usługi Azure SQL Database lub Azure SQL Managed Instance, a kroki konfiguracji są takie same jak w przypadku łączenia z inną instancją programu SQL Server. Te połączenia nie są obsługiwane w Azure SQL Database, Azure SQL Managed Instance ani w bazie danych SQL w Microsoft Fabric.
- Łączenie z Oracle, Teradata lub MongoDB jest obsługiwane w SQL Server 2019, SQL Server 2022 oraz SQL Server 2025. Te połączenia nie są obsługiwane w Azure SQL Database, Azure SQL Managed Instance ani w bazie danych SQL w Microsoft Fabric.
- Łączenie z Azure Blob Storage jest obsługiwane przez SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database oraz Azure SQL Managed Instance. Nawiązywanie połączenia z usługą Azure Blob Storage z poziomu bazy danych SQL w usłudze Microsoft Fabric nie jest obsługiwane.
- Łączenie się z ADLS Gen2 nie jest wspierane w wersjach SQL Server 2019 sprzed CU11 ani z bazy danych SQL w Microsoft Fabric. Łączenie z ADLS Gen2 jest obsługiwane od SQL Server 2019 CU11, a także w SQL Server 2022, SQL Server 2025, Azure SQL Database oraz Azure SQL Managed Instance.
- Łączenie się z pamięcią kompatybilną z S3 nie jest obsługiwane przez SQL Server 2019, Azure SQL Database, Azure SQL Managed Instance ani bazy danych SQL w Microsoft Fabric. Łączenie z pamięcią kompatybilną z S3 jest obsługiwane w SQL Server 2022 i SQL Server 2025.
- Łączenie z OneLake jest obsługiwane z bazy danych SQL w Microsoft Fabric. Łączenie z OneLake nie jest obsługiwane w SQL Server 2019, SQL Server 2022, SQL Server 2025, Azure SQL Database ani Azure SQL Managed Instance.
- Obliczenia pushdown są obsługiwane w SQL Server 2019, SQL Server 2022 oraz SQL Server 2025. Obliczenia typu pushdown nie są obsługiwane w Azure SQL Database, Azure SQL Managed Instance ani w bazie danych SQL w Microsoft Fabric.
- Uwierzytelnianie tożsamości zarządzanej nie jest obsługiwane w SQL Server 2019 ani SQL Server 2022. Uwierzytelnianie za pomocą tożsamości zarządzanej jest obsługiwane w SQL Server 2025 w przypadku połączeń z usługami Azure Blob Storage i ADLS Gen2 i wymaga SQL Server z obsługą Azure Arc lub SQL Server na maszynie wirtualnej platformy Azure. Uwierzytelnianie Managed Identity jest również obsługiwane w Azure SQL Database oraz Azure SQL Managed Instance, ale nie jest obsługiwane w bazie danych SQL w Microsoft Fabric.
Uwaga / Notatka
Począwszy od programu SQL Server 2025 (17.x), wykonywanie zapytań dotyczących plików danych (CSV, Parquet i Delta) w Azure Blob Storage, ADLS Gen2 lub składowaniu zgodnym z S3 jest natywną funkcją aparatu i nie wymaga już instalowania ani uruchamiania usług PolyBase. Łączniki RDBMS (SQL Server, Oracle, Teradata, MongoDB, ODBC) nadal wymagają zainstalowania i uruchomienia usług PolyBase. Program SQL Server 2025 (17.x) dodaje również obsługę systemu Linux dla tych łączników, które były wcześniej dostępne tylko w systemie Windows.
Wykonywanie zapytań o dane zewnętrzne
Przed wybraniem konkretnego scenariusza zapoznaj się z trzema sposobami wykonywania zapytań dotyczących danych zewnętrznych:
| Metoda | Składnia | Użyj, gdy | Uwierzytelnianie | Wymagana instalacja PolyBase |
|---|---|---|---|---|
| OLE DB zapytania ad hoc | OPENROWSET(provider, connection, query) |
Potrzebujesz szybkiego jednorazowego zapytania bez obiektów trwałych lub potrzebujesz uwierzytelniania identyfikatora Entra firmy Microsoft | Uwierzytelnianie SQL, uwierzytelnianie systemu Windows, Microsoft Entra ID (MSOLEDBSQL) | Nie. |
| Zapytania ad hoc do plików | OPENROWSET(BULK ...) |
Chcesz szybko eksplorować dane plików lub testować schematy przed utworzeniem tabeli | Token SAS, klucz dostępu, tożsamość zarządzana, Microsoft Entra ID | SQL Server 2022: Tak 1 SQL Server 2025 i nowsze wersje: Nie Azure SQL Database, Azure SQL Managed Instance oraz baza danych SQL w usłudze Fabric: Wbudowane |
| Trwałe łączniki danych |
CREATE EXTERNAL TABLE z sqlserver://, oracle://, teradata://, itp. |
Potrzebujesz powtarzającego się dostępu, zarządzania, statystyk i obliczeń przesuwanych na niższy poziom dla środowiska produkcyjnego | Tylko uwierzytelnianie SQL | Yes |
1 Aby uzyskać dostęp do plików w chmurze w SQL Server 2022 (16.x), musisz zainstalować funkcję PolyBase, ale złącza pamięci masowej kompatybilne z Azure Blob Storage, ADLS Gen2 i S3 nie zależą od usług PolyBase. SQL Server 2025 (17.x) i nowsze wersje mają natywne wsparcie dla CSV, Parquet i Delta bez konieczności instalowania lub uruchamiania usług PolyBase.
- Zapytania ad hoc w OLE DB służą
OPENROWSET(provider, connection, query)do szybkiego jednorazowego dostępu do zdalnego źródła danych bez tworzenia trwałych obiektów. Mogą korzystać z uwierzytelniania SQL, uwierzytelniania systemu Windows lub Microsoft Entra ID z MSOLEDBSQL. Ten scenariusz nie wymaga instalacji PolyBase. - Zapytania ad hoc dotyczące plików służą
OPENROWSET(BULK ...)do szybkiego eksplorowania danych plików lub testowania schematu przed utworzeniem tabeli. Mogą używać tokenów SAS, kluczy dostępu, Managed Identity lub Microsoft Entra ID. SQL Server 2022 wymaga instalacji funkcji PolyBase dla plików w chmurze, ale nie wymaga usług PolyBase. SQL Server 2025 i nowsze wersje nie wymagają PolyBase do plików w chmurze. Doraźne zapytania dotyczące plików są wbudowaną funkcją usługi Azure SQL Database, Azure SQL Managed Instance oraz bazy danych SQL w usłudze Fabric. - Trwałe złącza danych wykorzystują
CREATE EXTERNAL TABLEoracle://sqlserver://, ,teradata://, i podobne lokalizacje do powtarzającego się dostępu, zarządzania, statystyki oraz obliczeń pushdown w obciążeniach produkcyjnych. Wymagają uwierzytelniania SQL i usług PolyBase.
Przewodnik po decyzjach
| Scenario | Zalecenie |
|---|---|
| Potrzebujesz uwierzytelniania Microsoft Entra ID do zdalnego SQL lub chcesz unikać usług PolyBase. | Użycie OPENROWSET(MSOLEDBSQL, ...) (ad hoc, brak trwałych obiektów). |
| Potrzebujesz trwałych tabel, statystyk lub przeniesienia obliczeń do zdalnych baz danych. | Używaj CREATE EXTERNAL TABLE z łącznikami programu PolyBase (sqlserver://, oracle://, teradata://, mongodb://, odbc://).
OPENROWSET Nie obsługuje złączy. |
| Eksplorujesz nowy plik lub testujesz schemat. | Zastosowanie OPENROWSET(BULK ...) (szybka iteracja, brak trwałych obiektów). |
| Importujesz dane z pliku do tabeli z zastosowaniem transformacji. | Użyj INSERT ... SELECT z OPENROWSET(BULK ...). |
| Potrzebujesz zarządzania lub współudostępniania dla wielu użytkowników lub aplikacji. | Użyj, CREATE EXTERNAL TABLE aby uprawnienia i metadane były scentralizowane. |
| Pracujesz w bazie danych SQL w Fabric. | Użyj OPENROWSET(BULK ...) do doraźnych zapytań OneLake lub tabel zewnętrznych, aby zapewnić dostęp wielokrotnego użytku; w przypadku magazynu zewnętrznego użyj skrótów OneLake. |
- Jeśli potrzebujesz uwierzytelniania Microsoft Entra ID na potrzeby zdalnego SQL lub chcesz uniknąć usług PolyBase, użyj
OPENROWSET(MSOLEDBSQL, ...)do wykonywania doraźnych zapytań zdalnych bez trwałych obiektów. - Jeśli potrzebujesz trwałych tabel, statystyk lub obliczeń pushdown do zdalnych baz danych, użyj
CREATE EXTERNAL TABLEz konektorami PolyBase, takimi jaksqlserver://,oracle://,teradata://,mongodb://, iodbc://.OPENROWSETnie obsługuje tych złączy. - Jeśli eksplorujesz nowy plik lub testujesz schemat, użyj go
OPENROWSET(BULK ...)do szybkiej iteracji i bez trwałych obiektów. - Jeśli pozyskujesz dane z pliku do tabeli z zastosowaniem transformacji, użyj
INSERT ... SELECTzOPENROWSET(BULK ...). - Jeśli potrzebujesz zarządzania lub współdzielonego dostępu dla wielu użytkowników lub aplikacji, użyj
CREATE EXTERNAL TABLEtak, aby uprawnienia i metadane były scentralizowane. - Jeśli pracujesz w bazie danych SQL na platformie Fabric, używaj
OPENROWSET(BULK ...)w przypadku doraźnych zapytań do OneLake lub tabel zewnętrznych do wielokrotnego użytku, a do magazynu zewnętrznego używaj skrótów OneLake.
Wybieranie scenariusza
Teraz, gdy znasz trzy podejścia, użyj jednego z poniższych przewodników, aby zaimplementować konkretny przypadek użycia.
Pliki zapytań (Parquet, CSV lub Delta)
Jeśli dane są w plikach Parquet, CSV lub Delta w usłudze Azure Blob Storage, usłudze ADLS Gen2, magazynie zgodnym z usługą S3 lub oneLake, postępuj zgodnie z jednym z następujących przewodników:
| Scenario | Zalecany przewodnik | Platformy |
|---|---|---|
| Szybkie zapytanie ad hoc dotyczące pliku Parquet lub CSV | Użyj OPENROWSET. Brak wymaganej tabeli zewnętrznej |
SQL Server 2022 (16.x) i nowsze wersje, Azure SQL Database, Azure SQL Managed Instance, SQL Database in Fabric |
| Powtarzające się zapytania dotyczące plików Parquet ze schematem trwałym | Tworzenie tabeli zewnętrznej w formacie Parquet | SQL Server 2022 (16.x) i nowsze wersje, Azure SQL Database, Azure SQL Managed Instance, SQL Database in Fabric |
| Wykonywanie zapytań dotyczących plików CSV przy użyciu tabeli zewnętrznej | Tworzenie tabeli zewnętrznej z formatem pliku dla tekstu rozdzielanego | SQL Server 2019 (15.x) i nowsze wersje, Azure SQL Database, Azure SQL Managed Instance, SQL Database in Fabric |
| Wykonywanie zapytań względem tabel Delta Lake | Tworzenie tabeli zewnętrznej za pomocą polecenia FILE_FORMAT = DeltaLakeFileFormat |
SQL Server 2022 (16.x) i nowsze wersje |
| Eksportowanie wyników zapytania do plików Parquet lub CSV (CETAS) | Użyj CREATE EXTERNAL TABLE AS SELECT |
SQL Server 2022 (16.x) i nowsze wersje, Azure SQL Managed Instance |
- Aby szybko wykonać zapytanie ad hoc dotyczące pliku Parquet lub CSV, użyj
OPENROWSET. Ta metoda nie wymaga zewnętrznej tabeli. SQL Server 2022 (16.x) oraz nowsze wersje, Azure SQL Database, Azure SQL Managed Instance oraz SQL database in Fabric wspierają ten schemat. - W przypadku powtarzających się zapytań dotyczących plików Parquet o stałym schemacie używaj tabeli zewnętrznej opartej na Parquet. SQL Server 2022 (16.x) oraz nowsze wersje, Azure SQL Database, Azure SQL Managed Instance oraz SQL database in Fabric wspierają ten schemat.
- Do wykonywania zapytań na plikach CSV użyj tabeli zewnętrznej z formatem pliku dla tekstu rozdzielanego separatorami. SQL Server 2019 (15.x) oraz nowsze wersje, Azure SQL Database, Azure SQL Managed Instance oraz SQL database in Fabric wspierają ten wzorzec.
- Aby wykonać zapytanie dotyczące tabel Delta Lake, użyj tabeli zewnętrznej z
FILE_FORMAT = DeltaLakeFileFormat. SQL Server 2022 (16.x) i nowsze wersje wspierają ten wzorzec. - Do eksportu wyników zapytań do plików Parquet lub CSV użyj
CREATE EXTERNAL TABLE AS SELECT. SQL Server 2022 (16.x) i nowsze wersje oraz Azure SQL Managed Instance wspierają ten wzorzec.
Możesz również wykonać jeden z tych samouczków krok po kroku.
| Tutorial | Opis |
|---|---|
| Wprowadzenie do technologii PolyBase w programie SQL Server 2022 | Obejmuje nawigację OPENROWSET między plikami Parquet i CSV, tabelami zewnętrznymi i folderami. |
| Wirtualizuj plik Parquet w magazynie zgodnym z S3 za pomocą technologii PolyBase | Samouczek dotyczący programu SQL Server 2022 (16.x) i nowszych wersji. |
| Wirtualizacja pliku CSV za pomocą technologii PolyBase | Samouczek dotyczący programu SQL Server 2022 (16.x) i nowszych wersji. |
| Wirtualizacja tabeli różnicowej za pomocą technologii PolyBase | Samouczek dotyczący programu SQL Server 2022 (16.x) i nowszych wersji. |
| Wirtualizacja danych za pomocą usługi Azure SQL Database (wersja zapoznawcza) | Przewodnik usługi Azure SQL Database dotyczący plików Parquet i CSV. |
| Wirtualizacja danych za pomocą usługi Azure SQL Managed Instance | Przewodnik po usłudze Azure SQL Managed Instance dla usług Parquet, CSV i CETAS. |
| Wirtualizacja danych w bazie danych SQL w Fabric | Przewodnik dotyczący bazy danych SQL w usłudze Fabric dla plików OneLake. |
Połącz się z innym wystąpieniem SQL Server, bazą danych Azure SQL lub zarządzanym wystąpieniem SQL
W programie SQL Server 2019 (15.x) i nowszych wersjach program PolyBase może wykonywać zapytania o tabele w innym wystąpieniu programu SQL Server, usłudze Azure SQL Database lub usłudze Azure SQL Managed Instance bez używania serwerów połączonych.
Ważna
Łącznik sqlserver:// nie jest obsługiwany w bazie danych SQL w Fabric. Łączniki PolyBase RDBMS używają uwierzytelniania SQL za pośrednictwem CREATE DATABASE SCOPED CREDENTIAL i nie obsługują uwierzytelniania Microsoft Entra ID, tożsamości zarządzanej ani głównego obiektu zabezpieczeń. Ponieważ baza danych SQL w platformie Fabric wymaga uwierzytelniania Microsoft Entra, nie można nawiązać z nią połączenia przy użyciu PolyBase.
| Krok | Co zrobić |
|---|---|
| 1. Zainstaluj program PolyBase | Instalowanie programu PolyBase w systemie Windows lub instalowanie programu PolyBase w systemie Linux |
| 2. Tworzenie poświadczeń |
CREATE DATABASE SCOPED CREDENTIAL z nazwą logowania docelowego |
| 3. Tworzenie zewnętrznego źródła danych | CREATE EXTERNAL DATA SOURCE ... WITH (LOCATION = 'sqlserver://<server>') |
| 4. Tworzenie tabeli zewnętrznej | CREATE EXTERNAL TABLE ... WITH (LOCATION = '<db>.<schema>.<table>') |
| 5. Zapytanie (Kwerenda) | SELECT * FROM <external_table> |
-
- Zainstaluj PolyBase na Windows lub Linux, używając opcji Install PolyBase na Windows lub Install PolyBase na Linuksie, zanim skonfigurujesz dostęp do zewnętrznych danych SQL.
-
- Utwórz poświadczenie na poziomie bazy danych dla docelowego loginu, używając
CREATE DATABASE SCOPED CREDENTIAL, aby aparat bazy danych mógł uwierzytelnić się na serwerze zdalnym.
- Utwórz poświadczenie na poziomie bazy danych dla docelowego loginu, używając
-
- Utworzenie zewnętrznego źródła danych dla zdalnego SQL Server, używając
CREATE EXTERNAL DATA SOURCE ... WITH (LOCATION = 'sqlserver://<server>').
- Utworzenie zewnętrznego źródła danych dla zdalnego SQL Server, używając
-
- Utwórz tabelę zewnętrzną, używając elementu
CREATE EXTERNAL TABLE ... WITH (LOCATION = '<db>.<schema>.<table>')do reprezentowania tabeli zdalnej.
- Utwórz tabelę zewnętrzną, używając elementu
-
- Zapytaj zewnętrzną tabelę, używając
SELECT * FROM <external_table>.
- Zapytaj zewnętrzną tabelę, używając
Wskazówka
Łącznik programu SQL Server (sqlserver://) działa również dla usług Azure SQL Database i Azure SQL Managed Instance. Użyj tych samych kroków i ustaw LOCATION na punkt końcowy usługi Azure SQL Database lub Azure SQL Managed Instance (na przykład sqlserver://myserver.database.windows.net).
Aby uzyskać szczegółowy przewodnik, zobacz Configure PolyBase to access external data in SQL Server (Konfigurowanie programu PolyBase w celu uzyskania dostępu do danych zewnętrznych w programie SQL Server).
Nawiązywanie połączenia z bazą danych Oracle, Teradata lub MongoDB
Program SQL Server 2019 (15.x) i nowsze wersje mogą wykonywać zapytania do Oracle, Teradata, MongoDB i Cosmos DB za pomocą łączników ODBC PolyBase.
| Źródło danych | Przewodnik | Wymagania |
|---|---|---|
| Oracle | Konfigurowanie programu PolyBase w celu uzyskiwania dostępu do danych zewnętrznych w programie Oracle | SQL Server 2019 (15.x) i nowsze wersje, sterowniki klienta Oracle |
| Teradata | Konfigurowanie programu PolyBase w celu uzyskiwania dostępu do danych zewnętrznych w usłudze Teradata | SQL Server 2019 (15.x) i nowsze wersje, sterownik Teradata ODBC |
| MongoDB / Cosmos DB | Konfigurowanie programu PolyBase w celu uzyskiwania dostępu do danych zewnętrznych w bazie danych MongoDB | SQL Server 2019 (15.x) i nowsze wersje, sterownik OdBC bazy danych MongoDB |
| Dowolne źródło ODBC | Konfigurowanie programu PolyBase w celu uzyskiwania dostępu do danych zewnętrznych przy użyciu typów ogólnych ODBC | SQL Server 2019 (15.x) i nowsze wersje (Windows) (System Linux rozpoczynający się od programu SQL Server 2025 (17.x)) |
- Źródła danych Oracle wykorzystują Configure PolyBase do dostępu do zewnętrznych danych w przewodniku Oracle i wymagają SQL Server 2019 (15.x) i nowszych wersji oraz sterowników klienta Oracle.
- Źródła danych Teradata wykorzystują Configure PolyBase do dostępu do zewnętrznych danych w przewodniku Teradata i wymagają SQL Server 2019 (15.x) i późniejszych wersji oraz sterownika Teradata ODBC.
- Źródła danych MongoDB lub Cosmos DB wykorzystują Configure PolyBase do dostępu do zewnętrznych danych w przewodniku MongoDB i wymagają SQL Server 2019 (15.x) i późniejszych wersji oraz sterownika MongoDB ODBC.
- Każde źródło ODBC może korzystać z Configure PolyBase do dostępu do danych zewnętrznych z przewodnikiem ODBC po typach ogólnych i wymaga wersji SQL Server 2019 (15.x) oraz nowszych na Windows lub SQL Server 2025 (17.x) oraz nowszych wersji na Linuksie.
Nawiązywanie połączenia z usługą Azure Blob Storage lub ADLS Gen2
| Platforma SQL | Opcje uwierzytelniania | Przewodnik |
|---|---|---|
| SQL Server 2022 (16.x) i nowsze wersje | Token SAS, klucz dostępu, tożsamość zarządzana (począwszy od programu SQL Server 2025 (17.x)) | Konfigurowanie programu PolyBase w celu uzyskiwania dostępu do danych zewnętrznych w usłudze Azure Blob Storage |
| SQL Server 2019 (15.x) | Klucz dostępu (za pośrednictwem łącznika usługi Hadoop) | Konfigurowanie programu PolyBase w celu uzyskiwania dostępu do danych zewnętrznych w usłudze Azure Blob Storage |
| Azure SQL Database | Token SAS, zarządzana tożsamość, przekazywanie bezpośrednie w Microsoft Entra | Wirtualizacja danych za pomocą usługi Azure SQL Database (wersja zapoznawcza) |
| Azure SQL Managed Instance | Token SAS, zarządzana tożsamość | Wirtualizacja danych za pomocą usługi Azure SQL Managed Instance |
- SQL Server 2022 i późniejsze wersje wspierają uwierzytelnianie Azure Blob Storage lub ADLS Gen2 poprzez wykorzystanie tokenów SAS, kluczy dostępu lub Managed Identity, począwszy od SQL Server 2025 (17.x). Aby uzyskać więcej informacji, zobacz Configure PolyBase to access external data in Azure Blob Storage (Konfigurowanie technologii PolyBase w celu uzyskania dostępu do danych zewnętrznych w usłudze Azure Blob Storage).
- SQL Server 2019 obsługuje Azure Blob Storage lub ADLS Gen2, korzystając z klucza dostępu przez konektor Hadoop. Aby uzyskać więcej informacji, zobacz Configure PolyBase to access external data in Azure Blob Storage (Konfigurowanie technologii PolyBase w celu uzyskania dostępu do danych zewnętrznych w usłudze Azure Blob Storage).
- Azure SQL Database obsługuje usługę Azure Blob Storage lub ADLS Gen2 przy użyciu tokenów SAS, Managed Identity albo uwierzytelniania pass-through Microsoft Entra. Aby uzyskać więcej informacji, zobacz Wirtualizacja danych z użyciem Azure SQL Database (wersja zapoznawcza).
- Azure SQL Managed Instance obsługuje Azure Blob Storage lub ADLS Gen2 poprzez wykorzystanie tokenów SAS lub Managed Identity. Aby uzyskać więcej informacji, zobacz Wirtualizacja danych za pomocą usługi Azure SQL Managed Instance.
W programie SQL Server 2022 (16.x) zmieniono prefiksy identyfikatora URI. Podczas migracji z programu SQL Server 2019 (15.x) lub starszych wersji:
-
Azure Blob Storage: zmień
wasb[s]://naabs:// -
ADLS Gen2: zmiana
abfs[s]://naadls://
Aby uzyskać więcej informacji, zobacz Configure PolyBase to access external data in Azure Blob Storage (Konfigurowanie technologii PolyBase w celu uzyskania dostępu do danych zewnętrznych w usłudze Azure Blob Storage).
Nawiązywanie połączenia z magazynem obiektów zgodnym ze standardem S3
Program SQL Server 2022 (16.x) i nowsze wersje obsługują magazyn zgodny z protokołem S3, takie jak Amazon S3, MinIO i Ceph.
Aby uzyskać więcej informacji, zobacz Configure PolyBase to access external data in S3-compatible object storage (Konfigurowanie programu PolyBase w celu uzyskania dostępu do danych zewnętrznych w magazynie obiektów zgodnym z programem S3).
Eksportowanie danych za pomocą CREATE EXTERNAL TABLE AS SELECT (CETAS)
Funkcja CETAS eksportuje wyniki zapytania do plików zewnętrznych (Parquet lub CSV) w usłudze Azure Blob Storage, usłudze ADLS Gen2 lub magazynie zgodnym z usługą S3.
| Platforma SQL | Wsparte | Formaty eksportu | Notatki |
|---|---|---|---|
| SQL Server 2022 (16.x) i nowsze wersje. Eksport do ADLS Gen2 z CETAS wymaga wersji SQL Server 2022 CU5 lub nowszej. | Yes | Parquet, CSV | Wymaga konfiguracji serwera: pozwól na eksport polibazy. |
| Azure SQL Managed Instance | Yes | Parquet, CSV | Domyślnie wyłączone |
| Azure SQL Database | Nie. | Żadne | Niedostępne |
| Baza danych SQL na platformie Fabric | Nie. | Żadne | Niedostępne |
- SQL Server 2022 i późniejsze wersje obsługują CETAS oraz eksport plików Parquet i CSV. Konfiguracja serwera: wymagana jest opcja eksportu polibazy. Eksport CETAS do ADLS Gen2 nie jest dostępny w wersjach SQL Server 2022 przed CU5.
- Azure SQL Managed Instance obsługuje CETAS i eksportuje pliki Parquet oraz CSV. Wskazówka Wyłączone domyślnie opisuje jego stan domyślny.
- Azure SQL Database nie obsługuje CETAS.
- Baza danych SQL w Fabric nie obsługuje CETAS.
Aby uzyskać informacje na temat Transact-SQL, zobacz CREATE EXTERNAL TABLE AS SELECT (CETAS).
Przykłady szybkiego startu
Przykład 1: Zapytanie ad hoc w pliku Parquet (OPENROWSET)
Nie jest wymagana tabela zewnętrzna. Działa w programie SQL Server 2022 (16.x) i nowszych wersjach, usługach Azure SQL Database, Azure SQL Managed Instance i SQL Database w usłudze Fabric.
SELECT TOP 10 *
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*.parquet',
    FORMAT = 'PARQUET'
) AS [result];
Przykład 2: Tabela zewnętrzna oparta na CSV w Azure Blob Storage
Ten przykład działa na wszystkich platformach SQL obsługujących zewnętrzne tabele zamiast plików CSV.
Krok 1. Tworzenie klucza głównego bazy danych (DMK). Ten krok jest wymagany, ponieważ magazyn poświadczeń przechowuje sekret tokenu SAS. Możesz jednak pominąć ten krok, jeśli korzystasz z uwierzytelniania Managed Identity lub Microsoft Entra.
CREATE MASTER KEY ENCRYPTION BY PASSWORD = '<password>';Krok 2. Tworzenie poświadczeń przy użyciu tokenu SAS. Pomiń początkowe
?.CREATE DATABASE SCOPED CREDENTIAL MyStorageCred WITH IDENTITY = 'SHARED ACCESS SIGNATURE', SECRET = '<your_SAS_token>'; -- omit the leading '?'Krok 3. Tworzenie zewnętrznego źródła danych.
CREATE EXTERNAL DATA SOURCE MyAzureStorage
WITH (
    LOCATION = 'abs://mycontainer@mystorageaccount.blob.core.windows.net',
    CREDENTIAL = MyStorageCred
);
Krok 4. Tworzenie formatu pliku dla pliku CSV.
CREATE EXTERNAL FILE FORMAT CsvFormat
WITH (
    FORMAT_TYPE = DELIMITEDTEXT,
    FORMAT_OPTIONS (
        FIELD_TERMINATOR = ',',
        STRING_DELIMITER = '"',
        FIRST_ROW = 2
    )
);
Krok 5. Tworzenie tabeli zewnętrznej.
CREATE EXTERNAL TABLE dbo.SalesExternal
(
    OrderId INT,
    OrderDate DATE,
    Amount DECIMAL (18, 2),
    Customer NVARCHAR (100)
)
WITH (
    DATA_SOURCE = MyAzureStorage,
    LOCATION = '/data/sales/',
    FILE_FORMAT = CsvFormat
);
Krok 6. Wykonywanie zapytań względem tabeli zewnętrznej.
SELECT *
FROM dbo.SalesExternal
WHERE OrderDate >= '2025-01-01';
Przykład 3. Wykonywanie zapytań względem tabeli w innym programie SQL Server
Ten przykład działa w programie SQL Server 2019 (15.x) i nowszych wersjach.
Krok 1. Utworzenie klucza głównego bazy danych (wymagane, ponieważ poświadczenia przechowują hasło).
CREATE MASTER KEY ENCRYPTION
BY PASSWORD = '<password>';
Krok 2: Utwórz poświadczenie dla zdalnego wystąpienia programu SQL Server.
CREATE DATABASE SCOPED CREDENTIAL RemoteSqlCred
WITH IDENTITY = 'remote_user',
     SECRET = '<password>';
Krok 3. Tworzenie zewnętrznego źródła danych.
CREATE EXTERNAL DATA SOURCE RemoteSqlServer
WITH (
    LOCATION = 'sqlserver://remote-server.contoso.com',
    PUSHDOWN = ON,
    CREDENTIAL = RemoteSqlCred
);
Krok 4. Utworzenie tabeli zewnętrznej (trzyczęściowa nazwa w pliku
LOCATION).CREATE EXTERNAL TABLE dbo.RemoteCustomers ( CustomerId INT, CustomerName NVARCHAR (200) COLLATE SQL_Latin1_General_CP1_CI_AS ) WITH ( DATA_SOURCE = RemoteSqlServer, LOCATION = 'SalesDB.dbo.Customers' );Krok 5. Wykonywanie zapytań względem serwerów.
SELECT c.CustomerName,
       s.Amount
FROM dbo.RemoteCustomers AS c
     INNER JOIN dbo.LocalSales AS s
         ON c.CustomerId = s.CustomerId;
Przykład 4. Eksportowanie wyników do Parquet poprzez CETAS
Działa w programie SQL Server 2022 (16.x) i nowszych wersjach usługi Azure SQL Managed Instance.
Krok 1: Włącz CETAS (tylko w SQL Server).
EXECUTE sp_configure 'allow polybase export', 1;
RECONFIGURE;
Krok 2. Tworzenie poświadczeń i źródła danych (ponowne użycie z wcześniejszych przykładów).
Krok 3. Tworzenie formatu pliku dla eksportu Parquet.
CREATE EXTERNAL FILE FORMAT ParquetFormat
WITH (
    FORMAT_TYPE = PARQUET
);
Krok 4. Eksportowanie wyników zapytania.
CREATE EXTERNAL TABLE dbo.Sales2025Export
WITH (
    DATA_SOURCE = MyAzureStorage,
    LOCATION = '/exports/sales_2025.parquet',
    FILE_FORMAT = ParquetFormat
) AS
SELECT *
FROM Sales.Orders
WHERE OrderDate >= '2025-01-01';
Bloki konstrukcyjne języka T-SQL dla technologii PolyBase
Przed zaimplementowaniem dowolnego scenariusza zapoznaj się z podstawowymi obiektami języka T-SQL używanymi przez program PolyBase i sposobem ich dopasowania do siebie:
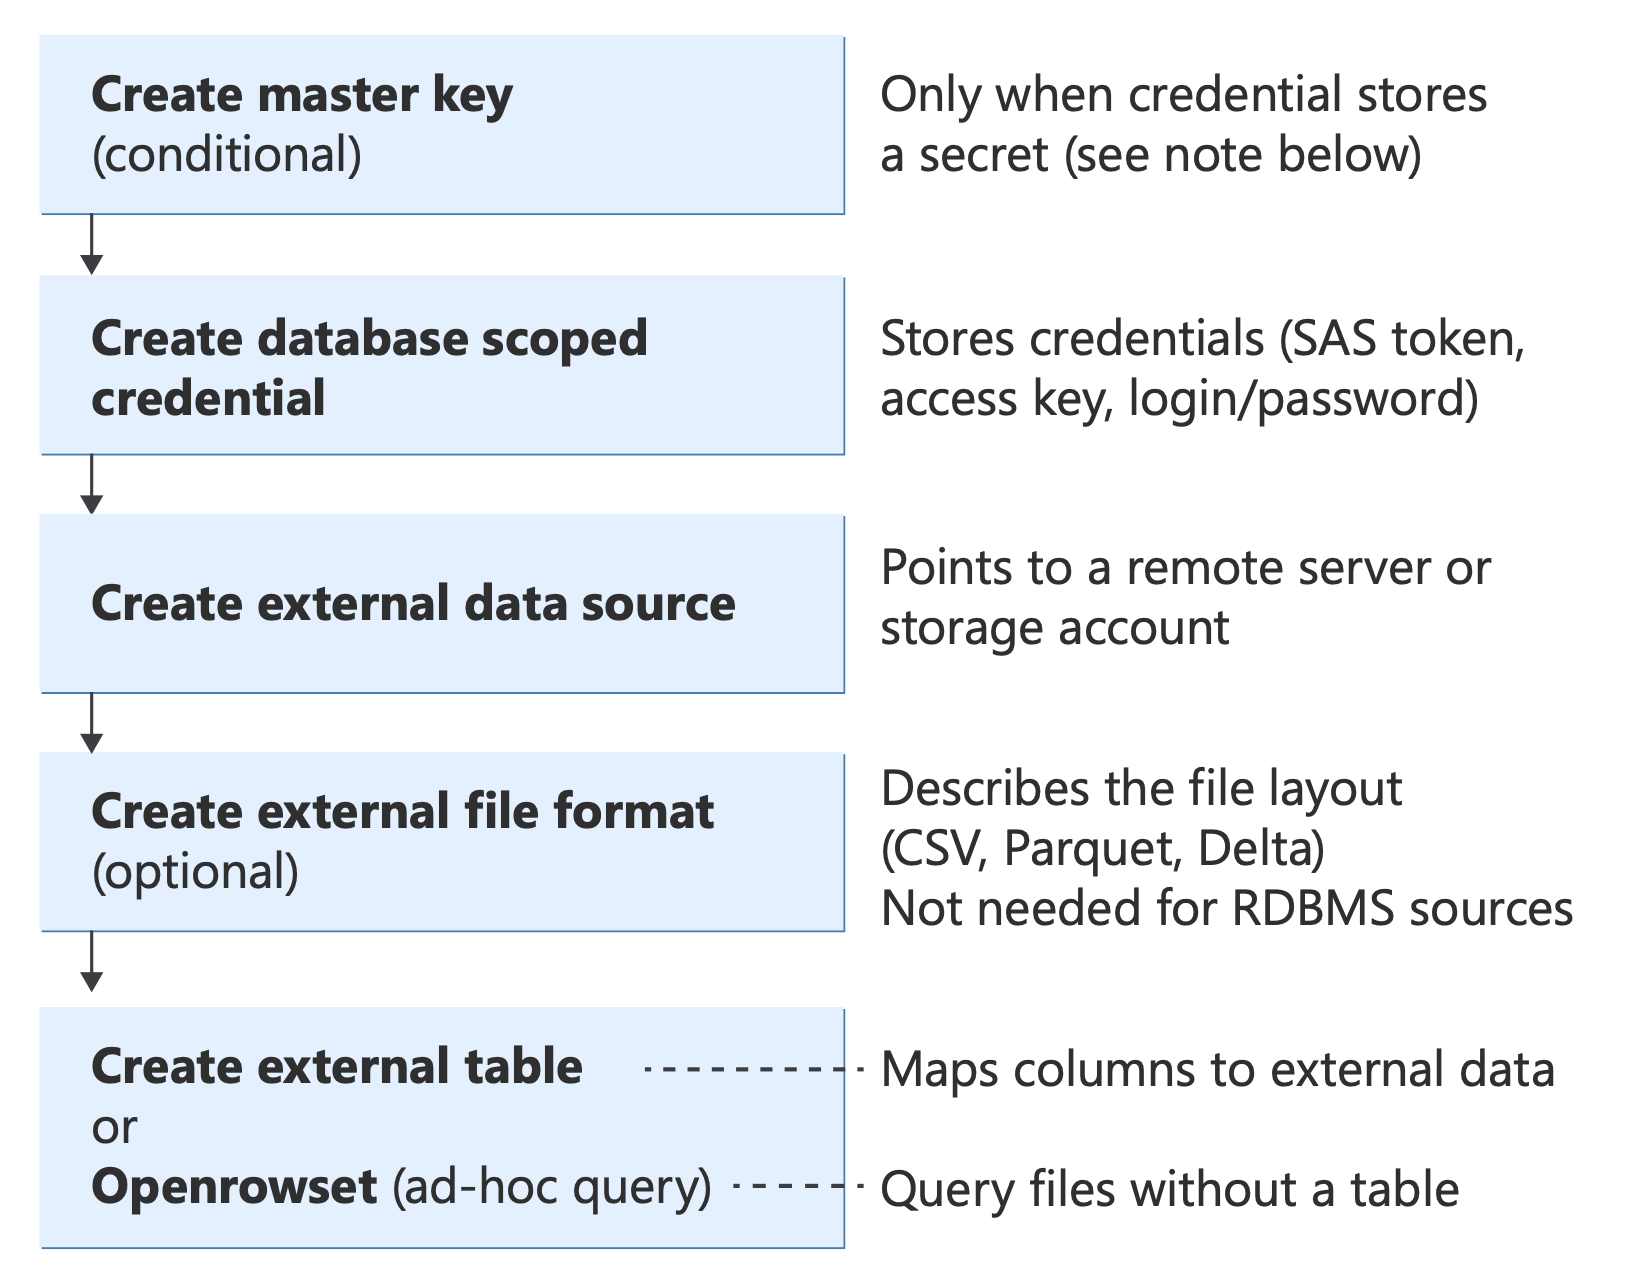
Diagram przedstawiający obiekty T-SQL technologii PolyBase i ich relacje — od uwierzytelniania (klucz główny bazy danych, poświadczenia), przez źródła danych i formaty plików, po metody wykonywania zapytań (External Table, OPENROWSET, BULK INSERT, CETAS).
- Informacje na temat składni zewnętrznych źródeł danych można znaleźć w CREATE EXTERNAL DATA SOURCE.
- Aby uzyskać składnię zewnętrznych formatów plików, zobacz CREATE EXTERNAL FILE FORMAT.
- Informacje o składni tabeli zewnętrznej można znaleźć w CREATE EXTERNAL TABLE.
- Informacje o składni dostępu do danych ad hoc znajdują się w OPENROWSET.
- Informacje o składni CETAS można znaleźć tutaj: CREATE EXTERNAL TABLE AS SELECT (CETAS).
Aby uzyskać pełną dokumentację Transact-SQL dla wszystkich obiektów, zobacz Dokumentacja Transact-SQL technologii PolyBase.
Ważna
Sprawdź mapowanie typów danych dla formatu pliku zewnętrznego. Podczas tworzenia formatu pliku zewnętrznego lub wykonywania zapytań dotyczących plików przy użyciu programu OPENROWSETPolyBase automatycznie mapuje typy danych źródłowych (Parquet, CSV, Delta, Oracle, Teradata, MongoDB) na typy danych programu SQL Server. Niezgodne typy mogą powodować ciche obcinanie, utratę precyzji lub błędy zapytań. Na przykład Parquet DECIMAL(38,18) mapuje na DECIMAL(18,0). Przed zdefiniowaniem kolumn tabeli zewnętrznej lub klauzuli WITH przejrzyj tabele mapowania. Aby uzyskać pełną dokumentację, zobacz Mapowanie typów za pomocą technologii PolyBase.
Kiedy potrzebujesz CREATE MASTER KEY?
Klucz główny bazy danych (DMK) jest tworzony przy użyciu CREATE MASTER KEY składni. DMK szyfruje sekrety przechowywane w ramach poświadczeń bazodanowych. Jest to wymagane tylko wtedy, gdy poświadczenie zawiera wartość wpisu tajnego, czyli w przypadku przechowywania hasła, tokenu lub klucza dostępu.
Klucz DMK jest wymagany (poświadczenia przechowują tajne informacje):
Typ uwierzytelniania IDENTITYwartośćPosiada tajemnicę DMK token SAS 'SHARED ACCESS SIGNATURE'Yes Wymagane Klucz dostępu S3 'S3 ACCESS KEY'Yes Wymagane Logowanie SQL / uwierzytelnianie podstawowe '<username>'Yes Wymagane Klucz dostępu do konta przechowywania '<storage_account_name>'Yes Wymagane - Dane uwierzytelniające tokena SAS używają
IDENTITY = 'SHARED ACCESS SIGNATURE'i przechowują wartość sekretu, więc wymagają klucza głównego bazy danych. - Dane dostępu S3 używają
IDENTITY = 'S3 ACCESS KEY'i przechowują wartość tajną, więc wymagają klucza głównego bazy danych.- Logowanie SQL lub podstawowe uwierzytelnianie wykorzystuje
IDENTITY = '<username>'i przechowuje wartość tajną, więc wymaga klucza głównego bazy danych.
- Logowanie SQL lub podstawowe uwierzytelnianie wykorzystuje
- Dane dostępu do konta pamięci masowej używają
IDENTITY = '<storage_account_name>'i przechowują wartość tajemniczą, więc wymagają klucza głównego bazy danych.
- Dane uwierzytelniające tokena SAS używają
DMK nie jest wymagany (żaden sekret nie jest przechowywany):
Typ uwierzytelniania IDENTITYwartośćPosiada tajemnicę DMK Zarządzana Tożsamość 'Managed Identity'Nie. Niewymagane Microsoft Entra ID 'User Identity'lub'Managed Identity'Nie. Niewymagane - Poświadczenie tożsamości zarządzanej używa elementu
IDENTITY = 'Managed Identity'i nie przechowuje żadnych wpisów tajnych, więc nie wymaga klucza głównego bazy danych. - Poświadczenie Microsoft Entra ID używa
IDENTITY = 'User Identity'lubIDENTITY = 'Managed Identity'i nie przechowuje wpisu tajnego, więc nie wymaga klucza głównego bazy danych.
- Poświadczenie tożsamości zarządzanej używa elementu
Wskazówka
Jeśli twoje CREATE DATABASE SCOPED CREDENTIAL oświadczenie nie zawiera sekretu, nie potrzebujesz DMK. Zarządzana tożsamość i uwierzytelnianie Microsoft Entra ID przekazuje zaufanie do platformy. Baza danych nie przechowuje haseł ani tokenów.
Przykłady:
W tym przykładowym zapytaniu wymagany jest DMK (poświadczenie zawiera token SAS).
CREATE MASTER KEY ENCRYPTION BY PASSWORD = '<password>';

CREATE DATABASE SCOPED CREDENTIAL SasCred
WITH IDENTITY = 'SHARED ACCESS SIGNATURE',
     SECRET = '<your_SAS_token>';
W tym przykładowym zapytaniu klucz DMK nie jest wymagany (tożsamość zarządzana, bez hasła).
CREATE DATABASE SCOPED CREDENTIAL ManagedIdentityCred
WITH IDENTITY = 'Managed Identity';
W tym przykładowym zapytaniu klucz DMK nie jest wymagany (przekazywanie w usłudze Microsoft Entra, bez konieczności podawania hasła).
CREATE DATABASE SCOPED CREDENTIAL EntraIdCred
WITH IDENTITY = 'User Identity';
Zdalny dostęp do danych za pomocą zestawu OPENROWSET i tabel zewnętrznych
Program SQL Server oferuje trzy odrębne podejścia do wykonywania zapytań dotyczących danych zdalnych. Możesz wybrać odpowiednie podejście, gdy rozumiesz różnice w składni, uwierzytelnianiu i architekturze.
| Metoda | Składnia | Nawiązuje połączenie z | Uwierzytelnianie | Usługi PolyBase | Platformy |
|---|---|---|---|---|---|
| Zapytania OLE DB | OPENROWSET(provider, connection, query) |
Dowolne źródło OLE DB za pośrednictwem bazy danych MSOLEDBSQL, SQLOLEDB lub innych dostawców | Uwierzytelnianie SQL, uwierzytelnianie systemu Windows, Microsoft Entra ID (MSOLEDBSQL) | Nie. | SQL Server (wszystkie obsługiwane wersje) |
| Zapytania plików w SQL Server 2022 (16.x) oraz SQL Server 2019 (15.x) | OPENROWSET(BULK ...) |
Pliki na dysku lokalnym, sieci lub w chmurze (Azure Blob, ADLS, S3, OneLake) | Token SAS, klucz dostępu, tożsamość zarządzana, Microsoft Entra ID | Tak dla chmury 1; Nie dla lokalnej | SQL Server 2022 (16.x) oraz SQL Server 2019 (15.x) |
| Zapytania plikowe w SQL Server 2025 (17.x) i późniejszych wersjach | OPENROWSET(BULK ...) |
Pliki na dysku lokalnym, sieci lub w chmurze (Azure Blob, ADLS, S3, OneLake) | Token SAS, klucz dostępu, tożsamość zarządzana, Microsoft Entra ID | Nie. | SQL Server 2022 (16.x) i nowsze wersje, Azure SQL Database, Azure SQL Managed Instance, SQL Database in Fabric |
| Łączniki programu PolyBase |
CREATE EXTERNAL TABLEz użyciem CREATE EXTERNAL DATA SOURCE , sqlserver://, oracle://, teradata://, , mongodb://odbc:// |
Zdalne źródła programu SQL Server, Oracle, Teradata, MongoDB, ODBC | Tylko uwierzytelnianie SQL | Yes | SQL Server 2019 (15.x) i nowsze wersje (Windows); SQL Server 2025 (17.x) i nowsze wersje (Linux) |
1 Aby uzyskać dostęp do plików w chmurze w SQL Server 2022 (16.x), funkcja PolyBase musi być zainstalowana.
- Zapytania OLE DB używają elementu
OPENROWSET(provider, connection, query), aby łączyć się z dowolnym źródłem OLE DB za pośrednictwem MSOLEDBSQL, SQLOLEDB lub innego dostawcy we wszystkich obsługiwanych wersjach programu SQL Server. Obsługują uwierzytelnianie SQL, Windows authentication oraz Microsoft Entra ID z MSOLEDBSQL, a także nie wymagają instalacji usług PolyBase. - W zapytaniach dotyczących plików znacznik
OPENROWSET(BULK ...)służy do odczytywania plików z dysku lokalnego, udziałów sieciowych lub magazynów w chmurze, takich jak Azure Blob Storage, ADLS, S3 czy OneLake, przy użyciu tokenu SAS, klucza dostępu, Managed Identity lub Microsoft Entra ID. Są obsługiwane dla plików lokalnych i sieciowych w wersjach SQL Server 2005 i nowszych, dla plików w chmurze w wersjach SQL Server 2022 (16.x) i nowszych, a także w Azure SQL Database, Azure SQL Managed Instance oraz bazie danych SQL w Fabric. Zapytania plików nie wymagają usług PolyBase dla plików lokalnych ani dla plików chmurowych w wersjach SQL Server 2022 (16.x) i nowszych. - Konektory PolyBase służą do łączenia ze zdalnymi źródłami danych SQL Server, Oracle, Teradata, MongoDB lub ODBC przy użyciu
CREATE EXTERNAL TABLEzCREATE EXTERNAL DATA SOURCEoraz lokalizacji typusqlserver://,oracle://,teradata://,mongodb://lubodbc://. Wymagają uwierzytelniania SQL i usług PolyBase w SQL Server 2019 (15.x) oraz nowszych wersjach na Windows i SQL Server 2025 (17.x) oraz w późniejszych wersjach na Linuksie. Aby uzyskać więcej informacji, zobacz CREATE EXTERNAL DATA SOURCE (Transact-SQL).
Kiedy należy używać każdego podejścia
Użyj OLE DB OPENROWSET dla:
- Używaj OLE DB
OPENROWSETdo szybkich, jednorazowych ad hoc zapytań bez tworzenia trwałych obiektów. - Użyj OLE DB
OPENROWSETna potrzeby uwierzytelniania przy użyciu Microsoft Entra ID lub tożsamości zarządzanej za pomocą MSOLEDBSQL. - Użyj OLE DB
OPENROWSET, aby uniknąć zależności usług PolyBase. - Użyj OLE DB
OPENROWSET, aby połączyć się z dowolnym źródłem danych, które mają dostawcę OLE DB.
Użyj pliku OPENROWSET(BULK) dla:
- Używaj pliku
OPENROWSET(BULK ...)do ad hoc eksploracji plików i odkrywania schematów. - Użyj pliku
OPENROWSET(BULK ...)do szybkich transformacji i podglądów, zanim zdecydujesz się na definicję tabeli. - Użyj pliku
OPENROWSET(BULK ...)do elastycznych transformacji kolumn w linii, takich jak casting, filtrowanie i obliczane kolumny. - Użyj pliku
OPENROWSET(BULK ...)dla danych, które nie zmieniają się często i nie wymagają trwałych metadanych.
Użyj konektorów PolyBase z CREATE EXTERNAL TABLE do:
- Używaj łączników PolyBase z
CREATE EXTERNAL TABLEdo tworzenia trwałych definicji tabel wielokrotnego użytku, używanych przez wielu użytkowników lub wiele aplikacji. - Używaj łączników PolyBase z
CREATE EXTERNAL TABLEdla obciążeń produkcyjnych, które wymagają statystyk i optymalizacji planu zapytań. - Używaj konektorów PolyBase z
CREATE EXTERNAL TABLEdo wypychania przetwarzania do źródeł zdalnych, takich jak Oracle i SQL Server. - Używaj łączników PolyBase z
CREATE EXTERNAL TABLEna potrzeby wspólnego zarządzania i zabezpieczeń; po utworzeniu tabeli użytkownicy potrzebują tylko uprawnieniaSELECT. - Używaj konektorów PolyBase z
CREATE EXTERNAL TABLE, gdy dla źródła zdalnego jest dostępne uwierzytelnianie SQL.
OPENROWSET (OLE DB) — zapytania zdalne ad hoc (brak wymaganych usług PolyBase)
Formularz OPENROWSET OLE DB łączy się ze zdalnym źródłem danych za pośrednictwem dostawcy OLE DB, wykonuje zapytanie przekazywane i zwraca wyniki jako zestaw wierszy. Jest to jednorazowa alternatywa ad hoc dla serwera połączonego. Nie są tworzone trwałe metadane. Ta składnia nie wymaga usług PolyBase i nie obsługuje plików w chmurze ani zewnętrznych źródeł danych.
To przykładowe zapytanie łączy się ze zdalnym programem SQL Server za pośrednictwem ole DB (a nie z technologią PolyBase).
SELECT *
FROM OPENROWSET (
    'MSOLEDBSQL',
    'Server=remote-server;Database=AdventureWorks;Trusted_Connection=yes;',
    'SELECT TOP 10 * FROM AdventureWorks.Sales.SalesOrderHeader'
);
OPENROWSET(BULK) — zapytania oparte na plikach (PolyBase)
Forma BULKOPENROWSET odczytuje dane bezpośrednio z plików. W programie SQL Server 2019 (15.x) i starszych wersjach jest odczytywany ze ścieżek plików lokalnych lub UNC i wymaga pliku formatu. W programie SQL Server 2022 (16.x) i nowszych wersjach można odczytywać z magazynu w chmurze przy użyciu parametrów DATA_SOURCE i FORMAT. To podejście jest zintegrowaną z technologią PolyBase wersją używaną do wirtualizacji danych.
W kontekście technologii PolyBase i wirtualizacji danych, gdy ten przewodnik odwołuje się do OPENROWSET, oznacza to składnię OPENROWSET(BULK ...) z klauzulą FORMAT do zapytań dotyczących plików zewnętrznych.
Przykłady:
To przykładowe zapytanie odczytuje plik Parquet z usługi Azure Blob Storage (SQL Server 2022 i nowsze wersje).
SELECT TOP 10 *
FROM OPENROWSET (
    BULK 'data/sales/*.parquet',
    DATA_SOURCE = 'MyAzureStorage',
    FORMAT = 'PARQUET'
) AS [result];
To przykładowe zapytanie odczytuje plik Parquet ze ścieżką śródliniową (Azure SQL Database, Azure SQL Managed Instance).
SELECT TOP 10 *
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*.parquet',
    FORMAT = 'PARQUET'
) AS [result];
Kiedy należy używać tabel OPENROWSET czy tabel zewnętrznych
Zarówno OPENROWSET(BULK ...), jak i zewnętrzne tabele umożliwiają wykonywanie zapytań dotyczących danych zewnętrznych przy użyciu języka T-SQL, ale są zaprojektowane do różnych przypadków użycia. W poniższej tabeli podsumowano kluczowe różnice, które pomogą Ci zdecydować, które podejście pasuje do danego scenariusza.
| Zdolność | OPENROWSET(BULK ...) |
Tabela zewnętrzna |
|---|---|---|
| Przeznaczenie | Eksploracja ad hoc i jednorazowe zapytania | Trwała, wielokrotnego użytku definicja tabeli |
| Metadane przechowywane w bazie danych | Nie. Nic nie jest zapisywane po uruchomieniu zapytania | Tak. Definicja tabeli, źródło danych i format pliku są przechowywane jako obiekty bazy danych |
| Definicja schematu | Wnioskowane automatycznie z pliku (Parquet) lub określone w tekście z klauzulą WITH |
Zdefiniowano jawnie w oświadczeniu CREATE EXTERNAL TABLE |
| Uprawnienia | Wymaga ADMINISTER BULK OPERATIONS lub ADMINISTER DATABASE BULK OPERATIONS |
Standardowe SELECT uprawnienie do tabeli jest wystarczające po utworzeniu. |
| Obliczone kolumny | Tak. Dodaj wyrażenia i obliczone kolumny na SELECT liście; funkcje metadanych, takie jak filename() i filepath() są dostępne tylko tutaj. |
Nie. Stała lista kolumn; wykonywanie przekształceń w widoku lub w zapytaniu, które odczytuje tabelę zewnętrzną |
| Statystyki | Azure SQL Managed Instance: ręcznie tworzone statystyki dla pojedynczej kolumny za pomocą sys.sp_create_openrowset_statistics. Zobacz statystyki ręczne OPENROWSET. SQL Server 2022 (16.x) i nowsze, Azure SQL Database, baza danych SQL w usłudze Fabric: automatyczne tworzenie statystyk dla predykatów. Statystyki ręczne OPENROWSET nie są obsługiwane w SQL Server. |
Pełna CREATE STATISTICS obsługa na wszystkich platformach oraz automatyczne tworzenie w programie SQL Server 2022 (16.x) i nowszych wersjach. Zobacz Tworzenie ręcznych statystyk tabeli zewnętrznej. |
| Wypychanie | Ograniczona obsługa. Silnik może przesyłać filtry do skanowania plików, ale nie dokonuje przesyłania do zdalnych źródeł RDBMS | Tak. Obsługuje obliczenia typu pushdown dla konektorów RDBMS (SQL Server, Oracle, Teradata, MongoDB) |
| Najlepsze dla | Eksploracja danych, odnajdywanie schematów, tworzenie prototypów zapytań, jednorazowe ładowanie danych, elastyczne przekształcenia | Obciążenia produkcyjne, powtarzające się zapytania, dostęp współdzielony przez użytkowników, dashboardy i raporty |
-
OPENROWSET(BULK ...)jest najlepszy do ad hoc eksploracji i jednorazowych zapytań, natomiast zewnętrzna tabela jest lepsza do trwałych, wielokrotnego użytku definicji tabel. -
OPENROWSET(BULK ...)nie przechowuje metadanych w bazie danych po uruchomieniu zapytania, podczas gdy zewnętrzna tabela przechowuje definicję tabeli, źródło danych i format pliku jako obiekty bazy danych. -
OPENROWSET(BULK ...)automatycznie określa schemat na podstawie pliku Parquet lub definiuje go bezpośrednio za pomocą klauzuliWITH, natomiast tabela zewnętrzna jawnie definiuje schemat w instrukcjiCREATE EXTERNAL TABLE. -
OPENROWSET(BULK ...)wymagaADMINISTER BULK OPERATIONSlubADMINISTER DATABASE BULK OPERATIONS, podczas gdy tabela zewnętrzna może być odpytywana przez użytkowników, którzy potrzebują jedynie standardowego uprawnieniaSELECT, gdy tabela już istnieje. -
OPENROWSET(BULK ...)obsługuje obliczane kolumny w funkcjach zapytania i metadanych, takie jakfilename()ifilepath(), podczas gdy tabela zewnętrzna ma stałą listę kolumn i wymaga transformacji w widoku lub w zapytaniu odczytującym tę zewnętrzną tabelę. -
OPENROWSET(BULK ...)ma ograniczoną obsługę statystyk: Azure SQL Managed Instance może używaćsys.sp_create_openrowset_statisticsdo tworzenia statystyk jednokolumnowych, ale SQL Server 2022 (16.x) i nowsze wersje, Azure SQL Database oraz baza danych SQL w usłudze Fabric automatycznie tworzą statystyki dla predykatów. Statystyki ręczneOPENROWSETnie są obsługiwane w SQL Server, Azure SQL Database ani bazie SQL w Fabric. Tabela zewnętrzna obsługuje pełną funkcjonalnośćCREATE STATISTICSna wszystkich platformach oraz automatyczne statystyki w programie SQL Server 2022 (16.x) i nowszych wersjach, usłudze Azure SQL Database oraz bazie danych SQL na platformie Fabric. Zobacz statystyki ręczne dla OPENROWSET oraz Tworzenie ręcznych statystyk dla tabeli zewnętrznej. -
OPENROWSET(BULK ...)ma ograniczone możliwości przenoszenia przetwarzania do źródła danych i nie obsługuje takiego przenoszenia do zdalnych źródeł RDBMS, podczas gdy tabela zewnętrzna obsługuje przenoszenie obliczeń dla łączników RDBMS. -
OPENROWSET(BULK ...), lepiej nadaje się do eksploracji danych, poznawania schematu, prototypowania, jednorazowego ładowania danych i elastycznych transformacji, natomiast tabela zewnętrzna lepiej nadaje się do obciążeń produkcyjnych, powtarzalnych zapytań, współdzielonego dostępu, pulpitów nawigacyjnych i raportowania.
Użyj OPENROWSET, gdy wymagasz elastyczności
Służy OPENROWSET do eksplorowania pliku, testowania różnych schematów lub dodawania obliczonych kolumn i przekształceń bez tworzenia obiektów trwałych. Można na przykład wyodrębnić ścieżkę pliku jako kolumnę, rzutować typy danych w tekście lub filtrować wyrażenia obliczone w jednym zapytaniu.
To przykładowe zapytanie zawiera obliczone kolumny i przekształcenia:
SELECT result.filename() AS [FileName],
       result.filepath(1) AS [Year],
       result.filepath(2) AS [Month],
       CAST (OrderDate AS DATE) AS OrderDate,
       Amount,
       OrderDate
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*/*/*/*.parquet',
    FORMAT = 'PARQUET'
) AS result
WHERE result.filepath(1) = '2025';
Wskazówka
Funkcje filepath() i filename() są dostępne w usługach Azure SQL Database, Azure SQL Managed Instance i SQL Server 2022 (16.x) i nowszych wersjach. Umożliwiają one filtrowanie części ścieżki pliku (eliminacja partycji) i uwidocznienie nazwy pliku źródłowego jako kolumny, która nie jest bezpośrednio możliwa w przypadku tabel zewnętrznych.
Używanie tabel zewnętrznych, gdy potrzebujesz trwałości i ładu
Użyj tabel zewnętrznych, gdy wielu użytkowników lub aplikacji musi wielokrotnie wykonywać zapytania dotyczące tych samych danych zewnętrznych. Należy zdefiniować schemat, źródło danych i poświadczenia raz i zapisać je w bazie danych. Konsumenci potrzebują tylko SELECT uprawnień w tabeli.
Tabele zewnętrzne obsługują również statystyki, których optymalizator zapytań używa do tworzenia lepszych planów wykonywania. Statystyki można utworzyć ręcznie lub zezwolić aparatowi na automatyczne tworzenie (SQL Server 2022 (16.x) i nowszych wersjach.
To przykładowe zapytanie tworzy statystyki dotyczące tabeli zewnętrznej w celu uzyskania lepszych planów zapytań.
CREATE STATISTICS Stats_OrderDate
ON dbo.SalesExternal(OrderDate)
WITH FULLSCAN;
Aby uzyskać więcej informacji na temat statystyk obu podejść, zobacz Zagadnienia dotyczące wydajności technologii PolyBase — Statystyki.
BULK INSERT vs. OPENROWSET(BULK): Którego należy użyć?
Zarówno BULK INSERT, jak i OPENROWSET(BULK ...) importują dane z plików do programu SQL Server z użyciem tej samej podstawowej mechaniki ładowania zbiorczego. Różnią się one jednak składnią, elastycznością i tym, co można zrobić z wynikami. Poniższa tabela zawiera podsumowanie kluczowych różnic:
Uwaga / Notatka
Samodzielna instrukcja BULK INSERT nie jest obsługiwana w bazie danych SQL usługi Fabric. Aby pobrać dane, użyj INSERT ... SELECT przeciwko OPENROWSET(BULK ...) OneLake.
| Zdolność | BULK INSERT |
OPENROWSET(BULK ...) |
|---|---|---|
| Podstawowy cel | Ładuje dane z pliku bezpośrednio do tabeli docelowej | Zwraca zestaw wierszy, który używasz w instrukcji SELECT lub INSERT ... SELECT |
| Wzorzec użycia | Autonomiczne wyrażenie: BULK INSERT <table> FROM '<file>' |
Należy użyć wewnątrz zapytania: SELECT * FROM OPENROWSET(BULK ...) lub INSERT INTO <table> SELECT * FROM OPENROWSET(BULK ...) |
| Wymaga tabeli docelowej? | Tak. Zawsze zapisuje dane bezpośrednio w tabeli | Nie. Można to SELECT używać bez potrzeby wstawiania, lub wstawić do dowolnej tabeli albo tabeli tymczasowej. |
| Przekształcenia kolumn podczas ładowania | Ograniczona obsługa. Dane przepływa z pliku do tabeli as-is (mapowanie kontrolowane przez format pliku lub kolejność kolumn) | Pełna obsługa. Możesz dodawać wyrażenia, CASTWHERE filtry, JOIN inne tabele i obliczone kolumny w otaczającym środowiskuSELECT |
| Wskazówki dotyczące tabeli | Klauzula zawiera obsługę WITH, BATCHSIZE, CHECK_CONSTRAINTS, FIRE_TRIGGERS, KEEPIDENTITY, KEEPNULLS, TABLOCK i więcej |
Obsługuje podpowiedzi tabeli za pomocą składni INSERT ... SELECT * FROM OPENROWSET(BULK ...) WITH (TABLOCK, IGNORE_CONSTRAINTS, ...) |
| Importowanie pojedynczej wartości dużego obiektu (LOB) | Niewspierane | Tak. Obsługuje SINGLE_BLOB, SINGLE_CLOB, SINGLE_NCLOB w celu zaimportowania całego pliku jako jedną wartość varbinary(max), varchar(max) lub nvarchar(max) |
| Formatowanie plików | Tak. Obsługiwane za pośrednictwem (XML i nie-XML) | Tak. Obsługiwane (XML i inne niż XML) |
| Dostęp do plików w chmurze |
DATA_SOURCE obsługuje usługę Azure Blob Storage w programie SQL Server 2017 (14.x) i nowszych wersjach, Azure SQL Database oraz Azure SQL Managed Instance. SQL Server 2019 CU11 i późniejsze aktualizacje również wspierają ADLS Gen2. Nie jest obsługiwana pamięć kompatybilna z S3. |
DATA_SOURCE obsługuje usługę Azure Blob Storage w programie SQL Server 2017 (14.x) i nowszych wersjach, usługę ADLS Gen2 w programie SQL Server 2019 CU11 i nowszych wersjach oraz magazyn obiektów zgodny z S3 w programie SQL Server 2022 (16.x) i nowszych wersjach. Azure SQL Database i Azure SQL Managed Instance obsługują Azure Blob Storage i ADLS Gen2. Baza danych SQL w Fabric obsługuje OneLake oraz zewnętrzną pamięć za pomocą skrótów OneLake. |
| Pliki Parquet lub Delta | Niewspierane. Tylko format CSV lub tekst oddzielany | Tak. Programy SQL Server 2022 (16.x) i nowsze wersje, Azure SQL Managed Instance oraz Azure SQL Database obsługują FORMAT = 'PARQUET' i FORMAT = 'DELTA'; baza danych SQL w usłudze Fabric obsługuje FORMAT = 'PARQUET', ale nie DELTA. Aby uzyskać więcej informacji, zobacz OPENROWSET BULK (Transact-SQL). |
| Wymagane uprawnienie |
ADMINISTER BULK OPERATIONS lub ADMINISTER DATABASE BULK OPERATIONS, plus INSERT w tabeli docelowej |
ADMINISTER BULK OPERATIONS lub ADMINISTER DATABASE BULK OPERATIONS |
| Minimalne logowanie | Tak. Obsługiwane w ramach prostych lub zbiorczych modeli odzyskiwania za pomocą TABLOCK |
Tak. Obsługiwane przy użyciu INSERT ... SELECT i TABLOCK |
-
BULK INSERTładuje dane z pliku bezpośrednio do tabeli docelowej, aOPENROWSET(BULK ...)zwraca zbiór wierszy, którego można użyć w instrukcjiSELECTlubINSERT ... SELECT. -
BULK INSERTjest zdaniem samodzielnym, natomiastOPENROWSET(BULK ...)musi być użyte wewnątrz zapytania takiego jakSELECT * FROM OPENROWSET(BULK ...)lubINSERT INTO <table> SELECT * FROM OPENROWSET(BULK ...). -
BULK INSERTzawsze zapisuje bezpośrednio do tabeli docelowej, natomiastOPENROWSET(BULK ...)możeSELECTz pliku bez wstawiania danych gdziekolwiek albo wstawiać je do dowolnej tabeli lub tabeli tymczasowej. -
BULK INSERTma ograniczone wsparcie dla transformacji kolumn, ponieważ dane przepływają z pliku do tabeli as-is, a mapowanie jest kontrolowane przez format pliku lub kolejność kolumn.OPENROWSET(BULK ...)obsługuje wyrażenia,CAST, filtryWHERE, elementyJOINoraz kolumny obliczeniowe w otaczającym elemencieSELECT. -
BULK INSERTużywa zdaniaWITHdlaBATCHSIZE,CHECK_CONSTRAINTS,FIRE_TRIGGERS,KEEPIDENTITY,KEEPNULLS,TABLOCK, , oraz innych podpowiedzi.OPENROWSET(BULK ...)obsługuje wskazówki dotyczące tabel za pomocąINSERT ... SELECT * FROM OPENROWSET(BULK ...) WITH (TABLOCK, IGNORE_CONSTRAINTS, ...). -
BULK INSERTnie obsługuje importu pojedynczych wartości dużych obiektów.OPENROWSET(BULK ...)obsługujeSINGLE_BLOB,SINGLE_CLOBorazSINGLE_NCLOBdo zaimportowania całego pliku jako jednej wartości varbinary(max), varchar(max) lub nvarchar(max), odpowiednio. - Zarówno
BULK INSERT, jak iOPENROWSET(BULK ...), obsługują pliki w formacie XML i inne niż XML. - W przypadku dostępu do plików w chmurze przy użyciu elementu
BULK INSERTparametrDATA_SOURCEobsługuje usługę Azure Blob Storage w programie SQL Server 2017 (14.x) i nowszych wersjach, usłudze Azure SQL Database oraz usłudze Azure SQL Managed Instance. Aktualizacje SQL Server 2019 CU11 i późniejsze również wspierają ADLS Gen2, aleBULK INSERTnie obsługują pamięci kompatybilnej z S3. W przypadkuOPENROWSET(BULK ...),DATA_SOURCEobsługuje usługę Azure Blob Storage w programie SQL Server 2017 (14.x) i nowszych wersjach, ADLS Gen2 w programie SQL Server 2019 CU11 i nowszych wersjach oraz magazyn obiektów zgodny z S3 w programie SQL Server 2022 (16.x) i nowszych wersjach. Azure SQL Database i Azure SQL Managed Instance obsługują Azure Blob Storage i ADLS Gen2. Baza danych SQL w Fabric obsługuje OneLake oraz zewnętrzną pamięć za pomocą skrótów OneLake. -
BULK INSERTnie obsługuje plików Parquet ani Delta, a obsługuje jedynie CSV lub tekst delimitowany.OPENROWSET(BULK ...)obsługujeFORMAT = 'PARQUET'iFORMAT = 'DELTA'w programie SQL Server 2022 (16.x) i nowszych wersjach, Azure SQL Database i Azure SQL Managed Instance. Baza danych SQL w Fabric obsługujeFORMAT = 'DELTA', ale nieFORMAT = 'PARQUET'. Aby uzyskać więcej informacji, zobacz OPENROWSET BULK (Transact-SQL). -
BULK INSERTwymagaADMINISTER BULK OPERATIONSlubADMINISTER DATABASE BULK OPERATIONSplusINSERTuprawnienia na tabeli docelowej, podczas gdyOPENROWSET(BULK ...)wymagaADMINISTER BULK OPERATIONSlubADMINISTER DATABASE BULK OPERATIONS. -
BULK INSERTobsługuje minimalne rejestrowanie w modelu odzyskiwania prostego lub z logowaniem zbiorczym z użyciemTABLOCK.OPENROWSET(BULK ...)obsługuje minimalne logowanie, gdy jest używany zINSERT ... SELECTiTABLOCK.
Kiedy wybrać BULK INSERT
Użyj BULK INSERT, gdy masz proste załadowanie pliku do tabeli i nie trzeba przekształcać, filtrować ani łączyć danych przy imporcie. Używa prostszej składni dla plików CSV lub innych plików rozdzielonych:
To przykładowe zapytanie ładuje plik CSV z usługi Azure Blob Storage bezpośrednio do tabeli.
BULK INSERT Sales.Invoices
FROM 'invoices/inv-2025-01.csv'
WITH (
    DATA_SOURCE = 'MyAzureBlobStorage',
    FORMAT = 'CSV',
    FIRSTROW = 2,
    FIELDTERMINATOR = ',',
    ROWTERMINATOR = '\n'
);
To przykładowe zapytanie ładuje plik lokalny z plikiem formatu do mapowania kolumn.
BULK INSERT dbo.Products
FROM 'C:\Data\products.csv'
WITH (
    FORMATFILE = 'C:\Data\products.fmt',
    FIRSTROW = 2,
    TABLOCK
);
Kiedy wybrać opcję OPENROWSET(BULK)
Użyj OPENROWSET(BULK ...) , jeśli potrzebujesz co najmniej jednego z następujących warunków:
- Użyj
OPENROWSET(BULK ...), aby wykonywać zapytania dotyczące danych plików lub wyświetlać ich podgląd bez konieczności wcześniejszego tworzenia tabeli. - Użyj
OPENROWSET(BULK ...)do transformacji, filtrowania lub łączenia danych podczas importu. - Użyj
OPENROWSET(BULK ...)do ładowania plików Parquet lub Delta, ponieważBULK INSERTnie obsługuje tych formatów. - Użyj
OPENROWSET(BULK ...)do importu całego pliku jako jednej wartości LOB zSINGLE_BLOB,SINGLE_CLOB, lubSINGLE_NCLOB.
To przykładowe zapytanie wyświetla podgląd pliku CSV z usługi Azure Blob Storage bez wstawiania danych w dowolnym miejscu.
SELECT TOP 10 *
FROM OPENROWSET (
    BULK 'invoices/inv-2025-01.csv',
    DATA_SOURCE = 'MyAzureBlobStorage',
    FORMAT = 'CSV',
    FIRSTROW = 2,
    FIELDTERMINATOR = ','
) AS src;
To przykładowe zapytanie wstawia dane z przekształcaniem i filtrowaniem.
INSERT INTO Sales.Invoices (InvoiceDate, Amount, Customer)
SELECT CAST (InvoiceDate AS DATE),
       Amount * 1.1, -- Apply a 10% markup
       UPPER(Customer)
FROM OPENROWSET (
    BULK 'invoices/inv-2025-01.csv',
    DATA_SOURCE = 'MyAzureBlobStorage',
    FORMAT = 'CSV',
    FIRSTROW = 2
) WITH (
    InvoiceDate VARCHAR (10),
    Amount DECIMAL (18, 2),
    Customer VARCHAR (100)
) AS src
WHERE Amount IS NOT NULL;
To przykładowe zapytanie ładuje plik Parquet (jest to niemożliwe z BULK INSERT).
INSERT INTO Sales.Invoices
SELECT *
FROM OPENROWSET (
    BULK 'data/invoices/*.parquet',
    DATA_SOURCE = 'MyAzureStorage',
    FORMAT = 'PARQUET') AS src;
To przykładowe zapytanie importuje cały plik XML jako pojedynczą wartość varbinary(max).
INSERT INTO dbo.XmlDocuments (DocContent)
SELECT BulkColumn
FROM OPENROWSET (
    BULK 'C:\Data\catalog.xml',
    SINGLE_BLOB
) AS x;
Wskazówka
Jednym z podejść jest rozpoczęcie od OPENROWSET(BULK ...) w SELECT w celu eksploracji i weryfikacji danych plików, a następnie przełączenie się do BULK INSERT do końcowego obciążenia produkcyjnego, jeśli nie potrzebujesz przekształceń. Jeśli potrzebujesz obsługi Parquet lub Delta albo filtrowania wbudowanego, pozostań przy OPENROWSET.
Aby uzyskać więcej informacji, zobacz następujące powiązane przewodniki:
- Artykuł Używanie BULK INSERT lub OPENROWSET(BULK...) do importowania danych do programu SQL Server zawiera szczegółowe porównanie z uwzględnieniem kwestii zabezpieczeń.
- Artykuł Bulk Import and Export of Data (SQL Server) przedstawia przegląd wszystkich metod masowego przenoszenia danych, w tym bcp,
BULK INSERT, orazOPENROWSET. - Artykuł BULK INSERT (Transact-SQL) zawiera pełne źródło T-SQL dla
BULK INSERT. - Artykuł OPENROWSET BULK (Transact-SQL) zawiera pełne źródło T-SQL dla
OPENROWSET(BULK ...). - Artykuł "Przykłady masowego dostępu do danych w Azure Blob Storage" przedstawia przykłady wykorzystujące obie metody z Azure Storage.
- Artykuł o masowym importowaniu danych dużych obiektów za pomocą OPENROWSET Bulk Rowset Provider (SQL Server) zawiera
SINGLE_BLOB,SINGLE_CLOB, orazSINGLE_NCLOBprzykłady. - Artykuł o używaniu pliku formatowanego do masowego importu danych (SQL Server) wyjaśnia użycie formatu plików obiema metodami.
- Aby uzyskać wskazówki dotyczące zachowania wartości null lub stosowania wartości domyślnych podczas importu masowego, zobacz Zachowywanie wartości null lub wartości domyślnych podczas importu masowego (SQL Server).
- Aby uzyskać wskazówki dotyczące zachowania wartości tożsamości podczas masowego importu, zobacz Zachowaj wartości tożsamości podczas masowego importu danych (SQL Server).
Przydatne funkcje metadanych
Gdy odpytujesz pliki zewnętrzne za pomocą OPENROWSET lub tabel zewnętrznych, używaj wbudowanych funkcji i procedur do sprawdzania metadanych plików, wykrywania schematów oraz tworzenia zapytań uwzględniających partycjonowanie.
filepath() i nazwa pliku()
Funkcje filepath() i filename() zwracają części ścieżki pliku lub nazwy pliku dla każdego wiersza w zestawie wyników. Są one szczególnie przydatne w następujących celach:
Eliminacja partycji: filtruj według segmentów folderów (na przykład partycji roku/miesiąca/dnia), aby aparat odczytywał tylko pasujące pliki zamiast skanować wszystko.
Uwidacznianie metadanych źródłowych: dołącz nazwę pliku źródłowego lub ścieżkę jako kolumnę w wynikach zapytania, co jest przydatne w przypadku inspekcji lub debugowania.
| Function | Zwroty | Przykład |
|---|---|---|
filename() |
Nazwa pliku źródłowego (w tym rozszerzenie) pliku źródłowego dla każdego wiersza | sales_2025_01.parquet |
filepath(N) |
N-ty segment folderu z symbolu wieloznacznego () w ścieżce *, gdzie BULK zaczyna się od 1 |
W przypadku ścieżki sales/2025/01/*.parquetfilepath(1) zwraca wartość 2025, filepath(2) zwraca wartość01 |
Dotyczy: Azure SQL Database, Azure SQL Managed Instance, SQL Server 2022 (16.x) i nowsze wersje, baza danych SQL w sieci szkieletowej.
To przykładowe zapytanie używa filepath() funkcji eliminacji partycji i filename() identyfikowania plików źródłowych. Odczytuje tylko pliki w folderze /2025/ i odczytuje tylko pliki w podfolderze /06/ .
SELECT result.filename() AS SourceFile,
       result.filepath(1) AS [Year],
       result.filepath(2) AS [Month],
       *
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*/*/*.parquet',
    FORMAT = 'PARQUET'
) AS result
WHERE result.filepath(1) = '2025'
      AND result.filepath(2) = '06';
Wskazówka
Umieść filtry w klauzuli filepath(), a nie w podzapytaniu lub CTE WHERE. Gdy filtr znajduje się w klauzuli WHERE, silnik może przeprowadzić usunięcie partycji na poziomie skanowania plików, co znacznie zmniejsza operacje wejścia/wyjścia.
sp_describe_first_result_set — odnajdywanie typów kolumn OPENROWSET
Podczas używania OPENROWSET z plikami Parquet, silnik automatycznie wnioskuje typy danych kolumn (wnioskowanie schematu). Wnioskowane typy mogą być większe niż jest to konieczne. Na przykład kolumny znaków są często wnioskowane jako varchar(8000), ponieważ metadane Parquet nie zawierają maksymalnej długości. Ten wybór może obniżyć wydajność i zużywać więcej pamięci.
Użyj sp_describe_first_result_set polecenia , aby sprawdzić wywnioskowany schemat przed zakończeniem zapytania. Po wyświetleniu wywnioskowanych typów określ w klauzuli WITH węższe typy, aby zwiększyć wydajność.
Krok 1. Sprawdzanie wywnioskowanego schematu.
EXECUTE sp_describe_first_result_set N'
SELECT *
FROM OPENROWSET(
    BULK ''abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*.parquet'',
    FORMAT = ''PARQUET''
) AS result';
Dane wyjściowe zawierają nazwę każdej kolumny, wywnioskowany typ danych, maksymalną długość, precyzję i skalę. Jeśli zobaczysz varchar(8000) tam, gdzie varchar(100) w zupełności wystarczy, zastąp go.
Krok 2. Używanie typów jawnych w celu uzyskania lepszej wydajności.
SELECT TOP 100 *
FROM OPENROWSET (
    BULK 'abs://mycontainer@mystorageaccount.blob.core.windows.net/data/sales/*.parquet',
    FORMAT = 'PARQUET'
) WITH (
    OrderId INT,
    OrderDate DATE,
    Amount DECIMAL (18, 2),
    Customer VARCHAR (100) -- much narrower than the inferred varchar(8000)
) AS result;
Wnioskowanie schematu działa tylko z plikami Parquet. W przypadku plików CSV zawsze określ definicje kolumn w klauzuli WITH (for OPENROWSET) lub w instrukcji CREATE EXTERNAL TABLE .
sp_describe_first_result_set to ogólna procedura dla SQL Server, Azure SQL Database, Azure SQL Managed Instance oraz bazy danych SQL usługi Fabric, ale jest szczególnie przydatna w przypadku zapytań OPENROWSET. Więcej informacji można znaleźć w sp_describe_first_result_set.
Wydajność, rozwiązywanie problemów i najlepsze rozwiązania
Po zaimplementowaniu wirtualizacji danych skorzystaj z tych przewodników, aby zoptymalizować wydajność, zdiagnozować problemy i zapewnić gotowość produkcyjną:
| Obszar | Artykuł | Szczegóły |
|---|---|---|
| Wydajność technologii PolyBase | zagadnienia dotyczące wydajności w programie PolyBase dla programu SQL Server | Statystyki, wypychanie, równoległość i zarządzanie pamięcią |
| Obliczenia wypychane | Obliczenia przesuwne w PolyBase | Określa, które działania są wypychane do zdalnego źródła |
| Jak sprawdzić, czy wystąpiło przesunięcie w dół | Jak sprawdzić, czy wystąpiło zewnętrzne wypychanie | Plany zapytań i dynamiczne widoki zarządzania |
| Troubleshooting | Monitorowanie i rozwiązywanie problemów z technologią PolyBase | Common errors and resolutions (Typowe błędy i rozwiązania) |
| Łączność protokołu Kerberos | Rozwiązywanie problemów z łącznością Kerberos w PolyBase | |
| Często zadawane pytania | Często zadawane pytania dotyczące technologii PolyBase | |
| Błędy i rozwiązania | błędów technologii PolyBase i możliwych rozwiązań |