Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Dotyczy: SQL ServerAzure SQL DatabaseAzure SQL Managed InstanceBaza danych SQL w usłudze Microsoft Fabric
Aparat bazy danych programu SQL Server przetwarza zapytania dotyczące różnych architektur magazynu danych, takich jak tabele lokalne, tabele partycjonowane i tabele rozproszone na wielu serwerach. Poniższe sekcje opisują, jak Database Engine przetwarza zapytania i optymalizuje ponowne wykorzystanie zapytań poprzez buforowanie planów wykonawczych.
Przykłady kodu w tym artykule korzystają z przykładowej bazy danych AdventureWorksDW2025, AdventureWorksLT2025 lub AdventureWorks2025, którą można pobrać z repozytorium GitHub Azure Data SQL Samples Repository.
Tryby wykonywania
SQL Server Database Engine może przetwarzać Transact-SQL (T-SQL) za pomocą dwóch odrębnych trybów przetwarzania:
- Wykonywanie trybu wierszowego
- Wykonywanie w trybie wsadowym
Wykonywanie trybu wierszowego
Wykonywanie w trybie wierszowym to metoda przetwarzania zapytań stosowana w tabelach i indeksach magazynu wierszy, gdzie dane są przechowywane w formacie wierszowym. Gdy zapytanie zostanie wykonane i uzyska dostęp do danych w tabelach i indeksach magazynu wierszy, operatory drzewa wykonawczego i operatory potomne odczytują każdy wymagany wiersz, we wszystkich kolumnach określonych w schemacie obiektów. Z każdego odczytanego wiersza Database Engine pobiera kolumny wymagane dla zbioru wyników, wskazane przez instrukcję SELECT, predykat JOIN lub predykat filtracyjny.
Uwaga / Notatka
Wykonywanie w trybie wierszowym jest bardzo wydajne w scenariuszach OLTP, ale może być mniej efektywne podczas skanowania dużych ilości danych, na przykład w scenariuszach hurtowni danych.
Wykonywanie w trybie wsadowym
Wykonywanie w trybie wsadowym to metoda przetwarzania zapytań, która przetwarza wiele wierszy naraz (stąd termin wsadowy). Każda kolumna w partii jest przechowywana jako wektor w osobnym obszarze pamięci, więc przetwarzanie w trybie wsadowym jest oparte na wektorach. Przetwarzanie w trybie wsadowym wykorzystuje także algorytmy zoptymalizowane pod kątem zaawansowanych zestawów instrukcji i zwiększonej przepustowości pamięci w nowoczesnych procesorach.
Wykonywanie w trybie wsadowym było pierwotnie zintegrowane i zoptymalizowane wokół formatu magazynu kolumnowego. Począwszy od SQL Server 2019 (15.x) i w Azure SQL Database, wykonywanie w trybie wsadowym nie wymaga indeksów columnstore. Aby uzyskać więcej informacji, zobacz Tryb usługi Batch w magazynie wierszy.
Przetwarzanie w trybie wsadowym pracuje na skompresowanych danych, gdy jest to możliwe, i eliminuje operator wymiany, którego używa wykonywanie w trybie wierszowym. Rezultatem jest lepsza równoległość i szybsza wydajność.
Gdy zapytanie działa w trybie wsadowym i uzyskuje dostęp do danych w indeksach columnstore, operatory drzewa wykonawczego i operatory potomne odczytują wiele wierszy razem w segmentach kolumn. Mechanizm bazy danych odczytuje tylko kolumny wymagane w wyniku, zgodnie z odwołaniami w instrukcji SELECT, predykacie JOIN lub predykacie filtru. Więcej informacji o indeksach columnstore można znaleźć w artykule Columnstore Index Architecture.
Uwaga / Notatka
Wykonywanie w trybie wsadowym jest bardzo efektywne w scenariuszach hurtowni danych, gdzie można odczytywać i agregować duże ilości danych.
Przetwarzanie instrukcji SQL
Przetwarzanie pojedynczego zapytania T-SQL to najprostszy sposób, w jaki Database Engine wykonuje instrukcje T-SQL. Poniższe kroki ilustrują podstawowy proces poprzez przetwarzanie pojedynczej SELECT instrukcji, która odnosi się wyłącznie do lokalnych tabel bazowych (bez widoków ani zdalnych tabel).
Pierwszeństwo operatora logicznego
Gdy używasz więcej niż jednego operatora logicznego w instrukcji, NOT jest obliczany najpierw, potem AND, a na końcu OR. Operatory arytmetyczne i bitowe są obsługiwane przed operatorami logicznymi. Więcej informacji można znaleźć w artykule Priorytet operatorów.
W poniższym przykładzie warunek koloru dotyczy modelu produktu 21, a nie modelu produktu 20, ponieważ AND ma pierwszeństwo nad OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Używanie nawiasów, nawet gdy nie są wymagane, może poprawić czytelność zapytań i zmniejszyć ryzyko błędu z powodu pierwszeństwa operatorów. Poniższy przykład jest bardziej czytelny niż poprzedni i ma to samo znaczenie.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Znaczenie zapytania można zmienić, dodając nawiasy, aby wymusić wykonanie OR jako pierwszego. Poniższe zapytanie znajduje tylko produkty w modelach 20 i 21, które są czerwone.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Optymalizowanie instrukcji SELECT
Instrukcja SELECT nie jest proceduralna; nie określa dokładnych kroków, których serwer bazy danych powinien użyć do pobrania żądanych danych. To zachowanie deklaratywne oznacza, że serwer bazy danych musi przeanalizować instrukcję i bazę danych, aby określić najefektywniejszy sposób wyodrębnienia żądanych danych. Proces ten jest nazywany optymalizacją planu zapytań. Komponentem wykonującym to zadanie jest Query Optimizer. Dane wejściowe do Query Optimizera składają się z zapytania, schematu bazy danych (definicji obiektów) oraz statystyk obiektowych. Wyjściem Optymalizatora zapytań jest plan wykonania zapytań, czasem nazywany planem zapytania lub planem realizacji. Treść planu wykonania jest szczegółowo opisana w sekcji Buforowanie i ponowne użycie planu wykonania.
Poniższy diagram ilustruje wejścia i wyjścia optymalizatora zapytań podczas optymalizacji pojedynczej SELECT instrukcji:
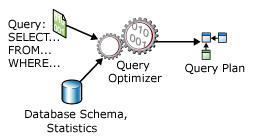
Instrukcja definiuje tylko: SELECT
- Format zestawu wyników. Jest to określane głównie na liście wyboru. Jednak inne klauzule, takie jak
ORDER BYiGROUP BYrównież wpływają na ostateczną formę zestawu wyników. - Tabele zawierające dane źródłowe. Jest to określone w klauzuli
FROM. - Sposób, w jaki tabele są logicznie powiązane na potrzeby instrukcji
SELECT. Jest to zdefiniowane w wyrażeniu łączącym, które może pojawić się w klauzuliWHERElub w klauzuliONnastępującej poFROM. - Warunki, które muszą spełniać wiersze w tabelach źródłowych, aby kwalifikować się do instrukcji
SELECT. Określone są w klauzulachWHEREiHAVING.
Plan wykonania zapytań definiuje:
Sekwencja, w której uzyskuje się dostęp do tabel źródłowych.
Zazwyczaj serwer bazy danych może uzyskać dostęp do tabel bazowych w wielu sekwencjach, aby zbudować zbiór wyników. Na przykład, jeśli instrukcja
SELECTodwołuje się do trzech tabel, serwer bazy danych może najpierw uzyskać dostęp doTableA, użyć danych zTableA, aby wyodrębnić pasujące wiersze zTableB, a następnie użyć danych zTableB, aby wyodrębnić dane zTableC. Inne sekwencje, w których serwer bazy danych może uzyskać dostęp do tabel, to:TableC,TableB,TableAlub
TableB,TableA,TableClub
TableB,TableC,TableAlub
TableC,TableATableBMetody używane do wyodrębniania danych z każdej tabeli.
Ogólnie rzecz biorąc, istnieją różne metody uzyskiwania dostępu do danych w każdej tabeli. Jeśli potrzebne są tylko kilka wierszy z określonymi wartościami klucza, serwer bazy danych może szybko wyszukiwać wiersze lub skanować niewielki zakres indeksów. Jeśli wszystkie wiersze w tabeli są wymagane, serwer bazy danych może zamiast tego przeskanować całą tabelę lub indeks. Jeśli wszystkie wiersze w tabeli są wymagane, ale istnieje indeks, którego kolumny klucza są w
ORDER BY, wykonanie skanowania indeksu zamiast skanowania tabeli może pozwolić uniknąć osobnego sortowania zbioru wyników. Jeśli tabela jest bardzo mała, pełne skany mogą być najefektywniejszą metodą dla prawie wszystkich operacji dostępu do tabeli.Metody używane do obliczania obliczeń oraz sposób filtrowania, agregowania i sortowania danych z każdej tabeli.
Podczas uzyskiwania dostępu do danych z tabel różne metody wykonują obliczenia na danych, takie jak obliczanie wartości skalarnych, a także agregują i sortują dane zgodnie z definicją tekstu zapytania. Na przykład przy użyciu klauzuli
GROUP BYlubORDER BYoraz jak filtrować dane, na przykład przy użyciu klauzuliWHERElubHAVING.
Proces wybierania jednego planu wykonania z potencjalnie wielu możliwych planów jest określany jako optymalizacja. Optymalizator zapytań jest jednym z najważniejszych składników aparatu bazy danych. Chociaż Query Optimizer ponosi pewien narzut związany z analizą zapytania i wyborem planu, koszt ten zwykle zwraca się wielokrotnie, gdy Query Optimizer wybiera efektywny plan wykonania. Na przykład dwie firmy budowlane mogą mieć identyczne strategie dla domu. Jeśli jedna firma poświęca kilka dni na zaplanowanie budowy domu, a druga zaczyna budować bez planowania, to firma, która poświęci czas na zaplanowanie projektu, prawdopodobnie kończy pierwsza.
Query Optimizer to optymalizator zapytań oparty na kosztach. Każdy możliwy plan wykonania ma skojarzony koszt pod względem ilości używanych zasobów obliczeniowych. Optymalizator zapytań musi przeanalizować możliwe plany i wybrać ten z najniższym szacowanymi kosztami. Niektóre złożone instrukcje mają tysiące możliwych planów wykonania. W takich przypadkach optymalizator zapytań nie analizuje wszystkich możliwych kombinacji. Zamiast tego używa złożonych algorytmów do znalezienia planu wykonania, który ma koszt rozsądnie zbliżony do minimalnego możliwego kosztu.
Optymalizator zapytań niekoniecznie wybiera plan realizacji o najniższym szacunkowym koszcie. Znajduje plan z rozsądnym szacunkowym kosztem w dostępnym czasie na optymalizację. Równoległy plan wykonania może zużywać więcej zasobów niż plan szeregowy, jednocześnie skracając szacowany czas wykonania.
SQL Server Query Optimizer opiera się na statystykach przy szacowaniu kosztów zasobów różnych metod wydobywania informacji z tabeli lub indeksu. Statystyki są prowadzone dla kolumn i indeksów i zawierają informacje o gęstości1 danych źródłowych. Informacje te wskazują selektywność wartości w danym indeksie lub kolumnie. Na przykład w tabeli reprezentującej samochody wiele samochodów ma tego samego producenta, ale każdy samochód ma unikatowy numer identyfikacyjny pojazdu (VIN). Indeks dotyczący VIN jest bardziej selektywny niż indeks dotyczący producenta, ponieważ VIN ma niższą gęstość niż producent. Jeśli statystyki indeksu nie są aktualne, optymalizator zapytań może nie dokonać najlepszego wyboru dla bieżącego stanu tabeli. Aby uzyskać więcej informacji na temat gęstości, zobacz Statystyki.
1 Gęstość definiuje rozkład unikatowych wartości, które istnieją w danych, lub średnią liczbę zduplikowanych wartości dla danej kolumny. W miarę spadku gęstości wybór wartości zwiększa się.
Optymalizator zapytań jest ważny, ponieważ pozwala serwerowi bazy danych dynamicznie dostosowywać się do zmieniających się warunków w bazie bez konieczności udziału programisty czy administratora bazy danych. Ta funkcja pozwala deweloperom skupić się na opisie końcowego wyniku zapytania. Mogą zaufać optymalizatorowi zapytań, aby za każdym razem opracował wydajny plan wykonania dla bieżącego stanu bazy danych, gdy optymalizowany jest plan zapytania dla instrukcji.
Uwaga / Notatka
Program SQL Server Management Studio ma trzy opcje wyświetlania planów wykonywania:
- Szacowany Plan Realizacji, czyli skompilowany plan, opracowany przez Optymalizator Zapytań.
- Rzeczywisty plan wykonania, który jest taki sam jak skompilowany plan wraz z jego kontekstem wykonawczym. Ten kontekst obejmuje informacje o środowisku uruchomieniowym dostępne po zakończeniu wykonywania, takie jak ostrzeżenia dotyczące wykonania lub, w nowszych wersjach Database Engine, czas, jaki upłynął, oraz czas CPU używany podczas wykonywania.
- Statystyki zapytań na żywo, czyli skompilowany plan wraz z jego kontekstem wykonawczym. Ten kontekst obejmuje informacje środowiska uruchomieniowego podczas postępu wykonywania i jest aktualizowany co sekundę. Informacje w czasie wykonywania obejmują na przykład rzeczywistą liczbę wierszy przepływających przez operatory.
Przetwórz instrukcję SELECT
Database Engine przetwarza pojedynczą SELECT instrukcję, wykonując następujące kroki:
- Analizator skanuje instrukcję
SELECTi dzieli ją na jednostki logiczne, takie jak słowa kluczowe, wyrażenia, operatory i identyfikatory. - Budowane jest drzewo zapytań, czasem nazywane drzewem sekwencji, opisujące logiczne kroki potrzebne do przekształcenia danych źródłowych w format wymagany przez zestaw wyników.
- Query Optimizer analizuje różne sposoby dostępu do tabel źródłowych. Wybiera serię kroków, która zwraca wyniki najszybciej, zużywając przy tym mniej zasobów. Aktualizuje drzewo zapytań, aby zapisać dokładnie tę serię kroków. Ostateczna, zoptymalizowana wersja drzewa zapytań jest nazywana planem wykonywania.
- Silnik relacyjny zaczyna realizować plan. Podczas przetwarzania kroków wymagających danych z tabel bazowych żąda wymaganych zestawów wierszy od silnika magazynu danych.
- Silnik relacyjny przetwarza dane zwrócone przez silnik magazynowania w zdefiniowanym formacie dla zestawu wyników i zwraca zestaw wyników do klienta.
Stałe składanie i obliczanie wyrażeń
Aparat bazy danych ocenia niektóre wyrażenia stałe na wczesnym etapie w celu zwiększenia wydajności zapytań. Ta technika optymalizacji stosowana przez Optymalizator zapytań ma na celu uproszczenie wyrażeń w czasie kompilacji, a nie w trakcie wykonywania. Obejmuje to obliczanie wyrażeń stałych podczas kompilacji zapytań, dzięki czemu wynikowy plan wykonania jest bardziej wydajny. Proces ten nazywany jest składaniem stałych. Stała to literał T-SQL, taki jak 3, 'ABC', '2025-12-31', 1.0e3 lub 0x12345678. Na przykład wykonaj następujące zapytanie:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Tutaj 30 * 12 jest stałym wyrażeniem. Database Engine ocenia to wyrażenie podczas kompilacji i może przepisać zapytanie wewnętrznie jako:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Wyrażenia składane
Aparat bazy danych wykorzystuje upraszczanie stałych z następującymi typami wyrażeń:
- Wyrażenia arytmetyczne, takie jak
1 + 1i5 / 3 * 2, zawierają tylko stałe. - Wyrażenia logiczne, takie jak
1 = 1i1 > 2 AND 3 > 4, zawierające tylko stałe. - Wbudowane funkcje, które Database Engine uznaje za składane, w tym
CASTorazCONVERT. Zazwyczaj funkcja wewnętrzna jest zwijana, jeśli jest funkcją wyłącznie swoich danych wejściowych, a nie innych informacji kontekstowych, takich jakSETopcje, ustawienia języka, opcje bazy danych czy klucze szyfrujące. Funkcje niedeterministyczne nie są składane. Deterministyczne funkcje wbudowane są zawijalne, z pewnymi wyjątkami. - Deterministyczne metody typów CLR zdefiniowanych przez użytkownika oraz deterministyczne funkcje CLR o wartościach skalarnych zdefiniowane przez użytkownika. Aby uzyskać więcej informacji, zobacz Constant Folding for CLR User-Defined Functions and Methods (Stałe składanie dla funkcji i metod CLR User-Defined).
Uwaga / Notatka
Wyjątek dotyczy dużych typów obiektów. Jeśli typ wyjściowy procesu składania to duży typ obiektu (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json lub xml), Database Engine nie składa wyrażenia.
Wyrażenia niefoldowalne
Wszystkie inne typy wyrażeń nie są składane. W szczególności następujące typy wyrażeń nie są składane:
- Wyrażenia niezdecydowane, takie jak wyrażenie, którego wynik zależy od wartości kolumny.
- Wyrażenia, których wyniki zależą od zmiennej lokalnej lub parametru, na przykład
@x. - Funkcje nieokreślone.
- Funkcje T-SQL zdefiniowane przez użytkownika.
- Wyrażenia, których wyniki zależą od ustawień języka.
- Wyrażenia, których wyniki zależą od
SETopcji. - Wyrażenia, których wyniki zależą od opcji konfiguracji serwera.
Przykłady składanych i niefoldowalnych wyrażeń stałych
Rozważ następujące zapytanie:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Jeśli dla tego zapytania opcja bazy danych PARAMETERIZATION nie jest ustawiona na FORCED, wyrażenie 117.00 + 1000.00 jest obliczane i zastępowane swoim wynikiem, 1117.00, zanim zapytanie zostanie skompilowane. Korzyści z tej optymalizacji stałych obejmują:
- Wyrażenie nie musi być obliczane wielokrotnie podczas wykonywania.
- Wartość wyrażenia po jego wyocenie jest używana przez optymalizator zapytań do oszacowania rozmiaru zbioru wyników części zapytania
TotalDue > 117.00 + 1000.00.
Z drugiej strony, jeśli dbo.f jest funkcją skalarną zdefiniowaną przez użytkownika, wyrażenie dbo.f(100) nie jest upraszczane, ponieważ Database Engine nie składa wyrażeń zawierających funkcje użytkownika, nawet jeśli są deterministyczne. Więcej informacji o parametryzacji można znaleźć w artykule Wymuszona parametryzacja.
Ocena wyrażeń
Ponadto niektóre wyrażenia, które nie są stałe złożone, ale których argumenty są znane w czasie kompilacji, niezależnie od tego, czy argumenty są parametrami lub stałymi, są oceniane przez narzędzie do szacowania rozmiaru zestawu wyników (kardynalności), który jest częścią optymalizatora podczas optymalizacji.
W szczególności następujące wbudowane funkcje i specjalne operatory są oceniane w czasie kompilacji, jeśli wszystkie ich dane wejściowe są znane: UPPER, LOWER, RTRIM, DATEPART( YY only ), GETDATE, CAST, i CONVERT. Następujące operatory są również oceniane w czasie kompilacji, jeśli wszystkie ich dane wejściowe są znane:
- Operatory arytmetyczne:
+,-,*,/, jednoargumentowy- - Operatory logiczne:
AND,OR,NOT - Operatory porównawcze:
<,>,<=,>=,<>,LIKE,IS NULL,IS NOT NULL
Żadne inne funkcje lub operatory nie są oceniane przez optymalizator zapytań podczas szacowania kardynalności.
Przykłady obliczania wyrażeń w czasie kompilacji
Rozważ tę procedurę przechowywaną:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Podczas optymalizacji instrukcji SELECT w procedurze optymalizator zapytań próbuje ocenić oczekiwaną kardynalność zestawu wyników dla warunku OrderDate > @d + 1. Wyrażenie @d + 1 nie jest składane na stałe, ponieważ @d jest parametrem. Jednak w czasie optymalizacji jest znana wartość parametru. Ta wartość pozwala optymalizatorowi zapytań dokładnie oszacować rozmiar zbioru wyników, co pomaga wybrać dobry plan zapytań.
Teraz rozważmy przykład podobny do poprzedniego, z tą różnicą, że zmienna lokalna @d2 zastępuje @d + 1 w zapytaniu, a wyrażenie jest obliczane w instrukcji SET, a nie w zapytaniu.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Gdy instrukcja SELECT w MyProc2 jest zoptymalizowana w Database Engine, wartość @d2 nie jest znana. Dlatego Query Optimizer używa domyślnej estymacji selektywności OrderDate > @d2 (w tym przypadku 30 procent).
Przetwarzanie innych oświadczeń
Podstawowe kroki przetwarzania instrukcji SELECT mają zastosowanie do innych instrukcji T-SQL, takich jak INSERT, UPDATE oraz DELETE. Oba UPDATE polecenia i DELETE muszą celować w zbiór wierszy do modyfikacji lub usunięcia. Proces identyfikowania tych wierszy jest tym samym procesem używanym do identyfikowania wierszy źródłowych, które przyczyniają się do zestawu wyników instrukcji SELECT . Obie instrukcje UPDATE i INSERT mogą zawierać osadzone instrukcje SELECT, które dostarczają wartości danych do aktualizacji lub wstawienia.
Nawet instrukcje Data Definition Language (DDL), takie jak CREATE PROCEDURE lub ALTER TABLE, sprowadzają się do serii operacji relacyjnych na tabelach katalogu systemu, a czasem (na przykład ALTER TABLE ADD COLUMN) na tabelach danych.
Stoły robocze
Silnik relacyjny może potrzebować zbudować tabelę roboczą, aby wykonać operację logiczną określoną w instrukcji T-SQL. Tabele robocze to wewnętrzne tabele, które zawierają wyniki pośrednie. Tabele robocze są generowane dla niektórych zapytań GROUP BY, ORDER BY lub UNION. Na przykład, jeśli klauzula ORDER BY odnosi się do kolumn, które nie są objęte żadnymi indeksami, silnik relacyjny może wymagać wygenerowania tabeli roboczej, aby posortować zbiór wyników w żądanej kolejności. Tabele robocze są czasami używane jako szpule, które tymczasowo przechowują wynik wykonywania części planu zapytania. Stoły robocze są tworzone w tempdb, a potem automatycznie usuwane, gdy nie są już potrzebne.
Wyświetlanie rozdzielczości
Procesor zapytań Database Engine traktuje widoki indeksowane i nieindeksowane różnie:
- Baza danych przechowuje wiersze indeksowanego widoku w tym samym formacie co tabela. Jeśli optymalizator zapytań zdecyduje się użyć widoku indeksowanego w planie zapytania, traktuje widok indeksowany tak samo jak tabelę bazową.
- Przechowywana jest tylko definicja widoku nieindeksowanego, a nie wierszy widoku. Query Optimizer włącza logikę z definicji widoku do planu wykonawczego, który tworzy dla instrukcji T-SQL odnoszącej się do widoku nieindeksowanego.
Logika, jaką Optymalizator zapytań stosuje do decydowania, kiedy użyć widoku indeksowego, jest podobna do tej, którą stosuje do decydowania, kiedy użyć indeksu w tabeli. Jeśli dane w widoku indeksowanym odpowiadają całości lub części instrukcji T-SQL, a optymalizator zapytań ustali, że indeks w widoku jest ścieżką dostępu o niskich kosztach, wybiera indeks niezależnie od tego, czy zapytanie odnosi się do widoku po nazwie.
Gdy instrukcja T-SQL odnosi się do widoku nieindeksowanego, parser i optymalizator zapytań analizują źródło zarówno instrukcji T-SQL, jak i widoku, a następnie łączą je w jeden plan wykonania. Instrukcja T-SQL i widok nie mają oddzielnych planów.
Rozważmy na przykład następujący widok:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Na podstawie tego poglądu oba te polecenia T-SQL wykonują te same operacje na tabelach bazowych i dają te same wyniki:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
Funkcja SQL Server Management Studio (SSMS) Showplan pokazuje, że silnik relacyjny buduje ten sam plan wykonania dla obu tych SELECT instrukcji.
Korzystanie ze wskazówek w widokach
Jeśli umieszczasz podpowiedzi na widokach w zapytaniu, mogą one kolidować z innymi podpowiedziami, które pojawiają się, gdy widok rozszerza się, aby uzyskać dostęp do bazowych tabel. Gdy ten konflikt wystąpi, zapytanie zwraca błąd. Rozważmy na przykład następujący widok, który zawiera wskazówkę tabeli w definicji:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Teraz załóżmy, że wprowadzisz to zapytanie:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
Zapytanie kończy się niepowodzeniem, ponieważ wskazówka SERIALIZABLE w widoku Person.AddrState propaguje się do obu tabel Person.Address i Person.StateProvince po rozwinięciu widoku. Jednak rozszerzenie widoku również ujawnia NOLOCK wskazówkę dotyczącą elementu Person.Address. Ponieważ wskazówki SERIALIZABLE i NOLOCK są sprzeczne, wynikowe zapytanie jest niepoprawne.
Podpowiedzi PAGLOCK, NOLOCK, ROWLOCK, TABLOCK i TABLOCKX tablicy są ze sobą sprzeczne, podobnie jak podpowiedzi HOLDLOCK, NOLOCK, READCOMMITTED, REPEATABLEREAD i SERIALIZABLE tablicy.
Wskazówki mogą propagować się przez poziomy zagnieżdżonych widoków. Na przykład załóżmy, że zapytanie stosuje wskazówkę HOLDLOCK w widoku v1. Po rozwinięciu v1 okazuje się, że widok v2 jest częścią jego definicji.
v2Definicja zawiera wskazówkę NOLOCK dotyczącą jednej z jej tabel podstawowych. Jednak ta tabela także dziedziczy wskazówkę z zapytania w widoku HOLDLOCK. Ponieważ element NOLOCK i HOLDLOCK wskazuje konflikt, zapytanie kończy się niepowodzeniem.
Gdy używasz wskazówki FORCE ORDER w zapytaniu zawierającym widok, pozycja widoku w uporządkowanej konstrukcji decyduje o kolejności łączenia tabel w widoku. Na przykład następujące zapytanie wybiera spośród trzech tabel i widoku:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
A View1 jest zdefiniowany zgodnie z poniższym przykładem:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
Kolejność sprzężenia w planie zapytania to Table1, Table2, TableA, TableB, Table3.
Rozwiązywanie problemów z indeksami w widokach
Jak w przypadku każdego indeksu, Database Engine wybiera widok indeksowany w swoim planie zapytań tylko wtedy, gdy optymalizator zapytań uzna to za korzystne.
Możesz tworzyć zindeksowane widoki w dowolnej edycji Database Engine. W niektórych edycjach Query Optimizer automatycznie uwzględnia widok indeksowany, podczas gdy w innych trzeba użyć wskazówki tabeli NOEXPAND. Automatyczne użycie indeksowanego widoku przez Query Optimizer jest obsługiwane tylko w wybranych edycjach SQL Server.
Uwaga / Notatka
Usługi Azure SQL Database i Azure SQL Managed Instance obsługują automatyczne korzystanie z indeksowanych widoków bez określania NOEXPAND wskazówki.
Optymalizator zapytań używa widoku indeksowanego, gdy spełnione są następujące warunki:
- Te opcje sesji są ustawione na :
ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- Opcja
NUMERIC_ROUNDABORTsesji jest ustawiona naOFF. - Optymalizator zapytań znajduje dopasowanie między kolumnami indeksu widoku a elementami zapytania, takimi jak:
- Predykaty warunku wyszukiwania w klauzuli
WHERE - Operacje sprzężenia
- Funkcje agregujące
-
GROUP BYKlauzule - Odwołania do tabel
- Predykaty warunku wyszukiwania w klauzuli
- Szacowany koszt użycia indeksu ma najniższy koszt wszelkich mechanizmów dostępu uwzględnionych przez optymalizator zapytań.
- Każda tabela przywoływana w zapytaniu (bezpośrednio lub poprzez rozszerzenie widoku w celu uzyskania dostępu do jego bazowych tabel), która odpowiada odwołaniu do tabeli w widoku indeksowanym, musi mieć zastosowany ten sam zestaw wskazówek w zapytaniu.
Uwaga / Notatka
Wskazówki READCOMMITTED i READCOMMITTEDLOCK są zawsze traktowane jako różne wskazówki w tym kontekście, niezależnie od bieżącego poziomu izolacji transakcji.
Oprócz wymagań dotyczących SET opcji i wskazówek tabeli są to te same reguły, których używa Optymalizator zapytań w celu określenia, czy indeks tabeli obejmuje zapytanie. Nie musisz określać niczego więcej w zapytaniu, aby widok indeksowany został użyty.
Zapytanie nie musi jawnie odwoływać się do widoku indeksowanego w FROM klauzuli optymalizatora zapytań w celu korzystania z widoku indeksowanego. Jeśli zapytanie zawiera odwołania do kolumn w tabelach bazowych, które są również obecne w widoku indeksowanym, a optymalizator zapytań szacuje, że przy użyciu indeksowanego widoku zapewnia najniższy mechanizm dostępu do kosztów, Optymalizator zapytań wybiera widok indeksowany, podobnie jak w przypadku wybierania indeksów tabel bazowych, gdy nie są bezpośrednio przywoływane w zapytaniu. Optymalizator zapytań może wybrać widok zawierający kolumny, do których nie odwołuje się zapytanie, o ile widok oferuje najniższą opcję kosztu obejmującą co najmniej jedną kolumnę określoną w zapytaniu.
Optymalizator zapytań traktuje widok indeksowany przywoływany w klauzuli FROM jako widok standardowy. Optymalizator zapytań rozszerza definicję widoku do zapytania na początku procesu optymalizacji. Następnie jest wykonywane dopasowywanie indeksowanego widoku. Widok indeksowany może być używany w końcowym planie wykonywania wybranym przez Optymalizator zapytań lub zamiast tego plan może zmaterializować niezbędne dane z widoku, korzystając z tabel bazowych, do których odwołuje się widok. Optymalizator zapytań wybiera alternatywę najniższego kosztu.
Używanie wskazówek z indeksowanymi widokami
Można zapobiec używaniu indeksów widoku dla zapytania przy użyciu EXPAND VIEWS wskazówki zapytania lub użyć NOEXPAND wskazówki tabeli, aby wymusić użycie indeksu dla indeksowanego widoku określonego w FROM klauzuli zapytania. Należy jednak umożliwić optymalizatorowi zapytań dynamiczne określenie najlepszych metod dostępu do użycia dla każdego zapytania. Ogranicz użycie elementów EXPAND i NOEXPAND do konkretnych przypadków, w których testowanie wykazało, że znacznie poprawi wydajność.
Opcja
EXPAND VIEWSokreśla, że Optymalizator zapytań nie używa żadnych indeksów widoku dla całego zapytania.Gdy określasz
NOEXPANDdla widoku, Optymalizator Zapytań rozważa użycie dowolnych indeksów zdefiniowanych w widoku.NOEXPANDokreślony z klauzulą opcjonalnąINDEX()wymusza optymalizator zapytań do używania określonych indeksów. Możesz określićNOEXPANDtylko dla widoku indeksowanego i nie możesz tego określić dla widoku, który nie jest indeksowany. Automatyczne użycie indeksowanego widoku przez Query Optimizer jest obsługiwane tylko w wybranych edycjach SQL Server.Uwaga / Notatka
Usługi Azure SQL Database i Azure SQL Managed Instance obsługują automatyczne korzystanie z indeksowanych widoków bez określania
NOEXPANDwskazówki.
Jeśli ani NOEXPAND ani EXPAND VIEWS nie zostanie określona w zapytaniu zawierającym widok, widok zostanie rozszerzony, aby uzyskać dostęp do bazowych tabel. Jeśli zapytanie tworzące widok zawiera jakiekolwiek wskazówki dotyczące tabeli, te wskazówki są propagowane do bazowych tabel. (Proces ten jest szczegółowo wyjaśniony w rozwiązywaniu widoków.) Dopóki zestaw wskazówek istniejących w tabelach bazowych widoku jest identyczny ze sobą, zapytanie może zostać dopasowane do widoku indeksowanego. Najczęściej te wskazówki się pokrywają, ponieważ są bezpośrednio dziedziczone z widoku. Jeśli jednak zapytanie odwołuje się do tabel zamiast widoków, a wskazówki zastosowane bezpośrednio w tych tabelach nie są identyczne, takie zapytanie nie kwalifikuje się do dopasowania do widoku indeksowanego.
INDEXJeśli wskazówki , PAGLOCK, ROWLOCKTABLOCKXUPDLOCKlub XLOCK dotyczą tabel, do których odwołuje się zapytanie po rozszerzeniu widoku, zapytanie nie kwalifikuje się do dopasowania indeksowanego widoku.
Jeżeli wskazówka tabeli w postaci INDEX ( index_val [ ,...n] ) odnosi się do widoku w zapytaniu i nie określisz również wskazówki NOEXPAND, to wskazówka indeksu jest ignorowana. Aby określić użycie określonego indeksu, użyj polecenia NOEXPAND.
Zazwyczaj, gdy optymalizator zapytań dopasowuje indeksowany widok do zapytania, stosuje wszelkie wskazówki optymalizatora określone dla tabel lub widoków w zapytaniu bezpośrednio do widoku indeksowanego. Jeśli optymalizator zapytań zdecyduje się nie używać widoku indeksowego, przekazuje wszelkie wskazówki bezpośrednio do tabel odwoływanych w widoku. Więcej informacji można znaleźć w artykule Zobacz rozdzielczość. Ta propagacja nie ma zastosowania do wskazówek dotyczących łączeń. Są one stosowane tylko w ich pierwotnej pozycji w zapytaniu. Optymalizator zapytań nie uwzględnia wskazówek łączenia przy dopasowywaniu zapytań do widoków indeksowanych. Jeśli plan zapytania używa widoku indeksowanego, który odpowiada części zapytania zawierającej wskazówkę sprzężenia, to wskazówka sprzężenia nie jest używana w planie.
Wskazówki nie są dozwolone w definicjach indeksowanych widoków. Database Engine ignoruje podpowiedzi wewnątrz definicji widoków indeksowanych podczas ich utrzymania lub wykonywania zapytań z użyciem widoków indeksowanych.
Aby uzyskać więcej informacji, zobacz Wskazówki dotyczące tabel.
Rozwiązywanie problemów z rozproszonymi widokami podzielonymi na partycje
Procesor zapytań Database Engine optymalizuje wydajność rozproszonych widoków partycjonowanych. Najważniejszym aspektem wydajności widoku rozproszonego partycjonowanego jest zminimalizowanie ilości danych przesyłanych między serwerami członkowskimi.
Database Engine buduje inteligentne, dynamiczne plany, które efektywnie wykorzystują rozproszone zapytania do dostępu do danych z tabel członków zdalnych:
- Procesor zapytań najpierw używa OLE DB do pobierania definicji ograniczeń sprawdzających z każdej tabeli składowej. Ta metoda pozwala procesorowi zapytań mapować rozkład wartości kluczy w tabelach członkowskich.
- Procesor zapytań porównuje zakresy kluczy określone w klauzuli instrukcji
WHERET-SQL z mapą pokazującą, jak wiersze są rozmieszczone w tabelach członkowskich. Procesor zapytań następnie buduje plan wykonywania zapytań, który wykorzystuje rozproszone zapytania do pobierania tylko tych zdalnych wierszy niezbędnych do wykonania instrukcji T-SQL. Plan realizacji jest również zaprojektowany w taki sposób, że dostęp do zdalnych tabel składowych, zarówno do danych, jak i metadanych, jest opóźniony do momentu, gdy informacje te będą potrzebne.
Rozważmy na przykład system, w Customers którym tabela jest partycjonowana na serwerze Server1 (CustomerID od 1 do 3299999), Server2 (CustomerID od 3300000 do 6599999) i Server3 (CustomerID od 6600000 do 9999999).
Rozważ plan wykonania utworzony dla tego zapytania wykonanego na serwerze Server1:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
Plan wykonywania dla tego zapytania wyodrębnia wiersze z wartościami CustomerID klucza z zakresu od 3200000 do 3299999 z lokalnej tabeli członkowskiej i wystawia zapytanie rozproszone w celu pobrania wierszy z wartościami kluczy z zakresu od 3300000 do 3400000 z Server2.
Database Engine Query Processor może również wbudować dynamiczną logikę w planach wykonywania zapytań dla instrukcji T-SQL, w których wartości klucza nie są znane w momencie powstania planu. Rozważmy na przykład tę procedurę przechowywaną:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
Mechanizm bazy danych nie jest w stanie przewidzieć, jaka wartość klucza jest dostarczana za pomocą parametru @CustomerIDParameter za każdym razem, gdy procedura się wykonuje. Ponieważ wartości klucza nie da się przewidzieć, procesor zapytań nie może też przewidzieć, do której tabeli członków musi uzyskać dostęp. Aby rozwiązać ten przypadek, Database Engine buduje plan wykonania z logiką warunkową, zwaną filtrami dynamicznymi, aby sterować tym, do której tabeli składowej uzyskiwany jest dostęp na podstawie wartości parametru wejściowego. Zakładając, że GetCustomer procedura składowana została wykonana na Server1, logika planu wykonania może być przedstawiona w następującym wyjściu:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
Database Engine czasami tworzy tego typu dynamiczne plany wykonawcze nawet dla zapytań, które nie są parametryzowane. Optymalizator zapytań może sparametryzować zapytanie, aby można było ponownie użyć planu wykonywania. Jeśli Query Optimizer parametryzuje zapytanie odnoszące się do widoku partycjonowanego, Query Optimizer nie może już zakładać, że wymagane wiersze pochodzą z określonej bazowej tabeli. Następnie musi stosować filtry dynamiczne w planie realizacji.
Procedura składowana i wykonywanie wyzwalacza
Database Engine przechowuje jedynie kod źródłowy procedur składowanych i wyzwalaczy. Po pierwszym wykonaniu procedury składowanej lub wyzwalacza źródło jest kompilowane w planie wykonywania. Jeśli procedura składowana lub wyzwalacz zostanie ponownie wykonany, zanim plan wykonywania stanie się przestarzały w pamięci, aparat relacyjny wykryje istniejący plan i ponownie go użyje. Jeśli plan zostanie usunięty z pamięci, powstaje nowy plan. Proces ten jest podobny do procesu, którym kieruje się aparat bazy danych dla wszystkich instrukcji T-SQL. Główną przewagą wydajnościową procedur i wyzwalaczy przechowywanych w Database Engine w porównaniu z partiami dynamicznego T-SQL jest to, że ich instrukcje T-SQL są zawsze takie same. Dlatego silnik relacyjny łatwo dopasowuje je do istniejących planów wykonywania. Procedury składowane i plany wyzwalaczy są łatwo ponownie wykorzystywane.
Plan wykonywania procedur składowanych i wyzwalaczy jest wykonywany oddzielnie od planu wykonywania dla partii wywołującej procedurę składowaną lub wyzwalacza. To rozdzielenie pozwala na większe ponowne wykorzystanie procedury przechowywanej i planów wykonania wyzwalaczy.
Buforowanie i ponowne używanie planu wykonywania
Database Engine wykorzystuje pamięć do przechowywania zarówno planów wykonania, jak i buforów danych. Procent pamięci przydzielany na plany wykonania lub bufory danych jest dostosowywany dynamicznie, w zależności od stanu systemu. Część pamięci przechowująca plany wykonania nazywana jest pamięćą podręczną planów.
Magazyny pamięci podręcznej planów
Pamięć podręczna dla planów ma dwa przechowalniki dla wszystkich skompilowanych planów.
- Magazyn pamięci podręcznej planów obiektów (OBJCP), przeznaczony dla planów związanych z trwałymi obiektami, takimi jak procedury przechowywane, funkcje i wyzwalacze.
- Magazyn pamięci podręcznej dla planów SQL SQL Plans (SQLCP), przeznaczony dla planów związanych z zapytaniami automatycznie parametryzowanymi, dynamicznymi lub przygotowanymi.
Poniższe zapytanie dostarcza informacji o wykorzystaniu pamięci przez te dwa magazyny pamięci podręcznej:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
Pamięć podręczna planów zawiera dwa dodatkowe magazyny, które nie przechowują planów:
- Magazyn pamięci podręcznej Bound Trees (PHDR), przeznaczony do struktur danych używanych podczas kompilacji planów dla widoków, ograniczeń i wartości domyślnych. Struktury te znane są jako bound trees lub algebrizer trees.
- Magazyn pamięci podręcznej Rozszerzonych procedur składowanych (XPROC), dla wstępnie zdefiniowanych procedur systemowych, takich jak sp_executesql czy xp_cmdshell. Te procedury przechowywane wykorzystują DLL zamiast instrukcji T-SQL. Struktura buforowana zawiera jedynie nazwę funkcji oraz nazwę DLL, w której procedura jest implementowana.
Komponenty planu wykonania
Plany wykonawcze Database Engine obejmują następujące główne elementy:
Plan skompilowany (lub plan zapytania)
Plan zapytania utworzony przez proces kompilacji jest głównie reentrancyjną strukturą danych tylko do odczytu, używaną przez nieograniczoną liczbę użytkowników. Przechowuje informacje o:
Operatory fizyczne implementujące operację opisaną przez operatory logiczne.
Kolejność tych operatorów, która określa kolejność uzyskiwania dostępu do danych, filtrowania i agregowania.
Liczba szacowanych wierszy przechodzących przez operatorów.
Uwaga / Notatka
Plan zapytań przechowuje także informacje o obiektach statystycznych używanych do estymacji kardynalności.
Należy utworzyć obiekty obsługi, takie jak tabele robocze lub pliki robocze w
tempdb.
Plan zapytań nie przechowuje żadnego kontekstu użytkownika ani informacji o czasie wykonywania. Database Engine określa liczbę wątków roboczych za każdym razem, gdy pobiera plan z pamięci podręcznej planu. Plan równoległy w pamięci podręcznej może również działać szeregowo.
Kontekst wykonywania
Każdy użytkownik, który obecnie wykonuje zapytanie, posiada strukturę danych, która przechowuje dane specyficzne dla jego wykonywania, takie jak wartości parametrów. Ta struktura danych nazywana jest kontekstem wykonania. Struktury danych kontekstu wykonywania są ponownie używane, ale ich zawartość nie jest. Jeśli inny użytkownik wykonuje to samo zapytanie, struktury danych są ponownie inicjowane z kontekstem dla nowego użytkownika.
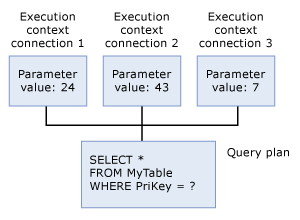
Ponowne wykorzystanie planów dla identycznych instrukcji
Gdy Database Engine wykonuje dowolne polecenie T-SQL, najpierw przegląda pamięć podręczną planu, aby zweryfikować, czy istnieje istniejący plan wykonania dla tego samego polecenia T-SQL. Instrukcja T-SQL jest uznawana za istniejącą, jeśli dosłownie odpowiada wcześniej wykonanej instrukcji T-SQL z planem zapisanym w pamięci podręcznej, znak po znaku. Database Engine ponownie wykorzystuje każdy istniejący plan, który znajdzie, oszczędzając narzut związany z rekompilacją instrukcji T-SQL. Jeśli nie istnieje plan wykonania, Database Engine generuje nowy plan wykonania zapytania.
Uwaga / Notatka
Pamięć podręczna planów nie utrwala planów wykonania dla niektórych instrukcji T-SQL, takich jak instrukcje operacji masowych uruchamianych w magazynie wierszowym (rowstore) lub instrukcje zawierające duże literały ciągów znaków. Te plany istnieją tylko podczas działania zapytania.
Database Engine wykorzystuje wydajny algorytm do znalezienia istniejących planów wykonania dla dowolnej określonej instrukcji T-SQL. W większości systemów minimalne zasoby używane przez ten skan są mniejsze niż te zaoszczędzone przez ponowne wykorzystanie istniejących planów zamiast kompilowania każdego polecenia T-SQL.
Algorytmy dopasowujące nowe instrukcje T-SQL do istniejących, nieużywanych planów wykonania w pamięci podręcznej planu wymagają, aby wszystkie odwołania do obiektów były w pełni kwalifikowane. Na przykład załóżmy, że Person jest domyślnym schematem użytkownika wykonującego następujące SELECT instrukcje. Chociaż ten przykład nie wymaga pełnego kwalifikowania tabeli Person do wykonania, oznacza to, że druga instrukcja nie pasuje do istniejącego planu, ale trzecia instrukcja już tak:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Zmiana którejkolwiek z poniższych SET opcji dla danego wykonania wpływa na możliwość ponownego wykorzystania planów, ponieważ Database Engine wykonuje constant folding, a te opcje wpływają na wyniki takich wyrażeń:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Buforowanie wielu planów dla tego samego zapytania
Zapytania i plany wykonania mogą być jednoznacznie zidentyfikowane w aparacie bazy danych, podobnie jak odcisk palca.
- Skrót planu zapytania to binarna wartość skrótu obliczana dla planu wykonywania dla danego zapytania i używana do unikatowego identyfikowania podobnych planów wykonywania.
- Hash zapytania to binarna wartość skrótu obliczana na tekście T-SQL zapytania i służy do jednoznacznej identyfikacji zapytań.
Możesz pobrać skompilowany plan z pamięci podręcznej planu, korzystając z uchwytu planu. Ten identyfikator przejściowy pozostaje stały tylko wtedy, gdy plan pozostaje w pamięci podręcznej. Uchwyt planu jest wartością skrótu pochodzącą z skompilowanego planu całej partii. Uchwyt planu dla skompilowanego planu pozostaje taki sam nawet jeśli jedna lub więcej instrukcji w partii zostanie ponownie skompilowana.
Uwaga / Notatka
Jeśli skompilujesz plan dla partii zamiast pojedynczej instrukcji, możesz użyć uchwytu planu i przesunięć instrukcji, aby uzyskać plan dla poszczególnych instrukcji w partii.
DMV sys.dm_exec_requests zawiera kolumny statement_start_offset i statement_end_offset dla każdego rekordu. Kolumny te odnoszą się do obecnie wykonywanej instrukcji aktualnie wykonywanego obiektu wsadowego lub utrwalonego. Aby uzyskać więcej informacji, zobacz sys.dm_exec_requests.
DMV sys.dm_exec_query_stats zawiera również te kolumny dla każdego rekordu. Kolumny te odnoszą się do pozycji instrukcji w partii lub obiekcie utrwalonym. Aby uzyskać więcej informacji, zobacz sys.dm_exec_query_stats.
Rzeczywisty tekst T-SQL wsadu jest przechowywany w osobnej przestrzeni pamięci niż pamięć podręczna planu, zwanej pamięcią podręczną SQL Manager (SQLMGR). Możesz pobrać tekst T-SQL dla skompilowanego planu z pamięci podręcznej SQL Managera, używając uchwytu SQL. Ten identyfikator przejściowy pozostaje stały tylko wtedy, gdy przynajmniej jeden plan, który się do niego odnosi, pozostaje w pamięci podręcznej planu. Uchwyt SQL to wartość skrótu pochodząca z całego tekstu wsadowego i gwarantuje unikalność dla każdego wsadu.
Uwaga / Notatka
Podobnie jak w planie skompilowanym, tekst T-SQL jest przechowywany dla każdej partii, wraz z komentarzami. Uchwyt SQL zawiera hash MD5 całego tekstu wsadowego i ma gwarantowaną unikalność dla każdej partii.
Następujące zapytanie dostarcza informacji o wykorzystaniu pamięci dla pamięci podręcznej SQL Manager:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Istnieje relacja jeden do wielu między uchwytem SQL a uchwytami planów. Ten warunek występuje, gdy klucz pamięci podręcznej dla skompilowanych planów jest inny. Ta różnica może wynikać ze zmiany opcji SET między dwoma realizacjami tego samego wsadu.
Rozważ następującą procedurę przechowywaną:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Sprawdź, co znajdziesz w pamięci podręcznej planu, używając następującego zapytania:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Oto zestaw wyników.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Teraz wykonaj procedurę przechowywaną z innym parametrem, bez innych zmian kontekstu wykonywania:
EXECUTE usp_SalesByCustomer 8;
GO
Sprawdź jeszcze raz, co znajdziesz w pamięci podręcznej planów. Oto zestaw wyników.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Zauważ, że wartość usecounts wzrasta do 2, co oznacza, że ten sam plan buforowany jest ponownie używany as-is, ponieważ struktury danych kontekstu wykonawczego są ponownie wykorzystywane. Teraz zmień SET ANSI_DEFAULTS opcję i wykonaj procedurę przechowywaną przy użyciu tego samego parametru.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Sprawdź jeszcze raz, co znajdziesz w pamięci podręcznej planu. Oto zestaw wyników.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Zwróć uwagę, że w danych wyjściowych sys.dm_exec_cached_plans dmv są teraz dwa wpisy:
- Kolumna
usecountspokazuje wartość1w pierwszym rekordzie. Ta wartość reprezentuje plan wykonany raz zSET ANSI_DEFAULTS OFF. - Kolumna
usecountspokazuje wartość2w drugim rekordzie. Ta wartość reprezentuje plan wykonany zSET ANSI_DEFAULTS ON, ponieważ został wykonany dwukrotnie. - Odmienne
memory_object_addressodnoszą się na inny wpis planu wykonania w pamięci podręcznej planu. Jednak wartośćsql_handlejest taka sama dla obu wpisów, ponieważ odwołują się one do tej samej partii.- Wykonanie z
ANSI_DEFAULTSustawionym naOFFma nowyplan_handle, i jest dostępny do ponownego użycia dla wywołań z tym samym zestawemSETopcji. Nowy identyfikator planu jest konieczny, ponieważ kontekst wykonania został ponownie zainicjowany ze względu na zmianę opcjiSET. Ale ta zmiana nie powoduje rekompilacji: oba wpisy odnoszą się do tego samego planu i zapytania, o czym świadczą te same wartościquery_plan_hashiquery_hash.
- Wykonanie z
W tej sytuacji masz dwa wpisy planu w pamięci podręcznej odpowiadające temu samemu wsadowi. Podkreśla to znaczenie zapewnienia, że opcje wpływające na pamięć podręczną planu SET są takie same, gdy te same zapytania są wykonywane wielokrotnie. Takie podejście optymalizuje ponowne wykorzystanie planu i utrzymuje rozmiar pamięci podręcznej planu na wymaganym minimum.
Wskazówka
Typowe pułapki polegają na tym, że różni klienci mogą mieć różne wartości domyślne dla SET opcji. Na przykład połączenie nawiązane przez SQL Server Management Studio automatycznie ustawia QUOTED_IDENTIFIER na ON, podczas gdy SQLCMD ustawia QUOTED_IDENTIFIER na OFF. Wykonanie tych samych zapytań z tych dwóch klientów skutkuje powstaniem wielu planów (jak opisano w poprzednim przykładzie).
Usuń plany wykonania z pamięci podręcznej planu
Plany wykonania pozostają w pamięci podręcznej planów, dopóki jest wystarczająco dużo pamięci do ich przechowywania. Gdy istnieje presja pamięci, SQL Server Database Engine stosuje podejście oparte na kosztach, aby zdecydować, które plany wykonania usunąć z pamięci podręcznej planu. Aby podjąć decyzję opartą na kosztach, SQL Server Database Engine zwiększa i zmniejsza bieżącą zmienną kosztową dla każdego planu wykonania w oparciu o następujące czynniki.
Gdy proces użytkownika wstawia plan wykonania do pamięci podręcznej, proces użytkownika ustawia bieżący koszt równoważny oryginalnemu kosztowi kompilacji zapytania. W przypadku planów realizacji ad hoc proces użytkownika ustawia aktualny koszt na zero. Następnie, za każdym razem, gdy proces użytkownika odwołuje się do planu wykonywania, resetuje bieżący koszt do pierwotnego kosztu kompilacji. W przypadku planów realizacji ad hoc proces użytkownika zwiększa bieżący koszt. Dla wszystkich planów maksymalna wartość bieżącego kosztu to oryginalny koszt kompilacji.
Gdy system odczuwa niedobór pamięci, aparat bazy danych programu SQL Server usuwa plany wykonania z pamięci podręcznej planów. Aby określić, które plany mają być usunięte, aparat bazy danych programu SQL Server wielokrotnie sprawdza stan każdego planu wykonania i usuwa plany, gdy ich bieżący koszt wynosi zero. Plan wykonania bez bieżących kosztów nie jest automatycznie usuwany, gdy istnieje presja pamięci. Jest usuwany tylko wtedy, gdy SQL Server Database Engine przeanalizuje plan i obecny koszt wynosi zero. Podczas badania planu wykonania silnik bazy danych SQL Server zmniejsza bieżący koszt do zera, jeżeli zapytanie nie korzysta obecnie z tego planu.
SQL Server Database Engine stale analizuje plany wykonawcze, aż usunie wystarczającą liczbę planów, by spełnić wymagania pamięci. Istniejący nacisk na pamięć może spowodować, że plan wykonania będzie miał wielokrotnie zwiększony i zmniejszony koszt. Gdy presja pamięci przestaje istnieć, SQL Server Database Engine przestaje zmniejszać bieżący koszt niewykorzystanych planów wykonania. Wszystkie plany realizacji pozostają w pamięci podręcznej planów, nawet jeśli ich koszt wynosi zero.
Silnik bazy danych SQL Server używa wątków monitora zasobów i wątków roboczych użytkownika do zwalniania pamięci z pamięci podręcznej planów w odpowiedzi na presję pamięci. Monitor zasobów i wątki użytkownika mogą jednocześnie analizować plany, aby obniżyć bieżący koszt dla każdego niewykorzystanego planu realizacji. Monitor zasobów usuwa plany wykonywania z pamięci podręcznej planu w sytuacji globalnego obciążenia pamięci. Zwalnia pamięć, aby wymusić zasady dotyczące pamięci systemowej, pamięci procesów, pamięci puli zasobów oraz maksymalnego rozmiaru wszystkich pamięci podręcznych.
Maksymalny rozmiar wszystkich pamięci podręcznych jest funkcją rozmiaru puli i nie może przekroczyć maksymalnej pamięci serwera. Aby uzyskać więcej informacji na temat konfiguracji maksymalnej pamięci serwera, zobacz ustawienie max server memory w sp_configure.
Gdy występuje nacisk na pamięć podręczną, wątki robocze użytkownika usuwają plany wykonawcze z pamięci podręcznej planu. Wymuszają one zasady maksymalnego rozmiaru pojedynczej pamięci podręcznej i maksymalnej liczby wpisów pojedynczej pamięci podręcznej.
Poniższe przykłady ilustrują, które plany realizacji zostaną usunięte z pamięci podręcznej planu.
- Plan wykonania jest często odwoływany, aby jego koszt nigdy nie osiągał zera. Plan pozostaje w pamięci podręcznej planu i nie jest usuwany, chyba że wystąpi presja pamięci i bieżący koszt wynosi zero.
- Plan wykonywania ad hoc jest wstawiany i nie jest odwoływany ponownie, dopóki nie pojawi się problem z brakiem pamięci. Ponieważ plany ad hoc są inicjalizowane z bieżącym kosztem równym zero, gdy SQL Server Database Engine analizuje plan realizacji, widzi zerowy koszt bieżący i usuwa plan z pamięci podręcznej planu. Plan wykonania ad hoc pozostaje w pamięci podręcznej planu z zerowym bieżącym kosztem, gdy nie ma presji pamięci.
Aby ręcznie usunąć pojedynczy plan lub wszystkie plany z pamięci podręcznej, użyj DBCC FREEPROCCACHE. Możesz także użyć DBCC FREESYSTEMCACHE do czyszczenia dowolnej pamięci podręcznej, w tym pamięci podręcznej planów. W SQL Server 2016 (13.x) i nowszych wersjach użyj ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE, aby wyczyścić pamięć podręczną procedur (plan) dla bieżącej bazy danych.
Zmiana niektórych ustawień konfiguracji za pomocą sp_configure i reconfigure powoduje także usunięcie planów z pamięci podręcznej planów. Listę tych ustawień konfiguracji można znaleźć w sekcji Uwagi artykułu DBCC FREEPROCCACHE . Po dokonaniu tej zmiany konfiguracji, do dziennika błędów zapisywana jest następująca informacja informacyjna:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Ponowne kompiluj plany wykonywania
Pewne zmiany w bazie danych mogą sprawić, że plan wykonania będzie nieefektywny lub nieważny. Database Engine wykrywa te zmiany i oznacza plan jako nieważny. Następnie należy ponownie skompilować nowy plan dla następnego połączenia, które wykonuje zapytanie. Warunki powodujące unieważnienie planu obejmują:
- Zmiany w tabeli lub widoku, do których odwołuje się zapytanie (
ALTER TABLEiALTER VIEW). - Zmiany w jednej procedurze, która spowodowałaby usunięcie wszystkich planów dla tej procedury z pamięci podręcznej (
ALTER PROCEDURE). - Zmiany w indeksach używanych w ramach planu wykonywania.
- Aktualizacje statystyk używanych przez plan wykonania, niezależnie od tego, czy są wyraźnie generowane przez polecenie, na przykład
UPDATE STATISTICS, czy generowane automatycznie. - Usunięcie indeksu używanego przez plan wykonawczy.
- Jawne wywołanie do
sp_recompile. - Duża liczba zmian kluczy (generowanych przez instrukcje
INSERTlubDELETEod innych użytkowników, którzy modyfikują tabelę przywoływaną przez zapytanie). - W przypadku tabel z wyzwalaczami, jeśli liczba wierszy w wstawionych lub usuniętych tabelach znacznie się zwiększa.
- Wykonanie procedury przechowywanej za pomocą opcji
WITH RECOMPILE.
Większość rekompilacji jest wymagana albo dla poprawności instrukcji, albo aby uzyskać potencjalnie szybsze plany wykonywania zapytań.
Gdy instrukcja w partii uruchamia rekompilację, rekompilowana jest tylko ta instrukcja, a nie cała partia. Zasada ta obowiązuje niezależnie od tego, czy partia jest przesyłana poprzez procedurę składowaną, trigger, ad hoc batch czy prepared statement.
Rekompilacja na poziomie instrukcji poprawia wydajność, ponieważ w większości przypadków niewielka liczba instrukcji powoduje rekompilacje oraz związane z nimi kary, zarówno pod względem czasu CPU, jak i blokad. Te kary są więc unikane dla innych instrukcji w partii, które nie wymagają ponownej kompilacji.
Zdarzenie sql_statement_recompile rozszerzone (XEvent) zgłasza ponowne kompilacje na poziomie instrukcji. Ten XEvent występuje, gdy ponowna kompilacja na poziomie instrukcji jest wymagana przez dowolny rodzaj serii. Ten wymóg obejmuje procedury składowane, wyzwalacze, partie ad hoc oraz zapytania. Partie mogą być przesyłane przez kilka interfejsów, w tym sp_executesql, dynamiczny SQL, metody Prepare lub metody Execute.
Kolumna recompile_causesql_statement_recompile XEvent zawiera kod całkowity, który wskazuje przyczynę ponownej kompilacji. Poniższa lista zawiera możliwe przyczyny:
- Zmieniono opcje kursora
- Odroczona kompilacja
-
FOR BROWSEzmieniono uprawnienia -
OPTION (RECOMPILE)Poproszono - Wyczyszczono sparametryzowany plan.
- Zmieniony widok partycjonowany
- Zmiana wersji bazy danych wpłynęła na plan
- Zmieniono środowisko powiadomień o zapytaniach
- Brakuje planu w Query Store
- Wymuszenie planu sklepu zapytań nie powiodło się
- Plan magazynu zapytań wymusza zmianę zasad
- Zmieniono zdalny zestaw rekordów
- Zmieniono schemat
-
SETzmieniono opcję - Zmieniono statystyki
- Zmieniono tabelę tymczasową
Uwaga / Notatka
Gdy ustawisz opcję AUTO_UPDATE_STATISTICS bazy danych na ON, zapytania są rekompilowane, gdy dotyczą tabel lub widoków indeksowanych, których statystyki są aktualizowane lub których liczność zmieniła się znacząco od ostatniego wykonania. To zachowanie dotyczy standardowych tabel zdefiniowanych przez użytkownika, tabel tymczasowych oraz wstawionych i usuniętych tabel utworzonych przez wyzwalacze DML.
Ustawienie AUTO_UPDATE_STATISTICS na OFF zatrzyma te rekompilacje, ale przestarzałe statystyki zwykle bardziej pogarszają wydajność zapytań niż same rekompilacje. Aby uzyskać więcej informacji, zobacz opcję AUTO_UPDATE_STATISTICS . Wstawiane i usuwane tabele wyzwalaczy DML INSTEAD OF są tworzone w tempdb, więc odpowiadają ustawieniu AUTO_UPDATE_STATISTICS elementu tempdb.
Używaj parametrów jawnych do ponownego wykorzystania planów
Stosowanie parametrów, w tym nazwanych parametrów w aplikacjach ADO.NET oraz markerów parametrów w aplikacjach OLE DB i ODBC, może zwiększyć ponowne wykorzystanie planów wykonawczych.
Ostrzeżenie
Zawsze weryfikuj dane wejściowe użytkownika według typu testowania, długości, formatu i zakresu. Aby uzyskać więcej informacji, zobacz wstrzykiwanie SQL.
Jedyną różnicą między następującymi dwoma SELECT wyrażeniami są wartości, które są porównywane w klauzuli WHERE :
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Jedyną różnicą między planami wykonywania dla tych zapytań jest wartość przechowywana dla porównania z kolumną ProductSubcategoryID . Chociaż celem jest, aby Database Engine zawsze rozpoznawał, że instrukcje generują zasadniczo ten sam plan i ponownie wykorzystywał te plany, Database Engine czasem nie wykrywa tego podobieństwa w złożonych instrukcjach T-SQL.
Oddzielenie stałych od instrukcji T-SQL za pomocą parametrów pomaga silnikowi relacyjnemu rozpoznawać zduplikowane plany. Używaj parametrów w następujący sposób:
W T-SQL używaj
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Ta metoda jest zalecana dla skryptów T-SQL, procedur przechowywanych lub wyzwalaczy, które generują instrukcje SQL dynamicznie.
ADO.NET z użyciem
SqlClientużywa nazwanych parametrów, takich jak@Parm. OLE DB i ODBC używają markerów parametrów. Znaczniki parametrów to znaki zapytania (?), które zastępują stałą w instrukcji SQL i są powiązane ze zmienną programową. Na przykład w aplikacji ODBC należy wykonać następujące czynności:Użyj
SQLBindParameteraby związać zmienną całkowitą z pierwszym znacznikiem parametru w instrukcji SQL.Umieść wartość całkowitą w zmiennej.
Wykonaj polecenie, określając marker parametru (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
Provider OLE DB Native Client SQL Server oraz sterownik ODBC Native Client SQL Server używają
sp_executesqldo wysyłania instrukcji do SQL Server, gdy w aplikacjach używa się markerów parametrów.Twórz procedury składowane, które z założenia wykorzystują parametry.
Jeśli nie uwzględnisz jawnie parametrów w projekcie aplikacji, możesz też polegać na Query Optimizerze, który automatycznie parametryzuje niektóre zapytania, korzystając z domyślnego zachowania prostej parametryzacji. Alternatywnie możesz wymusić, aby optymalizator zapytań rozważył sparametryzowanie wszystkich zapytań w bazie danych, ustawiając PARAMETERIZATION opcję ALTER DATABASE instrukcji na FORCED.
Prosta parametryzacja
W Database Engine użycie parametrów lub markerów parametrów w instrukcjach T-SQL zwiększa zdolność silnika relacyjnego do dopasowywania nowych instrukcji T-SQL do istniejących, wcześniej skompilowanych planów wykonania.
Ostrzeżenie
Zawsze weryfikuj dane wejściowe użytkownika według typu testowania, długości, formatu i zakresu. Aby uzyskać więcej informacji, zobacz wstrzykiwanie SQL.
Jeśli instrukcja T-SQL zostanie wykonana bez parametrów, Database Engine parametryzuje ją wewnętrznie, aby zwiększyć możliwość dopasowania jej do istniejącego planu wykonania. Proces ten nazywa się parametryzacją. Domyślnie jest to prosta parametryzacja, a dla bazy danych można włączyć wymuszoną parametryzację.
Rozważ to stwierdzenie:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Możesz określić wartość 1 na końcu instrukcji jako parametr. Silnik relacyjny buduje plan wykonania dla tej partii tak, jakbyś w miejscu wartości 1określił parametr . Dzięki tej prostej parametryzacji Database Engine rozpoznaje, że następujące dwie instrukcje generują zasadniczo ten sam plan wykonania i ponownie wykorzystuje pierwszy plan dla drugiej instrukcji:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Podczas przetwarzania złożonych instrukcji T-SQL silnik relacyjny może mieć trudności z określeniem, które wyrażenia można parametryzować. Aby zwiększyć zdolność silnika relacyjnego do dopasowywania złożonych instrukcji T-SQL do istniejących, nieużywanych planów wykonania, wyraźnie określ parametry, używając albo sp_executesql, albo znaczników parametrów.
Uwaga / Notatka
Gdy używasz operatorów arytmetycznych +, -, *, / lub % do dokonywania niejawnej lub jawnej konwersji stałych wartości int, smallint, tinyint lub bigint na typy danych float, real, decimal lub numeric, Database Engine stosuje konkretne reguły do obliczania typu i precyzji wyników wyrażeń. Zasady te różnią się w zależności od tego, czy zapytanie jest parametryzowane. W związku z tym podobne wyrażenia w zapytaniach mogą w niektórych przypadkach generować różne wyniki.
W domyślnym zachowaniu prostej parametryzacji Database Engine parametryzuje stosunkowo niewielką klasę zapytań. Można jednak określić, że wszystkie zapytania w bazie danych mają być sparametryzowane, z zastrzeżeniem pewnych ograniczeń, ustawiając PARAMETERIZATION opcję ALTER DATABASE polecenia na FORCED. Ta zmiana może poprawić wydajność baz danych, które doświadczają dużej liczby równoległych zapytań poprzez zmniejszenie częstotliwości kompilacji zapytań.
Alternatywnie można określić, że pojedyncze zapytanie i inne, które są składniowo równoważne, ale różnią się tylko w ich wartości parametrów, mają być sparametryzowane.
Wskazówka
Gdy korzystasz z rozwiązania do mapowania obiektowo-relacyjnego (ORM), takiego jak Entity Framework (EF), zapytania aplikacyjne, takie jak ręczne drzewa zapytań LINQ czy niektóre surowe zapytania SQL, mogą nie być parametryzowane. To ograniczenie wpływa na ponowne wykorzystanie planów oraz możliwość śledzenia zapytań w Query Store. Aby uzyskać więcej informacji, zobacz buforowanie i parametryzację zapytań w EF oraz zapytania Raw SQL.
Wymuszona parametryzacja
Możesz zastąpić domyślne proste zachowanie parametryzacji aparatu bazy danych, określając, że wszystkie instrukcje SELECT, INSERT, UPDATE i DELETE w bazie danych mają być parametryzowane, z zastrzeżeniem pewnych ograniczeń. Włącz wymuszoną parametryzację, ustawiając opcję PARAMETERIZATION na FORCED w instrukcji ALTER DATABASE. Wymuszona parametryzacja może zwiększyć wydajność niektórych baz danych, zmniejszając częstotliwość kompilacji zapytań i ponowne kompilowania. Bazy danych, które mogą korzystać z wymuszonej parametryzacji, to zazwyczaj te, które korzystają z dużych ilości współbieżnych zapytań ze źródeł, takich jak aplikacje do obsługi punktów sprzedaży.
Gdy ustawisz opcję PARAMETERIZATION na FORCED, każda wartość literalna, która pojawia się w instrukcji INSERT, SELECT, UPDATE lub DELETE, przesłanej w dowolnej formie, jest konwertowana na parametr podczas kompilacji zapytania. Wyjątki są literałami, które są wyświetlane w następujących konstrukcjach zapytania:
-
INSERT...EXECUTEOświadczenia. - Instrukcje wewnątrz treści procedur składowanych, wyzwalaczy lub funkcji zdefiniowanych przez użytkownika. Aparat bazy danych już używa planów zapytań w przypadku tych procedur.
- Instrukcje przygotowane już parametryzowane w aplikacji po stronie klienta.
- Instrukcje, które zawierają wywołania metody XQuery, gdzie metoda pojawia się w kontekście, w którym argumenty zwykle będą sparametryzowane, takie jak klauzula
WHERE. Jeśli metoda pojawi się w kontekście, w którym jej argumenty nie będą sparametryzowane, pozostała część instrukcji zostanie sparametryzowana. - Instrukcje wewnątrz kursora T-SQL. (
SELECTinstrukcje wewnątrz kursorów interfejsu API są sparametryzowane). - Przestarzałe konstrukcje zapytań.
- Każda instrukcja wykonywana w kontekście, gdy
ANSI_PADDINGlubANSI_NULLSjest ustawione naOFF. - Instrukcje zawierające więcej niż 2097 dosłownych wartości, które kwalifikują się do parametryzacji.
- Wyrażenia odwołujące się do zmiennych, na przykład
WHERE T.col2 >= @bb. - Instrukcje zawierające
RECOMPILEwskazówkę zapytania. - Zdania zawierające klauzulę
COMPUTE. - Zdania zawierające klauzulę
WHERE CURRENT OF.
Poniższe klauzule zapytań nie są parametryzowane. W takich przypadkach tylko klauzule nie są sparametryzowane. Inne klauzule w ramach tego samego zapytania mogą kwalifikować się do wymuszonej parametryzacji.
- Element
<select_list>dowolnej instrukcjiSELECT. Ta lista zawieraSELECTlisty podzapytań orazSELECTlisty wewnątrz instrukcjiINSERT. - Instrukcje podzapytania
SELECT, które pojawiają się wewnątrz instrukcjiIF. - Klauzule
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOlubFOR XMLzapytania. - Argumenty, bezpośrednie lub jako podwyrażenia, do
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXML, lub dowolnegoFULLTEXToperatora. - Wzorzec i parametry escape_character klauzuli
LIKE. - Styl argumentu klauzuli
CONVERT. - Stałe całkowite wewnątrz klauzuli
IDENTITY. - Stałe określone przy użyciu składni rozszerzenia ODBC.
- Wyrażenia składane na stałe, które są argumentami operatorów
+,-,*,/i%. Rozważając kwalifikowanie się do wymuszonej parametryzacji, Database Engine uznaje wyrażenie za podlegające zwijaniu stałych, gdy spełniony jest jeden z następujących warunków:- W wyrażeniu nie są wyświetlane żadne kolumny, zmienne ani podzapytania.
- Wyrażenie zawiera klauzulę
CASE.
- Argumenty klauzul query hint, w tym argument
FASTklauzuli query hint , argumentMAXDOPklauzuli query hint oraz argumentMAXRECURSIONklauzuli query hint .
Parametryzacja zachodzi na poziomie poszczególnych instrukcji T-SQL. Innymi słowy, poszczególne zapytania w zbiorze są sparametryzowane. Po kompilacji parametryzowane zapytanie wykonuje się w kontekście partii, w której zostało pierwotnie przekazane. Jeśli plan wykonania zapytania jest buforowany, można ustalić, czy zapytanie zostało parametryzowane, odwołując się do kolumny sql dynamicznego widoku zarządzania sys.syscacheobjects. Jeśli zapytanie jest parametryzowane, nazwy i typy danych parametrów znajdują się przed tekstem przesłanej partii w tej kolumnie, na przykład (@1 TINYINT).
Uwaga / Notatka
Nazwy parametrów są dowolne. Użytkownicy lub aplikacje nie powinni opierać się na konkretnej kolejności nazw. Ponadto następujące elementy mogą się zmieniać między wersjami SQL Server a aktualizacjami kumulatywnymi (CU): nazwy parametrów, wybór literałów poddawanych parametryzacji oraz odstępy w tekście parametryzowanym.
Typy danych parametrów
Gdy Database Engine parametryzuje literale, parametry są konwertowane na następujące typy danych:
- Literale całkowitoliczbowe, których rozmiar mieściłby się w parametrze typu typie danych int, przenoszą się do int. Większe literale całkowitoliczbowe, będące częścią predykatów obejmujących dowolny operator porównawczy (w tym
<,<=,=,!=,>,!>,>=,ANY,BETWEEN,ALL,<>,SOME,!<iIN) parametryzują się do numeric(38,0). Większe literały, które nie są częścią predykatów obejmujących operatory porównawcze, parametryzują się do numeric, którego precyzja jest wystarczająco duża, by utrzymać ich rozmiar, a skala wynosi 0. - Literały liczbowe o stałym przecinku, będące częścią predykatów obejmujących operatory porównawcze, parametryzują się do numeric o precyzji 38, a skala jest wystarczająco duża, aby pomieścić jego rozmiar. Literały liczbowe stałoprzecinkowe, które nie są częścią predykatów obejmujących operatory porównawcze, są parametryzowane jako numeric, którego precyzja i skala są wystarczająco duże, by pomieścić jego wartość.
- Literały zmiennoprzecinkowe parametryzują się do float(53).
- Literale ciągów nie-Unicode parametryzują się do varchar(8000), jeśli literal mieści się w obrębie 8 000 znaków, a do varchar(max), jeśli jest większy niż 8 000 znaków.
- Literale ciągów znaków Unicode parametryzują się do nvarchar(4000), jeśli literal mieści się w 4 000 znaków Unicode, oraz do nvarchar(max), jeśli literal jest większy niż 4 000 znaków.
- Literały binarne parametryzują się do varbinary(8000), jeśli literal mieści się w obrębie 8 000 bajtów. Jeśli jest większy niż 8 000 bajtów, jest konwertowany na varbinary(max).
- Literały pieniężne są parametryzowane jako pieniądze.
Wskazówki dotyczące używania wymuszonej parametryzacji
Weź pod uwagę następujące kwestie, gdy ustawiasz opcję PARAMETERIZATION na FORCED:
- Wymuszona parametryzacja zmienia stałe literałowe w zapytaniu na parametry podczas kompilacji zapytania. W związku z tym optymalizator zapytań może wybrać nieoptymalne plany zapytań. W szczególności optymalizator zapytań jest mniej prawdopodobny na dopasowanie zapytania do widoku z indeksem lub indeksu na kolumnie obliczonej. Można również wybrać nieoptymalne plany zapytań dotyczących tabel partycjonowanych i rozproszonych widoków partycjonowanych. Nie używaj wymuszonej parametryzacji w środowiskach, które mocno opierają się na indeksowanych widokach i indeksach dla kolumn obliczeniowych. Zazwyczaj tylko doświadczeni specjaliści od baz danych powinni korzystać z
PARAMETERIZATION FORCEDopcji po upewnieniu się, że nie wpływa ona negatywnie na wydajność. - Zapytania rozproszone odwołujące się do więcej niż jednej bazy danych kwalifikują się do wymuszonej parametryzacji, o ile opcja
PARAMETERIZATIONjest ustawiona naFORCEDw bazie danych, której kontekstem jest uruchomione zapytanie. - Ustawienie opcji
PARAMETERIZATIONnaFORCEDpowoduje usunięcie wszystkich planów zapytań z pamięci podręcznej planów bazy danych, z wyjątkiem tych, które są obecnie kompilowane, rekompilowane lub uruchamiane. Plany zapytań, które są kompilowane lub uruchamiane podczas zmiany ustawień, są parametryzowane przy następnym uruchomieniu zapytania. - Ustawienie
PARAMETERIZATIONtej opcji to operacja online, która nie wymaga wyłącznych blokad na poziomie bazy danych. - Bieżące ustawienie
PARAMETERIZATIONopcji jest zachowywane podczas ponownego dołączenia lub przywracania bazy danych.
Możesz nadpisać zachowanie wymuszonej parametryzacji, określając, że ma zostać podjęta próba prostej parametryzacji na pojedynczym zapytaniu oraz wszelkich innych zapytaniach składniowo równoważnych, ale różniących się tylko wartościami parametrów. Z drugiej strony można określić, że wymuszona parametryzacja ma być podejmowana tylko na zestawie zapytań równoważnych składniowo, nawet jeśli wymuszona parametryzacja jest wyłączona w bazie danych. Do tego celu korzystaj z przewodników planu.
Uwaga / Notatka
Kiedy opcja PARAMETERIZATION jest ustawiona na FORCED, raportowanie komunikatów o błędach może różnić się od sytuacji, gdy opcja PARAMETERIZATION jest ustawiona na SIMPLE: w ramach parametryzacji wymuszonej może być zgłaszanych wiele komunikatów o błędach, podczas gdy w ramach prostej parametryzacji zgłaszanych będzie mniej komunikatów, a numery wierszy, w których występują błędy, mogą być raportowane niepoprawnie.
Po włączeniu wymuszonej parametryzacji nadal można wykonywać proste parametryzacje. Na przykład następujące zapytanie nie może być sparametryzowane zgodnie z regułami wymuszonej parametryzacji:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Można go jednak sparametryzować zgodnie z prostymi regułami parametryzacji. Gdy wymuszona parametryzacja jest podejmowana, ale kończy się niepowodzeniem, prosta parametryzacja jest nadal podejmowana.
Przygotowywanie instrukcji SQL
Aparat bazy danych obsługuje przygotowywanie instrukcji T-SQL przed wykonaniem. Jeśli aplikacja musi wykonać polecenie T-SQL wielokrotnie, może użyć API bazy danych do:
- Przygotuj oświadczenie raz. Ten krok kompiluje polecenie T-SQL do postaci planu wykonania.
- Wykonaj wstępnie skompilowany plan wykonania za każdym razem, gdy trzeba wykonać polecenie. Takie podejście uniemożliwia ponowne kompilowanie instrukcji T-SQL przy każdym wykonaniu po pierwszym wykonaniu. Przygotowywanie i wykonywanie instrukcji jest kontrolowane przez funkcje i metody interfejsu API. Dostawca OLE DB SQL Server Native Client oraz sterownik ODBC SQL Server Native Client obsługują model przygotowania/wykonania wykonywania instrukcji T-SQL. Na żądanie przygotowania dostawca lub sterownik wysyła instrukcję do programu SQL Server z żądaniem przygotowania instrukcji. Database Engine kompiluje plan wykonania i zwraca uchwyt tego planu do dostawcy lub sterownika. Na żądanie wykonania dostawca lub sterownik wysyła do serwera żądanie wykonania planu skojarzonego z uchwytem.
Instrukcje przygotowane nie mogą tworzyć obiektów tymczasowych w Database Engine. Przygotowane instrukcje nie mogą odwoływać się do systemowych procedur składowanych, które tworzą obiekty tymczasowe, takie jak tabele tymczasowe. Te procedury muszą być wykonywane bezpośrednio.
Nadmierne stosowanie modelu prepare/execute może pogorszyć wydajność. Jeśli polecenie jest wykonywane tylko raz, bezpośrednie wykonanie wymaga tylko jednego przebiegu komunikacji z serwerem. Przygotowanie i wykonanie jednorazowego polecenia T-SQL wymaga dodatkowej rundy komunikacji sieciowej: jednego przebiegu w celu przygotowania instrukcji i jednego przebiegu w celu jego wykonania.
Przygotowanie instrukcji jest skuteczniejsze, jeśli używasz markerów parametrów. Załóżmy na przykład, że aplikacja jest od czasu do czasu proszona o pobranie informacji o produkcie z przykładowej AdventureWorksLT2025 bazy danych. Aplikacja może to wykonać na dwa sposoby.
Stosując pierwsze podejście, aplikacja może wykonać osobne zapytanie dla każdego żądanego produktu:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Stosując drugie podejście, aplikacja wykonuje następujące operacje:
Przygotowuje instrukcję zawierającą marker parametru (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Wiąże zmienną programową ze znacznikiem parametru.
Za każdym razem, gdy potrzebne są informacje o produkcie, wypełnia zmienną powiązaną wartością klucza i wykonuje instrukcję .
Drugie podejście jest bardziej efektywne, gdy instrukcja wykonywana jest więcej niż trzy razy.
W aparacie Database Engine model przygotowania/wykonywania nie ma istotnej przewagi wydajnościowej nad bezpośrednim wykonaniem, ze względu na sposób, w jaki Database Engine ponownie wykorzystuje plany wykonania. Database Engine posiada wydajne algorytmy do dopasowywania aktualnych instrukcji T-SQL z planami wykonania, które są generowane dla wcześniejszych wykonań tego samego polecenia T-SQL. Jeśli aplikacja wykona polecenie T-SQL z markerami parametrów wielokrotnie, Database Engine ponownie wykorzystuje plan wykonania z pierwszego wykonania dla drugiego i kolejnych wykonań (chyba że plan zostanie usunięty z pamięci podręcznej planów). Model przygotowywania/wykonywania nadal ma następujące korzyści:
- Znalezienie planu wykonania za pomocą uchwytu identyfikacyjnego jest bardziej efektywne niż stosowanie algorytmów używanych do dopasowywania instrukcji T-SQL do istniejących planów wykonania.
- Aplikacja może kontrolować, kiedy plan realizacji jest tworzony i kiedy jest ponownie wykorzystywany.
- Model przygotowywania/wykonywania jest przenośny do innych baz danych, w tym wcześniejszych wersji programu SQL Server.
Czułość parametrów
Wrażliwość parametrów, znana również jako parameter sniffing, odnosi się do procesu, w którym Database Engine wyczuwa aktualne wartości parametrów podczas kompilacji lub rekompilacji i przekazuje je do Query Optimizera, aby potencjalnie pomóc w generowaniu bardziej efektywnych planów wykonywania zapytań.
Wartości parametrów są wykrywane podczas kompilacji lub ponownej kompilacji dla następujących typów partii:
- Procedury przechowywane
- Zapytania przesłane za pośrednictwem
sp_executesql - Przygotowane zapytania
Więcej informacji na temat rozwiązywania problemów z parameter sniffing można znaleźć, zobacz:
- Badanie i rozwiązywanie problemów z uwzględnieniem parametrów
- Używaj parametrów jawnych do ponownego wykorzystania planów
- Optymalizacja planów wrażliwych na parametry
- Rozwiązywanie problemów z zapytaniami dotyczącymi planu wykonywania zapytań wrażliwego na parametry w usłudze Azure SQL Database
- Rozwiązywanie problemów z zapytaniami dotyczących parametrów w planie wykonywania zapytań w usłudze Azure SQL Managed Instance
Gdy zapytanie w Database Engine używa tej wskazówki OPTION (RECOMPILE), Query Optimizer zamienia parametry i zmienne lokalne w stałe w czasie kompilacji, które mogą zostać poddane składaniu stałych i zredukowane do literałów. Podczas kompilacji optymalizator zna i może wykorzystać aktualne wartości parametrów i zmiennych lokalnych tak, jak istnieją bezpośrednio przed tą instrukcją. Wskazówka OPTION (RECOMPILE) pozwala optymalizatorowi wygenerować bardziej optymalny plan zapytań dostosowany do konkretnych wartości oraz wykorzystać najlepsze indeksy bazowe w czasie działania. W przypadku parametrów ten proces odwołuje się nie do wartości pierwotnie przekazanych do partii lub procedury składowanej, ale do ich wartości w czasie ponownej kompilacji. Wartości te mogą być modyfikowane w trakcie procedury przed uzyskaniem instrukcji, która zawiera RECOMPILE. Takie zachowanie może poprawić wydajność zapytań z bardzo zmiennymi lub nierównomiernie rozłożonymi danymi wejściowymi, kosztem kompilacji zapytania za każdym razem, gdy jest wykonywane. Ten koszt może być wysoki. Unikaj używania RECOMPILE wskazówki bez oceny jej wpływu na całkowite obciążenie pracą.
Zmienne lokalne i szacunki kardynalności
Gdy zapytanie używa zmiennych lokalnych, Database Engine nie jest w stanie rozpoznać ich wartości podczas kompilacji, więc szacuje kardynalność na podstawie dostępnych statystyk lub heurystyk. Jeśli istnieją statystyki, zazwyczaj używa wartości All Density (znanej również jako średnia gęstość) z histogramu statystycznego, aby oszacować, ile wierszy pasuje do predykatu. Jednak jeśli dla kolumny nie ma dostępnych statystyk, Database Engine opiera się na heurystycznych szacunkach, takich jak zakładanie 10% selektywności dla predykatów równości oraz 30% dla nierówności i zakresów. Te szacunki mogą prowadzić do mniej dokładnych planów realizacji. Oto przykład zapytania, które używa zmiennej lokalnej.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
W tym przypadku Database Engine nie używa wartości 100 do optymalizacji zapytania. Używa ona ogólnego oszacowania.
Równoległe przetwarzanie zapytań
Database Engine zapewnia zapytania równoległe do optymalizacji wykonywania zapytań i operacji na indeksach dla komputerów posiadających więcej niż jeden mikroprocesor (CPU). Ponieważ Database Engine może wykonywać zapytanie lub indeksowanie równolegle, korzystając z kilku wątków roboczych systemu operacyjnego, operacja kończy się szybko i sprawnie.
Podczas optymalizacji zapytań Database Engine szuka zapytań lub operacji indeksowych, które mogłyby skorzystać z równoległego wykonywania. Dla tych zapytań Database Engine wstawia operatory wymiany do planu wykonania zapytania, aby przygotować zapytanie do wykonania równoległego. Operator wymiany to operator w planie wykonywania zapytań, który zapewnia zarządzanie procesami, redystrybucję danych i sterowanie przepływem. Operator wymiany zawiera Distribute Streams, Repartition Streams oraz Gather Streams jako podtypy, z których co najmniej jeden może pojawić się w danych wyjściowych planu zapytania programu Showplan dla zapytania równoległego.
Ważne
Niektóre konstrukcje ograniczają zdolność Aparatu bazy danych do stosowania równoległości w całym planie wykonania lub w jego częściach.
Konstrukcje hamujące równoległość obejmują:
| Konstrukcja | Opis |
|---|---|
| Skalarne funkcje zdefiniowane przez użytkownika | Aby uzyskać więcej informacji o skalarnych funkcjach definiowanych przez użytkownika, zobacz Tworzenie funkcji zdefiniowanych przez użytkownika. Począwszy od SQL Server 2019 (15.x) aparat bazy danych SQL Server może dokonać inliningu tych funkcji i odblokować wykorzystanie równoległości podczas przetwarzania zapytań. Więcej informacji o skalarnym inliningu UDF można znaleźć w artykule Inteligentne przetwarzanie zapytań w bazach danych SQL. |
| Zapytanie zdalne | Więcej informacji o Remote Query można znaleźć w artykule Logical and physical showplan operator reference. |
| Dynamiczne kursory | Więcej informacji o kursorach można znaleźć w DECLARE CURSOR. |
| Zapytania cykliczne | Więcej informacji o rekurencji można znaleźć w Wytyczne dotyczące definiowania i używania rekurencyjnych wspólnych wyrażeń tabelarycznych oraz Rekurencja w T-SQL. |
| Funkcje z wieloma instrukcjami w tabeli (MSTVFs) | Więcej informacji o MSTVFs można znaleźć w artykule Create User-defined Functions (Database Engine). |
TOP słowo kluczowe |
Aby uzyskać więcej informacji, zobacz TOP. |
Plan wykonywania zapytania może zawierać atrybut NonParallelPlanReason w elemecie QueryPlan , który opisuje, dlaczego równoległość nie była używana. Wartości tego atrybutu to:
| Wartość NonParallelPlanReason | Opis |
|---|---|
MaxDOPSetToOne |
Maksymalny stopień równoległości ustawiony na 1. |
EstimatedDOPIsOne |
Szacowany stopień równoległości wynosi 1. |
NoParallelWithRemoteQuery |
Równoległość nie jest obsługiwana w przypadku zapytań zdalnych. |
NoParallelDynamicCursor |
Plany równoległe nie są obsługiwane w przypadku kursorów dynamicznych. |
NoParallelFastForwardCursor |
Plany równoległe nie są obsługiwane w przypadku szybkich kursorów do przodu. |
NoParallelCursorFetchByBookmark |
Plany równoległe nie są obsługiwane w przypadku kursorów pobieranych przy użyciu zakładki. |
NoParallelCreateIndexInNonEnterpriseEdition |
Równoległe tworzenie indeksu nie jest obsługiwane w przypadku wersji innej niż Enterprise. |
NoParallelPlansInDesktopOrExpressEdition |
Plany równoległe nie są obsługiwane w przypadku edycji Desktop i Express. |
NonParallelizableIntrinsicFunction |
Zapytanie odwołuje się do funkcji wewnętrznej, która nie może być równoległa. |
CLRUserDefinedFunctionRequiresDataAccess |
Przetwarzanie równoległe nie można użyć w przypadku funkcji UDF w CLR, która wymaga dostępu do danych. |
TSQLUserDefinedFunctionsNotParallelizable |
Zapytanie odwołuje się do funkcji zdefiniowanej przez użytkownika języka T-SQL, która nie była równoległa. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Transakcje zmiennych typu tabeli nie obsługują równoległych transakcji zagnieżdżonych. |
DMLQueryReturnsOutputToClient |
Zapytanie DML zwraca dane wyjściowe do klienta i nie może być wykonywane równolegle. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
Nieobsługiwana kombinacja planów szeregowych i równoległych dla pojedynczej kompilacji indeksu online. |
CouldNotGenerateValidParallelPlan |
Weryfikacja planu równoległego nie powiodła się, przejście do szeregowego. |
NoParallelForMemoryOptimizedTables |
Równoległość nie jest obsługiwana dla referencyjnych tabel OLTP In-Memory. |
NoParallelForDmlOnMemoryOptimizedTable |
Równoległe przetwarzanie nie jest obsługiwane dla DML w tabeli OLTP In-Memory. |
NoParallelForNativelyCompiledModule |
Równoległość nie jest obsługiwana w przypadku natywnie skompilowanych modułów. |
NoRangesResumableCreate |
Generowanie zakresu nie powiodło się w przypadku operacji tworzenia możliwej do wznowienia. |
Po wstawieniu operatorów wymiany powstaje plan wykonania zapytań równoległych. Plan wykonywania zapytań równoległych może używać więcej niż jednego wątku roboczego. Plan wykonania szeregowego, używany przez zapytanie nie równoległe (szeregowe), wykorzystuje tylko jeden wątek wykonawczy do jego realizacji. Rzeczywista liczba wątków roboczych używanych przez zapytanie równoległe jest ustalana podczas inicjalizacji wykonywania planu zapytania i zależy od złożoności planu oraz stopnia równoległości.
Stopień równoległości (DOP) określa maksymalną liczbę procesorów, które mogą być użyte do wykonania zadania równoległego. DOP nie wskazuje całkowitej liczby wątków roboczych używanych przez zapytanie. Limit DOP jest ustawiany dla zadania. Nie jest to ograniczenie na żądanie lub ograniczenie na zapytanie. Oznacza to, że podczas równoległego wykonywania zapytania pojedyncze żądanie może uruchomić wiele zadań przypisanych do harmonogramisty. Więcej procesorów niż określona przez MAXDOP liczba może być jednocześnie używanych w danym momencie wykonywania zapytania, gdy różne zadania są wykonywane równocześnie. Aby uzyskać więcej informacji, zobacz przewodnik dotyczący architektury wątków i zadań.
Optymalizator zapytań nie używa równoległego planu wykonania zapytania, jeśli spełniony jest którykolwiek z następujących warunków:
Plan wykonania szeregowego jest trywialny lub nie przekracza ustawienia progu kosztu dla równoległości.
Plan wykonywania szeregowego ma niższy całkowity szacowany koszt poddrzewa niż jakikolwiek równoległy plan wykonywania rozważany przez optymalizator.
Zapytanie zawiera operatory skalarne lub relacyjne, których nie można uruchomić równolegle. Niektóre operatory mogą spowodować uruchomienie sekcji planu zapytania w trybie seryjnym lub uruchomienie całego planu w trybie seryjnym.
Uwaga / Notatka
Łączny szacowany koszt poddrzewa planu równoległego może być niższy niż próg kosztów ustawienia równoległości. Innymi słowy, całkowity szacowany koszt poddrzewa planu seryjnego przekroczył koszt planu równoległego, a wybrano plan zapytania o niższym całkowitym szacowanym koszcie poddrzewa.
Stopień równoległości (DOP)
Aparat bazy danych automatycznie wykrywa najlepszy stopień równoległości dla każdego wystąpienia równoległego wykonywania zapytań lub operacji DDL indeksu. Określa tę wartość na podstawie następujących kryteriów:
Niezależnie od tego, czy program SQL Server jest uruchomiony na komputerze z więcej niż jednym mikroprocesorem, czy procesorem CPU, takim jak symetryczny komputer wieloprocesorowy (SMP). Tylko komputery z więcej niż jednym procesorem CPU mogą używać zapytań równoległych.
Czy są dostępne wystarczające wątki robocze. Każda operacja zapytania lub indeksu wymaga wykonania określonej liczby wątków roboczych. Wykonanie planu równoległego wymaga więcej wątków roboczych niż plan seryjny, a liczba wymaganych wątków roboczych zwiększa się wraz ze stopniem równoległości. Gdy wymóg wątku roboczego planu równoległego dla określonego stopnia równoległości nie może być spełniony, SQL Server Database Engine automatycznie zmniejsza stopień równoległości lub uruchamia plan równoległy szeregowo.
Wykonany typ operacji zapytania lub indeksu. Operacje indeksowania, które tworzą lub ponownie kompilują indeks, usuwają indeks klastrowany, oraz zapytania intensywnie korzystające z cykli CPU, są najlepszymi kandydatami do planu równoległego. Na przykład łączenia dużych tabel, duże agregacje i sortowanie wyników z dużych zestawów są dobrymi kandydatami. Podstawowe zapytania, często spotykane w aplikacjach do przetwarzania transakcji, wykazują, że dodatkowa koordynacja wymagana do wykonania zapytania równolegle przewyższa potencjalny wzrost wydajności. Aby odróżnić zapytania, które korzystają z równoległości i tych, które nie przynoszą korzyści, aparat bazy danych programu SQL Server porównuje szacowany koszt wykonywania operacji zapytania lub indeksu z progiem kosztu dla wartości równoległości . Użytkownicy mogą zmienić domyślną wartość
5przy użyciu sp_configure, jeśli odpowiednie testy wykażą, że inna wartość lepiej odpowiada bieżącemu obciążeniu.Czy istnieje wystarczająca liczba wierszy do przetworzenia. Jeśli optymalizator zapytań ustali, że liczba wierszy jest zbyt mała, nie wprowadza operatorów wymiany w celu dystrybucji wierszy. W związku z tym operatory są wykonywane szeregowo. Wykonywanie operatorów w serialnym planie pozwala uniknąć scenariuszy, gdy koszty uruchamiania, dystrybucji i koordynacji przewyższają zyski osiągnięte dzięki równoległemu wykonywaniu operatorów.
Czy dostępne są aktualne statystyki. Jeśli najwyższy stopień równoległości nie jest możliwy, niższe stopnie są brane pod uwagę przed porzuceniem planu równoległego. Na przykład, gdy tworzysz klastrowany indeks na widoku, statystyki nie mogą być oceniane, ponieważ indeks klastrowany jeszcze nie istnieje. W takim przypadku aparat bazy danych programu SQL Server nie może zapewnić najwyższego stopnia równoległości dla operacji indeksowania. Jednak niektóre operatory, takie jak sortowanie i skanowanie, mogą nadal korzystać z równoległego wykonywania.
Uwaga / Notatka
Równoległe operacje indeksowania są dostępne tylko w wersjach SQL Server Enterprise, Developer i Evaluation.
W czasie wykonywania aparat bazy danych programu SQL Server określa, czy bieżące obciążenie systemu i informacje o konfiguracji opisane wcześniej umożliwiają równoległe wykonywanie. Jeśli wykonywanie równoległe jest uzasadnione, aparat bazy danych programu SQL Server określa optymalną liczbę wątków roboczych i rozkłada wykonywanie planu równoległego w tych wątkach roboczych. Gdy operacja zapytania lub indeksu rozpoczyna wykonywanie na wielu wątkach roboczych na potrzeby wykonywania równoległego, ta sama liczba wątków procesów roboczych jest używana do momentu ukończenia operacji. Aparat bazy danych programu SQL Server ponownie sprawdza optymalną liczbę decyzji wątku roboczego za każdym razem, gdy plan wykonania jest pobierany z pamięci podręcznej planu. Na przykład jedno wykonanie buforowanego planu równoległego może działać seryjnie, późniejsze wykonanie tego samego planu może używać trzech wątków roboczych, a trzecie może korzystać z czterech wątków roboczych.
Operatory aktualizacji i usuwania w równoległym planie wykonania zapytań są wykonywane sekwencyjnie, ale klauzula instrukcji WHERE lub UPDATE może być wykonywana równolegle. Rzeczywiste zmiany danych są następnie szeregowo stosowane do bazy danych.
Począwszy od poziomu zgodności bazy danych 110, instrukcja SELECT ... INTO może być wykonywana równolegle. Inne formy operatorów wstawiania działają tak samo, jak opisano w poprzednich wersjach.
Począwszy od poziomu zgodności bazy danych 130 instrukcja INSERT ... SELECT może być wykonywana równolegle podczas wstawiania do stert lub klastrowanych indeksów magazynu kolumn (CCI) oraz przy użyciu wskazówki TABLOCK. Wstawianie do lokalnych tabel tymczasowych (identyfikowanych przez prefiks #) oraz do globalnych tabel tymczasowych (identyfikowanych przez prefiksy ##) są również obsługiwane w przetwarzaniu równoległym za pomocą podpowiedzi TABLOCK. Aby uzyskać więcej informacji, zobacz INSERT.
Statyczne i oparte na zestawie kluczy kursory mogą być wypełniane przez równoległe plany wykonywania. Jednak zachowanie kursorów dynamicznych może być udostępniane tylko przez wykonywanie szeregowe. Optymalizator zapytań zawsze generuje plan wykonywania szeregowego dla zapytania będącego częścią kursora dynamicznego.
Przesłanianie stopni równoległości
Stopień równoległości określa liczbę procesorów do użycia w równoległym wykonywaniu planu. Możesz ustawić tę konfigurację na różnych poziomach:
Na poziomie serwera, korzystając z opcji konfiguracji serwera maksymalny stopień równoległości (
MAXDOP).Dotyczy: SQL Server
SQL Server 2019 (15.x) wprowadził automatyczne zalecenia dotyczące ustawiania
MAXDOPopcji konfiguracji serwera podczas procesu instalacji. Interfejs użytkownika konfiguracji umożliwia akceptowanie zalecanych ustawień lub wprowadzanie własnej wartości. Aby uzyskać więcej informacji, zobacz Stronę Konfiguracja aparatu bazy danych — MaxDOP.Poziom obciążenia, korzystając z
MAX_DOPopcji konfiguracji grupy obciążenia Resource Governor.Dotyczy: SQL Server
Na poziomie bazy danych, korzystając
MAXDOPz konfiguracji o zakresie bazy danych.Dotyczy: SQL Server, Azure SQL Database oraz Azure SQL Managed Instance
Na poziomie zapytania lub instrukcji indeksu, przy użyciu
MAXDOPwskazówki zapytania lub opcjiMAXDOPindeksu. Na przykład możesz użyć opcjiMAXDOP, aby kontrolować, poprzez zwiększanie lub zmniejszanie, liczbę procesorów dedykowanych operacji indeksu online. W ten sposób można zrównoważyć wykorzystanie zasobów przez operację indeksowania z wykorzystaniem zasobów przez współbieżnych użytkowników.Dotyczy do: SQL Server, Azure SQL Database oraz Azure SQL Managed Instance
Ustawienie opcji max degree of parallelism na 0 (0 domyślnie) pozwala aparatowi Database Engine korzystać ze wszystkich dostępnych procesorów, maksymalnie 64 procesorów, w równoległym wykonaniu planu. Chociaż Database Engine ustawia docelowo 64 procesory logiczne w czasie wykonywania, gdy opcja MAXDOP jest ustawiona na 0, możesz ręcznie ustawić inną wartość, jeśli zajdzie taka potrzeba. Ustawienie MAXDOP na 0 dla zapytań i indeksów pozwala aparatowi bazy danych wykorzystać wszystkie dostępne procesory, maksymalnie do 64 procesorów, dla tych zapytań lub indeksów podczas wykonywania planu równoległego.
MAXDOP nie jest wymuszoną wartością dla wszystkich zapytań równoległych, lecz raczej wstępnym celem dla wszystkich zapytań kwalifikujących się do przetwarzania równoległego. Oznacza to, że jeśli w czasie działania nie ma wystarczającej liczby wątków roboczych, zapytanie może wykonać się z niższym stopniem równoległości niż wartość określona przez opcję konfiguracji serwera MAXDOP.
Wskazówka
Więcej informacji można znaleźć w rekomendacjach MAXDOP, gdzie znajdziesz wytyczne dotyczące konfiguracji MAXDOP na poziomie serwera, bazy danych, zapytania lub wskazówki.
Przykład zapytania równoległego
Poniższe zapytanie zlicza liczbę zamówień złożonych w danym kwartale, począwszy od 1 kwietnia 2024 roku, w których co najmniej jedna pozycja zamówienia została otrzymana przez klienta później niż uzgodniona data. To zapytanie zawiera listę liczby takich zamówień pogrupowanych według każdego priorytetu zamówienia i posortowanych w kolejności rosnącego priorytetu.
W tym przykładzie użyto teoretycznych nazw tabel i kolumn.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Załóżmy, że następujące indeksy są zdefiniowane w tabelach lineitem i :orders
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Poniżej przedstawiono jeden możliwy plan równoległy wygenerowany dla wcześniej pokazanego zapytania:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
Poniższa ilustracja przedstawia plan zapytania wykonany z poziomem równoległości równym 4 i obejmującym połączenie dwóch tabel.
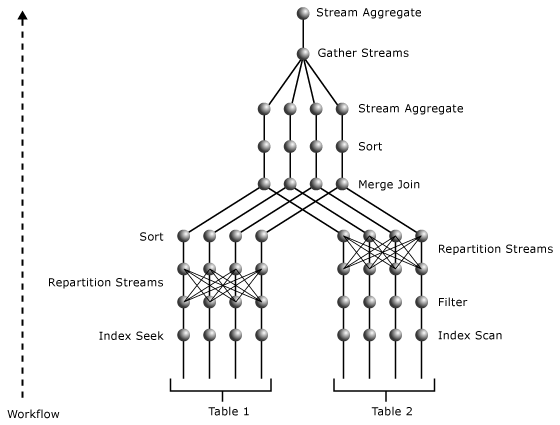
Plan równoległy zawiera trzy operatory równoległości. Zarówno operator Wyszukiwania Indeksu o_datkey_ptr, jak i operator Skanowania Indeksu l_order_dates_idx są wykonywane równolegle. Proces ten generuje kilka oddzielnych strumieni, które można określić na podstawie najbliższych operatorów równoległości znajdujących się odpowiednio powyżej operatora Index Scan i operatora Index Seek. Obaj operatorzy ponownie partycjonują typ wymiany. Przetasowują dane między strumieniami i generują tyle samo strumieni na swoim wyjściu, co na swoich wejściach. Ta liczba strumieni jest równa stopniowi równoległości.
Operator równoległości powyżej operatora l_order_dates_idx Index Scan dzieli swoje strumienie wejściowe na nowo, używając wartości L_ORDERKEY jako klucza. W ten sposób te same wartości L_ORDERKEY są wyświetlane w tym samym strumieniu wyjściowym. Jednocześnie strumienie wyjściowe utrzymują kolejność w L_ORDERKEY kolumnie, aby spełnić wymagania wejściowe operatora scalania sprzężenia.
Operator równoległości nad operatorem Index Seek repartycjonuje jego strumienie wejściowe za pomocą wartości O_ORDERKEY. Ponieważ jego wejście nie jest sortowane według wartości kolumny O_ORDERKEY, a ta kolumna jest kolumną join w operatorze Merge Join, operator Sort między operatorami równoległości a Merge Join zapewnia, że wejście jest posortowane dla operatora Merge Join według kolumn join. Operator Sort, podobnie jak operator łączenia przez scalanie, jest wykonywany równolegle.
Najwyższy operator równoległości zbiera wyniki z kilku strumieni w jeden strumień. Częściowe agregacje wykonywane przez operator Agregacji Strumienia poniżej operatora równoległości są następnie kumulowane do jednej SUM wartości dla każdej unikalnej wartości O_ORDERPRIORITY przez operator Agregacji Strumienia powyżej operatora równoległości. Ponieważ ten plan składa się z dwóch segmentów wymiany, o stopniu równoległości równym 4, wykorzystuje osiem wątków roboczych.
Więcej informacji o operatorach użytych w tym przykładzie można znaleźć w artykule Logical and physical showplan operator reference.
Równoległe operacje indeksowania
Plany zapytań dla operacji indeksowych tworzących, odbudowujących lub usuwających indeks klastrowany mogą wspierać równoległe, wielowątkowe operacje na komputerach z wieloma procesorami.
Uwaga / Notatka
Równoległe operacje indeksowe są dostępne tylko w edycji Enterprise.
Database Engine używa tych samych algorytmów do określania stopnia równoległości (łącznej liczby oddzielnych wątków roboczych do uruchomienia) dla operacji indeksowych, co dla innych zapytań. Opcja konfiguracji serwera maksymalny stopień równoległości ustala maksymalny stopień równoległości dla operacji indeksowej. Możesz nadpisać max degree of parallelism wartość dla poszczególnych operacji indeksowych, ustawiając opcję indeksu MAXDOP w instrukcjach CREATE INDEX, ALTER INDEX, DROP INDEX, i ALTER TABLE .
Gdy SQL Server Database Engine buduje plan wykonania dla indeksu, liczba równoległych operacji jest ustalana na najniższą wartość spośród tych wartości:
- Liczba procesorów, czyli CPU, w komputerze.
- Liczba podana w opcji konfiguracji serwera
max degree of parallelism. - Liczba procesorów, które nie są jeszcze powyżej progu wykonanej pracy dla wątków roboczych SQL Server.
Na przykład na komputerze z ośmioma procesorami, ale gdzie max degree of parallelism jest ustawione na 6, operacja indeksowania używa nie więcej niż sześciu równoległych wątków roboczych. Jeśli pięć procesorów CPU na komputerze przekroczy próg pracy programu SQL Server podczas tworzenia planu wykonywania indeksu, plan wykonywania określa tylko trzy równoległe wątki procesu roboczego.
Główne fazy równoległej operacji indeksowej obejmują:
- Koordynujący wątek roboczy szybko i losowo skanuje tabelę, aby oszacować rozkład kluczy indeksu. Koordynujący wątek roboczy ustala granice kluczy, które tworzą liczbę zakresów kluczy równą stopniowi operacji równoległych, gdzie każdy zakres kluczy jest szacowany na podobną liczbę wierszy. Na przykład, jeśli w tabeli jest cztery miliony wierszy, a stopień równoległości wynosi 4, to koordynujący wątek roboczy określa wartości kluczowe wyznaczające cztery zestawy wierszy z 1 milionem wierszy w każdym zbiorze. Jeśli koordynujący wątek roboczy nie jest w stanie ustalić wystarczającej liczby zakresów kluczy, aby wykorzystać wszystkie procesory, odpowiednio zmniejsza stopień równoległości.
- Koordynujący wątek roboczy uruchamia liczbę wątków roboczych równą liczbie równoległych operacji i czeka na zakończenie przez nie pracy. Każdy wątek roboczy skanuje tabelę podstawową przy użyciu filtru, który pobiera tylko wiersze z wartościami klucza w zakresie przypisanym do wątku roboczego. Każdy wątek roboczy tworzy strukturę indeksu dla wierszy w swoim zakresie kluczy. W przypadku indeksu partycjonowanego każdy wątek procesu roboczego tworzy określoną liczbę partycji. Partycje nie są dzielone przez wątki robocze.
- Po zakończeniu wszystkich równoległych wątków roboczych, koordynujący wątek roboczy łączy podjednostki indeksowe w jeden indeks. Ta faza dotyczy tylko operacji indeksowania w trybie offline.
Poszczególne CREATE TABLE lub ALTER TABLE polecenia mogą mieć wiele ograniczeń wymagających utworzenia indeksu. Te operacje tworzenia wielu indeksów są wykonywane w serii, chociaż każda pojedyncza operacja tworzenia indeksu może być operacją równoległą na komputerze, który ma wiele procesorów CPU.
Architektura zapytań rozproszonych
Database Engine obsługuje dwie metody odwoływania się do heterogenicznych źródeł danych OLE DB w instrukcjach T-SQL:
Nazwy serwerów połączonych
Użyj procedur przechowywanych w systemie
sp_addlinkedserverisp_addlinkedsrvlogin, aby nadać źródłu danych OLE DB nazwę serwera. Możesz odwoływać się do obiektów na tych połączonych serwerach w instrukcjach T-SQL, używając nazw czteroczęściowych. Na przykład, jeśli nazwa połączonego serweraDeptSQLSrvrjest zdefiniowana dla innego wystąpienia SQL Server, następujące polecenie odwołuje się do tabeli na tym serwerze:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Możesz także określić nazwę serwera połączonego w instrukcji
OPENQUERY, aby uzyskać dostęp do zbioru wierszy ze źródła danych OLE DB. Następnie możesz odwoływać się do tego zestawu wierszy jak do tabeli w instrukcjach T-SQL.Nazwy łączników ad hoc
W przypadku sporadycznych odwołań do źródła danych należy określić funkcje
OPENROWSETlubOPENDATASOURCEz informacjami potrzebnymi do połączenia z połączonym serwerem. Możesz wtedy odwoływać się do zestawu wierszy tak samo, jak w instrukcjach T-SQL odwołujesz się do tabeli:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
Database Engine wykorzystuje OLE DB do komunikacji między silnikiem relacyjnym a silnikiem pamięci masowej. Silnik relacyjny rozkłada każde polecenie T-SQL na serię operacji na podstawowych zestawach wierszy OLE DB, które silnik magazynu otwiera z tabel bazowych. Proces ten oznacza, że silnik relacyjny może również otwierać podstawowe zestawy wierszy OLE DB na dowolnym źródle danych OLE DB.
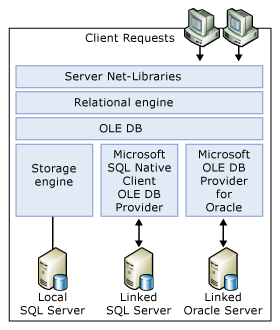
Aparat relacyjny używa interfejsu programowania aplikacji OLE DB (API) do otwierania zestawów wierszy na serwerach połączonych, pobierania wierszy i zarządzania transakcjami.
Dla każdego źródła danych OLE DB, do którego uzyskujesz dostęp jako serwera połączonego, serwer działający na SQL Server musi mieć dostawcę OLE DB. Zestaw operacji T-SQL, które możesz wykonywać względem określonego źródła danych OLE DB, zależy od możliwości dostawcy OLE DB.
Dla każdej instancji SQL Server członkowie stałej roli serwera sysadmin mogą włączać lub wyłączać używanie nazw złączy ad hoc dla dostawcy OLE DB za pomocą właściwości SQL Server DisallowAdhocAccess. Po włączeniu dostępu ad hoc każdy użytkownik zalogowany do tej instancji może wykonać instrukcje T-SQL zawierające nazwy łączników ad hoc, odwołując się do dowolnego źródła danych w sieci, do którego ma dostęp dostawca OLE DB. Aby kontrolować dostęp do źródeł danych, członkowie stałej roli serwera sysadmin mogą wyłączyć dostęp ad hoc dla danego dostawcy OLE DB, ograniczając tym samym użytkowników wyłącznie do tych źródeł danych, do których odwołują się nazwy serwerów połączonych zdefiniowane przez administratorów. Domyślnie dostęp ad hoc jest włączony dla dostawcy OLE DB programu SQL Server i wyłączony dla wszystkich innych dostawców OLE DB.
Zapytania rozproszone mogą umożliwić użytkownikom dostęp do innego źródła danych (na przykład plików, źródeł danych nierelacyjnych, takich jak Active Directory, itd.) poprzez wykorzystanie kontekstu bezpieczeństwa konta systemu Windows, w kontekście którego działa usługa SQL Server. SQL Server odpowiednio personifikuje poświadczenia dla logowań systemu Windows. Jednak takie podszywanie się nie jest możliwe dla kont logowania SQL Server. To ograniczenie może potencjalnie umożliwić użytkownikowi zapytania rozproszonego dostęp do innego źródła danych, do którego nie posiada uprawnień, ale konto, na którym działa usługa SQL Server, ma uprawnienia. Użyj sp_addlinkedsrvlogin do zdefiniowania konkretnych identyfikatorów logowania, które są autoryzowane do uzyskiwania dostępu do odpowiedniego serwera połączonego. Ta opcja nie jest dostępna dla nazw ad hoc, więc zachowaj ostrożność przy włączaniu dostawcy OLE DB na potrzeby dostępu ad hoc.
Gdy to możliwe, Database Engine przekazuje operacje relacyjne, takie jak joins, ograniczenia, projekcje, sortowanie i operacje grupowania, do źródła danych OLE DB. Database Engine domyślnie nie skanuje tabeli bazowej do programu SQL Server i nie wykonuje operacji relacyjnych samodzielnie. Database Engine zadaje zapytania dostawcy OLE DB, aby określić poziom gramatyki SQL obsługiwanej przez niego i na podstawie tych informacji przekazuje dostawcy jak najwięcej operacji relacyjnych.
Database Engine określa mechanizm, w którym dostawca OLE DB zwraca statystyki wskazujące, jak wartości kluczowe są rozmieszczone w obrębie źródła danych OLE DB. Ten mechanizm pozwala Database Engine Query Optimizer lepiej analizować wzorzec danych w źródle danych w odniesieniu do wymagań każdego polecenia T-SQL, zwiększając możliwości Query Optimizera do generowania optymalnych planów wykonania.
Przetwarzanie zapytań w tabelach partycjonowanych i indeksach
Aparat bazy danych obsługuje przetwarzanie zapytań uwzględniające partycje dla tabel i indeksów partycjonowanych. Ta sekcja opisuje, jak procesor zapytań obsługuje obiekty partycjonowane, jak interpretować plany wykonawcze obejmujące partycjonowanie oraz najlepsze praktyki poprawy wydajności zapytań na obiektach partycjonowanych.
Uwaga / Notatka
Tabele partycjonowane i indeksy są obsługiwane w edycji SQL Server Standard, począwszy od SQL Server 2016 (13.x) z Service Pack 1.
Nowa funkcja wyszukiwania uwzględniająca partycje
W Database Engine procesor zapytań wewnętrznie postrzega podzieloną tabelę jako indeks wielokolumnowy, gdzie PartitionID jest kolumną wiodącą.
PartitionID jest ukrytą kolumną obliczeniową używaną wewnętrznie do reprezentowania ID partycji zawierającej określony wiersz. Na przykład załóżmy, że tabela T, zdefiniowana jako T(a, b, c), jest partycjonowana według kolumny a, a ma klastrowany indeks na kolumnie b. Ta tabela partycjonowana jest traktowana jako tabela niepartycjonowana, ze schematem T(PartitionID, a, b, c) i klastrowanym indeksem na kluczu złożonym (PartitionID, b). Ta reprezentacja umożliwia optymalizatorowi zapytań wykonywanie operacji poszukiwania na podstawie PartitionID na dowolnej partycjonowanej tabeli lub indeksie.
Eliminacja partycji jest teraz wykonywana w tej operacji wyszukiwania.
Dodatkowo optymalizator zapytań jest rozszerzony tak, aby operację wyszukiwania lub skanowania z jednym warunkiem można było wykonać na PartitionID (jako logicznej kolumnie wiodącej) i ewentualnie na innych kolumnach klucza indeksowego. Procesor zapytań wykonuje następnie wyszukiwanie drugiego poziomu, z innym warunkiem, na jednej lub większej liczbie dodatkowych kolumn dla każdej odrębnej wartości spełniającej kryteria operacji wyszukiwania pierwszego poziomu. Ta operacja, zwana partition skip scan, pozwala optymalizatorowi zapytań wykonać operację poszukiwania lub skanowania na podstawie jednego warunku określającego partycje, do których należy uzyskać dostęp, oraz operację poszukiwania indeksu drugiego poziomu w ramach tego operatora, która zwraca wiersze z tych partycji spełniające inny warunek. Rozważmy na przykład następujące zapytanie.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
W tym przykładzie załóżmy, że tabela T, zdefiniowana jako T(a, b, c), jest partycjonowana względem kolumny a i ma klastrowany indeks na kolumnie b. Następująca funkcja partycji definiuje granice podziału dla tabeli T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Aby rozwiązać zapytanie, procesor zapytań wykonuje operację wyszukiwania pierwszego poziomu, aby znaleźć każdą partycję zawierającą wiersze spełniające warunek T.a < 10. Ta operacja identyfikuje partycje, do których należy uzyskać dostęp. W każdej zidentyfikowanej partycji procesor następnie wykonuje wyszukiwanie drugiego poziomu w indeksie klastrowanym dla kolumny b, aby znaleźć wiersze spełniające warunek T.b = 2 i T.a < 10.
Poniższa ilustracja przedstawia logiczną reprezentację operacji skanu pomijania partycji. Przedstawia tabelę T z danymi w kolumnach a i b. Partycje są numerowane od 1 do 4 z granicami partycji wyświetlanymi przez kreskowane linie pionowe. Operacja wyszukiwania pierwszego poziomu w partycjach (niepokazana na ilustracji) ustala, że partycje 1, 2 i 3 spełniają warunek wyszukiwania wynikający z podziału zdefiniowanego dla tabeli i predykatu dotyczącego kolumny a (T.a < 10). Ścieżka pokonywana podczas przeszukiwania drugiego poziomu jest zilustrowana zakrzywioną linią. W zasadzie operacja przeszukuje każdą z tych partycji w poszukiwaniu wierszy spełniających warunek b = 2. Całkowity koszt operacji jest taki sam jak koszt trzech oddzielnych przeszukań indeksu.
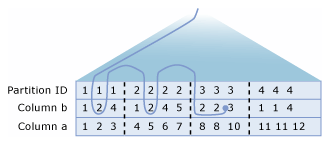
Wyświetlanie informacji o partycjonowaniu w planach wykonywania zapytań
Zbadaj plany wykonania zapytań na tabelach partycjonowanych i indeksach, używając instrukcji SET SHOWPLAN_XML T-SQL SET lub SET STATISTICS XML, albo korzystając z graficznych danych wyjściowych planu wykonania w SSMS. Na przykład możesz wyświetlić plan wykonania w czasie kompilacji, wybierając Display Estimated Execution Plan na pasku narzędzi Edytor Power Query, a plan wykonania w czasie wykonywania, wybierając Include Actual Execution Plan.
Korzystając z tych narzędzi, możesz znaleźć następujące informacje:
- Operacje takie jak skanowanie, wyszukiwanie, wstawianie, aktualizacje, scalanie i usuwanie, uzyskujące dostęp do tabel partycjonowanych lub indeksów.
- Partycje, do których uzyskuje dostęp zapytanie. Na przykład plany wykonania w czasie działania obejmują łączną liczbę partycji, do których uzyskuje się dostęp, oraz zakresy przylegających partycji, do których uzyskuje się dostęp.
- Gdy operacja partition skip scan jest używana w operacji wyszukiwania lub skanowania w celu pobrania danych z co najmniej jednej partycji.
Ulepszenia informacji o partycji
Mechanizm bazy danych zapewnia ulepszone informacje dotyczące partycjonowania zarówno dla planów wykonania w czasie kompilacji, jak i w czasie wykonywania. Plany wykonywania zawierają teraz następujące informacje:
- Opcjonalny
Partitionedatrybut wskazujący, że operator taki jak wyszukiwanie, skanowanie, wstawienie, aktualizacja, scalenie lub usuwanie jest wykonywany na tabeli partycjonowanej. - Nowy element
SeekPredicateNewz podelementemSeekKeys, który zawieraPartitionIDjako kolumnę klucza indeksu wiodącego i warunki filtrowania, które określają wyszukiwanie zakresowe naPartitionID. Obecność dwóchSeekKeyspodelementów wskazuje na skanowanie z pominięciem partycji naPartitionID. - Podsumowanie informacji, które zawierają łączną liczbę partycji, do których uzyskiwano dostęp. Te informacje są dostępne tylko w planach czasu wykonywania.
Aby zademonstrować sposób wyświetlania tych informacji zarówno w danych wyjściowych graficznego planu wykonywania, jak i danych wyjściowych programu XML Showplan, rozważ następujące zapytanie w tabeli fact_salespartycjonowanej . To zapytanie aktualizuje dane w dwóch partycjach.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
Poniższa ilustracja przedstawia właściwości operatora Clustered Index Seek w planie wykonywania środowiska uruchomieniowego dla tego zapytania. Aby zobaczyć definicję tabeli fact_sales i definicję podziału, zobacz Przykład.

Atrybut partycjonowany
Gdy operator taki jak "Index Seek" jest wykonywany na partycjonowanej tabeli lub indeksie, atrybut Partitioned pojawia się w planie czasu kompilacji i wykonania, i jest ustawiony na wartość True (1). Atrybut nie wyświetla się, gdy jest ustawiony na False (0).
Atrybut Partitioned może pojawić się w następujących operatorach fizycznych i logicznych:
- Skanowanie tabeli
- Skanowanie indeksu
- Wyszukiwanie indeksu
- Wstawiać
- Aktualizacja
- Usuń
- Połącz
Jak pokazano na poprzedniej ilustracji, atrybut ten pojawia się we właściwościach operatora, w którym jest definiowany. W wyjściu XML Showplan ten atrybut pojawia się jako Partitioned="1" w węźle RelOp operatora, w którym jest zdefiniowany.
Nowy predykat wyszukiwania
W wyjściu XML Showplan element SeekPredicateNew pojawia się w operatorze, w którym jest zdefiniowany. Może zawierać maksymalnie dwa wystąpienia podelementu SeekKeys . Pierwszy SeekKeys element określa operację wyszukiwania pierwszego poziomu na poziomie identyfikatora partycji indeksu logicznego. To znaczy, że ta operacja seek określa partycje, do których należy uzyskać dostęp, aby spełnić warunki zapytania. Drugi SeekKeys element określa wyszukiwanie drugiego poziomu, które występuje w każdej partycji zidentyfikowanej w wyszukiwaniu pierwszego poziomu.
Podsumowanie partycji
W planach wykonawczych podczas działania, informacje podsumowujące dotyczące partycji zawierają liczbę partycji, do których uzyskano dostęp, oraz identyfikację rzeczywistych partycji, do których uzyskano dostęp. Te informacje umożliwiają sprawdzenie, czy dostęp do poprawnych partycji jest uzyskiwany w zapytaniu i czy wszystkie inne partycje zostały wyeliminowane z uwagi.
Podano następujące informacje: Actual Partition Count, i Partitions Accessed.
Actual Partition Count jest całkowitą liczbą partycji, do których uzyskuje dostęp zapytanie.
Partitions Accessed, w wyjściu XML Showplan, to podsumowanie partycji, które pojawia się w nowym RuntimePartitionSummary elemencie w RelOp węźle operatora, w którym jest zdefiniowany. W poniższym przykładzie pokazano zawartość RuntimePartitionSummary elementu wskazującą, że są dostępne dwie łączne partycje (partycje 2 i 3).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Wyświetlanie informacji o partycjach za pomocą innych metod showplanu
Metody Showplan SHOWPLAN_ALL, SHOWPLAN_TEXT i STATISTICS PROFILE nie zgłaszają informacji o partycjonowaniu opisanej w tym artykule, z następującym wyjątkiem. W ramach predykatu SEEK, partycje, do których należy uzyskać dostęp, są identyfikowane przez predykat zakresu w obliczonej kolumnie reprezentującej identyfikator partycji. Poniższy przykład pokazuje SEEK predykat dla Clustered Index Seek operatora. Uzyskuje się dostęp do partycji 2 i 3, a operator wyszukiwania filtruje wiersze spełniające warunek date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Interpretowanie planów wykonywania dla partycjonowanych stert
Sterta partycjonowana jest traktowana jako indeks logiczny na identyfikatorze partycji. W planie wykonania eliminacja partycji na stercie partycjonowanej jest reprezentowana jako Table Scan operator z SEEK predykatem na ID partycji. W poniższym przykładzie przedstawiono podane informacje o programie Showplan:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Interpretowanie planów wykonywania dla sprzężeń współlokowanych
Kollokacja łączenia może wystąpić, gdy dwie tabele są partycjonowane przy użyciu tej samej lub równoważnej funkcji partycjonowania, a kolumny partycjonowania z obu stron łączenia są określone w warunku łączenia zapytania. Optymalizator zapytań może wygenerować plan, w którym partycje każdej tabeli z równymi identyfikatorami partycji są łączone oddzielnie. Połączone sprzężenia mogą być szybsze niż sprzężenia niezwiązane, ponieważ mogą wymagać mniej pamięci i czasu przetwarzania. Optymalizator zapytań wybiera plan nieskorelowany lub skorelowany na podstawie szacunków kosztów.
W zaplanowanym planie Nested Loops sprzężenie odczytuje co najmniej jedną sprzężonej tabeli lub partycji indeksu po stronie wewnętrznej. Liczby w operatorach Constant Scan reprezentują numery partycji.
Gdy generowane są plany równoległe dla pokrywających się sprzężeń partycjonowanych tabel lub indeksów, operator Równoległości pojawia się między operatorami sprzężeń Constant Scan i Nested Loops. W tym przypadku wiele wątków roboczych po zewnętrznej stronie sprzężenia odczytuje i pracuje na różnych partycjach.
Na poniższej ilustracji przedstawiono równoległy plan zapytania dla sprzężenia posuwanego.
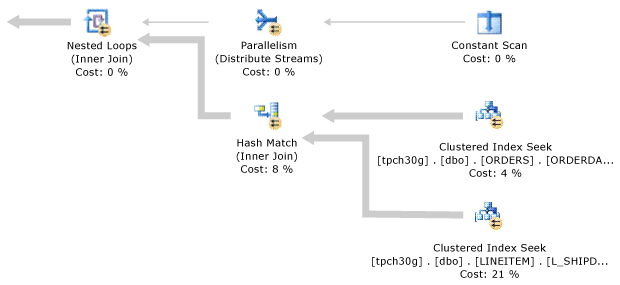
Strategia równoległego wykonywania zapytań dla partycjonowanych obiektów
Procesor zapytań używa strategii wykonywania równoległego dla zapytań wybranych z partycjonowanych obiektów. W ramach strategii wykonywania procesor zapytań określa partycje tabeli wymagane dla zapytania oraz proporcje wątków procesów roboczych do przydzielenia do każdej partycji. W większości przypadków procesor zapytań przydziela równą lub prawie równą liczbę wątków roboczych do każdej partycji, a następnie wykonuje zapytanie równolegle w partycjach. W poniższych akapitach wyjaśniono bardziej szczegółowo alokację wątków roboczych.
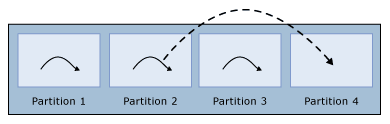
Jeśli liczba wątków roboczych jest mniejsza niż liczba partycji, procesor zapytań przypisuje każdy wątek procesu roboczego do innej partycji, początkowo pozostawiając co najmniej jedną partycję bez przypisanego wątku roboczego. Gdy wątek roboczy zakończy wykonywanie na partycji, procesor zapytań przypisuje go do następnej partycji, aż każda partycja otrzyma pojedynczy wątek roboczy. Ten przydział jest jedynym przypadkiem, w którym procesor zapytań ponownie przydziela wątki robocze do innych partycji.
Pokazuje wątek procesu roboczego ponownie przydzielony po zakończeniu. Jeśli liczba wątków roboczych jest równa liczbie partycji, procesor zapytań przypisuje jeden wątek procesu roboczego do każdej partycji. Po zakończeniu wątku roboczego nie zostanie on ponownie przeniesiony do innej partycji.
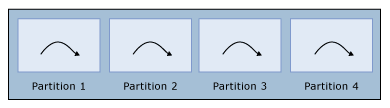
Jeśli liczba wątków roboczych jest większa niż liczba partycji, procesor zapytań przydziela taką samą liczbę wątków roboczych do każdej partycji. Jeśli liczba wątków roboczych nie jest dokładną wielokrotnością liczby partycji, procesor zapytań przydziela jeden dodatkowy wątek roboczy do niektórych partycji, aby wykorzystać wszystkie dostępne wątki robocze. Jeśli jest tylko jedna partycja, wszystkie wątki robocze są przypisane do tej partycji. Na poniższym diagramie występują cztery partycje i 14 wątków roboczych. Każda partycja ma przypisane trzy wątki robocze, a dwie partycje mają dodatkowy wątek roboczy, co daje łącznie 14 przypisań wątków roboczych. Wątek roboczy, po zakończeniu pracy, nie jest ponownie przypisywany do innej partycji.
Chociaż poprzednie przykłady sugerują prosty sposób alokacji wątków roboczych, rzeczywista strategia jest bardziej złożona i uwzględnia inne zmienne występujące podczas wykonywania zapytań. Na przykład, jeśli tabela jest spartycjonowana i ma klasteryzowany indeks w kolumnie A, a zapytanie ma klauzulę predykatu WHERE A IN (13, 17, 25), procesor zapytań przydziela jeden lub więcej wątków roboczych do każdej z tych trzech wartości wyszukiwania (A = 13, A = 17 i A = 25) zamiast do każdej partycji tabeli. Wystarczy wykonać zapytanie w partycjach zawierających te wartości, a jeśli wszystkie te predykaty szukania znajdują się w tej samej partycji tabeli, wszystkie wątki robocze są przypisane do tej samej partycji tabeli.
Aby podać kolejny przykład, załóżmy, że tabela ma cztery podziały na kolumnie A z punktami brzegowymi (10, 20, 30), indeks w kolumnie B, a zapytanie ma klauzulę predykatową WHERE B IN (50, 100, 150). Ponieważ partycje tabel opierają się na wartościach A, wartości B mogą występować w dowolnej z partycji tabeli. W związku z tym procesor zapytań wyszukuje każdą z trzech wartości B (50, 100, 150) w każdej z czterech partycji tabeli. Procesor zapytań przypisuje wątki robocze proporcjonalnie, aby móc wykonywać każde z tych 12 skanowań zapytania równolegle.
Podziały tabeli oparte na kolumnie A |
Wyszukuje kolumnę B w każdej partycji tabeli |
|---|---|
Podział tabeli 1: A < 10 |
B = 50, B = 100B = 150 |
Partycja tabeli 2: A >= 10 AND A < 20 |
B = 50, B = 100B = 150 |
Partycja tabeli 3: A >= 20 AND A < 30 |
B = 50, B = 100B = 150 |
Podział tabeli 4: A >= 30 |
B = 50, B = 100B = 150 |
Najlepsze rozwiązania
Aby poprawić wydajność zapytań uzyskujących dostęp do dużej ilości danych z dużych tabel partycjonowanych i indeksów, stosuj się do następujących najlepszych praktyk:
Rozebraj każdą partycję na wiele dysków. To podejście jest szczególnie istotne przy użyciu dysków talerzowych.
Jeśli to możliwe, użyj serwera z wystarczającą ilością pamięci głównej, aby zmieścić często używane partycje lub wszystkie partycje w pamięci, aby zmniejszyć koszt operacji we/wy.
Jeśli dane, które odpytujesz, nie mieszczą się w pamięci, skompresuj tabele i indeksy, aby zmniejszyć koszty I/O.
Użyj serwera z szybkimi procesorami i dowolną liczbą rdzeni procesora, na które można sobie pozwolić, aby skorzystać z możliwości przetwarzania zapytań równoległych.
Upewnij się, że serwer ma wystarczającą przepustowość kontrolera we/wy.
Utwórz indeks klastrowany w każdej dużej tabeli podzielonej na partycje, aby skorzystać z optymalizacji skanowania drzewa B.
Podczas masowego ładowania danych do tabel partycjonowanych należy stosować się do zalecanych najlepszych praktyk opisanych w białej księdze The Data Loading Performance Guide.
Przykład
Poniższy przykład tworzy testową bazę danych zawierającą jedną tabelę z siedmioma partycjami. Aby zobaczyć informacje o partycjonowaniu zarówno dla planów kompilacji, jak i w czasie wykonywania skorzystaj z narzędzi opisanych w sekcji Display partitioning information in query execution plans podczas wykonywania zapytań w tym przykładzie.
Uwaga / Notatka
Ten przykład wstawia do tabeli ponad 1 milion wierszy. Uruchomienie tego przykładu może potrwać kilka minut w zależności od sprzętu. Przed wykonaniem tego przykładu sprawdź, czy masz więcej niż 1,5 GB dostępnego miejsca na dysku.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Treści powiązane
- Odwołanie do operatora logicznego i fizycznego planu wykonania
- Omówienie zdarzeń rozszerzonych
- Najlepsze rozwiązania dotyczące monitorowania obciążeń za pomocą magazynu zapytań
- Estymacja kardynalności (SQL Server)
- inteligentne przetwarzanie zapytań w bazach danych SQL
- Pierwszeństwo operatora (Transact-SQL)
- Omówienie planu wykonania
- Performance Center dla aparatu bazy danych SQL Server i usługi Azure SQL Database