Dane profilu
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Przed oczyszczeniem lub przekształceniem danych należy zrozumieć, co znajduje się w tabelach. Profilowanie danych oznacza badanie zestawów danych w celu generowania statystyk podsumowania — liczb, średnich, rozkładów wartości oraz procentów wartości brakujących — które ujawniają jakość i strukturę Twoich danych. Ta podstawa ułatwia identyfikowanie problemów, takich jak brakujące wartości, wartości odstające i nieoczekiwane wzorce, zanim spowodują problemy podrzędne.
W tej lekcji dowiesz się, jak generować statystyki podsumowania przy użyciu poleceń SQL i funkcji profilowania danych w usłudze Azure Databricks.
Generowanie statystyk podsumowania przy użyciu języka SQL
Usługa Azure Databricks udostępnia polecenia SQL, które zbierają i wyświetlają statystyki dotyczące tabel. Te statystyki pomagają optymalizatorowi zapytań wybrać wydajne plany wykonywania i zapewnić wgląd w cechy danych.
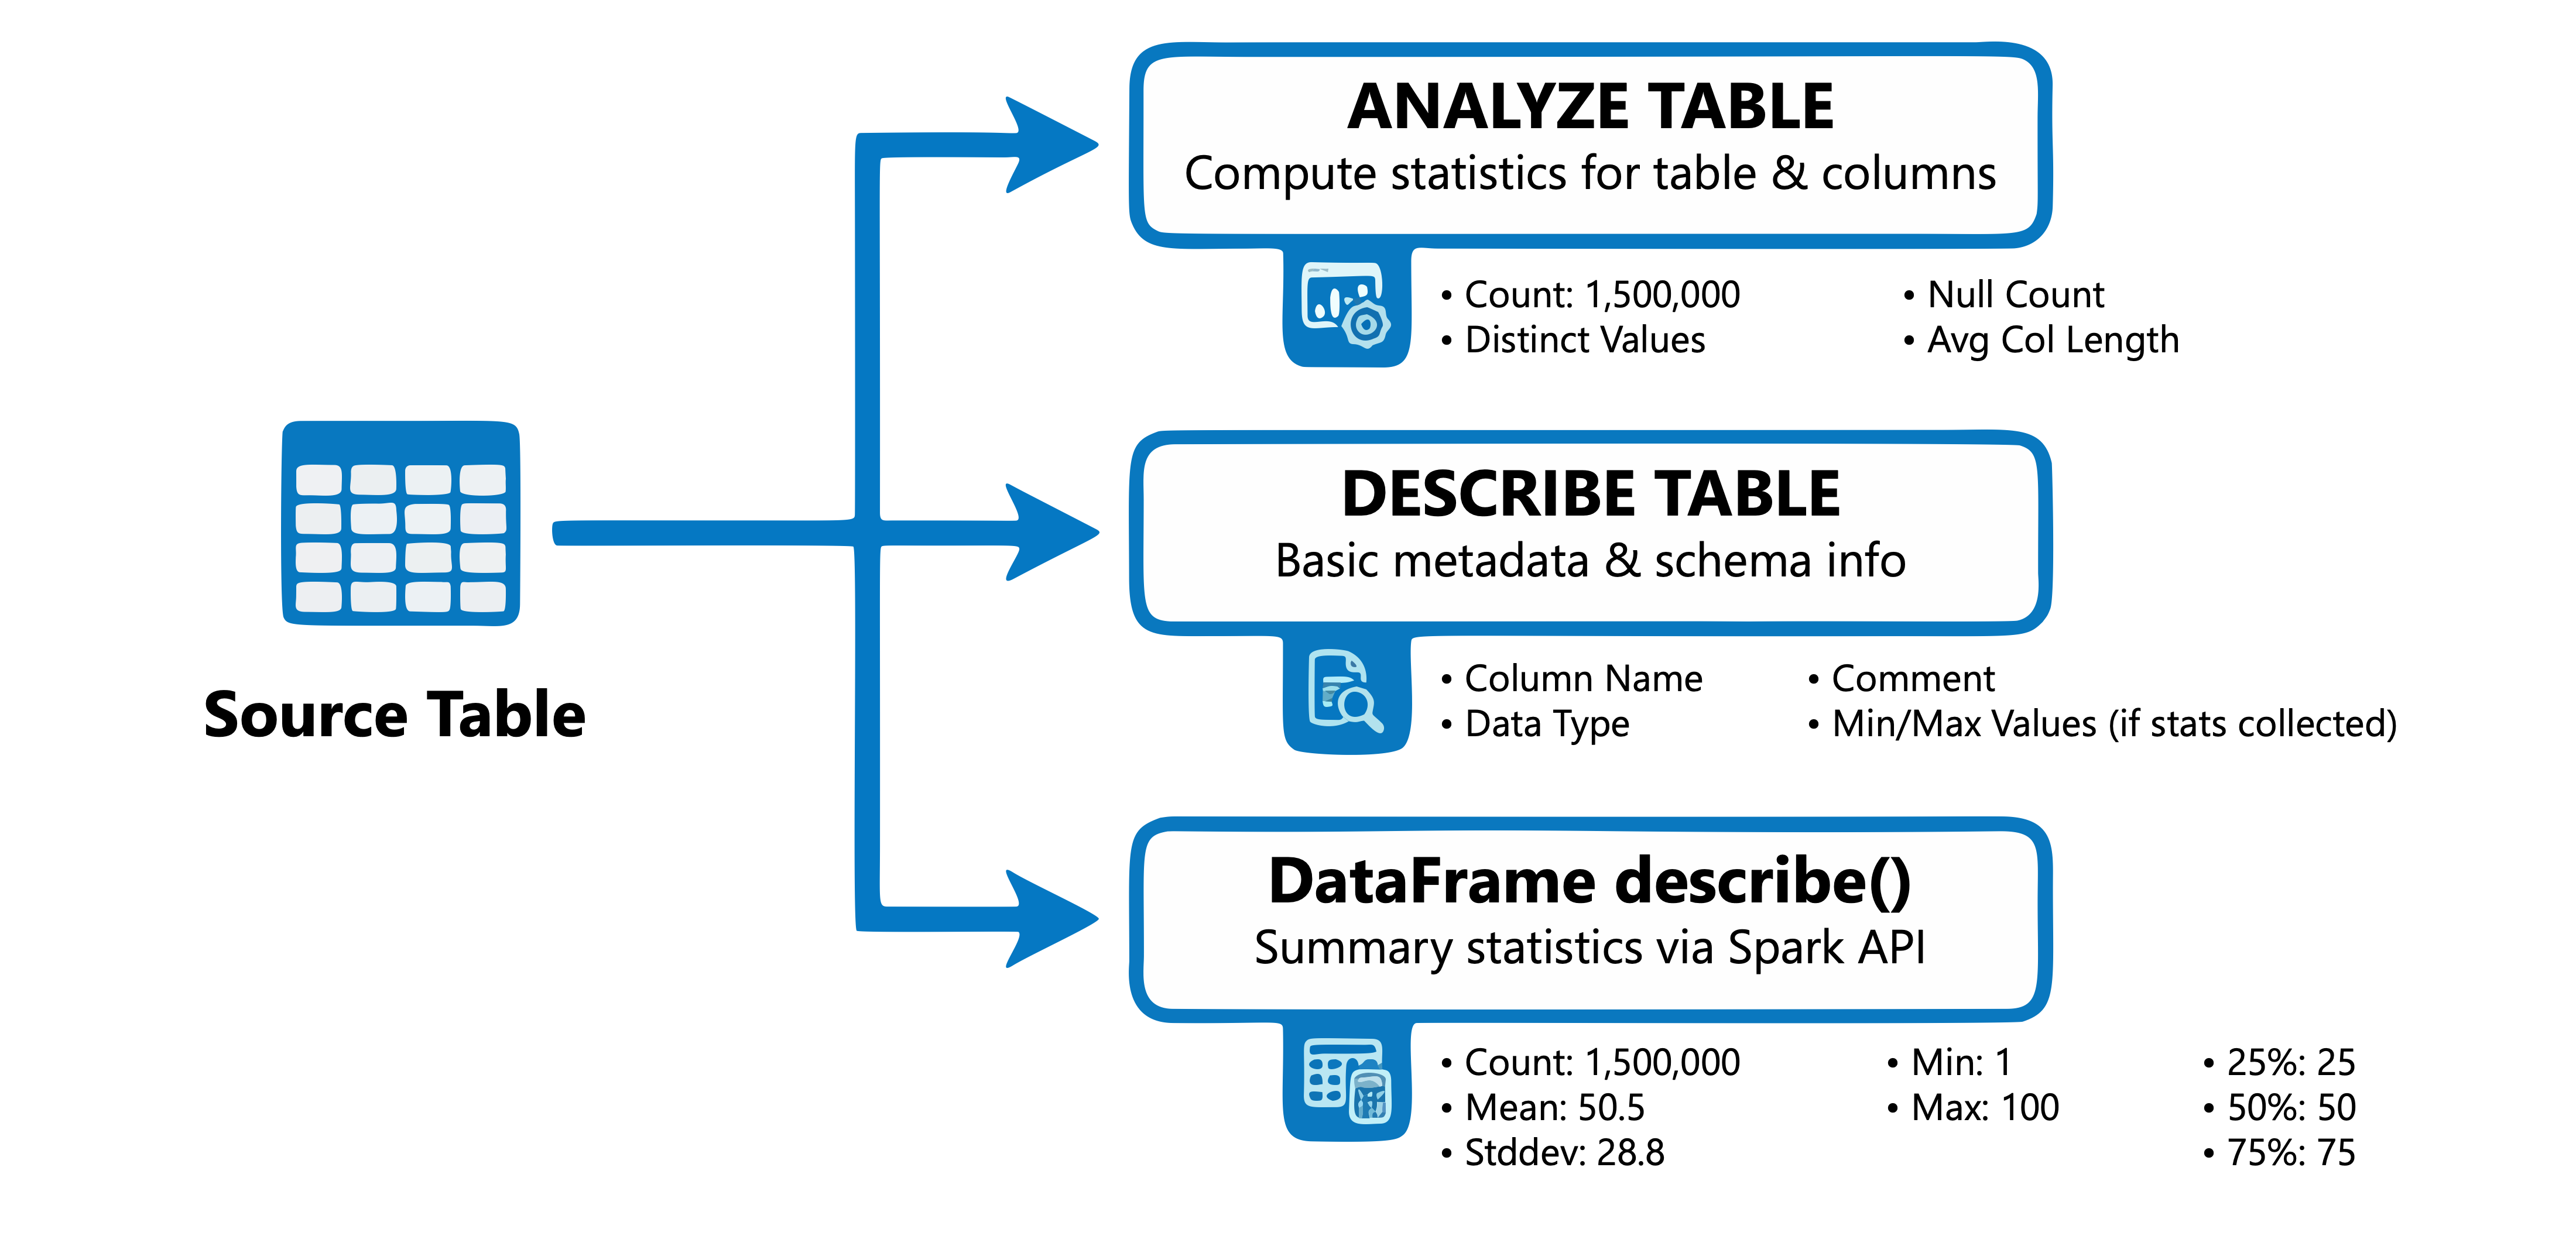
Zbieranie statystyk za pomocą funkcji ANALYZE TABLE
Polecenie ANALYZE TABLE oblicza statystyki dla tabeli lub określonych kolumn. Te same statystyki obejmują liczby wierszy, metryki na poziomie kolumny, takie jak minimalne i maksymalne wartości, liczby wartości null i liczby unikalnych wartości.
-- Collect basic table statistics (row count and size)
ANALYZE TABLE sales.transactions COMPUTE STATISTICS;

-- Collect statistics for specific columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR COLUMNS
    transaction_id, amount, customer_id;

-- Collect statistics for all columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR ALL COLUMNS;
Podczas analizowania określonej kolumny uzyskujesz szczegółowe metryki:
-- View column-level statistics
DESC EXTENDED sales.transactions amount;
Zwraca to metryki, w tym minimalną wartość, maksymalną wartość, liczbę wartości null, unikatową liczbę, średnią długość kolumny i maksymalną długość kolumny.
Wyświetlanie statystyk za pomocą funkcji DESCRIBE TABLE
Polecenie DESCRIBE TABLE EXTENDED wyświetla zebrane statystyki wraz z metadanymi tabeli:
DESCRIBE TABLE EXTENDED sales.transactions;
Możesz również użyć narzędzia PySpark, aby pobrać metadane tabeli i wygenerować statystyki podsumowania:
# Generate summary statistics for numeric columns using the DataFrame API
df = spark.table("sales.transactions")
df.describe().show()
Metoda describe() zwraca liczbę, średnią, odchylenie standardowe, minimum i maksimum dla kolumn liczbowych i tekstowych.
Dane wyjściowe DESCRIBE TABLE EXTENDED zawierają wiersz Statistics, który pokazuje rozmiar tabeli w bajtach oraz, po uruchomieniu ANALYZE TABLE ... COMPUTE STATISTICS, liczbę wierszy. W przypadku tabel zarządzanych przez Unity Catalog optymalizacja predykcyjna jest automatycznie uruchamiana ANALYZE w celu aktualizowania statystyk.
Wskazówka
Uruchom polecenie ANALYZE TABLE po załadowaniu zbiorczych danych lub znaczących zmianach, aby upewnić się, że optymalizator zapytań ma dokładne statystyki dotyczące planowania wydajnych zapytań.
Używanie profilowania danych w katalogu Unity Catalog
Poza poleceniami SQL, usługa Azure Databricks zapewnia monitorowanie jakości danych w Unity Catalog — narzędzie obejmujące dwie odrębne funkcje.
- Wykrywanie anomalii (publiczna wersja zapoznawcza) automatycznie monitoruje wszystkie tabele w schemacie. Analizuje wzorce historyczne, aby oceniać świeżość każdej tabeli (kiedy ostatnio została zaktualizowana) i kompletność (czy osiągnięto oczekiwaną liczbę wierszy). Można ją włączyć raz na poziomie schematu w Eksploratorze wykazu i Azure Databricks określa, jak często skanować każdą tabelę. Użyj wykrywania anomalii, aby uzyskać szerokie, zautomatyzowane pokrycie we wszystkich tabelach bez konieczności konfigurowania poszczególnych tabel.
- Profilowanie danych zapewnia głęboką analizę statystyczną dla każdej tabeli — śledzenie rozkładów, procentowych udziałów wartości null, metryk zmienności oraz wydajności modelu w miarę upływu czasu. Należy skonfigurować ją indywidualnie dla każdej tabeli. Użyj profilowania danych dla najbardziej krytycznych tabel, w których potrzebne są szczegółowe trendy historyczne.
W przypadku prac inżynierii danych koncentrujących się na czyszczeniu i jakości użyj obu metod: wykrywania anomalii jako systemu wczesnego ostrzegania we wszystkich tabelach oraz profilowania danych w celu szczegółowego monitorowania kluczowych tabel.
Diagram wyjaśnia, jak używać profilowania danych w Unity Catalog.
Informacje o typach profilów
Profilowanie danych obsługuje trzy typy analiz, z których każdy jest odpowiedni dla różnych scenariuszy:
| Typ profilu | Przypadek użycia | Kluczowe cechy |
|---|---|---|
| Snapshot | Tabele ogólnego przeznaczenia | Oblicza metryki w całej tabeli przy każdym odświeżeniu |
| Szeregi czasowe | Tabele z kolumnami znacznika czasu | Śledzi metryki w oknach czasowych w celu wykrywania trendów |
| Wnioskowanie | Tabele wnioskowania modelu uczenia maszynowego | Monitoruje dane wejściowe, przewidywania i dokładność modelu w czasie |
W przypadku zadań inżynierii danych ukierunkowanych na jakość danych najbardziej istotne są profile migawek i szeregów czasowych.
Tworzenie profilu przy użyciu interfejsu użytkownika
Aby utworzyć profil w Eksploratorze wykazu:
- Przejdź do swojej tabeli w Eksploratorze katalogu.
- Wybierz kartę Jakość .
- Jeśli wykrywanie anomalii nie jest włączone dla schematu, wybierz pozycję Włącz. Jeśli wykrywanie anomalii jest już włączone, wybierz pozycję Konfiguruj.
- W oknie dialogowym Monitorowanie jakości danych w polu Profilowanie danych wybierz pozycję Konfiguruj.
- Wybierz typ profilu i skonfiguruj opcje, takie jak stopień szczegółowości i planowanie.
Profil generuje tabelę metryk profilu ze statystykami podsumowania i tabelą metryk dryfu, która śledzi zmiany rozkładu w czasie. Azure Databricks wypełnia tabelę metryk dryfu, gdy jest dostępna tabela odniesienia lub kolejne okno czasowe.
Tworzenie profilu przy użyciu interfejsu API
Aby uzyskać dostęp programowy, użyj zestawu SDK usługi Databricks. Zainstaluj lub uaktualnij zestaw SDK, aby uzyskać bieżący interfejs API:
%pip install "databricks-sdk>=0.68.0"
Następnie utwórz profil migawki dla tabeli:
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.dataquality import Monitor, DataProfilingConfig, SnapshotConfig

w = WorkspaceClient()

# Retrieve the table ID and schema ID required by the API
table = w.tables.get(full_name="main.sales.transactions")
schema = w.schemas.get(full_name="main.sales")

w.data_quality.create_monitor(
    monitor=Monitor(
        object_type="table",
        object_id=table.table_id,
        data_profiling_config=DataProfilingConfig(
            output_schema_id=schema.schema_id,
            assets_dir="/Workspace/Users/user@example.com/monitoring",
            snapshot=SnapshotConfig()
        )
    )
)
Aby odświeżyć profil i zaktualizować metryki:
from databricks.sdk.service.dataquality import Refresh

w.data_quality.create_refresh(
    object_type="table",
    object_id=table.table_id,
    refresh=Refresh(object_type="table", object_id=table.table_id)
)
Interpretowanie wyników profilowania
Profilowanie generuje metryki, które ułatwiają ocenę jakości danych i identyfikowanie problemów wymagających uwagi.
Kluczowe metryki do zbadania
Tabela metryk profilu zawiera statystyki dla każdej kolumny:
| Wskaźnik | Co ujawnia |
|---|---|
count i num_nulls |
Kompletność danych — wysokie procenty wartości null mogą wskazywać na problemy z przetwarzaniem danych. |
distinct_count |
Kardynalność — nieoczekiwane wartości mogą sugerować problemy z jakością danych |
min, , max, , avgstddev |
Charakterystyka rozkładu — odstające lub niesymetryczne rozkłady |
frequent_items |
Najbardziej typowe wartości — ułatwia identyfikowanie dominujących kategorii lub duplikatów |
quantiles |
Rozkład wartości — przydatny do wykrywania niesymetryczności |
Wykrywanie problemów z jakością danych
Podczas badania wyników profilowania poszukaj następujących typowych wskaźników:
- Wysoki procent wartości null w kolumnach, które powinny zawierać dane
- Nieoczekiwane unikatowe liczby, takie jak unikatowe identyfikatory, które nie są unikatowe
- Zakresy wartości poza oczekiwanymi granicami, takie jak kwoty ujemne, w których prawidłowe są tylko wartości dodatnie
- Zmiany rozkładu w czasie, które mogą wskazywać na dryf danych
Tabela metryk dryfu oblicza testy statystyczne, takie jak test Kolmogorova-Smirnova (KS) dla kolumn liczbowych i test chi-kwadrat dla kolumn kategorycznych. Te testy kwantyfikują, ile rozkładów uległo zmianie.
Zrozumienie tych wzorców pomaga zaprojektować odpowiednie reguły czyszczenia i walidacji dla potoków danych.