Projektowanie logiki pozyskiwania i konfiguracji źródła danych
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Projektowanie logiki pozyskiwania wymaga podjęcia krytycznych decyzji dotyczących sposobu przechodzenia danych z systemów źródłowych do usługi Azure Databricks. Te decyzje wpływają na świeżość danych, wydajność przetwarzania i niezawodność systemu. Przed wybraniem narzędzi lub napisaniem kodu należy zrozumieć cechy źródeł danych i zdefiniować strategie wyodrębniania zgodne z wymaganiami biznesowymi.
W tej lekcji zapoznasz się z kluczowymi zagadnieniami dotyczącymi projektowania logiki pozyskiwania danych i konfiguracji źródła danych w usłudze Azure Databricks. W tym miejscu skupimy się na koncepcyjnej logice i wzorcach projektowych — szczegółowe informacje dotyczące wyboru i implementacji narzędzi zostały omówione w kolejnych lekcjach.
Poznaj typy wyodrębniania
Typ wyodrębniania określa sposób przechwytywania danych z systemów źródłowych i wpływa zarówno na terminowość, jak i wydajność potoku danych. Usługa Azure Databricks obsługuje trzy podstawowe wzorce wyodrębniania, z których każdy jest odpowiedni dla różnych scenariuszy.
Pełne wyodrębnianie
Pełne wyodrębnianie odczytuje cały zestaw danych z systemu źródłowego podczas każdego procesu ładowania.

Takie podejście działa dobrze, gdy:
- Systemy źródłowe nie obsługują śledzenia zmian
- Woluminy danych są wystarczająco małe, aby wydajnie przetwarzać
- Należy okresowo kompilować tabele docelowe od podstaw
- Relacje danych są złożone, a logika przyrostowa byłaby podatna na błędy
Pełne wyodrębnianie staje się niepraktyczne w miarę wzrostu ilości danych. Ponowne przetwarzanie milionów rekordów, gdy tylko kilka tysięcy zmieniło zasoby obliczeniowe i opóźnia odbiorców podrzędnych.
Wyodrębnianie przyrostowe
Wyodrębnianie przyrostowe przetwarza tylko nowe lub zmienione rekordy od ostatniego uruchomienia pozyskiwania. Aparat śledzi, jakie dane zostały przetworzone, i wysyła zapytania tylko do aktualizacji.

Ten wzorzec wymaga:
- Niezawodny wskaźnik zmiany w danych źródłowych (sygnatura czasowa, numer sekwencji lub kolumna wersji)
- Zarządzanie stanem w celu śledzenia ostatniej przetworzonej pozycji
- Logika do obsługi rekordów opóźnionych lub przybywających w niewłaściwej kolejności
Wyodrębnianie przyrostowe znacznie poprawia wydajność dużych zestawów danych. Zamiast odczytywać miliony wierszy, możesz przetwarzać tylko tysiące zmian na jeden przebieg.
Wyodrębnianie danych ze strumienia
Ekstrakcja strumieniowa umożliwia przechwytywanie danych niemal w czasie rzeczywistym za pośrednictwem ciągłego przetwarzania. Zamiast działać zgodnie z harmonogramem, zadania przesyłania strumieniowego pozostają aktywne i przetwarzają rekordy w momencie ich nadejścia.

Rozważ przesyłanie strumieniowe, gdy:
- Procesy biznesowe wymagają świeżości danych mierzonych w sekundach lub minutach
- Systemy źródłowe publikują zdarzenia w magistralach komunikatów lub zestawieniach zmian
- Musisz reagować na zdarzenia w miarę ich występowania
Ekstrakcja strumieniowa wymaga zawsze aktywnej infrastruktury, ale zapewnia najniższe opóźnienie dostępności danych.
Projektowanie pod kątem przechwytywania danych zmian
Przechwytywanie zmian danych (CDC) to wyspecjalizowany wzorzec wyodrębniania, który przechwytuje poszczególne zmiany na poziomie wiersza, w tym wstawiania, aktualizacji i usuwania. Usługa CDC różni się od prostego wyodrębniania przyrostowego, ponieważ zachowuje typ operacji dla każdej zmiany.

Podczas projektowania usługi CDC należy wziąć pod uwagę sposób tworzenia rekordów zmian w systemie źródłowym:
- Dzienniki transakcji bazy danych: bazy danych, takie jak PROGRAM SQL Server, mogą uwidaczniać zmiany na poziomie wiersza przy użyciu funkcji CDC opartej na dzienniku transakcji. Systemy podrzędne, takie jak usługa Azure Databricks, mogą następnie odczytywać te zmiany i przetwarzać je w ramach pipeline przetwarzania danych.
- Zmiany w źródłach danych: Tabele Delta i niektóre bazy danych, takie jak Azure Cosmos DB, zapewniają wbudowane śledzenie zmian, które wyświetla zmiany wierszy za pomocą metadanych.
- Migawki okresowe: niektóre systemy nie obsługują ciągłego CDC, co wymaga porównania migawek w celu określenia zmian.
Usługa CDC umożliwia obsługę przypadków użycia, których nie można obsłużyć przy użyciu prostego wyodrębniania przyrostowego. Można precyzyjnie replikować usunięcia, utrzymywać ścieżki audytu i przetwarzać aktualizacje modyfikujące kluczowe kolumny.
Uwaga / Notatka
Usługa CDC wymaga informacji sekwencjonowania w celu poprawnego obsługi zdarzeń poza kolejnością. Dane źródłowe wymagają kolumny (takiej jak sygnatura czasowa lub numer sekwencji), która określa poprawną kolejność zmian.
Identyfikowanie właściwości typu pliku źródłowego
Gdy dane docierają jako pliki, a nie z systemów transakcyjnych, format pliku ma wpływ na projekt pozyskiwania. Każdy format ma odrębne cechy wpływające na przetwarzanie.

Formaty oparte na tekście
Pliki CSV i JSON są typowymi formatami źródłowymi, ponieważ są czytelne dla człowieka i powszechnie obsługiwane. Jednak stanowią one wyzwania związane z wydajnym przetwarzaniem:
- Zmienność schematu: Pliki mogą mieć niespójne kolejności kolumn, brakujące pola lub odmiany typu danych
- Brak wydajności kompresji: formaty tekstowe zwykle zużywają więcej miejsca niż alternatywy binarne
- Analizowanie obciążenia: każda wartość wymaga konwersji tekstu na typ podczas odczytu
Używaj formatów opartych na tekście, gdy systemy źródłowe mogą tworzyć te formaty tylko wtedy, gdy woluminy danych są wystarczająco małe, aby problemy z wydajnością nie miały zastosowania.
Formaty kolumnowe
Pliki Parquet i ORC przechowują dane w formacie kolumnowym, umożliwiając wydajne zapytania analityczne. Te formaty oferują:
- Kompresja: Magazyn kolumnowy osiąga lepsze współczynniki kompresji, grupując podobne wartości
- Oczyszczanie kolumn: zapytania odczytują tylko potrzebne kolumny, zmniejszając liczbę operacji we/wy
- Schemat osadzony: plik zawiera metadane opisujące nazwy i typy kolumn
Zaprojektuj proces pozyskiwania danych tak, aby korzystać z formatów źródłowych kolumnowych, gdy masz kontrolę nad sposobem eksportowania danych przez systemy źródłowe.
Formaty częściowo ustrukturyzowane
Pliki XML i zagnieżdżone pliki JSON reprezentują dane hierarchiczne, które nie pasują do płaskiej struktury tabelarycznej. Podczas pozyskiwania częściowo ustrukturyzowanych danych:
- Planowanie wyodrębniania lub definicji schematu.
- Określ, czy spłaszczyć strukturę, czy zachować zagnieżdżanie.
- Uwzględnij różne struktury dokumentów w tym samym źródle.
Zagadnienia dotyczące połączenia ze źródłem danych
Konfiguracja źródła danych definiuje sposób, w jaki usługa Azure Databricks łączy się z systemami źródłowymi i uwierzytelnia się z nimi. Projekt musi dotyczyć zabezpieczeń połączeń, zarządzania poświadczeniami i wzorców dostępu.
Źródła magazynu obiektów w chmurze
Magazyn w chmurze (Azure Data Lake Storage, Amazon S3 lub Google Cloud Storage) służy jako najbardziej typowa strefa przyjęcia danych. Podczas konfigurowania połączeń przechowywania:
- Użyj lokalizacji zewnętrznych Unity Catalog, aby zarządzać dostępem do ścieżek magazynowania.
- Skonfiguruj odpowiednie metody uwierzytelniania (tożsamość zarządzana, jednostki usługi lub poświadczenia magazynu).
- Projektowanie struktur folderów, które obsługują wydajne przetwarzanie przyrostowe.
Struktura folderów znacząco wpływa na wydajność identyfikowania i przetwarzania nowych plików w usłudze Azure Databricks. Rozważ następujące wzorce:
Partycjonowanie oparte na datach: Organizowanie plików według hierarchii dat w celu włączenia oczyszczania partycji podczas operacji odczytu przyrostowego:
/data/sales/year=2025/month=11/day=28/
/data/sales/year=2025/month=11/day=29/
Ta struktura umożliwia kwerendom skanowanie tylko odpowiednich partycji dat, a nie wyświetlanie listy wszystkich plików.
Organizacja oparta na źródle: w przypadku pozyskiwania z wielu źródeł oddziel dane według systemu źródłowego, aby uprościć logikę przetwarzania:
/landing/erp/orders/
/landing/crm/customers/
/landing/web/clickstream/
Przetwarzanie folderów wg stanu: Użyj oddzielnych folderów do śledzenia statusu przetwarzania plików:
/incoming/     # New files arrive here
/processing/   # Files currently being processed
/archive/      # Successfully processed files
/failed/       # Files that failed processing
Podczas projektowania struktur folderów należy wziąć pod uwagę następujące kwestie:
- Obciążenie związane z odnajdywaniem plików: płaskie struktury z tysiącami plików spowalniają operacje wyświetlania plików. Partycjonowane struktury zmniejszają liczbę plików, które należy wyliczyć w usłudze Azure Databricks.
- Zgodność z funkcją Auto Loader: Funkcja Auto Loader usługi Azure Databricks wydajnie śledzi nowe pliki w przechowywaniu w chmurze. Struktury folderów dopasowane do tego, jak Auto Loader odnajduje pliki i zapisuje punkty kontrolne.
-
Wyodrębnianie kolumn partycji: użyj partycjonowania w stylu hive (
key=value), aby usługa Azure Databricks mogła automatycznie wyodrębniać wartości partycji jako kolumny bez analizowania zawartości pliku.
Źródła baz danych
Nawiązywanie połączenia z transakcyjnymi bazami danych wymaga uwzględnienia innych aspektów niż magazyn w chmurze.
- Łączność sieciowa między usługą Azure Databricks i serwerem bazy danych.
- Poświadczenia uwierzytelniania są przechowywane bezpiecznie (przy użyciu wpisów tajnych , a nie zakodowanych na stałe wartości).
- Możliwości buforowania połączeń i wypychania zapytań.
- Wpływ na wydajność systemu źródłowego podczas wyodrębniania.
Źródła przesyłania strumieniowego
Magistrale komunikatów i strumienie zdarzeń (takie jak usługa Azure Event Hubs lub inne typowe platformy obsługi komunikatów) wymagają:
- Szczegóły połączenia brokera i uwierzytelnianie.
- Konfiguracja grupy odbiorców na potrzeby przetwarzania równoległego.
- Zarządzanie przesunięciem w związku ze śledzeniem pozycji zużycia.
- Integracja rejestru schematów na potrzeby walidacji formatu komunikatów.
Źródła aplikacji SaaS
Aplikacje dla przedsiębiorstw, takie jak Salesforce, ServiceNow lub SAP, uwidaczniają dane za pośrednictwem interfejsów API o unikatowych cechach:
- Limity szybkości interfejsu API ograniczające przepływność wyodrębniania.
- Strategie stronicowania dla dużych zestawów wyników.
- Przepływy uwierzytelniania (OAuth, klucze interfejsu API lub oparte na certyfikatach).
- Dostępne funkcje śledzenia zmian lub webhooki.
Stosowanie platformy projektowania opartej na wymaganiach
Skuteczne projektowanie wprowadzania danych rozpoczyna się od analizy wymagań, zanim wybierze się typy ekstrakcji lub formaty plików. Użyj następującej powtarzalnej struktury, aby kierować decyzjami projektowymi.
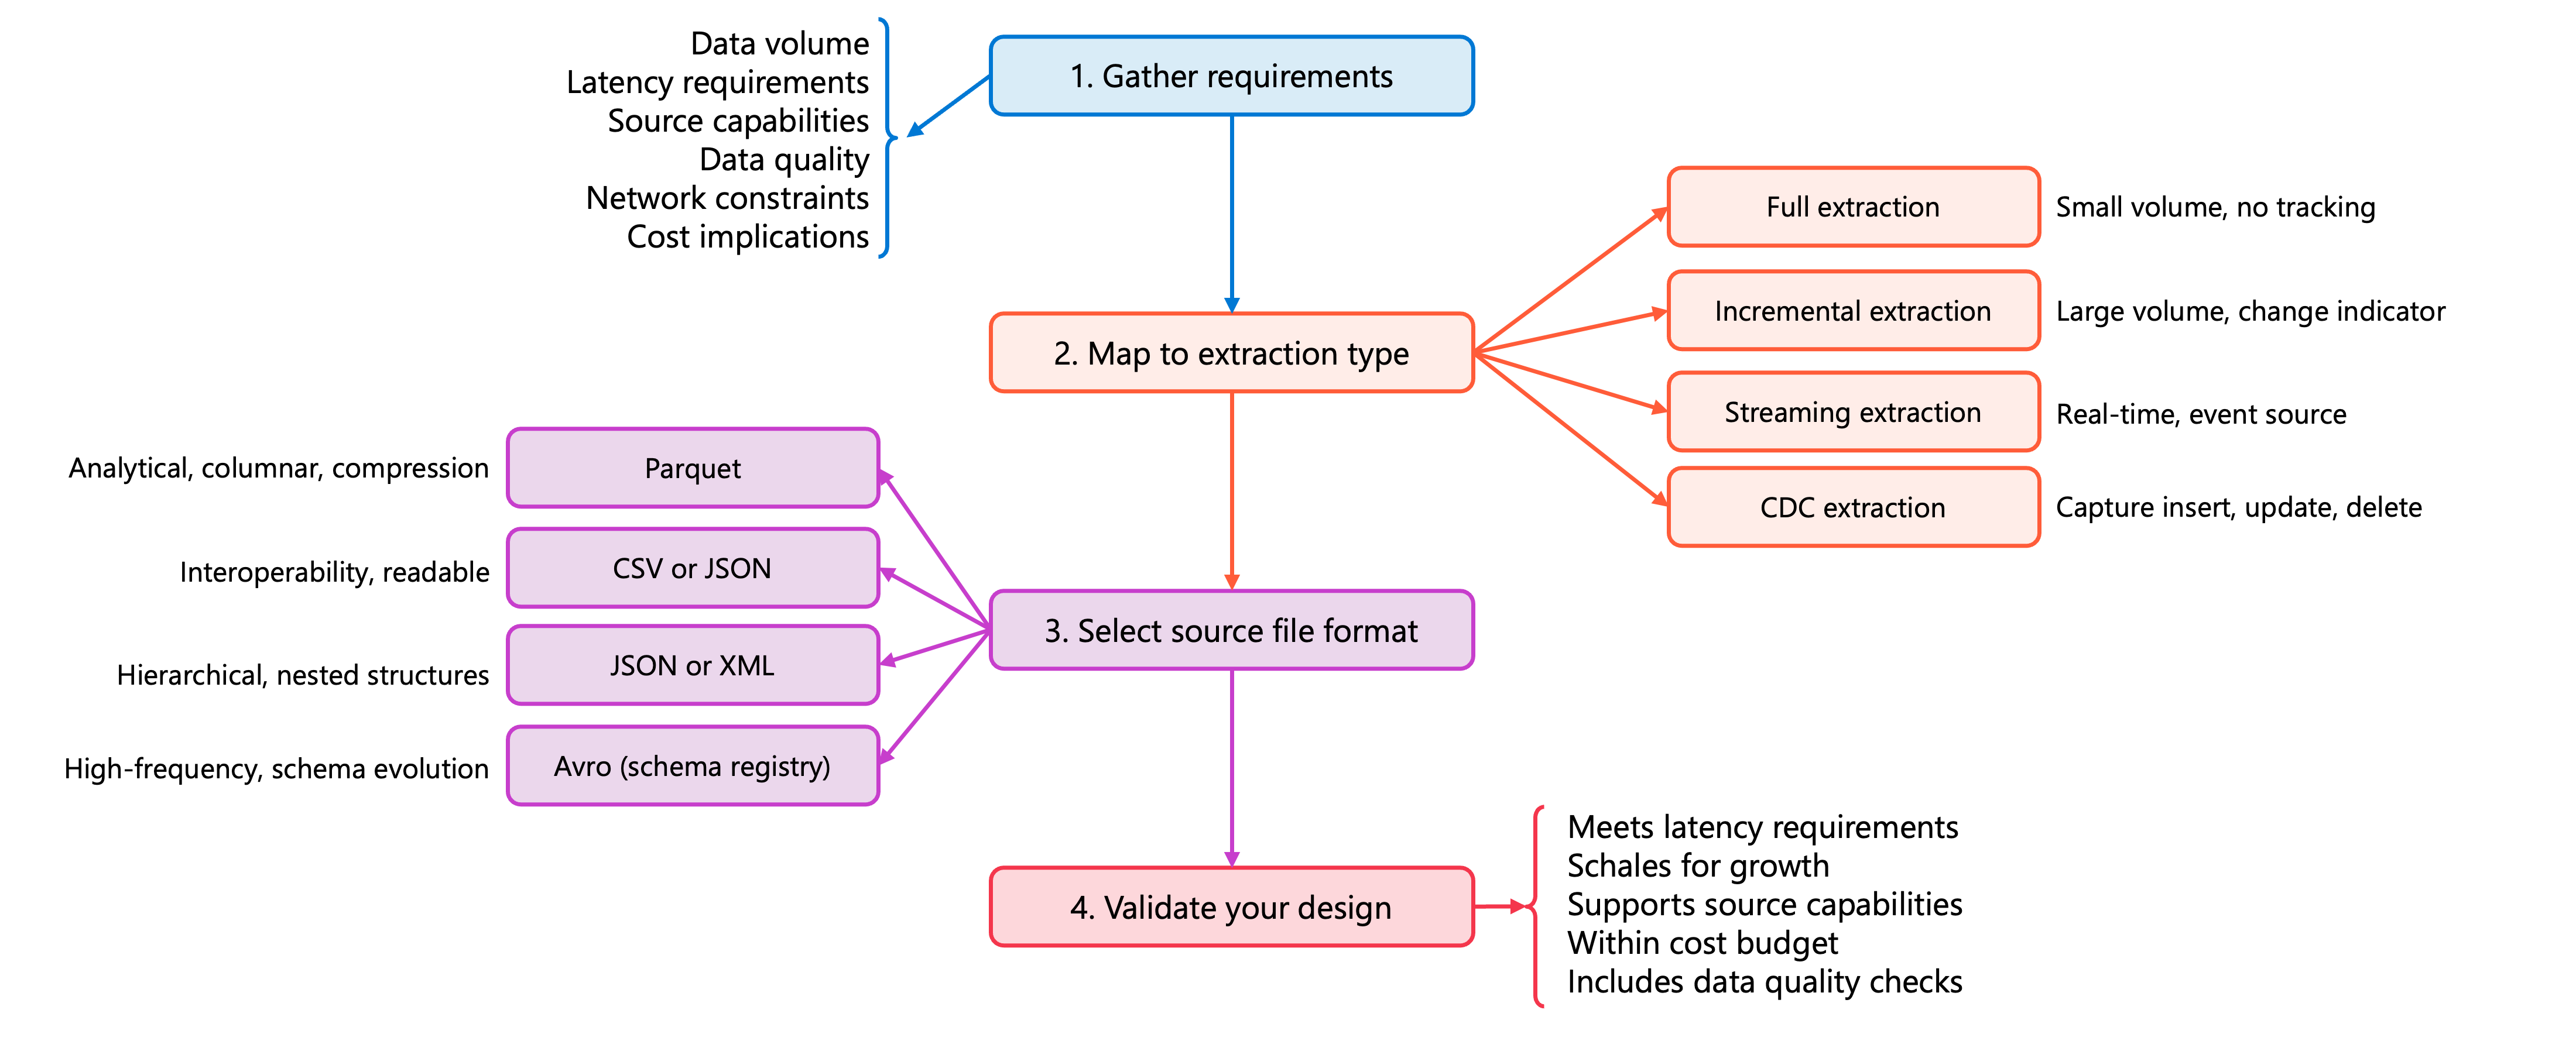
Krok 1: Zbierz wymagania
Przed podjęciem jakichkolwiek decyzji technicznych odpowiedz na następujące kluczowe pytania:
| Kategoria wymagań | Pytania, na które należy odpowiedzieć |
|---|---|
| objętość danych | Ile danych istnieje w źródle? Ile zmian między przebiegami? Jaki jest wskaźnik wzrostu? |
| Wymagania dotyczące opóźnienia | Jak świeże muszą być dane dla odbiorców podrzędnych? Czy istnieją umowy SLA, które należy spełnić? |
| Możliwości źródła | Czy źródło obsługuje śledzenie zmian, CDC, czy tylko pełne wyodrębnianie? Jakie formaty plików mogą tworzyć? |
| Jakość danych | Jak niezawodne są dane źródłowe? Jakiej walidacji lub jakiego czyszczenia potrzeba? |
| Ograniczenia sieci | Jaka przepustowość istnieje między źródłem a usługą Azure Databricks? Czy istnieją wymagania dotyczące zapory lub sieci VPN? |
| Wpływ na koszty | Jakie są koszty obliczeń, magazynu i transferu danych w różnych podejściach? |
Krok 2. Mapuj wymagania dotyczące typu wyodrębniania
Użyj analizy wymagań, aby wybrać odpowiedni wzorzec wyodrębniania:
| Jeśli wymagania wskazują... | Następnie wybierz... |
|---|---|
| Mały wolumin danych (< 100 000 wierszy), brak dostępnego śledzenia zmian, akceptowalna jest prosta ponowna kompilacja | Pełne wyodrębnianie |
| Duża ilość danych, dostępny niezawodny wskaźnik zmiany (sygnatura czasowa/sekwencja), wystarczająca aktualizacja co godzinę lub codziennie. | Wyodrębnianie przyrostowe |
| Wymagana świeżość w czasie rzeczywistym lub niemal w czasie rzeczywistym, źródło publikuje zdarzenia, dostępna infrastruktura przesyłania strumieniowego | Ekstrakcja strumieniowa |
| Należy przechwycić usunięcia i typy operacji, wymagany dziennik inspekcji, źródło obsługuje przechwytywanie dziennika transakcji | Wyodrębnianie cdC |
Krok 3. Wybieranie formatu pliku źródłowego
Jeśli kontrolujesz format źródłowy lub musisz wybrać format strefy docelowej, dopasuj format do Twoich potrzeb:
| Jeśli twój scenariusz obejmuje... | Następnie wybierz... |
|---|---|
| Duże zestawy danych analitycznych, zapytania kolumnowe, wymagają kompresji | Parquet |
| Współdziałanie z wieloma systemami, wymagana jest czytelność człowieka | CSV lub JSON |
| Hierarchiczne lub zagnieżdżone struktury danych | JSON lub XML |
| Przesyłanie strumieniowe o wysokiej częstotliwości z ewolucją schematu | Avro z rejestrem schematów |
Krok 4. Weryfikowanie projektu
Przed wdrożeniem sprawdź, czy projekt rozwiązuje następujące problemy:
Typ wyodrębniania spełnia wymagania dotyczące opóźnień. W przeciwnym razie odbiorcy podrzędni otrzymują nieaktualne dane, co potencjalnie powoduje nieprawidłowe decyzje biznesowe lub naruszenia umowy SLA.
Podejście pozwala na skalowanie w celu obsługi przewidywanego wzrostu danych. Jeśli tak nie jest, potoki, które działają dzisiaj, mogą ulec awarii lub stać się zbyt wolne wraz ze wzrostem ilości danych.
Funkcje systemu źródłowego obsługują wybrany wzorzec. Jeśli nie, przepływ danych ulegnie awarii w czasie wykonywania lub wymaga kosztownych obejść, które dodają do złożoności.
Szacowanie kosztów mieści się w ramach ograniczeń budżetowych. Jeśli nie, rozwiązanie może być wprawdzie technicznie solidne, ale finansowo niezrównoważone do użytku produkcyjnego.
Testy jakości danych są planowane dla potoku. Jeśli nie, nieprawidłowe lub uszkodzone dane są propagowane do systemów podrzędnych, powodując błędy lub niepoprawną analizę.
Stosowanie struktury: praktyczny przykład
Platforma handlu elektronicznego musi pozyskiwać dane zamówień. Zamówienia są przechowywane w bazie danych PostgreSQL, a firma wymaga raportowania godzinowego.
Krok 1. Zbieranie wymagań:
- Wielkość: 50 000 nowych zamówień dziennie, 2 miliony wierszy łącznie, 15% roczny wzrost.
- Opóźnienie: jednogodzinna świeżość jest akceptowalna dla celów raportowania.
- Źródło: Baza danych PostgreSQL obsługuje zapytania oparte na sygnaturze czasowej, ale nie ma natywnej usługi CDC.
- Jakość: dane źródłowe są weryfikowane podczas wprowadzania; wymagane minimalne czyszczenie.
- Sieć: bezpośrednia łączność za pośrednictwem usługi Azure Private Link.
- Koszt: minimalizuj użycie zasobów obliczeniowych; koszty magazynowania są pomocnicze.
Krok 2. Mapuj na typ wyodrębniania:
Duża ilość z niezawodną kolumną sygnatury czasowej i wymaganiami o opóźnieniu godzinowym → wyodrębniania przyrostowego.
Dlaczego nie inni?
- Pełne wyodrębnianie: Ponowne przetwarzanie 2 milionów wierszy na godzinę marnuje zasoby obliczeniowe, gdy tylko około 2000 zamówień zmienia się w ciągu godziny.
- Przesyłanie strumieniowe: jednogodzinne opóźnienie nie uzasadnia kosztu infrastruktury przesyłania strumieniowego zawsze włączonej.
- CDC: PostgreSQL nie oferuje natywnego dziennika transakcji w stylu CDC, a przypadek użycia nie wymaga śledzenia operacji usuwania ani innych typów operacji.
Krok 3. Wybieranie formatu pliku:
Dane trafiają do usługi Azure Data Lake Storage w celu przetwarzania → Parquet dla wydajnego przechowywania w formacie kolumnowym. Układ partycjonowany według daty do wykrywania przyrostowego → /landing/orders/year=2025/month=11/day=28/.
Dlaczego nie inni?
- CSV/JSON: większe rozmiary plików, brak korzyści kompresji i niższa wydajność zapytań dla obciążeń analitycznych.
- Avro: Lepiej nadaje się do przesyłania strumieniowego z ewolucją schematu; pozyskiwanie wsadowe nie wymaga funkcji zorientowanych na przesyłanie strumieniowe.
- XML: zwiększa złożoność przetwarzania bez korzyści dla ustrukturyzowanych danych w kolejności tabelarycznej.
Krok 4. Weryfikowanie projektu:
- Przyrosty godzinowe spełniają godzinne wymagania dotyczące opóźnienia.
- √ Przetwarzanie zmienia się tylko wydajnie wraz ze wzrostem.
- √ Kolumna PostgreSQL
order_updated_atumożliwia wykonywanie zapytań przyrostowych. - Przetwarzanie tysięcy wierszy w porównaniu do milionów zmniejsza koszty obliczeń.
Ostateczna decyzja: Przyrostowe wyodrębnianie z użyciem kolumny znacznika czasu, zaplanowane co godzinę, dane będą docelowo umieszczane jako pliki Parquet w usłudze Azure Data Lake Storage.
Wskazówka
Udokumentowanie decyzji projektowych i uzasadnienie ich podejmowania. W przypadku zmiany wymagań lub problemów ta dokumentacja pomaga zrozumieć, dlaczego wybrano bieżące podejście i jakie kompromisy zostały dokonane. Rozważ utworzenie rekordu decyzji projektowej dla każdego głównego potoku.
Opierając się na podstawach wynikających z wymagań, możesz ocenić konkretne narzędzia i metody przetwarzania, które implementują projekt integracji danych.