Wybieranie narzędzia do pozyskiwania danych
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Podczas projektowania potoków danych w usłudze Azure Databricks wybranie odpowiedniego narzędzia pozyskiwania bezpośrednio wiąże się z niezawodnością potoku, nakładem pracy związanym z jego konserwacją i kosztami długoterminowymi. Każde narzędzie odpowiada różnym scenariuszom, źródłom danych i wymaganiom operacyjnym. Zrozumienie tych różnic ułatwia podejmowanie świadomych decyzji, które są zgodne z potrzebami organizacji.
Zrozumienie krajobrazu narzędzi do wprowadzania danych
Usługa Azure Databricks udostępnia wiele opcji importu danych, które obejmują zakres od w pełni zarządzanych usług po wysoce konfigurowalne frameworki. Wybrane narzędzia zależą od czynników, takich jak typ źródła danych, wymagania dotyczące opóźnień i jaka kontrola jest potrzebna w procesie pozyskiwania.

Na najbardziej kompleksowym poziomie usługa Lakeflow Connect oferuje gotowe łączniki do aplikacji i baz danych przedsiębiorstw. Te łączniki automatycznie obsługują uwierzytelnianie, śledzenie zmian, odzyskiwanie błędów i ewolucję schematu. W zakresie dostosowywania, Spark Structured Streaming zapewnia pełną kontrolę nad przepływem danych przez potok, choć wymaga to większego nakładu pracy programistycznej i konserwacyjnej.
Między tymi skrajnościami można znaleźć narzędzia, takie jak automatyczne ładowanie plików magazynu w chmurze, COPY INTO na potrzeby ładowania wsadowego opartego na języku SQL i podejścia oparte na notesach przy użyciu połączeń JDBC/ODBC . Ponadto usługa Azure Data Factory służy jako warstwa orkiestracji, która może koordynować przenoszenie danych do usługi Azure Databricks z szerszego ekosystemu platformy Azure.
Lakeflow Connect
Usługa Lakeflow Connect reprezentuje nowoczesne podejście do pozyskiwania danych w usłudze Azure Databricks. Oferuje on zarówno w pełni zarządzane łączniki, jak i standardowe łączniki, które integrują się z potokami Lakeflow w celu zapewnienia usprawnionego środowiska.
Łączniki zarządzane są zorganizowane w trzy typy:
łączniki SaaS zapewniają wbudowaną integrację z aplikacjami dla przedsiębiorstw, takimi jak Salesforce, ServiceNow, SharePoint, HubSpot, Jira, Microsoft Dynamics 365, Workday, Zendesk i wiele innych. Te łączniki obsługują uwierzytelnianie specyficzne dla źródła, operacje odczytu przyrostowego, ograniczanie szybkości interfejsu API, ewolucję schematu i automatyczne ponawianie prób. Są one uruchamiane na bezserwerowych zasobach obliczeniowych i zapisują w tabelach przesyłania strumieniowego zarządzanych przez Unity Catalog.
Łączniki baz danych przetwarzają dane z relacyjnych baz, takich jak MySQL, PostgreSQL i SQL Server, z wykorzystaniem przechwytywania zmian danych (CDC). Ponieważ łączniki oparte na usłudze CDC odczytują dzienniki transakcji bazy danych zamiast wykonywać zapytania bezpośrednio w tabelach, wymagają wdrożenia bramy wejściowej w sieci oraz woluminu magazynowego do buforowania przechwyconych zmian.
Łączniki społeczności to łączniki typu open source tworzone i obsługiwane przez społeczność. Rozszerzają one usługę Lakeflow Connect na źródła, które nie mają jeszcze łącznika zarządzanego. Możesz użyć istniejącego łącznika społeczności lub współtworzyć własny.
Uwaga / Notatka
Ekosystem łączników szybko rośnie. Zapoznaj się z dokumentacją łączników zarządzanych , aby zapoznać się z bieżącą pełną listą obsługiwanych źródeł.
Łączniki standardowe rozszerzają usługę Lakeflow Connect z magazynem obiektów w chmurze i magistralami komunikatów. Dane można pozyskiwać z usług Amazon S3, Azure Data Lake Storage lub Google Cloud Storage przy użyciu modułu automatycznego ładowania. W przypadku danych w czasie rzeczywistym standardowe łączniki obsługują platformy Apache Kafka, Google Pub/Sub i Apache Pulsar.

Rozważ użycie Lakeflow Connect, gdy potrzebujesz niezawodnego i wymagającego niewielkiej konserwacji pozyskiwania danych z obsługiwanych źródeł. Łączniki zarządzane znacznie skracają czas programowania i trwającą konserwację w porównaniu z rozwiązaniami niestandardowymi. Jeśli jednak źródło danych nie jest obsługiwane lub potrzebujesz wysoce wyspecjalizowanej logiki pozyskiwania, może być konieczne zapoznanie się z innymi opcjami.
Program Lakeflow Connect obsługuje zarówno zaplanowane pozyskiwanie (co godzinę, codziennie, co tydzień) i wyzwalacze na żądanie , dzięki czemu są odpowiednie dla zwykłych cykli odświeżania danych i scenariuszy ładowania ad hoc.
Łączniki oparte na zapytaniach
Łączniki oparte na zapytaniach stanowią uproszczoną alternatywę dla łączników bazy danych CDC na potrzeby zaplanowanego pozyskiwania z relacyjnych baz danych. Zamiast odczytywać dzienniki transakcji, wysyłają zapytania do tabeli źródłowej bezpośrednio przy użyciu kolumny kursora — monotonicznie rosnącego znacznika czasu lub liczby całkowitej, która śledzi, które wiersze są nowe lub aktualizowane od ostatniego uruchomienia potoku.
Ponieważ wysyłają zapytania bezpośrednio do źródła, łączniki oparte na zapytaniach nie wymagają bramy pozyskiwania ani magazynu przejściowego. W każdym zaplanowanym przebiegu łącznik pobiera wszystkie wiersze, których wartość w kolumnie kursora jest większa niż znacznik maksymalnego poziomu z poprzedniego przebiegu, a następnie zapisuje wyniki do tabel strumieniowych w Unity Catalog.
Obsługiwane źródła to Oracle, Teradata, SQL Server, MySQL, MariaDB, PostgreSQL i wszystkie źródła danych federacyjnych usługi Lakehouse.
Łączniki oparte na zapytaniach obsługują trzy tryby śledzenia historii dla tabel docelowych:
- Typ scD 1: zastępuje istniejący wiersz najnowszym wierszem źródłowym. Żadna historia nie jest zachowywana.
- Typ scD 2: zachowuje pełną historię, dodając nowe wiersze z metadanymi wersji.
- Tylko dołączanie: dołącza każdy importowany wiersz bez scalania lub zastępowania.
Wybierz łączniki oparte na zapytaniach zamiast łączników baz danych CDC, gdy infrastruktura CDC lub binlog nie jest dostępna, ale w źródle istnieje niezawodna kolumna kursora. Wybierz łączniki CDC, gdy potrzebujesz każdego pośredniego stanu wiersza między przebiegami potoku lub gdy śledzenie usuwania nietrwałego ma krytyczne znaczenie. Kompromis polega na tym, że łączniki oparte na zapytaniach umieszczają większe obciążenie bezpośrednio na tabelach źródłowych w porównaniu z łącznikami CDC, które odczytują z dziennika binlog.
Automatyczny ładownik
Moduł automatycznego ładowania zapewnia przyrostowe przetwarzanie plików dla danych przychodzących do magazynu w chmurze. Zamiast skanować całe katalogi w celu znalezienia nowych plików, Auto Loader wydajnie śledzi, które pliki zostały przetworzone, przetwarzając tylko nowe pliki.
Auto Loader działa poprzez zachowanie stanu w lokalizacji punktu kontrolnego, który śledzi przetworzone pliki. Gdy nowe pliki trafiają do magazynu w chmurze, funkcja automatycznego ładowania odnajduje je za pośrednictwem listy katalogów lub trybu powiadomień dotyczących plików. Lista katalogów okresowo skanuje pod kątem nowych plików, podczas gdy tryb powiadomień plików używa zdarzeń natywnych dla chmury do natychmiastowego wykrywania.
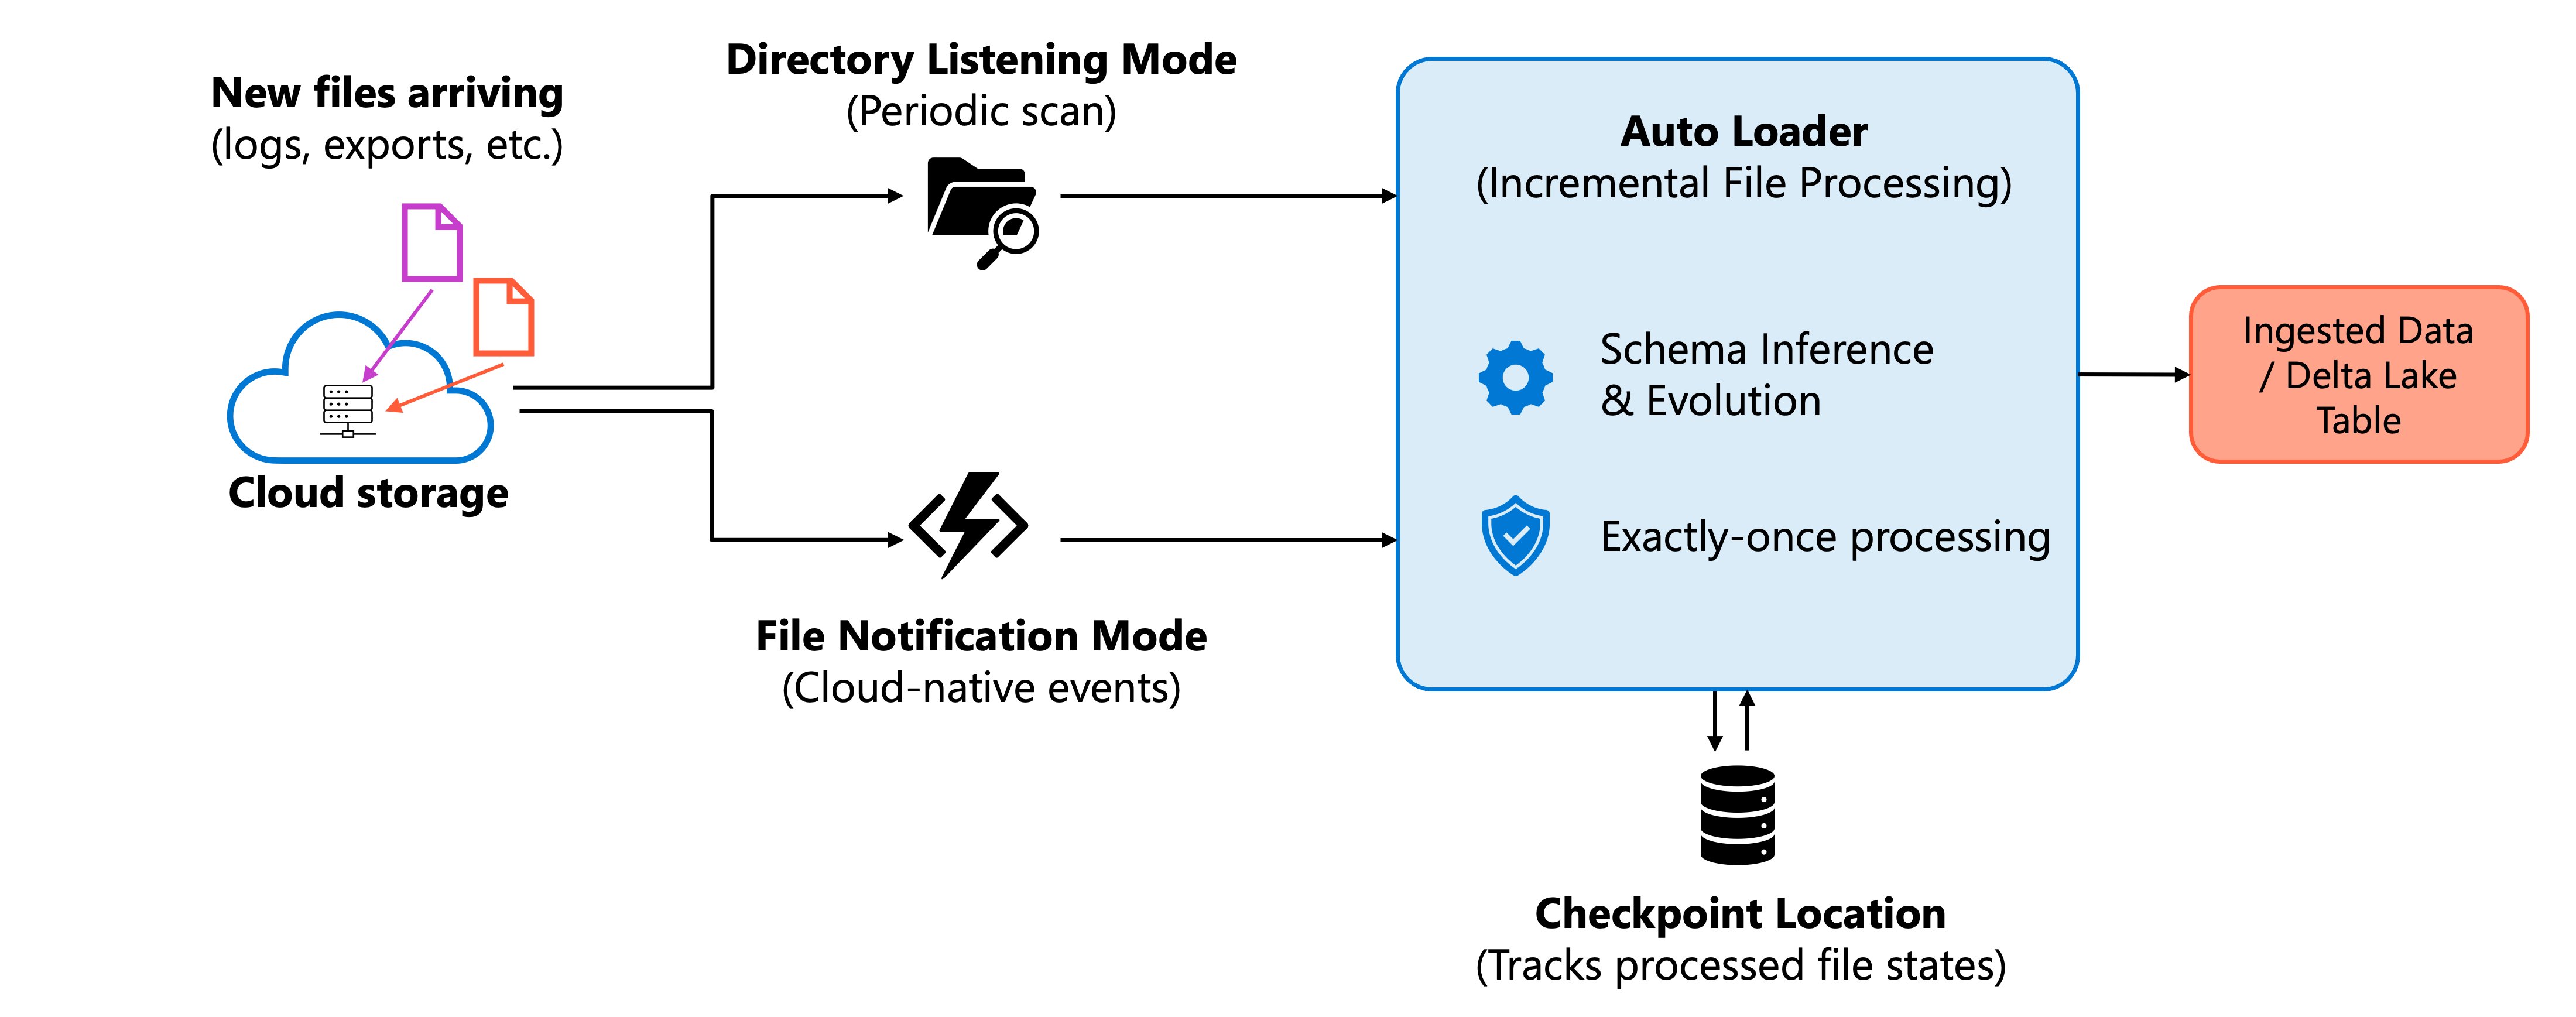
Najważniejsze możliwości automatycznego modułu ładującego obejmują:
- Wnioskowanie schematu i ewolucja: automatycznie wykrywa schemat plików przychodzących i obsługuje zmiany schematu w sposób bezproblemowy.
- Przetwarzanie dokładnie jednokrotne: Gwarantuje, że każdy plik jest przetwarzany raz, nawet w przypadku awarii i ponownego uruchamiania.
- Skalowalność: wydajnie obsługuje miliardy plików na potrzeby wypełniania kopii zapasowych lub migracji.
- Obsługa formatu: przetwarza pliki JSON, CSV, Parquet, Avro, ORC, XML, tekstowe i binarne.
Auto Loader pasuje do scenariuszy, w których dane przychodzą jako pliki do magazynu w chmurze — typowe wzorce obejmują pliki logów, eksporty z systemów nadrzędnych i strefy przyjmowania danych. Możesz użyć Auto Loader z potokami Lakeflow w celu zapewnienia zarządzanego środowiska pracy lub Structured Streaming w celu uzyskania większej kontroli.
SKOPIUJ DO
Polecenie COPY INTO SQL ładuje dane z chmury do tabel Delta. W przeciwieństwie do Automatycznego Ładowacza, który działa w sposób ciągły jako strumień, COPY INTO wykonuje się jako operacja wsadowa, którą planujesz lub wyzwalasz ręcznie.
COPY INTO śledzi, które pliki zostały już przetworzone, co sprawia, że operacja jest idempotentna. Uruchomienie tego samego polecenia wiele razy nie duplikuje danych, ponieważ wcześniej załadowane pliki są pomijane. Ta cecha przydaje COPY INTO się w przypadku zaplanowanych zadań wsadowych, w których oczekujesz przewidywalnego, powtarzalnego zachowania.
Uwaga / Notatka
Metadane śledzenia są przechowywane w ramach dziennika transakcji tabeli Delta (katalogu _delta_log)

Typowe scenariusze dla COPY INTO obejmują jednorazowe migracje danych, zaplanowane obciążenia wsadowe ze stref lądowania oraz przepływy pracy typu SQL, w których preferowana jest składnia deklaratywna nad interfejsami API przesyłania strumieniowego.
Wybierz COPY INTO zamiast Auto Loader, gdy wykonujesz jednorazowe ładowanie wsadowe dużego zestawu danych.
COPY INTO Zapewnia prostszy model konfiguracji bez konieczności infrastruktury przesyłania strumieniowego, dzięki czemu idealnie nadaje się do ładowania setek gigabajtów, a nawet terabajtów danych w ramach jednej operacji. Model ciągłego przetwarzania i zarządzanie punktami kontrolnymi automatycznego modułu ładującego dodają niepotrzebną złożoność, gdy wystarczy załadować dane tylko raz.
Jednak w przypadku ciągłego pozyskiwania przyrostowego na dużą skalę moduł automatycznego ładowania zapewnia lepszą wydajność i bardziej niezawodne odnajdywanie plików.
Strukturalne przesyłanie strumieniowe Spark
Przesyłanie strumieniowe ze strukturą platformy Spark stanowi podstawę przetwarzania danych w czasie rzeczywistym w usłudze Azure Databricks. Umożliwia ciągłe pozyskiwanie z różnych źródeł przesyłania strumieniowego z dokładnie jednokrotnymi gwarancjami przetwarzania.
Obsługiwane źródła przesyłania strumieniowego obejmują:
- Apache Kafka i Azure Event Hubs: w przypadku architektur opartych na zdarzeniach i przetwarzania kolejek komunikatów.
- Strumienie zmian Delta Lake: do propagowania zmian między tabelami Delta.
- Magazyn w chmurze za pośrednictwem automatycznego modułu ładującego: w przypadku pozyskiwania strumieniowego opartego na plikach.
- Gniazda i niestandardowe źródła: w przypadku wyspecjalizowanych scenariuszy pozyskiwania.
Wybierz opcję Przesyłanie strumieniowe ze strukturą, gdy potrzebujesz precyzyjnej kontroli nad zachowaniem przesyłania strumieniowego, niestandardowym znakowaniem wodnym lub logiką okien albo podczas pracy ze źródłami, które nie są obsługiwane przez abstrakcje wyższego poziomu.
Połączenia JDBC i ODBC
Pozyskiwanie danych opartych na notesach przy użyciu technologii JDBC lub ODBC pozostaje praktycznym podejściem do wyodrębniania danych z relacyjnych baz danych. Piszesz kod, który łączy się bezpośrednio ze źródłowymi bazami danych, wykonuje zapytania i ładuje wyniki do tabel delty.
Takie podejście obsługuje praktycznie dowolną bazę danych ze sterownikiem JDBC lub ODBC: SQL Server, Oracle, PostgreSQL, MySQL i wiele innych. Pełne lub przyrostowe ładowanie implementuje się, pisząc odpowiednie zapytania, często używając kolumn znaczników czasowych do śledzenia postępu wyodrębniania.
Chociaż zarządzane łączniki Lakeflow Connect zastępują protokół JDBC/ODBC w wielu scenariuszach, połączenia oparte na notatnikach pozostają cenne, gdy:
- Baza danych nie jest obsługiwana przez łączniki zarządzane usługi Lakeflow Connect.
- Potrzebujesz niestandardowej logiki wyodrębniania, której zarządzane łączniki nie mogą obsłużyć.
- Utrzymujesz istniejące potoki korzystające z tego wzorca.
- Dla dużych tabel wymagane są określone optymalizacje wypychania zapytań.
W przypadku korzystania z JDBC/ODBC, poświadczenia należy bezpiecznie przechowywać przy użyciu sekretów Databricks, zamiast twardego kodowania ich w notatnikach. Zastanów się nad wpływem na wydajność systemów źródłowych i zaimplementuj odpowiednie mechanizmy ograniczania lub harmonogramowania, aby zapobiec przeciążeniu baz danych transakcyjnych.
W przypadku lokalnych baz danych wymagana jest dodatkowa infrastruktura sieciowa — Azure ExpressRoute/VPN do bezpośredniej łączności JDBC z usługi Databricks lub Azure Data Factory z Self-Hosted Integration Runtime, aby najpierw umieścić dane w magazynie w chmurze.
Azure Data Factory
Usługa Azure Data Factory (ADF) służy jako platforma aranżacji i przenoszenia danych w ekosystemie platformy Azure. Doskonały w koordynowaniu przepływów pracy obejmujących wiele usług i kierowanie danych z różnych źródeł do magazynu w chmurze, gdzie Azure Databricks może je przetwarzać.
Usługa ADF jest szeroko zintegrowana z usługami firmy Microsoft, takimi jak Dynamics 365, Azure SQL Database i Microsoft Fabric. Gdy dane pochodzą z tych źródeł, usługa ADF zapewnia prostą łączność i może przechować dane w Azure Data Lake Storage do późniejszego przetwarzania w Databricks.
Zrozumienie odpowiedniej roli usługi ADF jest ważne. Użyj usługi ADF dla:
- Orkiestracja: koordynowanie przepływów pracy obejmujących wiele usług platformy Azure.
- Początkowe lądowanie danych: przenoszenie danych ze źródeł platformy Azure do magazynu w chmurze.
- Integracja dla przedsiębiorstw: gdy zasady firmy wymagają usługi ADF do przenoszenia danych.

Unikaj używania usługi ADF do podstawowych przekształceń ETL wewnątrz usługi Databricks. Uruchamianie przekształceń za pośrednictwem działań usługi ADF wprowadza niepotrzebną złożoność i jest mniej wydajne niż natywne przetwarzanie Databricks. Pozwól usłudze ADF obsługiwać przenoszenie danych do usługi Lakehouse, a następnie użyj narzędzi usługi Azure Databricks do logiki przekształcania.
Stosowanie struktury decyzyjnej
Wybór narzędzia do integracji danych staje się bardziej oczywisty, gdy oceniasz swój scenariusz pod kątem kluczowych kryteriów decyzyjnych.
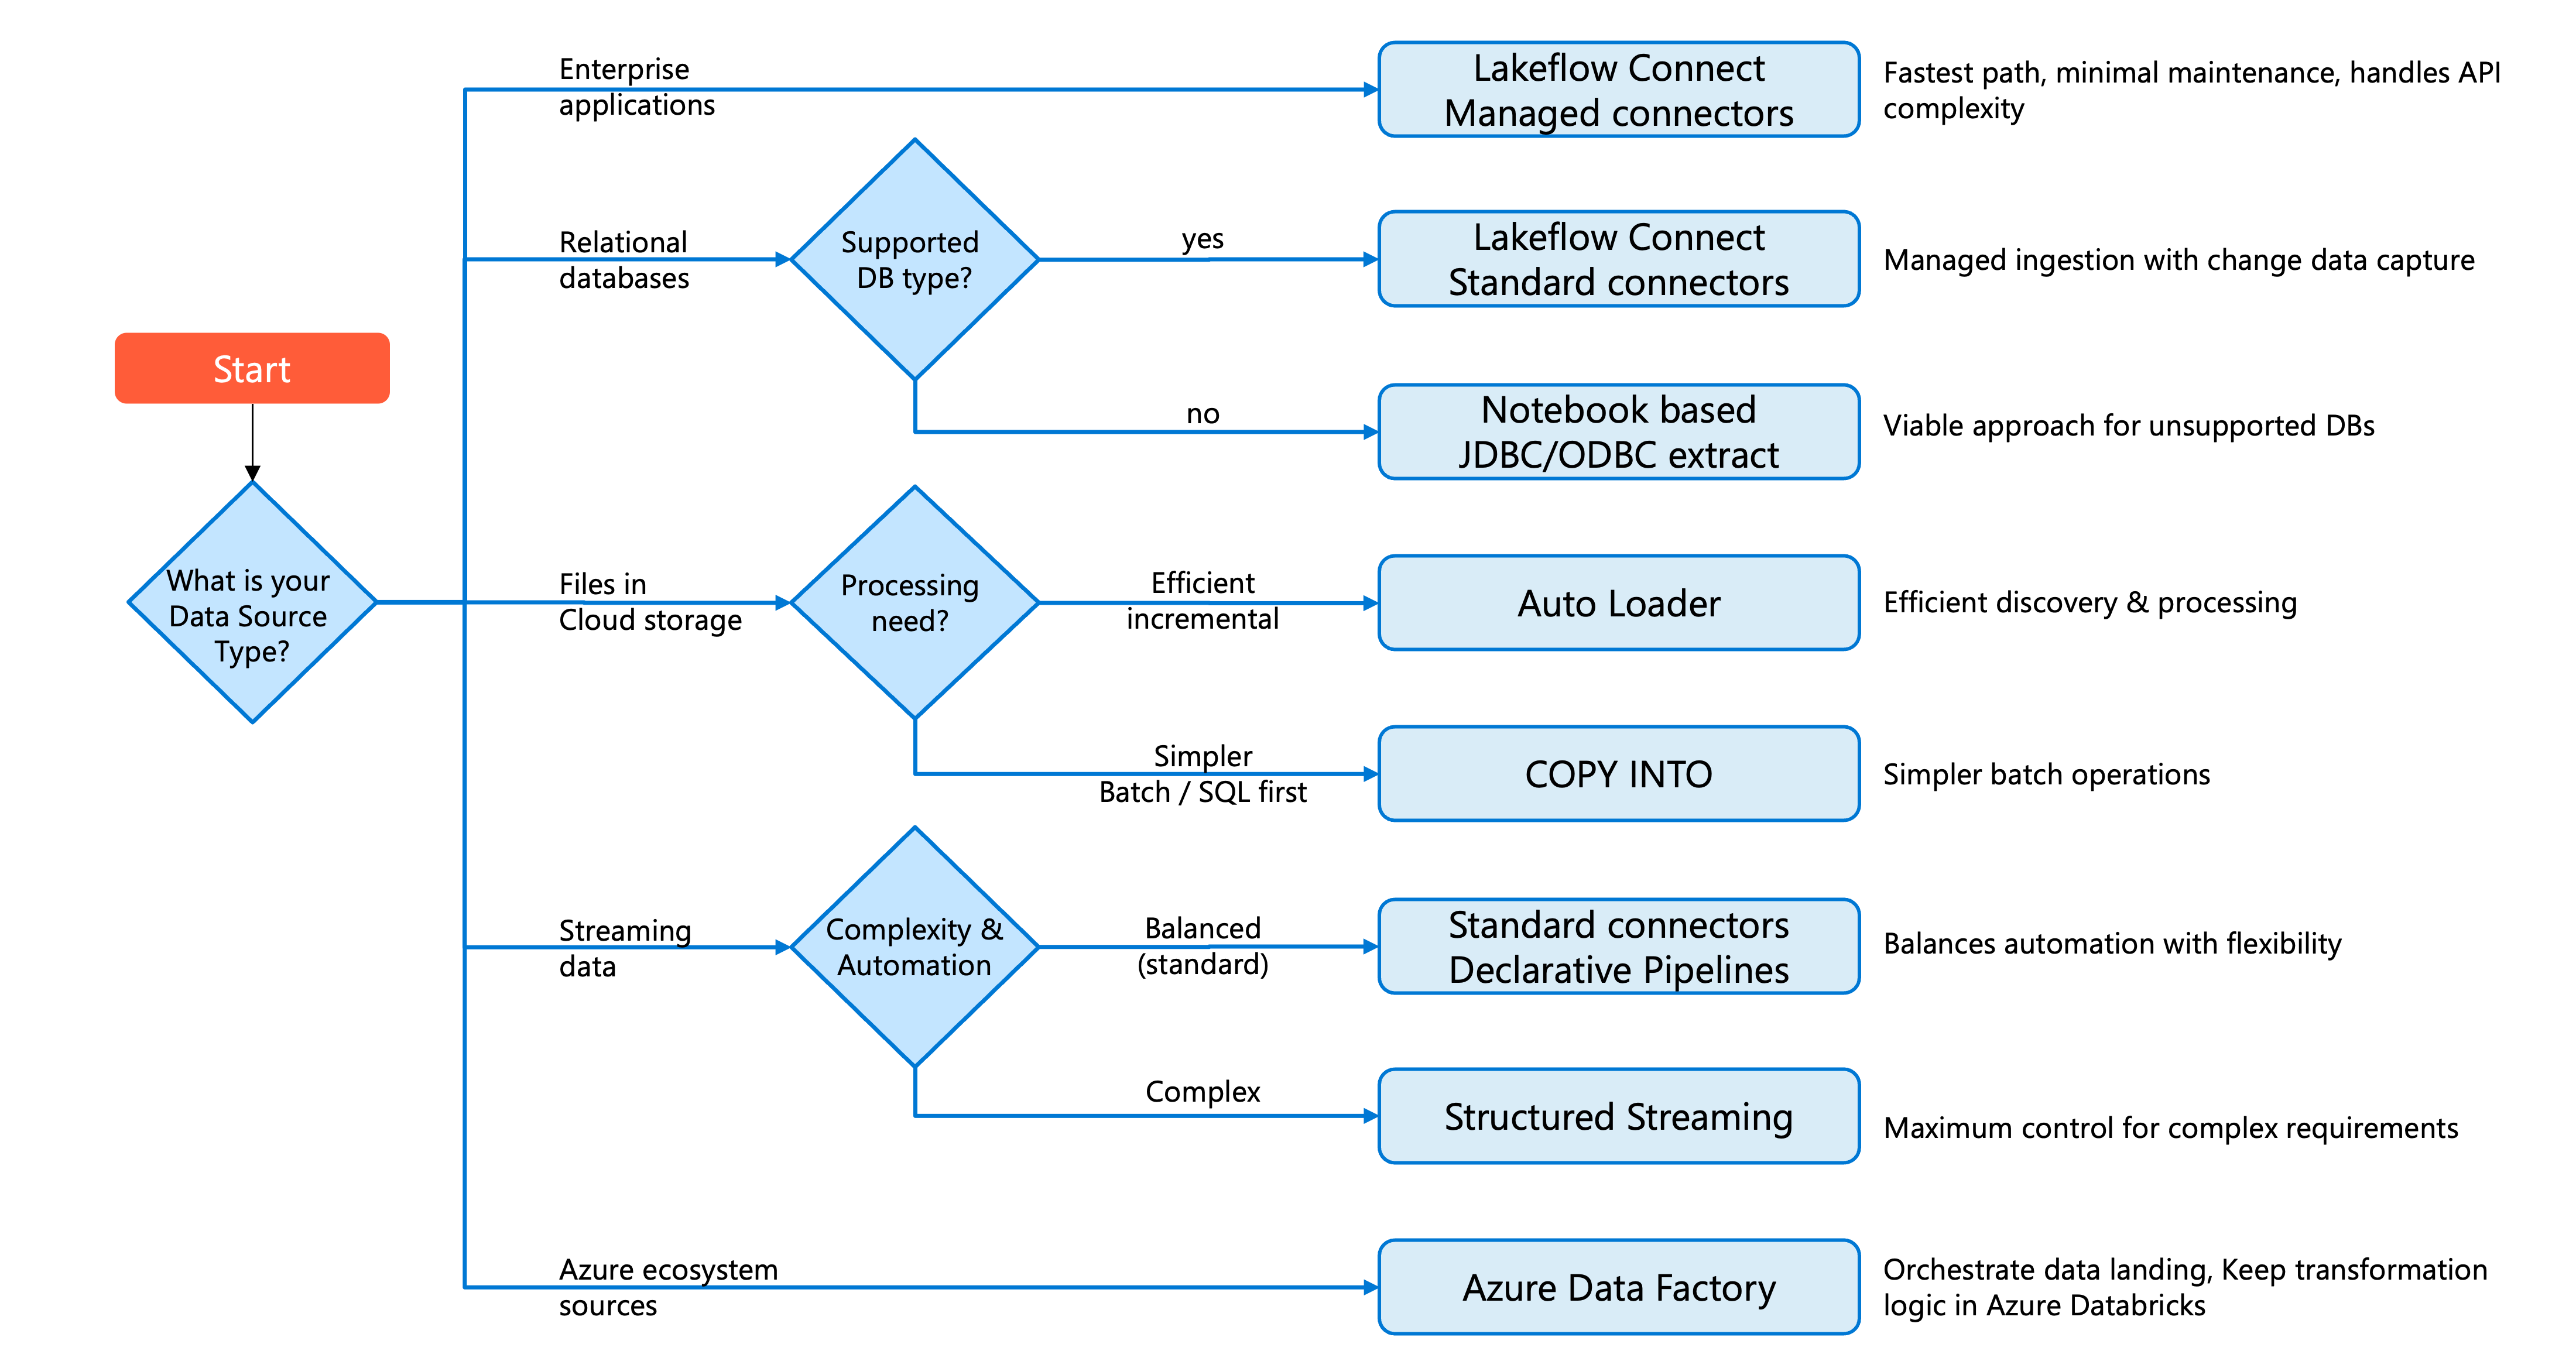
Zacznij od zidentyfikowania typu źródła danych, a następnie rozważ wymagania operacyjne i kontekst organizacyjny.
W przypadku aplikacji dla przedsiębiorstw (Salesforce, ServiceNow, SharePoint) łączniki zarządzane lakeflow Connect oferują najszybszą ścieżkę do środowiska produkcyjnego z minimalną konserwacją. Te łączniki obsługują złożoność integracji interfejsu API, ograniczania szybkości i śledzenia zmian.
W przypadku relacyjnych baz danych z obsługiwanymi typami narzędzie Lakeflow Connect oferuje dwie procedury zarządzane: łączniki bazy danych (oparte na CDC, wymagają bramy) do przechwytywania ciągłych zmian oraz łączniki oparte na zapytaniach do łatwiejszego planowanego pobierania przy użyciu kolumny kursora. W przypadku nieobsługiwanych baz danych wyodrębnianie JDBC/ODBC oparte na notesach pozostaje opłacalne.
W przypadku plików w magazynie w chmurze funkcja automatycznego ładowania zapewnia wydajne odnajdywanie przyrostowe i przetwarzanie. Użyj funkcji COPY INTO w przypadku prostszych scenariuszy wsadowych lub w przypadku preferowania przepływów pracy typu SQL-first.
W przypadku danych przesyłanych strumieniowo z magistrali komunikatów (Kafka, Event Hubs, Pub/Sub) łączniki standardowe z potokami Lakeflow równoważą automatyzację z elastycznością. W przypadku złożonych wymagań dotyczących przesyłania strumieniowego usługa Structured Streaming oferuje maksymalną kontrolę.
W przypadku źródeł ekosystemu platformy Azure wymagających koordynacji z innymi usługami usługa Azure Data Factory może koordynować lądowanie danych w Lakehouse. Zachowaj logikę przekształcania w usłudze Azure Databricks, a nie w przepływach danych usługi ADF.
Wskazówka
Zacznij od najbardziej zarządzanej opcji, która spełnia Twoje wymagania. Łączniki zarządzane skracają czas programowania i obciążenie konserwacyjne. Należy przejść do bardziej dostosowanych podejść tylko wtedy, gdy nie można spełnić określonych wymagań przy użyciu abstrakcji wyższego poziomu.
Wybór zależy również od umiejętności zespołu i standardów organizacyjnych. Udokumentuj swoje decyzje i uzasadnienie, aby pomóc przyszłym członkom zespołu w pełnym zrozumieniu architektury przetwarzania danych.