Projektowanie logiki zadań lakeflow
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Podczas projektowania logiki zadań dla zadania Lakeflow podejmujesz decyzje wpływające na sposób wykonywania, skalowania i reagowania na zmieniające się warunki przepływu pracy. Dobrze zaprojektowane zadanie równoważy wydajność, koszty i łatwość utrzymania przy jednoczesnym spełnieniu wymagań biznesowych.
W tej lekcji dowiesz się, jak tworzyć struktury zależności zadań, wybierać wzorce wykonywania i konfigurować parametry, które sprawiają, że zadania są elastyczne i wielokrotnego użytku.
Omówienie relacji zadań w zadaniu
Zadania Lakeflow reprezentują zadania i ich relacje jako Graf Acykliczny (DAG). Każde zadanie w grupie DAG może zależeć od jednego lub większej liczby nadrzędnych zadań, tworząc wizualną mapę kolejności wykonywania przepływu pracy.

Rozważ typowy przepływ pracy przetwarzania danych. Może istnieć zadanie pozyskiwania, które ładuje nieprzetworzone dane, a następnie zadania przekształcania, które czyszczą i agregują te dane, a na koniec zadanie publikujące wyniki. Zależności między tymi zadaniami określają nie tylko kolejność wykonywania, ale także sposób propagacji błędów za pośrednictwem przepływu pracy.
Podczas konfigurowania zależności zadań należy wybrać jedną z kilku warunków zależności:
| Warunek zależności | Zachowanie |
|---|---|
| Wszystko powiodło się | Uruchamiane tylko wtedy, gdy wszystkie zadania nadrzędne zakończą się pomyślnie |
| Co najmniej jeden sukces | Uruchamia się, gdy wszystkie zadania nadrzędne kończą się powodzeniem |
| Żaden nie zawiódł | Uruchamia się, gdy żadne zadania nadrzędne nie powiodły się, nawet jeśli niektóre zostały pominięte |
| Wszystko gotowe | Uruchamiane po zakończeniu wszystkich zadań nadrzędnych niezależnie od wyniku |
| Co najmniej jedno niepowodzenie | Uruchamia się tylko wtedy, gdy co najmniej jedno nadrzędne zadanie kończy się niepowodzeniem |
| Wszystkie nie powiodły się | Działa tylko wtedy, gdy wszystkie zadania nadrzędne kończą się niepowodzeniem |
Te warunki zapewniają kontrolę nad wykonywaniem zadań, wykraczając poza prostą kolejność sekwencyjną. Można na przykład skonfigurować zadanie oczyszczania z poleceniem Wszystko gotowe, aby upewnić się, że zasoby tymczasowe są zwalniane niezależnie od tego, czy wcześniejsze zadania zakończyły się pomyślnie.
Podczas debugowania potoku można wyłączyć poszczególne zadania , a nie je usuwać. Wyłączone zadanie jest pomijane w czasie wykonywania, ale zachowuje jego konfigurację, zależności i historię uruchamiania bez zmian, dzięki czemu można je ponownie włączyć bez ponownego kompilowania zadania. Preferowane jest to zamiast usunięcia, gdy może być konieczne ponowne wykonanie zadania — na przykład wstrzymanie przerwanego zadania, aby reszta pracy mogła być kontynuowana zgodnie z harmonogramem.
Projektowanie wzorców wykonywania zadań
Wybór między wykonywaniem szeregowym i równoległym wpływa zarówno na wydajność środowiska uruchomieniowego, jak i wykorzystanie zasobów. Zadania bez zależności mogą być uruchamiane jednocześnie, co zmniejsza całkowity czas trwania zadania.
Rozważmy scenariusz, w którym trzeba przetwarzać dane z trzech niezależnych źródeł. Jeśli projektujesz je jako zadania sekwencyjne, zadanie czeka na ukończenie każdego źródła przed rozpoczęciem następnego. W przypadku równoległego wykonywania wszystkie trzy zadania są uruchamiane jednocześnie.
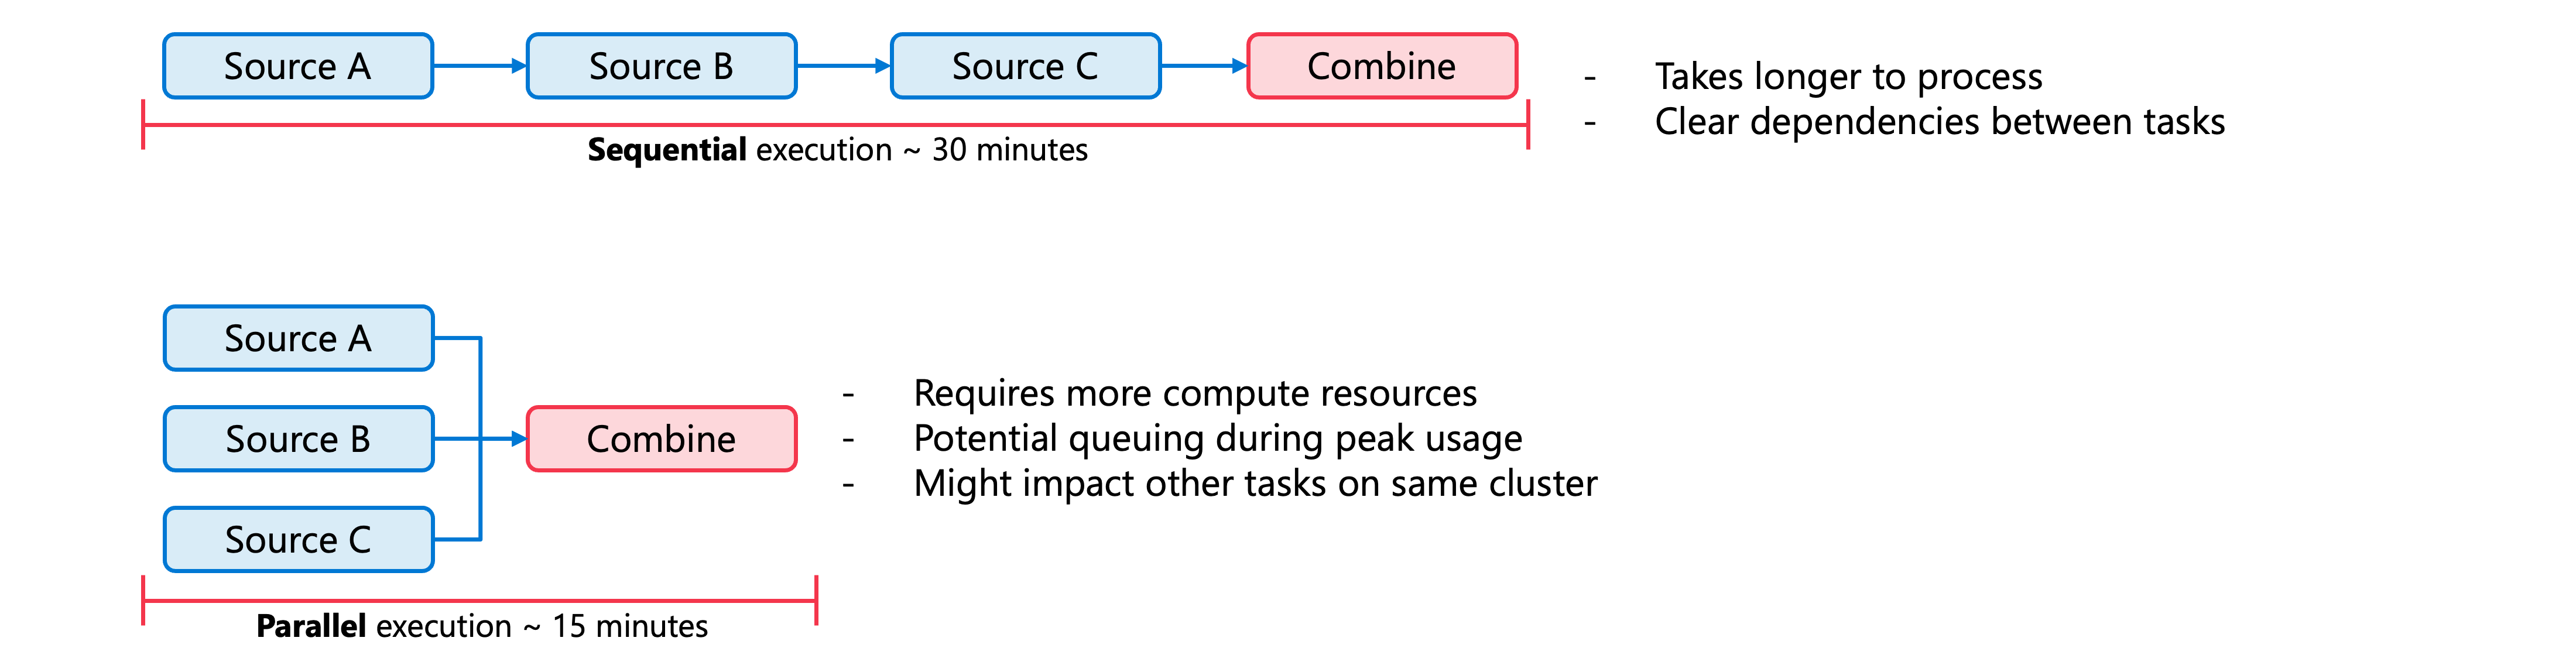
Jednak wykonywanie równoległe wymaga większej liczby zasobów obliczeniowych. Podczas projektowania grafu zadań, równoważ równoległość z dostępną pojemnością obliczeniową w obszarze roboczym. Usługa Azure Databricks ogranicza współbieżne uruchamianie zadań w obszarze roboczym, więc bardzo równoległe zadania mogą oczekiwać w kolejce w trakcie szczytowego obciążenia.
Zadania współużytkujące zasób obliczeniowy są uruchamiane w tym samym klastrze, co zmniejsza opóźnienie uruchamiania, ale oznacza, że współużytkują dostępną pamięć i procesor CPU. Rozważ grupowanie powiązanych zadań na udostępnionych obliczeniach przy jednoczesnym zachowaniu zadań intensywnie korzystających z zasobów w dedykowanych klastrach.
Dodawanie logiki warunkowej do przepływów zadań
Rzeczywiste przepływy pracy często wymagają podejmowania decyzji na podstawie warunków danych lub wyników przetwarzania. Lakeflow Jobs udostępniają dwa podstawowe mechanizmy wykonywania warunkowego.
Jeśli/inne rozgałęzianie
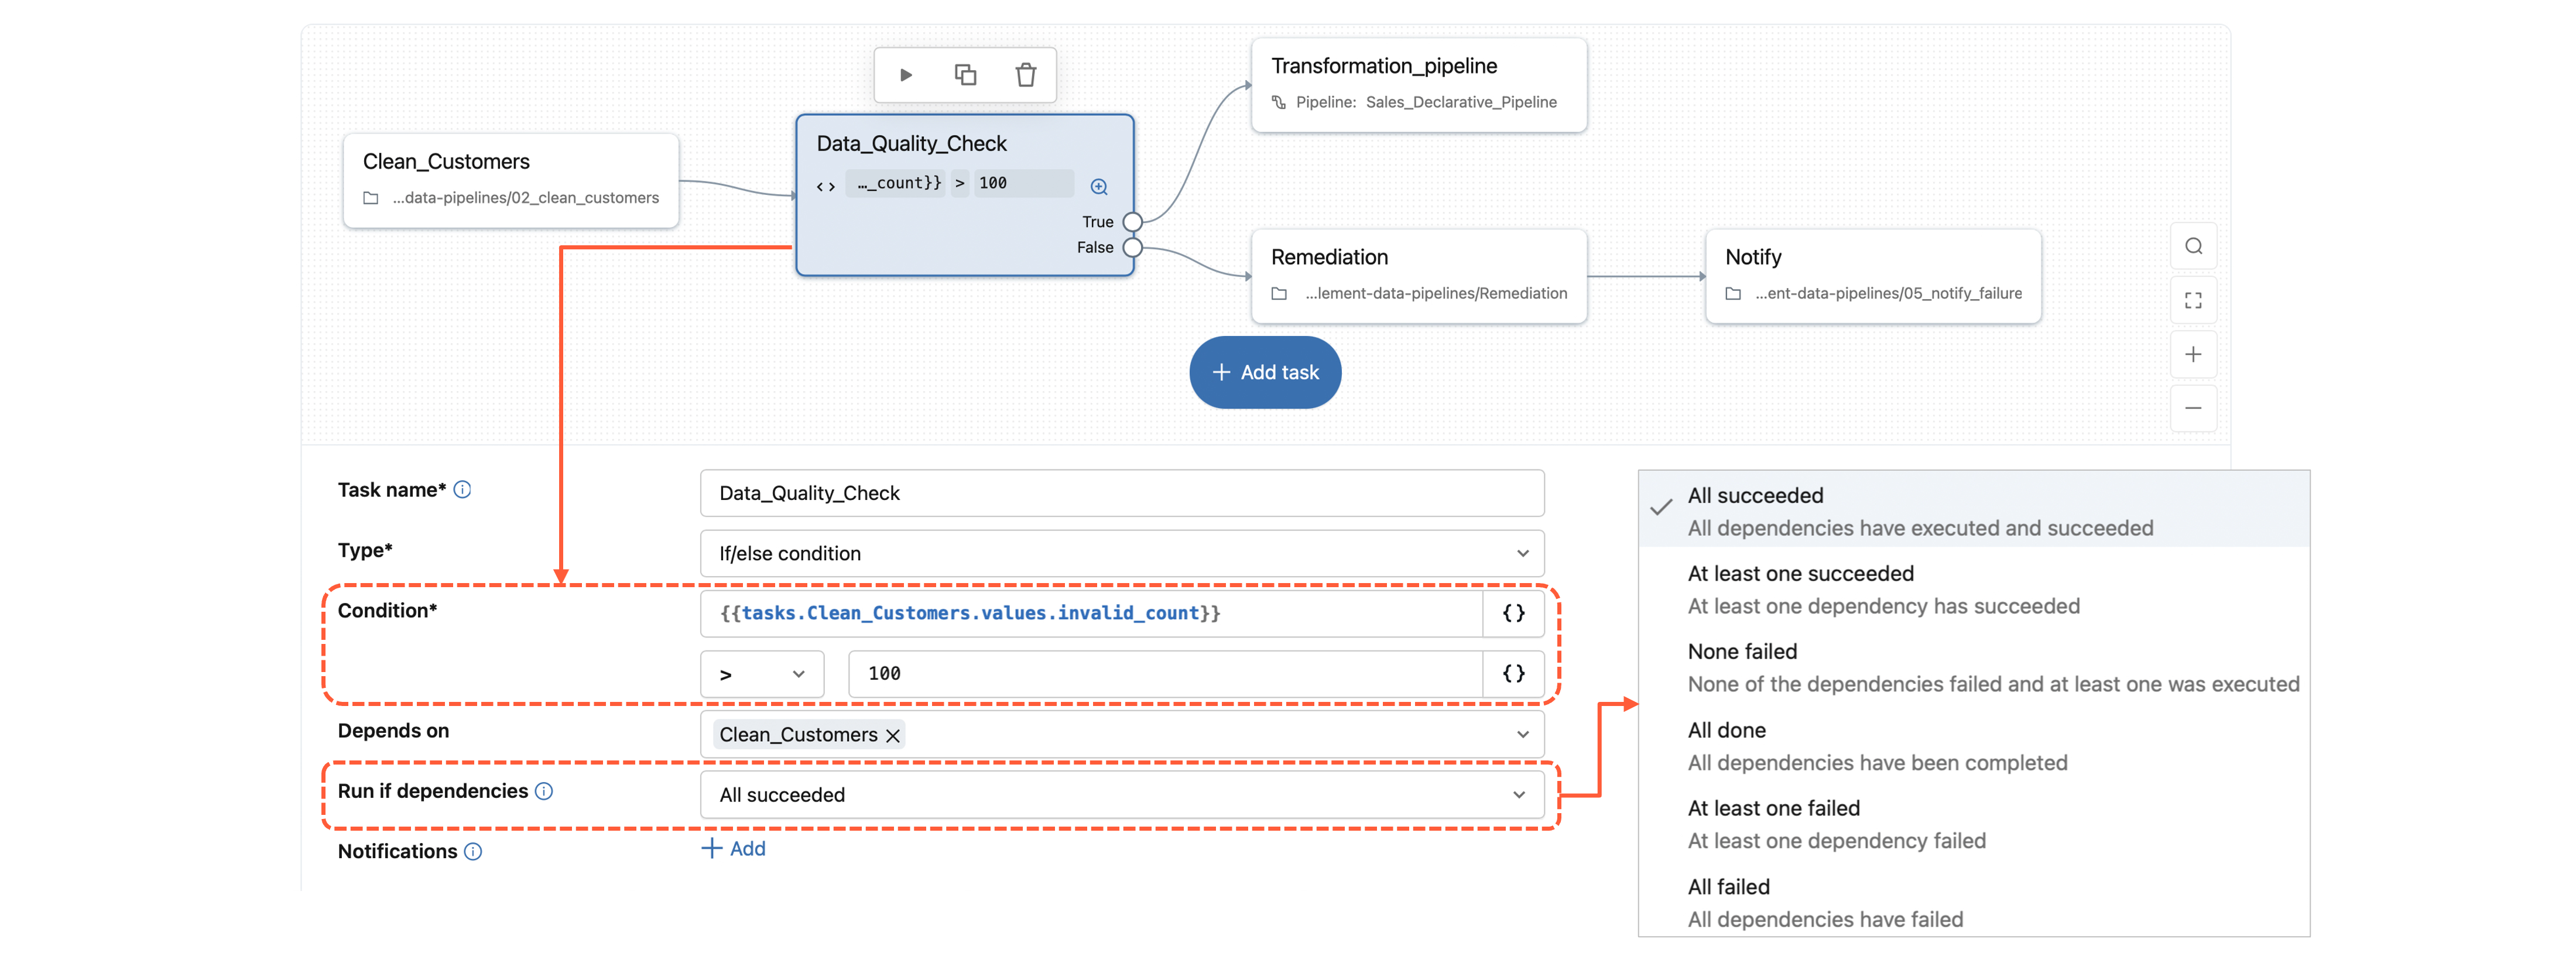
Użyj zadań warunkowych If/else , jeśli musisz wybrać między różnymi ścieżkami przetwarzania na podstawie wartości lub stanu. Warunek oblicza wyrażenie przy użyciu wartości zadań, parametrów zadania lub odwołań dynamicznych.
Załóżmy na przykład, że kontrola jakości danych generuje liczbę nieprawidłowych rekordów. Możesz skonfigurować zadanie warunkowe If/else do kierowania przebiegiem wykonania.
- Jeśli nieprawidłowe dane przekraczają próg, uruchom przepływ pracy naprawczego.
- W przeciwnym razie przejdź do standardowej ścieżki transformacyjnej
Wyrażenie warunku może wyglądać następująco: {{tasks.quality_check.values.invalid_count}} > 100
Gdy warunek jest prawdziwy, wykonywane są zadania skonfigurowane do zależności od prawdziwego wyniku. W przypadku wartości false zamiast tego zostanie uruchomiona alternatywna ścieżka.
Uruchom, jeśli warunki
W przypadku zadań, które powinny być wykonywane na podstawie wyników nadrzędnych zadań, a nie wartości danych, użyj polecenia Uruchom, jeśli zależności. Takie podejście obsługuje scenariusze, takie jak:
- Uruchamianie zadania powiadomień tylko wtedy, gdy zadania nadrzędne kończą się niepowodzeniem
- Wykonywanie logiki oczyszczania niezależnie od powodzenia lub niepowodzenia
- Kontynuuj, gdy co najmniej jedno z kilku alternatywnych źródeł danych zakończy się sukcesem.
Uruchom polecenie , jeśli warunki są obliczane automatycznie na podstawie stanu zadania bez konieczności jawnych porównań wartości.
Implementowanie przetwarzania iteracyjnego za pomocą polecenia Dla każdego
Jeśli musisz zastosować taką samą logikę przetwarzania w wielu elementach, zadanie Dla każdego eliminuje powtarzające się definicje zadań. Definiujesz jedno zadanie zagnieżdżone, które jest wykonywane raz dla każdego elementu w tablicy wejściowej.
Typowe scenariusze dla każdego zadania to:
- Przetwarzanie plików z listy ścieżek
- Przekształcanie danych dla wielu regionów lub zakresów dat
- Uruchamianie tej samej analizy w różnych kategoriach produktów
Tablica wejściowa może pochodzić z kilku źródeł. Można go zdefiniować bezpośrednio jako JSON, odwołać się do wartości zadania z poprzedniego zadania lub użyć parametru zadania. Każda iteracja odbiera odpowiedni element tablicy jako dane wejściowe.
# A preceding task might set values like this:
regions = ["us-east", "us-west", "eu-central"]
dbutils.jobs.taskValues.set(key="regions_to_process", value=regions)
Dla każdego zadania następnie odwołuje {{tasks.get_regions.values.regions_to_process}} się i uruchamia swoje zagnieżdżone zadanie trzy razy — raz dla każdego regionu.
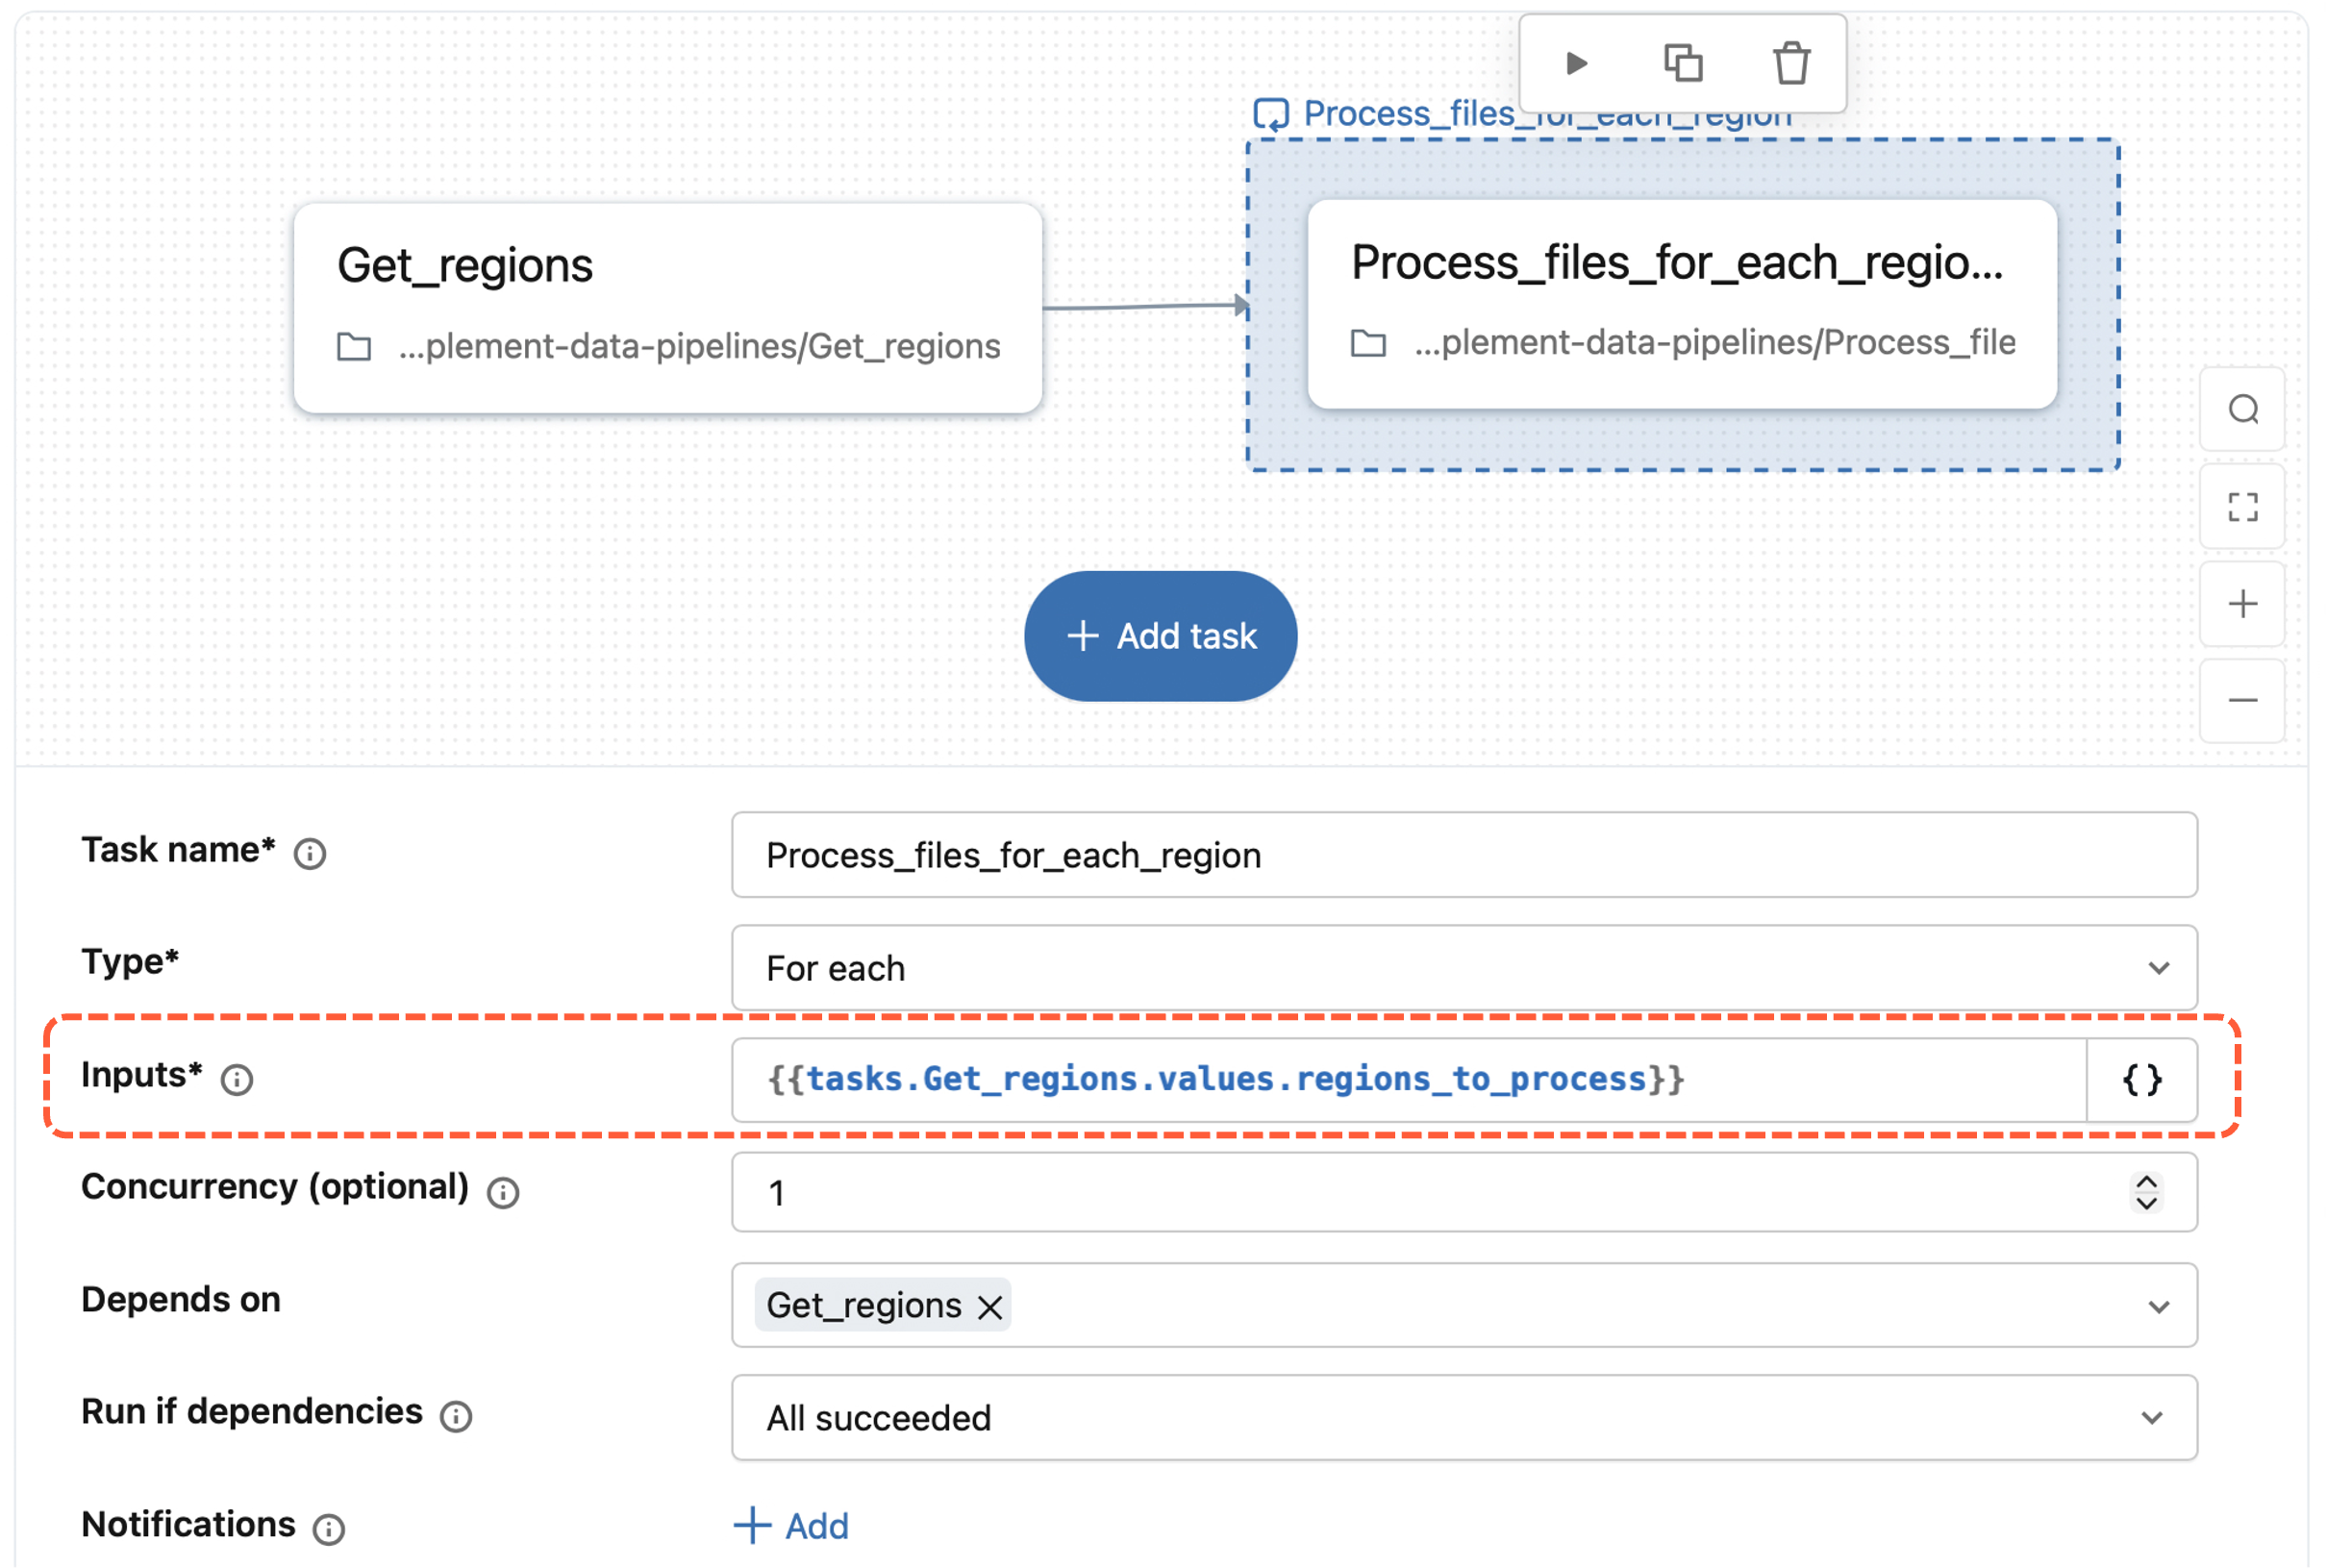
Współbieżność można kontrolować, ustawiając liczbę iteracji, które mogą być uruchamiane równolegle. Wyższa współbieżność przetwarza elementy szybciej, ale wymaga więcej zasobów obliczeniowych.
Konfigurowanie parametrów pod kątem elastyczności
Dobrze zaprojektowane zadania akceptują parametry , które umożliwiają takie samemu przepływowi pracy obsługę różnych scenariuszy bez modyfikacji. Parametry można definiować na poziomie zadania i mieć do nich dostęp w dowolnym zadaniu lub przekazywać je specjalnie do poszczególnych zadań.
Rozważ zaprojektowanie zadań przy użyciu tych wzorców parametrów:
Parametry daty i godziny: włącz to samo zadanie, aby przetwarzać różne okresy. Obsługuje to zarówno zaplanowane uruchomienia z aktualnymi datami, jak i operacje uzupełniania danych historycznych.
Parametry środowiska: zezwalaj na przełączanie między konfiguracjami programowania, przejściowymi i produkcyjnymi. Możesz sparametryzować nazwy katalogów, ścieżki przechowywania lub ustawienia połączenia.
Parametry przetwarzania: kontrolowanie zachowania zadania, takiego jak rozmiary partii, kryteria filtrowania lub formaty danych wyjściowych.
Aby odwołać się do parametru zadania w ramach zadania, użyj składni {{job.parameters.<parameter_name>}} w konfiguracji zadania. Jeśli na przykład zdefiniujesz parametr zadania o nazwie target_catalog, skonfiguruj zadanie notesu, aby przekazać je jako parametr podstawowy o wartości {{job.parameters.target_catalog}}. Następnie uzyskaj dostęp do niego w notesie:
# Access the parameter passed to the notebook
target_catalog = dbutils.widgets.get("target_catalog")
spark.sql(f"USE CATALOG {target_catalog}")
Usługa Azure Databricks udostępnia odwołania do wartości dynamicznych, które wstrzykują kontekst uruchomieniowy do parametrów. W przypadku zaplanowanych zadań {{job.trigger.time.iso_date}} zawiera datę wyzwalacza. W przypadku przebiegów wypełniania, {{backfill.iso_datetime}} dostarcza znacznik czasu wypełniania.
Wybieranie zasobów obliczeniowych dla zadań
Każdy typ zadania ma zalecane opcje obliczeniowe, które mają wpływ zarówno na możliwości, jak i koszty. Projekt logiki zadań powinien uwzględniać wymagania obliczeniowe:
| Typ zadania | Zalecane obliczenia |
|---|---|
| Notebooki, skrypty Pythona | Obliczenia zadań bezserwerowych |
| Zapytania i pliki SQL | Bezserwerowa usługa SQL Warehouse |
| Potoki danych Lakeflow | Obliczenia potoku bezserwerowego |
| Pliki JAR i Przesyłanie platformy Spark | Obliczenia dotyczące klasycznych zadań |
Zadania w ramach tego samego zadania mogą używać różnych zasobów obliczeniowych. Typowy wzorzec przypisuje zadania SQL do magazynu danych SQL, podczas gdy przekształcenia oparte na notesach są uruchamiane na infrastrukturze obliczeniowej zadań.
Gdy wiele zadań współużytkuje klaster, klaster pozostaje aktywny do czasu ukończenia wszystkich zadań. Skraca to czas uruchamiania, ale wiąże się z kosztami w okresach bezczynności między wykonaniami zadań. Równoważenie korzyści operacyjnych z zasobów współdzielonych z izolacją zasobów w dedykowanych klastrach.
W przypadku zadań produkcyjnych przetwarzanie bezserwerowe eliminuje obciążenie związane z zarządzaniem klastrem i automatycznie skaluje je. Klasyczne obliczenia zapewniają większą kontrolę konfiguracji, gdy potrzebujesz określonych wersji platformy Spark, bibliotek niestandardowych lub określonych typów wystąpień.
Projekt logiki zadań ustanawia podstawę niezawodnych, wydajnych przepływów pracy danych. Podczas implementowania i testowania zadań można dostosowywać zależności, dostosowywać równoległość i dostrajać parametry w celu dopasowania rzeczywistych cech obciążenia.