Instalowanie bibliotek na potrzeby obliczeń
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Podczas uruchamiania notesów i zadań w obliczeniach usługi Azure Databricks często potrzebne są pakiety innych firm lub kod niestandardowy, który nie jest uwzględniony w domyślnym środowisku uruchomieniowym. Zainstalowanie bibliotek na poziomie klastra zapewnia, że każdy notes i zadanie korzystające z tego środowiska obliczeniowego mają dostęp do tych samych zależności, tworząc spójne środowisko wykonywania.
Zrozumienie sposobu efektywnego instalowania bibliotek staje się kluczowe, ponieważ przepływy pracy inżynierii danych rosną w złożoności. Musisz wiedzieć, której metody instalacji użyć, gdzie przechowywać pliki biblioteki oraz jak tryby dostępu wpływają na opcje.
Zrozumienie bibliotek o zakresie obliczeniowym
Biblioteki o zakresie obliczeniowym są instalowane w klastrze i stają się dostępne dla wszystkich notesów i zadań uruchamianych w tym klastrze. W przeciwieństwie do bibliotek dla sesji notebooka, które instalują się tylko dla określonej sesji notebooka, biblioteki o zakresie obliczeniowym przetrwają ponowne uruchomienia klastra i tworzą wspólne środowisko dla wszystkich użytkowników.
Po zainstalowaniu biblioteki na poziomie klastra usługa Azure Databricks automatycznie ponownie zainstaluje ją za każdym razem, gdy klaster zostanie uruchomiony. To zachowanie zapewnia spójność — nie trzeba ręcznie ponownie instalować zależności po zatrzymaniu i ponownym uruchomieniu klastra. Wszystkie notesy dołączone do klastra mogą natychmiast importować zainstalowane pakiety i korzystać z nich.
Uwaga / Notatka
Aby zainstalować biblioteki w klastrze, musisz mieć uprawnienie CAN MANAGE w tym klastrze. To uprawnienie umożliwia modyfikowanie konfiguracji klastra, w tym dodawanie i usuwanie bibliotek. Bez tego uprawnienia nie będzie można uzyskać dostępu do interfejsu instalacyjnego biblioteki.
Biblioteki o zakresie obliczeniowym obsługują koła języka Python, pliki JAR języka Java i pakiety języka R. Można je zainstalować z repozytoriów pakietów, takich jak PyPI i Maven, lub z plików przechowywanych w plikach obszaru roboczego, woluminach Unity Catalog lub w magazynie obiektów w chmurze. Wybrana metoda instalacji zależy od typu biblioteki, trybu dostępu do klastra i wymagań dotyczących zabezpieczeń organizacji.
Jednak biblioteki o zakresie obliczeniowym mają ważne ograniczenie: każda biblioteka, którą zainstalujesz, wpływa na każdy notatnik w klastrze. Jeśli różne zespoły potrzebują sprzecznych wersji tej samej biblioteki, będziesz potrzebować oddzielnych klastrów lub instalacji ograniczonych do notebooka, aby uniknąć konfliktów.
Instalowanie bibliotek z repozytoriów pakietów
Repozytoria pakietów zapewniają najbardziej typowy sposób instalowania bibliotek. PyPI hostuje pakiety języka Python, maven hostuje biblioteki Java i Scala, a usługa CRAN hostuje pakiety języka R. Te repozytoria automatycznie obsługują rozwiązywanie zależności i zarządzanie wersjami.
Aby zainstalować bibliotekę z PyPI, wybierz pozycję PyPI jako źródło biblioteki i wprowadź nazwę pakietu. W przypadku obciążeń produkcyjnych określ dokładną wersję, aby zapewnić powtarzalność: pymssql==2.3.9. Bez numeru wersji usługa Azure Databricks instaluje najnowszą dostępną wersję, co może się zmieniać podczas instalacji i potencjalnie zakłócać działanie kodu.
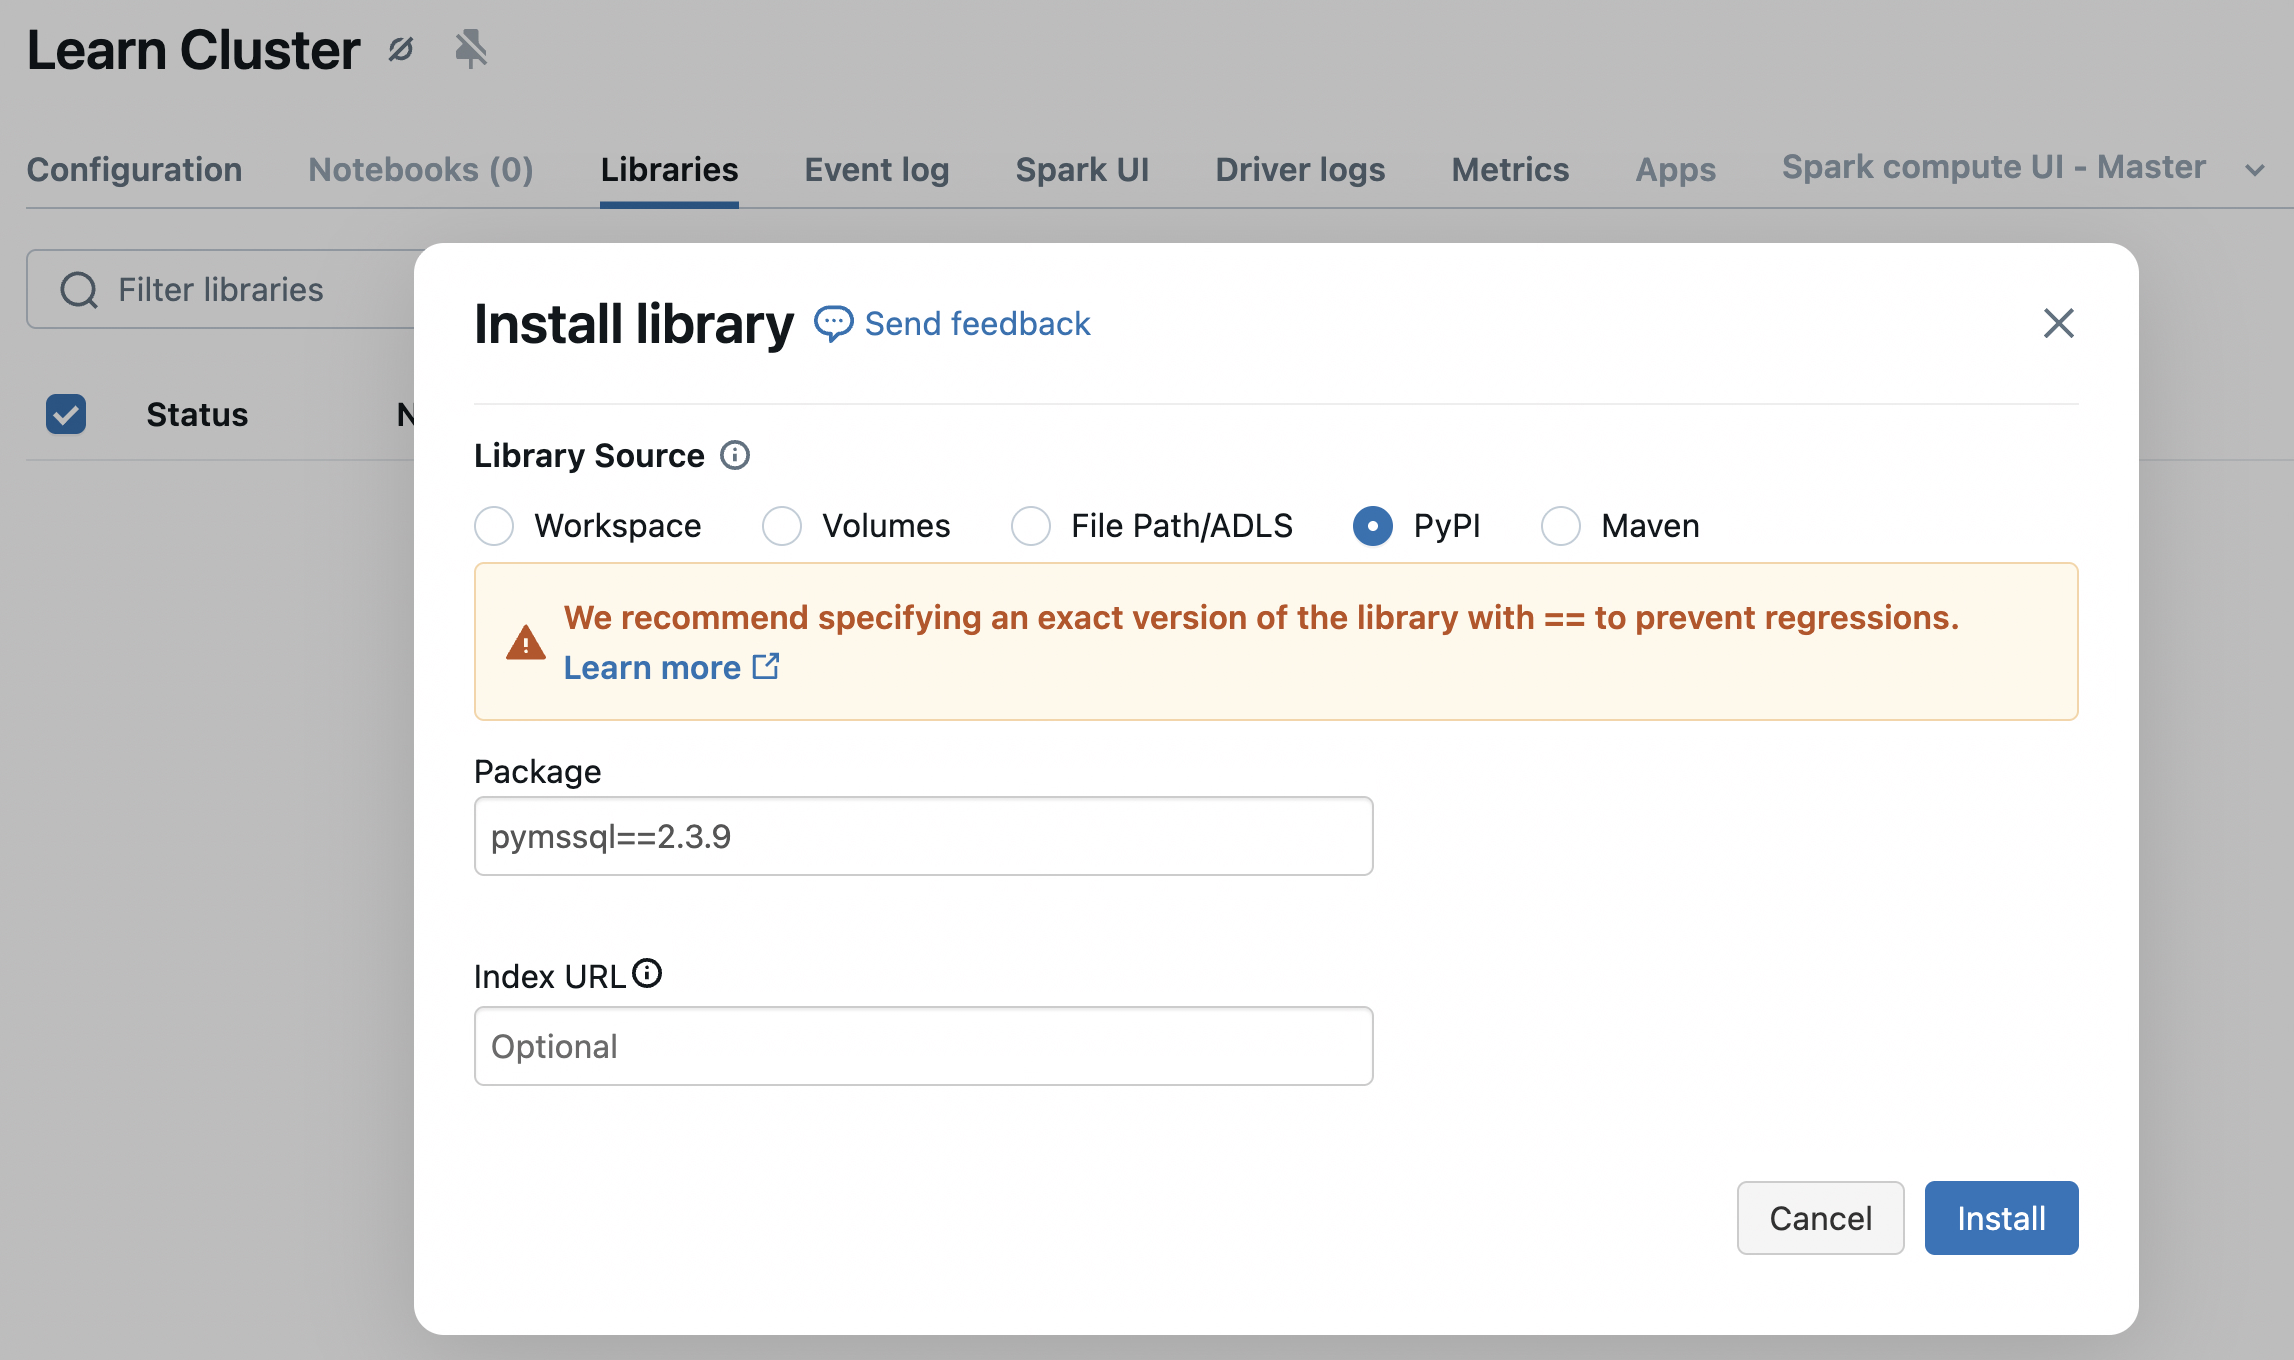
Biblioteki Maven wymagają współrzędnych w formacie groupId:artifactId:version. Aby na przykład zainstalować sterownik JDBC firmy Microsoft dla biblioteki programu SQL Server, należy użyć polecenia com.microsoft.sqlserver:mssql-jdbc:13.2.1.jre11. Jeśli nie znasz dokładnych współrzędnych, możesz wyszukać pakiety bezpośrednio w oknie dialogowym instalacji. Program Maven obsługuje również wykluczanie określonych przejściowych zależności, które mogą powodować konflikt z innymi zainstalowanymi bibliotekami.

W przypadku pakietów języka R z usługi CRAN podaj nazwę pakietu. W przeciwieństwie do bibliotek języków Python i Java, instalacje CRAN zawsze pobierają najnowszą wersję ze skonfigurowanego lustra. Aby przypiąć określone wersje pakietów języka R, należy przechowywać pliki pakietu w plikach lub woluminach obszaru roboczego zamiast instalować z poziomu usługi CRAN.
W przypadku klastrów skonfigurowanych w standardowym trybie dostępu współrzędne narzędzia Maven i ścieżki plików JAR wymagają allowlist zatwierdzenia przed instalacją. Ta miara zabezpieczeń zapewnia administratorom przeglądanie i zatwierdzanie bibliotek uruchamianych w udostępnionych zasobach obliczeniowych.
Uwaga / Notatka
Aby dowiedzieć się więcej na temat konfigurowania bibliotek i zarządzania nimi allowlists , zobacz dokumentację.
Instalowanie bibliotek z plików
Przechowywanie plików biblioteki w plikach obszaru roboczego lub woluminach w katalogu Unity zapewnia dokładną kontrolę nad używanymi wersjami bibliotek. Takie podejście działa dobrze, kiedy potrzebujesz bibliotek niedostępnych w repozytoriach publicznych, niestandardowych pakietów, które sami opracowaliście wewnętrznie, lub konkretnych wersji, które nie są już dostępne w repozytoriach pakietów.
Używanie plików obszarów roboczych i woluminów Unity Catalog do instalacji bibliotek utrzymuje scentralizowane zarządzanie zamiast pomijania mechanizmów kontroli zabezpieczeń przy pomocy instalacji ad hoc, takich jak bezpośrednie użycie poleceń pip3 lub niezarządzanych niestandardowych skryptów wykonywanych z notesów. Woluminy Unity Catalogu zapewniają ulepszony nadzór dzięki modelowi kontroli dostępu Unity Catalogu, zapewniając śledzenie wszystkich instalacji bibliotek za pomocą dzienników audytowych oraz ochronę poprzez szczegółowe uprawnienia.
Pliki obszaru roboczego zapewniają wygodną lokalizację dla magazynu biblioteki z limitem rozmiaru pliku o rozmiarze 500 MB. Aby zainstalować bibliotekę z plików obszaru roboczego, prześlij plik Wheel, JAR lub requirements.txt za pomocą okna dialogowego Importowanie obszaru roboczego, a następnie odwołaj się do niego podczas instalacji biblioteki przy użyciu ścieżki, takiej jak /Workspace/Users/you@example.com/libraries/mypackage-1.0.0-py3-none-any.whl.

Woluminy katalogu Unity oferują zwiększone zabezpieczenia i lepsze zarządzanie dla przechowywania bibliotek. Dostęp można kontrolować za pomocą uprawnień Unity Catalog, zapewniając, że tylko autoryzowani użytkownicy mogą odczytywać lub modyfikować pliki biblioteki. Prześlij pliki do wolumenu za pomocą Eksploratora Katalogu, a następnie zainstaluj je przy użyciu ścieżki, takiej jak /Volumes/main/engineering/libraries/mypackage-1.0.0-py3-none-any.whl. Tożsamość używana do instalacji musi mieć uprawnienie do odczytu woluminu na określonym woluminie.

Pliki requirements.txt języka Python działają zarówno z plikami obszaru roboczego, jak i woluminami w czasie wykonywania Databricks Runtime 15.0 lub nowszym. Te pliki umożliwiają zdefiniowanie wielu zależności pakietów w jednym pliku, co ułatwia zachowanie spójnych środowisk w klastrach. Przekaż plik requirements.txt i zainstaluj go tak samo jak każda inna biblioteka — usługa Azure Databricks automatycznie instaluje wszystkie wymienione pakiety.
W przypadku klastrów ze standardowym trybem dostępu należy dodać ścieżki plików biblioteki do allowlist przed instalacją. Dotyczy to zarówno plików przestrzeni roboczej, jak i woluminów, umożliwiając administratorom zatwierdzenie bibliotek używanych w obliczeniach współdzielonych.
Używanie skryptów init do konfiguracji zaawansowanej
Skrypty inicjowania uruchamiają polecenia powłoki podczas uruchamiania klastra przed uruchomieniem sterownika Spark i funkcji wykonawczych. Chociaż usługa Databricks nie zaleca używania skryptów inicjowania do instalacji bibliotek — biblioteki o zakresie klastra zapewniają lepsze podejście — skrypty inicjowania są przydatne do konfiguracji na poziomie systemu, której biblioteki nie mogą obsłużyć.
Skrypty inicjowania mogą służyć do instalowania pakietów systemowych z apt-get, konfigurowania zmiennych środowiskowych lub ustawiania agentów monitorowania. Na przykład skrypt inicjowania może zainstalować wyspecjalizowany sterownik bazy danych, który wymaga bibliotek systemowych, a następnie skonfigurować parametry połączenia za pomocą zmiennych środowiskowych. Skrypt jest uruchamiany za każdym razem, gdy klaster jest uruchamiany, zapewniając, że konfiguracja będzie się powtarzać po ponownym uruchomieniu.
Przechowuj skrypty inicjujące w woluminach Unity Catalog dla klastrów działających na Databricks Runtime 13.3 LTS lub nowszym. Utwórz plik skryptu powłoki, prześlij go do woluminu, a następnie skonfiguruj klaster do uruchomienia skryptu, określając jego ścieżkę tak jak /Volumes/main/engineering/scripts/setup.sh. W przypadku trybu dostępu standardowego dodaj ścieżkę skryptu inicjalizacyjnego do allowlist przed skonfigurowaniem klastra.
Skrypty inicjowania są wykonywane sekwencyjnie w określonej kolejności. Jeśli jakikolwiek skrypt zwraca kod zakończenia inny niż zero, nie można uruchomić klastra. Ta ochrona po awarii uniemożliwia uruchamianie klastrów z niekompletną lub niepoprawną konfiguracją. Możesz rozwiązać problemy ze skryptami inicjowania zakończonymi niepowodzeniem, konfigurując dostarczanie dzienników klastra i sprawdzając dzienniki skryptów inicjowania.
Rozważ użycie skryptów inicjalizacyjnych jako ostatecznego rozwiązania dla potrzeb konfiguracji, których nie można obsłużyć za pomocą bibliotek o zakresie klastra i zasad klastra. Używanie zasad klastra do ustawiania zmiennych środowiskowych i konfiguracji platformy Spark często zapewnia prostsze, bardziej obsługiwane rozwiązanie niż skrypty inicjowania.
Konfigurowanie bibliotek dla standardowego trybu dostępu
Klastry skonfigurowane w standardowym trybie dostępu zapewniają najsilniejsze zabezpieczenia i izolację w usłudze Azure Databricks. Ten tryb wymaga jawnego zatwierdzenia bibliotek i skryptów inicjowania, aby zapobiec nieautoryzowanemu wykonywaniu kodu w udostępnionych zasobach obliczeniowych.
Przed zainstalowaniem bibliotek Maven lub plików JAR w klastrach trybu dostępu standardowego administrator magazynu metadanych musi dodać je do klastra allowlist. Współrzędne Maven są umieszczane na allowlist przy użyciu formatu groupId:artifactId:version. Wszystkie wersje biblioteki możesz zarządzać za pomocą allowlist, a wszystkie artefakty w grupie za pomocą groupId:artifactId mogą być zarządzane jednym poleceniem groupId. W przypadku plików JAR przechowywanych w woluminach lub przechowywaniu obiektów, allowlist ścieżka pliku lub ścieżka katalogu.
Skrypty inicjowania wymagają oddzielnych allowlist wpisów, nawet jeśli są przechowywane w tej samej lokalizacji co pliki JAR. Jeśli dopisujesz ścieżkę do listy dozwolonych, usługa Azure Databricks używa dopasowywania prefiksów — dodanie /Volumes/prod-libraries/ do allowlist zezwala na wszystkie pliki i podkatalogi w tej lokalizacji. Dołącz ukośnik końcowy, aby zapobiec niezamierzonym dopasowaniom prefiksu na poziomie katalogu.
allowlist przyznaje tylko pozwolenie na używanie ścieżki do instalacji biblioteki lub skryptu inicjalizacyjnego. Nadal potrzebujesz odpowiednich uprawnień dostępu do danych. W przypadku woluminów tożsamość instalatora musi mieć uprawnienia READ VOLUME. W przypadku trybu dostępu standardowego tożsamość właściciela klastra weryfikuje te uprawnienia podczas instalacji biblioteki.
Aby skonfigurować program allowlist, administratorzy magazynu metadanych używają Eksploratora katalogu, wybierając ustawienia magazynu metadanych i przechodząc do sekcji Dozwolone pliki JAR/skrypty inicjalizacyjne. Ta scentralizowana kontrola zapewnia, że zespoły ds. zabezpieczeń mogą przeglądać i zatwierdzać wszystkie biblioteki używane w zasobach obliczeniowych organizacji, zachowując ład bez blokowania produktywności.

Wybieranie właściwej metody instalacji
Różne metody instalacji biblioteki odpowiadają różnym scenariuszom. Na poniższym diagramie przedstawiono przepływ decyzji, który ułatwia wybranie odpowiedniego podejścia do instalacji:
