Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Esta página explica como gerenciar o acesso à computação sem servidor e como implementar limites de taxa para ambientes sem servidor. Administradores do espaço de trabalho gerenciam a computação serverless por meio de objetos integrados de computação serverless. Um objeto de computação sem servidor é um tipo de recurso que define o limite de permissão para cargas de trabalho sem servidor. Seu workspace obtém automaticamente dois objetos de computação padrão:
- Computação interativa padrão: rege o acesso aos notebooks e ao Databricks Connect.
- Computação Automatizada Padrão: controla o acesso a tarefas e Pipelines Declarativos do Spark no Lakeflow.
Por padrão, todos os usuários do workspace podem usar em ambos os objetos, de modo que as cargas de trabalho existentes continuam a ser executadas sem alterações. Um administrador de workspace pode remover usuários ou grupos de qualquer objeto para restringir o acesso. Um usuário que perde o acesso verá a opção de computação sem servidor como indisponível em suas superfícies de produto.
Gerenciar o acesso à computação sem servidor
Para controlar quem tem acesso à computação sem servidor, os administradores do workspace podem editar as permissões nos objetos de Computação Interativa Padrão e Computação Automatizada Padrão . Os administradores do workspace têm a permissão Pode Gerenciar por padrão, mas podem conceder a permissão a qualquer usuário. Esses objetos de computação padrão não podem ser renomeados ou excluídos.
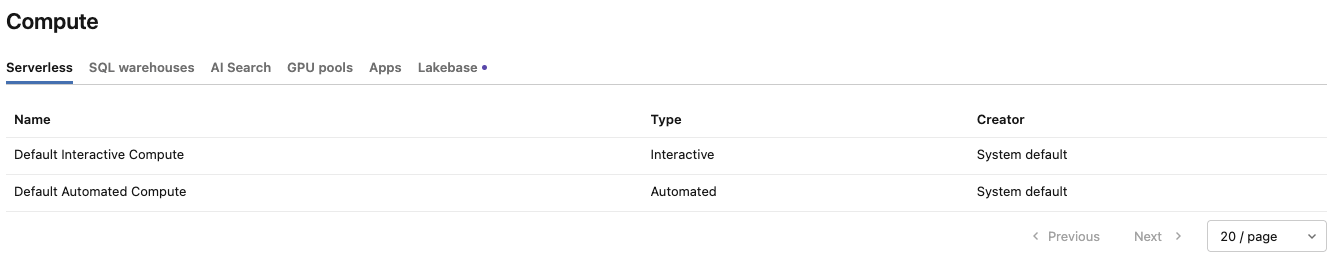
Cada objeto de computação sem servidor dá suporte a dois níveis de permissão:
| Permissão | Permite que você |
|---|---|
| Pode usar | Executar cargas de trabalho nesta computação |
| Pode gerenciar | Executar cargas de trabalho nessa computação e editar as permissões da computação |
Você também pode gerenciar permissões para objetos computacionais serverless usando a API de Permissões. Objetos de computação serverless usam o tipo de serverless-compute objeto, e cada objeto é identificado por seu ID.
Restringir o acesso a interativo sem servidor
Para limitar quem pode usar infraestrutura sem servidor para notebooks e Databricks Connect:
- Clique em Computação na barra lateral do workspace.
- Na guia Serverless, clique no menu kebab
 ao lado de Computação interativa padrão e, em seguida, clique em Editar permissões.
- Remova o grupo Todos os Usuários ou o grupo que inclui todos os usuários do workspace.
- Adicione apenas os usuários, grupos ou entidades de serviço específicos que você deseja autorizar.
Se você revogar as permissões interativas da infraestrutura sem servidor de um usuário, os notebooks já anexados a ela não conseguirão se conectar quando ele executar uma célula, e o usuário não verá mais a opção Sem servidor como disponível no seletor de computação do notebook. Se eles tentarem executar o Databricks Connect, a solicitação de conexão falhará com um erro indicando que o usuário não tem acesso à infraestrutura sem servidor.
Restringir o acesso a pipelines e trabalhos sem servidor
Para limitar quem pode usar sem servidor em trabalhos e pipelines:
- Clique em Computação na barra lateral do workspace.
- Na guia Sem servidor, clique no menu kebab ao lado de Computação automatizada padrão e, em seguida, clique em Editar permissões.
- Remova o grupo Todos os Usuários ou o grupo que inclui todos os usuários do workspace.
- Adicione apenas os usuários, grupos ou entidades de serviço específicos que você deseja autorizar.
Se você revogar as permissões automatizadas para serverless de um usuário, todos os jobs ou pipelines existentes desse usuário em execução no serverless deixarão de ser executados. O usuário verá uma mensagem de erro se tentar executar um trabalho sem servidor.
Antes de revogar o acesso de um usuário à Computação Automatizada Padrão, audite quais trabalhos e pipelines os usuários afetados possuem. A consulta a seguir identifica cargas de trabalho recentes sem servidor para um usuário específico:
SELECT *
FROM system.billing.usage
WHERE usage_date >= date_add(now(), -30)
  AND billing_origin_product IN ('JOBS', 'DLT')
  AND identity_metadata.run_as = '<user_email>';
Verifique a coluna usage_metadata para identificar os recursos afetados, como IDs de trabalho e IDs de pipeline.
Auditar o uso sem servidor
Entre os registros de faturamento sem servidor está um campo serverless_compute_id em usage_metadata. Use-o para rastrear em qual objeto de computação uma carga de trabalho foi executada:
SELECT
  usage_metadata.serverless_compute_id,
  identity_metadata.run_as,
  SUM(usage_quantity) AS total_dbus
FROM system.billing.usage
WHERE billing_origin_product IN ('JOBS', 'DLT', 'INTERACTIVE')
  AND usage_metadata.serverless_compute_id IS NOT NULL
  AND usage_date >= date_add(now(), -30)
GROUP BY 1, 2
ORDER BY 3 DESC;
Recursos compatíveis de controle de acesso para computação sem servidor
Os recursos a seguir se integram aos controles de acesso da computação sem servidor.
Interativo (Computação Interativa Padrão)
- Notebooks e notebooks de GPU sem servidor
- Databricks Connect
Automatizado (Computação Automatizada Padrão)
- Tarefas e tarefas de GPU sem servidor
- Pipelines Declarativos do Spark no Lakeflow
Recursos de controle de acesso à computação sem servidor não compatíveis
Os seguintes recursos não estão integrados aos controles de acesso à computação sem servidor:
- Databricks SQL (DBSQL)
- Inferência em lote (
ai_query()) - Serviço de Modelo
- Pontos de extremidade de taxa de transferência provisionados da API do Modelo de Base
- Lakebase
- Aplicativos do Databricks
- Avaliação de agente e dados sintéticos
- Indexação da busca vetorial
- Otimização preditiva
- Monitoramento do Lakehouse
- Controle de acesso detalhado em computação dedicada. O acesso ao computo dedicado determina se um usuário pode usar controle de acesso detalhado.
Para qualquer recurso não listado aqui, entre em contato com sua equipe de conta Azure Databricks para perguntar sobre seu status.
Limitações do controle de acesso serverless
Important
Em caso de interrupção do serviço, as verificações de acesso podem falhar na abertura, e usuários que, de outra forma, teriam acesso negado podem iniciar cargas de trabalho sem servidor. Esse recurso tem como objetivo ajudar a governar o acesso à computação serverless. Não use esse recurso para garantir um limite absoluto de gasto nos valores finais faturados. O Azure Databricks não se responsabiliza pelos custos incorridos por cargas de trabalho que rodam durante tal evento.
- Você não pode renomear ou excluir objetos de computação padrão.
- Um trabalho ou pipeline já configurado para ser executado em modo sem servidor falha para qualquer usuário que perder o acesso Can Use à Computação Automatizada Padrão. Examine as cargas de trabalho ativas antes de remover o acesso de um usuário.
- A computação em segundo plano (trabalhos iniciados pelo sistema) é isenta de controles de acesso de computação sem servidor.
Defina limites de taxa para computação sem servidor
Important
Os limites de taxa estão no Private Preview. Para ingressar nesta versão prévia, entre em contato com sua equipe de conta do Azure Databricks. Após ingressar na versão prévia, os administradores do espaço de trabalho podem habilitá-la na página Prévias usando a configuração Limite de taxa de computação sem servidor.
Um limite de taxa limita quanto uma carga de trabalho automatizada pode gastar, limitando até onde ela pode escalar automaticamente. Administradores de workspace podem criar objetos de computação automatizados personalizados e atribuir a cada um um limite de taxa. Quando uma carga de trabalho roda em um objeto de computação que possui limite de taxa, o escalonador automático serverless não escala os executores Spark da carga além do tamanho definido no objeto.
Os limites de taxa aplicam-se apenas a cargas de trabalho automatizadas (jobs e Spark Declarative Pipelines no Lakeflow). Cargas de trabalho interativas (notebooks e Databricks Connect) não estão sujeitas a limitação de taxa.
Um limite de taxa é expresso como tamanho. Cada tamanho corresponde a um limite aproximado de DBUs que uma carga de trabalho pode consumir por hora. A limitação de taxa restringe apenas o escalonamento automático dos executores do Spark. Ele não impõe limite a outros componentes de uma carga de trabalho, como o driver, VMs de REPL, GPUs ou atualizações de exibições materializadas e de tabelas de streaming.
O limite de taxa se aplica por carga de trabalho. Cada trabalho e cada pipeline que utiliza um objeto de computação são limitados de forma independente. Dois trabalhos que usam o mesmo objeto de computação recebem cada um o limite máximo. Dentro de um único job, o limite é compartilhado entre todas as tarefas desse job.
Requisitos de limite de taxa
- Para criar e gerenciar objetos computacionais serverless, você deve ser administrador de workspace ou usuário com criação de cluster sem restrições.
- Os limites de taxa sem servidor exigem o Azure Databricks Runtime 17.3.1 ou posterior. As tarefas usam automaticamente o ambiente de execução mais recente. Para Spark Declarative Pipelines no Lakeflow, opte pelo runtime do canal de prévia (preview channel).
Crie uma computação sem servidor com limite de requisições
- Clique em Computação na barra lateral do workspace.
- Na aba Serverless , clique em Criar computação serverless.
- Insira um nome.
- Para Tamanho, selecione o limite de taxa a aplicar, de Pequeno a 2X Grande. Deixe definido como Default para usar o limite padrão do seu espaço de trabalho.
- Clique em Criar.

O novo objeto de computação aparece na aba Serverless com o tipo Automatizado. Para permitir que os usuários executem cargas de trabalho nesse recurso, conceda a eles as permissões Can Use ou Can Manage, conforme descrito em Gerenciar acesso à computação sem servidor. Você não pode editar o tamanho de um objeto de computação padrão.
Tamanhos dos limites de taxa
Cada tamanho corresponde a um limite aproximado de DBUs por hora:
| Tamanho | Limite aproximado |
|---|---|
| Pequeno | ~60 DBUs por hora |
| Medium | ~120 DBUs por hora |
| Grande | ~240 DBUs por hora |
| Extra Grande | ~480 DBUs por hora |
| 2X-Large | ~960 DBUs por hora |
Esses limites máximos são limiares direcionais. O uso real pode oscilar em torno deles devido à variabilidade inerente da infraestrutura serverless.
Escolher Padrão aplica o limite padrão do seu espaço de trabalho: Médio para espaços de trabalho de nível premium, ou Grande para espaços de trabalho de nível corporativo. Esses limites correspondem aos limites máximos padrão de autoescalonamento existentes para cargas de trabalho automatizadas sem servidor.
Execute uma carga de trabalho em recursos de computação com limitação de taxa
Um usuário com a permissão Pode usar em um objeto de computação pode selecioná-lo ao configurar um job ou pipeline. A carga de trabalho então é executada dentro do limite de taxa do recurso computacional. Se uma carga de trabalho não especificar um objeto de computação, ela volta para o Cálculo Automatizado Padrão do seu workspace. Se o usuário não tiver acesso a esse padrão, a carga de trabalho não executa.
- Jobs: Selecione o objeto de computação sem servidor no nível do job, seja nas configurações de Computação do job na interface do usuário ou fazendo referência ao ID do recurso de computação na API de Jobs. Para copiar o ID, abra o objeto de computação na aba Serverless e clique em Copiar ID de computação.
- Pipelines Declarativos Spark no Lakeflow: selecione o objeto de computação automatizada como a computação sem servidor para um pipeline no editor do Lakeflow.
Quando um limite de taxa restringe uma carga de trabalho, você pode visualizar o impacto no histórico de consultas da carga de trabalho ou, no caso de pipelines, na interface do usuário do Lakeflow.
Limitações de limite de taxa
- Os limites de taxa restringem apenas o escalonamento automático dos executores do Spark. Outros componentes de custo, como o driver, VMs REPL, GPUs e atualizações de visualizações materializadas ou de tabelas de streaming, não têm limite.
- O limite de DBU por hora para cada tamanho é uma estimativa. O uso real pode exceder a meta devido a flutuações modestas no limite aplicado e à variabilidade inerente da infraestrutura serverless.
- Uma carga de trabalho no tamanho 2X-Large pode ter desempenho abaixo do esperado porque o tamanho físico do cluster é limitado a 256 executores. Se duas ou mais cargas de trabalho 2X-Large forem agendadas no mesmo cluster de runtime, cada uma pode atingir desempenho inferior ao esperado.
- Devido a detalhes de implementação do faturamento, a mesma carga de trabalho pode resultar em um consumo de DBU diferente sob diferentes limites de taxa.
- Você não pode definir um limite de taxa em um objeto de computação padrão.