Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
A execução de consulta adaptável (AQE) é a reotimização de consulta que ocorre durante a execução de consulta.
A motivação para a nova otimização do runtime é que o Azure Databricks tem as estatísticas precisas mais atualizadas no final de uma troca de ordem aleatória e de difusão (chamado de fase de consulta na AQE). Como resultado, o Azure Databricks pode optar por uma estratégia física melhor, escolher o tamanho e o número da partição de ordem aleatória ideal, ou as otimizações usadas para exigir dicas, por exemplo, processamento de junção de inclinação.
Isso pode ser muito útil quando a coleta de estatísticas não está ativada ou quando as estatísticas estão obsoletas. Também é útil em locais em que estatísticas derivadas estaticamente são imprecisas, como no meio de uma consulta complicada ou após a ocorrência de distorção de dados.
Capacidades
O AQE está habilitado por padrão. Ela tem quatro recursos principais:
- Altera dinamicamente a junção de mesclagem de classificação na junção hash de difusão.
- Une partições dinamicamente (combine partições pequenas em partições de tamanho razoável) após a troca em ordem aleatória. Tarefas muito pequenas têm pior taxa de transferência de E/S e tendem a sofrer mais com sobrecarga de agendamento e sobrecarga de instalação de tarefas. A combinação de pequenas tarefas salva recursos e melhora a taxa de transferência do cluster.
- Processa dinamicamente a distorção em classificar junção de mesclagem e junção hash aleatória dividindo (e replicando se necessário) tarefas distorcidas em tarefas de tamanho quase uniforme.
- Detecta e propaga dinamicamente as relações vazias.
Aplicação
A AQE aplica-se a todas as consultas:
- Não streaming
- Que contêm pelo menos uma troca (geralmente, quando há uma junção, agregação ou janela), uma subconsulta ou ambas.
Nem todas as consultas aplicadas à AQE são necessariamente otimizadas de novo. A otimização pode ou não criar um plano de consulta diferente do compilado estaticamente. Para determinar se o plano de uma consulta foi alterado pelo AQE, consulte a seção a seguir, Planos de consulta.
Planos de consultas
Esta seção discute como você pode examinar os planos de consulta de diferentes maneiras.
Nesta seção:
Interface do usuário do Spark
AdaptiveSparkPlan nodo
As consultas aplicadas à AQE contêm um ou mais nós AdaptiveSparkPlan, geralmente como o nó raiz de cada consulta principal ou subconsulta.
Antes que a consulta seja executada ou quando ela estiver em execução, o isFinalPlan sinalizador do nó correspondente AdaptiveSparkPlan será exibido como false; depois que a execução da consulta for concluída, o isFinalPlan sinalizador será alterado para true.
Plano em evolução
O diagrama do plano de consulta evolui à medida que a execução progride e reflete o plano mais atual que está sendo executado. Os nós que já foram executados (nos quais há métricas disponíveis) não serão alterados, mas aqueles que não podem mudar ao longo do tempo como resultado de reotimizações.
Veja a seguir um exemplo de diagrama de plano de consulta:

DataFrame.explain()
AdaptiveSparkPlan nodo
As consultas aplicadas à AQE contêm um ou mais nós AdaptiveSparkPlan, geralmente como o nó raiz de cada consulta principal ou subconsulta. Antes que a consulta seja executada ou quando ela estiver em execução, o isFinalPlan sinalizador do nó correspondente AdaptiveSparkPlan será exibido como false; depois que a execução da consulta for concluída, o isFinalPlan sinalizador será alterado para true.
Plano atual e inicial
Em cada nó AdaptiveSparkPlan, haverá o plano inicial (o plano antes de aplicar qualquer otimização da AQE) e o plano atual ou final, dependendo se a execução foi concluída. O plano atual evoluirá conforme a execução progride.
Estatísticas de runtime
Cada estágio de difusão e ordem aleatória contém estatísticas de dados.
Antes da execução do estágio ou quando o estágio está em execução, as estatísticas são estimativas de tempo de compilação e o sinalizador isRuntime é false, por exemplo: Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false);
Após a conclusão da execução do estágio, as estatísticas são as coletadas em runtime e o sinalizador isRuntime se tornará true, por exemplo: Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true)
Veja a seguir um DataFrame.explain exemplo:
Antes da execução

Durante a execução

Após a execução

SQL EXPLAIN
AdaptiveSparkPlan nodo
As consultas aplicadas à AQE contêm um ou mais nós AdaptiveSparkPlan, geralmente como o nó raiz de cada consulta principal ou subconsulta.
Nenhum plano atual
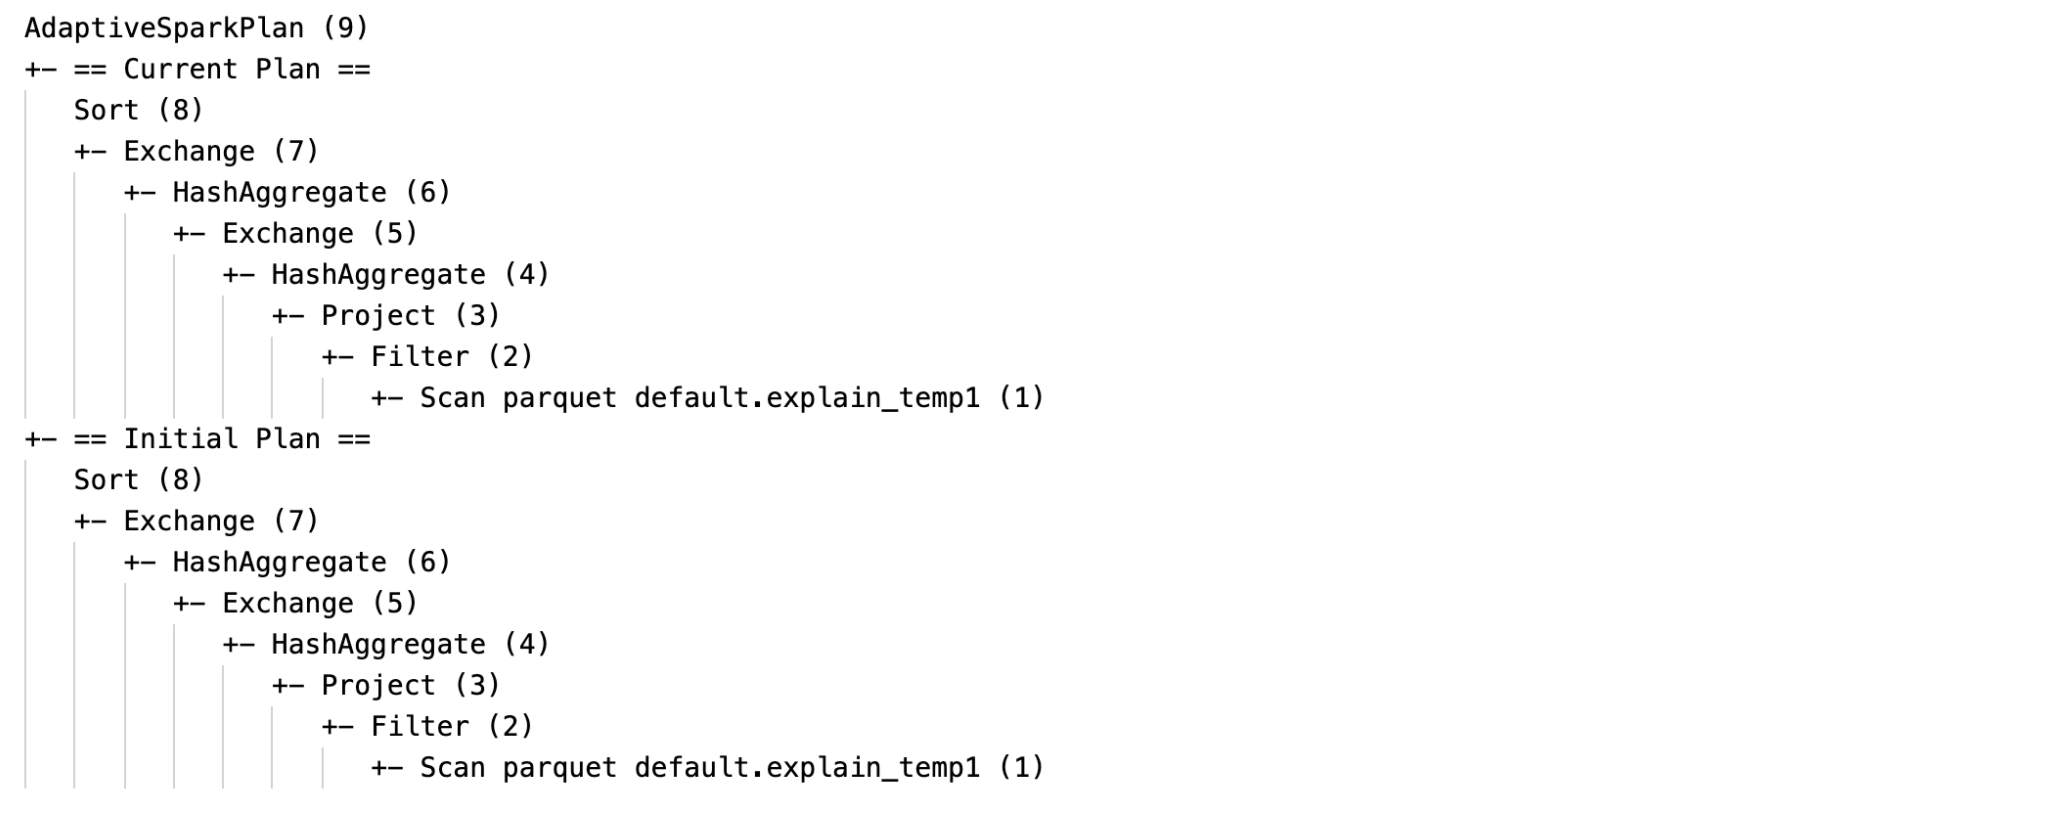
Como SQL EXPLAIN não executa a consulta, o plano atual é sempre o mesmo que o plano inicial e não reflete o que eventualmente seria executado pelo AQE.
Veja a seguir um exemplo de explicação do SQL:
Eficácia
O plano de consulta será alterado se uma ou mais otimizações do AQE entrarem em vigor. O efeito dessas otimizações do AQE é demonstrado pela diferença entre os planos atuais e finais e o plano inicial e os nós de plano específicos nos planos atuais e finais.
Alterar dinamicamente a junção de mesclagem de classificação em junção hash de difusão: nós de junção físicas diferentes entre o plano atual/final e o plano inicial

Unir partições dinamicamente: nó
CustomShuffleReadercom a propriedadeCoalesced

Processar dinamicamente a junção de inclinação: nó
SortMergeJoincom o campoisSkewcomo true.

Detectar e propagar dinamicamente as relações vazias: parte de (ou todo) o plano é substituído pelo nó LocalTableScan com o campo de relação como vazio.


Configuração
Nesta seção:
- Habilitar e desabilitar a execução de consulta adaptável
- Habilitar o embaralhamento otimizado automaticamente
- Altera dinamicamente a junção de mesclagem de classificação na junção hash de difusão
- Unir partições dinamicamente
- Manipular dinamicamente a junção de distorção
- Detectar e propagar dinamicamente relações vazias
Habilitar e desabilitar a execução de consulta adaptável
| Propriedade |
|---|
|
spark.databricks.optimizer.adaptive.enabled Tipo: BooleanSe deseja habilitar ou desabilitar a execução de consulta adaptável. Valor padrão: true |
Habilitar a ordem aleatória otimizada automaticamente
| Propriedade |
|---|
|
spark.sql.shuffle.partitions Tipo: IntegerO número padrão de partições a serem usadas ao embaralhar dados para junções ou agregações. A configuração do valor auto habilita a ordem aleatória com otimização automática, que determina automaticamente esse número com base no plano de consulta e no tamanho dos dados de entrada da consulta.Observação: para Streaming Estruturado, essa configuração não pode ser alterada entre reinicializações de consulta do mesmo local de ponto de verificação. Valor padrão: 200 |
Alterar dinamicamente a junção de mesclagem de classificação em junção hash de difusão
| Propriedade |
|---|
|
spark.databricks.adaptive.autoBroadcastJoinThreshold Tipo: Byte StringO limite para disparar a alternância para a junção de difusão em runtime. Valor padrão: 30MB |
Unir partições dinamicamente
| Propriedade |
|---|
|
spark.sql.adaptive.coalescePartitions.enabled Tipo: BooleanIndica se a união de partição deve ser habilitada ou desabilitada. Valor padrão: true |
|
spark.sql.adaptive.advisoryPartitionSizeInBytes Tipo: Byte StringO tamanho do destino após a união. Os tamanhos de partição unificados estarão próximos, mas não maiores do que o tamanho alvo. Valor padrão: 64MB |
|
spark.sql.adaptive.coalescePartitions.minPartitionSize Tipo: Byte StringO tamanho mínimo das partições após a coalescagem. Os tamanhos das partições combinadas não devem ser menores que este tamanho. Valor padrão: 1MB |
|
spark.sql.adaptive.coalescePartitions.minPartitionNum Tipo: IntegerO número mínimo de partições após a coalescagem. Não recomendado, porque a configuração o substitui explicitamente spark.sql.adaptive.coalescePartitions.minPartitionSize.Valor padrão: 2x número de núcleos do cluster |
Manipular dinamicamente a junção de distorção
| Propriedade |
|---|
|
spark.sql.adaptive.skewJoin.enabled Tipo: BooleanIndica se o processamento de junção de distorção deve ser habilitado ou desabilitado. Valor padrão: true |
|
spark.sql.adaptive.skewJoin.skewedPartitionFactor Tipo: IntegerUm fator que, quando multiplicado pelo tamanho médio da partição, contribui para determinar se uma partição é distorcida. Valor padrão: 5 |
|
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes Tipo: Byte StringUm limite que contribui para determinar se uma partição é distorcida. Valor padrão: 256MB |
Uma partição é considerada distorcida quando ambas (partition size > skewedPartitionFactor * median partition size) e (partition size > skewedPartitionThresholdInBytes) são true.
Detectar e propagar dinamicamente relações vazias
| Propriedade |
|---|
|
spark.databricks.adaptive.emptyRelationPropagation.enabled Tipo: BooleanIndica se a propagação de relação vazia dinâmica deve ser habilitada ou desabilitada. Valor padrão: true |
Perguntas frequentes (FAQ)
Nesta seção:
- Por que a AQE não transmitiu uma pequena tabela de junção?
- Ainda devo usar uma dica de estratégia de junção de difusão com a AQE habilitada?
- Qual é a diferença entre a dica de junção de distorção e a otimização de junção de distorção da AQE? Qual delas devo utilizar?
- Por que a AQE não ajusta minha ordenação de junção automaticamente?
- Por que o AQE não detectou minha distorção de dados?
Por que a AQE não transmitiu uma pequena tabela de junção?
Se o tamanho da relação que se espera que seja transmitida estiver abaixo desse limite, mas ainda assim não for transmitida:
- Verifique o tipo de junção. Não há suporte para a transmissão para determinados tipos de junção, por exemplo, a relação à esquerda de um
LEFT OUTER JOINnão pode ser transmitida. - Também pode ser que a relação contenha muitas partições vazias; nesse caso, a maioria das tarefas pode ser concluída rapidamente com a junção de mesclagem de classificação ou potencialmente pode ser otimizada com manipulação de junção de distorção. A AQE evitará alterar essas junções de mesclagem de classificação para junções de hash de difusão se o percentual de partições não vazias for menor que
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Ainda devo usar uma dica de estratégia de junção de difusão com a AQE habilitada?
Sim. Uma junção de difusão planejada estaticamente geralmente é mais bem-desempenho do que uma planejada dinamicamente pelo AQE, pois o AQE pode não mudar para a junção de difusão até depois de executar o embaralhamento para ambos os lados da junção (quando os tamanhos reais da relação são obtidos). Portanto, usar uma dica de difusão ainda poderá ser uma boa opção se você conhecer bem a consulta. O AQE respeitará as dicas de consulta da mesma maneira que a otimização estática, mas ainda pode aplicar otimizações dinâmicas que não são afetadas pelas dicas.
Qual é a diferença entre a dica de junção de distorção e a otimização de junção de distorção da AQE? Qual delas devo utilizar?
É recomendável contar com o tratamento de junção de distorção da AQE em vez de usar a dica de junção de distorção, pois a junção de distorção da AQE é completamente automática e, em geral, tem um desempenho melhor do que a contraparte de dica.
Por que a AQE não ajusta minha ordenação de junção automaticamente?
A reordenação dinâmica de junções não faz parte da AQE.
Por que o AQE não detectou minha distorção de dados?
Há duas condições de tamanho que devem ser satisfeitas para que o AQE detecte uma partição como uma partição distorcida:
- O tamanho da partição é maior que o
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(padrão de 256 MB) - O tamanho da partição é maior que o tamanho mediano de todas as partições vezes o fator
spark.sql.adaptive.skewJoin.skewedPartitionFactorde partição distorcido (padrão 5)
Além disso, o manuseio de distorções AQE só se aplica a junções baseadas em aleatoriedade (classificar junções de mesclagem e embaralhar junções de mesclagem). As junções de difusão jamais são otimizadas para distorção. Para as junções suportadas, o tipo de junção determina qual lado o AQE pode otimizar:
| Tipo de junção | Inclinação otimizada no lado esquerdo | Inclinação otimizada no lado direito |
|---|---|---|
INNER |
Sim | Sim |
CROSS |
Sim | Sim |
LEFT OUTER |
Sim | Não |
RIGHT OUTER |
Não | Sim |
LEFT SEMI |
Sim | Não |
LEFT ANTI |
Sim | Não |
FULL OUTER |
Não | Não |
Por exemplo, em um LEFT OUTER JOIN, apenas a inclinação no lado esquerdo pode ser otimizada, e um FULL OUTER JOIN não tem otimização de inclinação em nenhum dos lados.
Legado
O termo "Execução Adaptável" existe desde o Spark 1.6, mas o novo AQE no Spark 3.0 é fundamentalmente diferente. Em termos de funcionalidade, o Spark 1.6 faz apenas a parte "união dinâmica de partições". Em termos de arquitetura técnica, o novo AQE é uma estrutura de planejamento dinâmico e replanificação de consultas com base em estatísticas de runtime, que dá suporte a uma variedade de otimizações, como as que descrevemos neste artigo e pode ser estendida para habilitar mais otimizações potenciais.