Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Importante
O Treinamento Programado requer aprovação de acesso explícita. Solicite acesso por meio do formulário de inscrição para preview e aguarde a aprovação antes de criar uma sessão de treinamento.
Use essa folha de referências para mapear o loop de treinamento para as funções e parâmetros do SDK do Python no Microsoft Foundry. Os exemplos se concentram na API de FineTuningSession conveniência síncrona. Clientes assíncronos e wrappers de livro de receitas usam diferentes interfaces e padrões de conclusão.
Prerequisites
- Concluir a instalação, a autenticação e a configuração de acesso.
- Use
azure-ai-finetuningsessions==1.0.0b1a versão de visualização pública instalada pelo livro de receitas. - A função de Usuário do Foundry para treinamento ou a função Proprietário do Foundry se você também implantar o modelo ajustado. Consulte o controle de acesso baseado em função para Microsoft Foundry.
- Selecione um modelo qualificado e uma configuração de adaptador com suporte. Prepare tokens com seu tokenizador correspondente e modelo de chat.
- Defina e confirme
AZURE_AI_PROJECT_ENDPOINTum orçamento de treinamento aprovado. Criar uma sessão e executar operações de treinamento ou amostragem pode incorrer em encargos.
Os métodos de conveniência de treinamento, amostragem e ponto de verificação aguardam os resultados da operação. Operações brutas e auxiliares assíncronos têm diferentes tipos de retorno e comportamento de conclusão; use a referência completa do SDK para essas interfaces.
Os exemplos usam o SDK síncrono, a menos que rotulado de outra forma. Prepare as funções auxiliares uma vez e execute as operações dentro with open_session() as session:. Usar dados tokenizados reais; os snippets não fornecem um conjunto de dados nem implementam um algoritmo de treinamento completo.
Ajuste fino supervisionado
O SFT (ajuste fino supervisionado) treina em prompts e respostas desejadas.
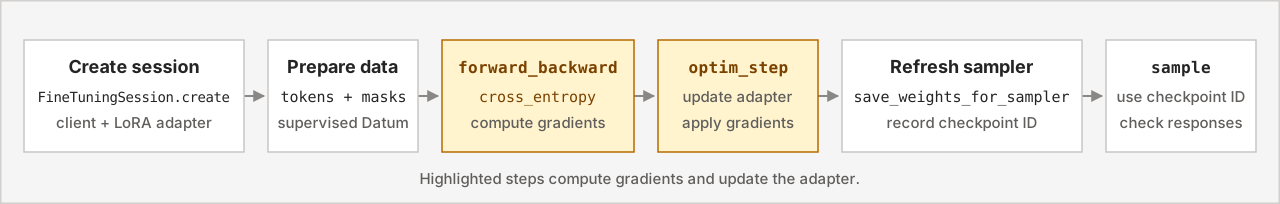
A sequência é criar > o ponto de verificação de avaliação > da etapa > de avaliação de dados > supervisionados para frente/para trás>. A amostragem não é necessária para cada lote supervisionado.
Aprendizado de reforço
O RL (aprendizado de reforço) treina de respostas de modelo pontuadas.

A sequência é criar > o sampler > de atualização que coleta recompensas > de computação e vantagens > da etapa do otimizador para frente/para trás>. Repita da atualização do sampler para coletar respostas da política atualizada.
Agrupamento, classificação e computação de vantagem pertencem ao driver, não a um algoritmo de treinamento automático do SDK. Para obter exemplos de treinamento completos, explore o repositório de exemplos de ajuste fino.
Criar uma sessão
FineTuningSessionClient conecta-se ao seu projeto usando um endpoint e credential.
FineTuningSession.create inicializa um modelo e um adaptador e inicia a pulsação da sessão.
Esse auxiliar autentica com DefaultAzureCredential, cria uma sessão e a descarrega quando seu contexto é encerrado. Use o modelo aprovado e a classificação lora. O escopo de credencial explícito é para autenticação Microsoft Entra.
import os
from collections.abc import Iterator
from contextlib import contextmanager

from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig
from azure.identity import DefaultAzureCredential


@contextmanager
def open_session() -> Iterator[FineTuningSession]:
    with DefaultAzureCredential() as credential:
        with FineTuningSessionClient(
            endpoint=os.environ["AZURE_AI_PROJECT_ENDPOINT"],
            credential=credential,
            credential_scopes=["https://ai.azure.com/.default"],
        ) as client:
            session = FineTuningSession.create(
                client,
                base_model="Qwen/Qwen3.8-27B",
                lora_config=LoRAConfig(rank=32),
                type="training",
                timeout_sec=600.0,
            )
            try:
                print("Session:", session.session_id)
                yield session
            finally:
                session.close()
Referência: FineTuningSession.create, FineTuningSessionClient e DefaultAzureCredential.
Espere um identificador de sessão após a conclusão do carregamento do modelo. Mantenha a sessão aberta para as operações abaixo; O fechamento de seu contexto interrompe a pulsação e envia uma solicitação de descarregamento.
| Parameter | Meaning |
|---|---|
base_model |
Identificador exato de modelo de treinamento com suporte. |
lora_config |
Explícito LoRAConfig com suporte rank. |
type |
Tipo de sessão; use training. A amostragem ocorre por meio da sessão de treinamento, não de um tipo de sessão de inferência separado. |
timeout_sec |
Tempo máximo para aguardar o carregamento do modelo. Um tempo limite não confirma a limpeza remota. |
from_checkpoint |
Opcional FromCheckpoint com a origem source_session_id e checkpoint_id. Use o estado de treinamento salvo compatível. |
user_metadata |
Dicionário opcional de metadados de execução a serem associados à sessão. |
training_type |
Seletor de camada opcional; os valores conhecidos são GlobalStandard, DatazoneStandarde DeveloperTier. A qualificação ainda depende do modelo e do projeto. |
Registre session.session_id quando você usar o SDK diretamente. Para executar uma receita de treinamento de ponta a ponta, consulte Introdução.
Preparar dados supervisionados
Datum grupos model_input e loss_fn_inputs por um exemplo.
| Tipo ou campo | Meaning |
|---|---|
ModelInput |
Blocos de entrada de modelo ordenado. |
ModelInputChunk.tokens |
IDs de token de texto do tokenizador do modelo. |
LossFnInputs.target_tokens |
Destinos de próximo token alinhados com as posições de entrada. |
LossFnInputs.weights |
Pesos explícitos por token; zero exclui um destino do treinamento de entropia cruzada. |
TensorData.data |
Destinos inteiros ou sinais de aprendizado de ponto flutuante. |
Shift entradas e destinos por um token e alinhe os pesos com os destinos. Treine os tokens de assistente pretendidos, não prompts ou observações. Veja as funções de perda e os pesos do token.
Passe tokens de prompt e de conclusão do mesmo renderizador de chat específico do modelo para este auxiliar. Ele cria um exemplo de SFT de turno único e mascara destinos de prompt.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    TensorData,
)


def supervised_datum(
    prompt_tokens: list[int], completion_tokens: list[int]
) -> Datum:
    if not prompt_tokens or not completion_tokens:
        raise ValueError("Provide prompt and completion tokens.")
    tokens = prompt_tokens + completion_tokens
    weights = [0.0] * len(prompt_tokens) + [1.0] * len(completion_tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=weights[1:]),
        ),
    )
Referência: Datum, LossFnInputs e ModelInput.
Compile batch como uma lista desses Datum valores. As matrizes de entrada, de destino e de peso têm o mesmo comprimento. Para dados de várias voltas, preserve as máscaras do renderizador em vez de tratar cada token após o primeiro prompt como um token de assistente.
Preparar dados RL
Para RL, use respostas de exemplo e sinais de aprendizagem derivados de recompensa:
| Field | Meaning |
|---|---|
SampledSequence.tokens |
IDs de token geradas. |
SampledSequence.logprobs |
Probabilidades de log de token da política que gerou a resposta, quando fornecida. |
LossFnInputs.logprobs |
Probabilidades de log de distribuição alinhadas com destinos de treinamento. |
LossFnInputs.advantages |
Vantagens por token; zero exclui posições de prompt e observação do sinal RL. |
Preserve o alinhamento entre destinos, probabilidades de log e vantagens. Não substitua as probabilidades de distribuição por aquelas de um modelo recém-atualizado. O construtor do LossFnInputs Python também requer explicitaçãoweights; O mascaramento de RL usa as vantagens.
Para uma distribuição de turno único, passe uma amostra sequence e uma advantage computada pelo driver. Esse auxiliar coloca zero vantagens e probabilidades de log em posições de prompt-target.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    SampledSequence,
    TensorData,
)


def rollout_datum(
    prompt_tokens: list[int],
    sequence: SampledSequence,
    advantage: float,
) -> Datum:
    if not prompt_tokens or not sequence.tokens:
        raise ValueError("Provide prompt and sampled response tokens.")
    if sequence.logprobs is None:
        raise ValueError("The rollout needs token log probabilities.")
    if len(sequence.logprobs) != len(sequence.tokens):
        raise ValueError("Align log probabilities with sampled tokens.")
    tokens = prompt_tokens + sequence.tokens
    prefix = len(prompt_tokens) - 1
    count = len(sequence.tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=[1.0] * (prefix + count)),
            logprobs=TensorData(
                data=[0.0] * prefix + sequence.logprobs
            ),
            advantages=TensorData(
                data=[0.0] * prefix + [advantage] * count
            ),
        ),
    )
Referência: SampledSequence e LossFnInputs.
Para chamadas de ferramentas ou distribuições de vários turnos, use o renderizador da receita para distinguir tokens de ação amostrados de observações de ambiente.
Gradientes de computação
session.forward_backward(batch, loss_fn=...) calcula o objetivo e acumula gradientes. Ele não atualiza os pesos do adaptador.
batch contém Datum valores.
loss_fn seleciona cross_entropy, importance_sampling, ppo, cispoou sapo. Opcional loss_fn_config usa o modelo do LossFnConfig SDK; não infera chaves de configuração aceitas de um documento de algoritmo.
Conclua a computação de gradiente antes da atualização do otimizador. Mantenha a redução de perda consistente ao acumular várias chamadas.
Com um SFT batchdinâmico session e não inteiro, compute gradientes e inspecione as saídas por exemplo:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward_backward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Referência: FineTuningSession.forward_backward e LossFn.
Para um lote RL preparado, use LossFn.IMPORTANCE_SAMPLING ou outra perda de política com suporte.
LossFn enumerar membros e seus valores de cadeia de caracteres selecione a mesma perda.
Aplicar uma etapa de otimizador
session.optim_step(adam_params) aplica gradientes acumulados.
AdamParams Python requer todos os cinco campos:
| Field | Meaning |
|---|---|
learning_rate |
Tamanho da atualização do otimizador. |
beta1 |
Fator de decadência do primeiro momento. |
beta2 |
Fator de decadência do segundo momento. |
eps |
Termo de estabilidade numérica. |
weight_decay |
Configuração de decadência de peso. |
Escolha valores para o experimento em vez de assumir padrões universais.
Esse auxiliar fornece todos os campos necessários e aguarda a atualização. Os valores são configurações de exemplo, não recomendações independentes de modelo.
from azure.ai.finetuningsessions import FineTuningSession
from azure.ai.finetuningsessions.models import AdamParams


def apply_optimizer_step(session: FineTuningSession) -> None:
    session.optim_step(
        AdamParams(
            learning_rate=2e-5,
            beta1=0.9,
            beta2=0.95,
            eps=1e-8,
            weight_decay=0.0,
        )
    )
Referência: FineTuningSession.optim_step e AdamParams.
Recompute learning_rate quando o driver usa uma agenda; não suponha que uma configuração de otimizador se aplique durante toda a execução.
Texto de exemplo
session.save_weights_for_sampler(seq_id, ...) prepara pesos e retorna um identificador de ponto de verificação de amostragem. Atualize os pesos do sampler após as atualizações antes de gerar do adaptador atualizado.
session.sample(prompt_tokens, sampling_params, checkpoint_id=..., ...) gera respostas dos pesos do sampler selecionados.
| Parâmetro ou resultado | Meaning |
|---|---|
prompt_tokens |
Prompt com token ou com suporte ModelInput. |
checkpoint_id |
Identificador de ponto de verificação do sampler concluído para esta sessão, não um caminho de ponto de verificação ou nome de implantação. |
num_samples |
Número de respostas para o prompt. |
SamplingParams.max_tokens |
Orçamento de token de conclusão. |
temperature, top_p, top_k |
Configurações de distribuição de amostragem. |
stop_criteria |
Uma lista de cadeias de caracteres de parada ou uma lista de IDs de token, não ambas. |
response_format |
Solicitação opcional de formato de resposta; O suporte depende do modelo e do provedor de amostragem. |
result.sequences |
Valores gerados SampledSequence . |
Python requer SamplingParamsmax_tokens, temperaturetop_pe top_k. Defina o mesmo seq_id para atualização e amostragem do sampler. Forneça ou pathsampling_session_seq_id ao salvar pesos do amostrador.
Após uma atualização do otimizador, atualize o sampler e gere uma resposta. Use o token prompt_tokens do modelo e a correspondência tokenizer do driver.
from azure.ai.finetuningsessions.models import SamplingParams

step = 1
sampler = session.save_weights_for_sampler(
    seq_id=step, sampling_session_seq_id=0
)
result = session.sample(
    prompt_tokens,
    SamplingParams(
        max_tokens=128,
        temperature=0.7,
        top_p=1.0,
        top_k=-1,
    ),
    checkpoint_id=sampler.checkpoint_id,
    seq_id=step,
    num_samples=1,
)
for sequence in result.sequences:
    print(tokenizer.decode(sequence.tokens, skip_special_tokens=True))
Referência: FineTuningSession.save_weights_for_sampler, FineTuningSession.sample e SamplingParams.
O resultado contém uma sequência de exemplo. Incremente o identificador de etapa com suas atualizações e atualize os pesos do sampler antes de amostragem da política atualizada.
Preparar pesos de amostra não é o mesmo que salvar o estado de treinamento retomável.
Manter ou atualizar pesos do sampler
O método síncrono usa sampling_session_seq_id para distinguir uma atualização na memória de um ponto de verificação de amostragem persistente.
| Purpose | Chamada síncrona |
|---|---|
| Atualizar pesos do sampler sem persistência | session.save_weights_for_sampler(seq_id=step, sampling_session_seq_id=0) |
| Persistir um ponto de verificação de amostragem |
session.save_weights_for_sampler(seq_id=step, path="sampler-final"), sem sampling_session_seq_id. |
Ambas as chamadas retornam um identificador de ponto de verificação de amostragem. Mantenha-o com sua ID de sessão proprietária. Um salvamento de amostragem durável não estabelece retenção indefinida ou torna o ponto de verificação utilizável em outra sessão.
Executar um passe somente para frente
session.forward(batch, loss_fn=...) retorna saídas de função de perda sem acumular gradientes. Use-o para inspecionar um lote preparado ou calcular as métricas de avaliação.
Seu resultado não preenche o treinamento somente total_loss. Inspeção loss_fn_outputs; não trate uma agregação ausente como perda zero.
Com uma dinâmica session e uma preparação batch, inspecione as saídas por exemplo sem alterar os gradientes acumulados:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Referência: FineTuningSession.forward.
Salvar e retomar o treinamento
session.save_weights(path) salva os pesos do adaptador e o estado do otimizador. Registre a referência de ponto de verificação com a sessão de origem e o estado do driver.
Após uma atualização concluída, salve o estado de treinamento e registre sua referência de sessão de origem/ponto de verificação:
saved = session.save_weights("example-final")
checkpoint_path = f"{session.session_id}/{saved.checkpoint_id}"
print("Training checkpoint:", checkpoint_path)
Referência: FineTuningSession.save_weights.
O método retorna somente após a conclusão do salvamento. Armazene checkpoint_path com a posição do conjunto de dados e outro estado do driver antes de fechar a sessão.
FineTuningSession.create_from_checkpoint restaura o estado de treinamento em uma nova sessão:
| Parameter | Meaning |
|---|---|
checkpoint_path |
Referência de ponto de verificação de treinamento salvo no <source-session-id>/<checkpoint-name> formulário. |
base_model |
Modelo base compatível com o ponto de verificação original. |
lora_config |
Configuração do adaptador compatível com uma classificação explícita. |
Um ponto de verificação de amostra não é um ponto de verificação de treinamento de estado completo. Restaure a posição do conjunto de dados e o agendamento separadamente no driver. Consulte Pontos de Verificação.
Esse auxiliar restaura o estado de treinamento salvo por meio de um autenticado client. Passe o treinamento checkpoint_pathgravado e mantenha o modelo base e a classificação LoRA compatíveis com a sessão de origem.
from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig


def restore_session(
    client: FineTuningSessionClient, checkpoint_path: str
) -> FineTuningSession:
    return FineTuningSession.create_from_checkpoint(
        client,
        checkpoint_path=checkpoint_path,
        base_model="Qwen/Qwen3.8-27B",
        lora_config=LoRAConfig(rank=32),
        timeout_sec=600.0,
    )
Referência: FineTuningSession.create_from_checkpoint.
A sessão retornada tem uma nova ID de sessão e inicia sua própria pulsação. Feche a sessão retomada quando o loop for encerrado, assim como você fechará uma sessão recém-criada.
Usar operações assíncronas
O cliente assíncrono do SDK e os wrappers do livro de receitas não são intercambiáveis. Importe o cliente assíncrono de azure.ai.finetuningsessions.aio; os tipos de modelo ainda vêm de azure.ai.finetuningsessions.models.
| Interface | Padrão de conclusão |
|---|---|
FineTuningSession síncrono |
O método retorna um resultado de operação concluído. |
Métodos de conveniência brutos do SDK assíncrono, como save_weights_for_sampler_async |
Aguarde o envio e aguarde o retorno asyncio.Task para conclusão. |
Métodos de wrapper de treinamento do livro de receitas, como save_state_async |
Aguarde o envio e aguarde o futuro.result_async() |
Para uma sessão ao vivo de propriedade de uma assíncrona client, esse auxiliar persiste os pesos do amostrador e retorna o identificador de ponto de verificação concluído:
from azure.ai.finetuningsessions.aio import (
    FineTuningSessionClient as AsyncSessionClient,
)


async def persist_sampler_checkpoint(
    client: AsyncSessionClient, session_id: str, name: str
) -> str:
    task = await client.save_weights_for_sampler_async(session_id, name)
    saved = await task
    return saved.checkpoint_id
Referência: FineTuningSessionClient.save_weights_for_sampler_async assíncrono.
Use save_weights_and_get_sampling_client_async em vez disso para uma atualização de sampler efêmero. No cliente bruto do SDK, esse método ainda retorna uma tarefa com um resultado de operação, não um cliente de amostragem de livro de receitas.
Aguardar salvamentos necessários antes de descarregar uma sessão. O argumento de compatibilidade ttl_seconds do livro de receitas não é encaminhado para essas salvamentos do SDK; não o trate como uma configuração de retenção imposta.
Para objetivos personalizados, o livro de receitas forward_backward_custom_async compõe saídas de encaminhamento de serviço com computação de perda diferencial do lado do cliente. Não é um método ativado FineTuningSessione o parâmetro do loss_fn SDK não aceita um Python arbitrário que pode ser chamado.
Fechar recursos
session.close() interrompe a pulsação e envia uma solicitação de descarregamento. Chame-o quando o loop for encerrado, inclusive em caso de falha; em seguida, feche o cliente HTTP e a credencial.
O fechamento não confirma a conclusão da limpeza remota nem exclui pontos de verificação.
session.delete() pode ser em cascata para recursos salvos. Consulte Inspecionar e descarregar sessões.
Use o gerenciador de contexto para executar uma única atualização SFT e salvar o open_session estado de treinamento. Defina open_session e apply_optimizer_step a partir dos exemplos anteriores e passe um SFT batchrenderizado não inteiro.
from azure.ai.finetuningsessions.models import Datum


def train_one_batch(batch: list[Datum]) -> str:
    if not batch:
        raise ValueError("Provide at least one rendered training datum.")
    with open_session() as session:
        session.forward_backward(batch, loss_fn="cross_entropy")
        apply_optimizer_step(session)
        saved = session.save_weights("example-final")
        return f"{session.session_id}/{saved.checkpoint_id}"
Referência: FineTuningSession.close e FineTuningSession.save_weights.
O auxiliar retorna uma referência de ponto de verificação de treinamento. Seu contexto envia uma solicitação de descarregamento mesmo que uma operação de treinamento gere uma exceção e feche o cliente e a credencial.
Referência do SDK
Use a referência completa para exemplos executáveis, assinaturas de método, APIs assíncronas, tipos de resultados e erros: