Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Importante
A Formação Programada requer aprovação explícita de acesso. Solicite acesso através do formulário de inscrição para pré-visualização e aguarde aprovação antes de criar uma sessão de formação.
Use esta folha de dicas para mapear o seu ciclo de treino para as funções e parâmetros do SDK Python no Microsoft Foundry. Os exemplos focam-se na API de conveniência FineTuningSession síncrona. Clientes assíncronos e wrappers de livros de receitas utilizam interfaces e padrões de conclusão diferentes.
Prerequisites
- Instalação completa, autenticação e configuração de acessos.
- Use
azure-ai-finetuningsessions==1.0.0b1, a versão pública de pré-visualização instalada pelo livro de receitas. - O papel de Foundry User para treino, ou o papel de Foundry Owner se também implementares o modelo afinado. Veja o controlo de acesso baseado em papéis para o Microsoft Foundry.
- Selecione um modelo elegível e uma configuração de adaptadores suportados. Prepare tokens com o seu tokenizador correspondente e modelo de chat.
- Defina
AZURE_AI_PROJECT_ENDPOINTe confirme um orçamento de formação aprovado. Criar uma sessão e executar operações de treino ou amostragem pode acarretar cargas.
Os métodos de treino, amostragem e conveniência dos pontos de controlo aguardam os resultados da operação. Operações brutas e assistentes assíncronos têm tipos de retorno e comportamentos de conclusão diferentes; use a referência completa do SDK para essas interfaces.
Os exemplos usam o SDK síncrono, a menos que seja rotulado de outra forma. Prepare as funções auxiliares uma vez e depois execute operações dentro with open_session() as session:de . Use dados tokenizados reais; os fragmentos não fornecem um conjunto de dados nem implementam um algoritmo de treino completo.
Ajuste fino supervisionado
O ajuste fino supervisionado (SFT) treina com base em prompts e respostas desejadas.
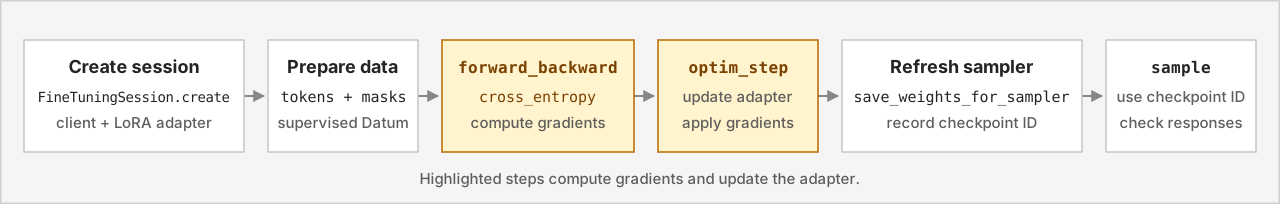
A sequência é : criar > , preparar dados > supervisionados, avançar/retroceder > passo > do otimizador, avaliar > , checkpoint. A amostragem não é obrigatória para todos os lotes supervisionados.
Aprendizagem por reforço
A aprendizagem por reforço (RL) treina a partir das respostas pontuadas dos modelos.

A sequência é criar > , atualizar, amostrar > , recolher rollouts, > calcular recompensas e vantagens > , avançar/recuar > passo do otimizador. Repita a partir da atualização do sampler para recolher respostas da política atualizada.
Agrupamento, avaliação e cálculo de vantagens pertencem ao teu driver, não a um algoritmo automático de treino SDK. Para exemplos completos de treino, explore o repositório de amostras de ajuste fino.
Crie uma sessão
FineTuningSessionClient liga-se ao seu projeto usando um endpoint e credential.
FineTuningSession.create inicializa um modelo e adaptador e inicia o batimento de coração da sessão.
Este assistente autentica com DefaultAzureCredential, cria uma sessão e descarrega-a quando o seu contexto sai. Use o seu modelo aprovado e o ranking LoRA. O âmbito explícito das credenciais é para autenticação Microsoft Entra.
import os
from collections.abc import Iterator
from contextlib import contextmanager

from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig
from azure.identity import DefaultAzureCredential


@contextmanager
def open_session() -> Iterator[FineTuningSession]:
    with DefaultAzureCredential() as credential:
        with FineTuningSessionClient(
            endpoint=os.environ["AZURE_AI_PROJECT_ENDPOINT"],
            credential=credential,
            credential_scopes=["https://ai.azure.com/.default"],
        ) as client:
            session = FineTuningSession.create(
                client,
                base_model="Qwen/Qwen3.8-27B",
                lora_config=LoRAConfig(rank=32),
                type="training",
                timeout_sec=600.0,
            )
            try:
                print("Session:", session.session_id)
                yield session
            finally:
                session.close()
Referência: FineTuningSession.create, FineTuningSessionClient e DefaultAzureCredential.
Espere um identificador de sessão após o carregamento do modelo. Mantenha a sessão aberta para as operações abaixo; fechar o seu contexto para o batimento cardíaco e envia um pedido de descarga.
| Parameter | Meaning |
|---|---|
base_model |
Identificador exato suportado do modelo de treino. |
lora_config |
Explícito LoRAConfig com um suporte rank. |
type |
Tipo de sessão; usar training. A amostragem ocorre através da sessão de treino, não de um tipo separado de sessão de inferência. |
timeout_sec |
Tempo máximo de espera para carregar o modelo. Um timeout não confirma a limpeza remota. |
from_checkpoint |
Opcional FromCheckpoint com a fonte source_session_id e checkpoint_id. Use o estado de treino guardado compatível. |
user_metadata |
Dicionário opcional de metadados de execução para associar à sessão. |
training_type |
Seletor de níveis opcional; os valores conhecidos são GlobalStandard, DatazoneStandard, e DeveloperTier. A elegibilidade ainda depende do modelo e do projeto. |
Grava session.session_id quando usares o SDK diretamente. Para executar uma receita de treino de ponta a ponta, veja Comece.
Preparar dados supervisionados
Datum Grupos model_input e loss_fn_inputs , por exemplo.
| Tipo ou campo | Meaning |
|---|---|
ModelInput |
Pedaços ordenados por entrada de modelo. |
ModelInputChunk.tokens |
IDs de tokens de texto do tokenizador do modelo. |
LossFnInputs.target_tokens |
Os alvos do próximo token alinhados com as posições de entrada. |
LossFnInputs.weights |
Pesos explícitos por token; zero exclui um alvo do treino de entropia cruzada. |
TensorData.data |
Alvos inteiros ou sinais de aprendizagem em ponto flutuante. |
Desloca as entradas e alvos por um token e alinha os pesos com os alvos. Treina com os tokens de assistente pretendidos, não com prompts ou observações. Ver Funções de perda e pesos de tokens.
Passe os tokens de prompt e de conclusão do mesmo renderizador de chat específico para este ajudante. Cria um exemplo de SFT de um único turno e mascara alvos de prompt.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    TensorData,
)


def supervised_datum(
    prompt_tokens: list[int], completion_tokens: list[int]
) -> Datum:
    if not prompt_tokens or not completion_tokens:
        raise ValueError("Provide prompt and completion tokens.")
    tokens = prompt_tokens + completion_tokens
    weights = [0.0] * len(prompt_tokens) + [1.0] * len(completion_tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=weights[1:]),
        ),
    )
Referência: Datum, LossFnInputs e ModelInput.
Constrói batch como uma lista destes Datum valores. Os arrays de entrada, alvo e pesos têm o mesmo comprimento. Para dados de múltiplas voltas, preserva as máscaras do renderizador em vez de tratar cada token após o primeiro prompt como um token assistente.
Preparar dados RL
Para o RL, utilize respostas amostradas e sinais de aprendizagem derivados da recompensa:
| Field | Meaning |
|---|---|
SampledSequence.tokens |
IDs de token gerados. |
SampledSequence.logprobs |
Probabilidades de registo de tokens da política que gerou a resposta, quando fornecidas. |
LossFnInputs.logprobs |
Registo de probabilidades de lançamento alinhadas com os objetivos de treino. |
LossFnInputs.advantages |
Vantagens por token; zero exclui posições de prompt e observação do sinal RL. |
Manter o alinhamento entre os alvos, probabilidades e vantagens de registo. Não substitua as probabilidades de lançamento por aquelas de um modelo recentemente atualizado. O construtor do LossFnInputs Python também requer o mascaramento explícito weights; O mascaramento RL utiliza as vantagens.
Para um lançamento de uma só volta, passe um amostrado sequence e um advantage calculado pelo seu condutor. Este auxiliar não coloca vantagens e probabilidades de registo nas posições de alvo imediato.
from azure.ai.finetuningsessions.models import (
    Datum,
    LossFnInputs,
    ModelInput,
    ModelInputChunk,
    SampledSequence,
    TensorData,
)


def rollout_datum(
    prompt_tokens: list[int],
    sequence: SampledSequence,
    advantage: float,
) -> Datum:
    if not prompt_tokens or not sequence.tokens:
        raise ValueError("Provide prompt and sampled response tokens.")
    if sequence.logprobs is None:
        raise ValueError("The rollout needs token log probabilities.")
    if len(sequence.logprobs) != len(sequence.tokens):
        raise ValueError("Align log probabilities with sampled tokens.")
    tokens = prompt_tokens + sequence.tokens
    prefix = len(prompt_tokens) - 1
    count = len(sequence.tokens)
    return Datum(
        model_input=ModelInput(
            chunks=[ModelInputChunk(tokens=tokens[:-1])]
        ),
        loss_fn_inputs=LossFnInputs(
            target_tokens=TensorData(data=tokens[1:]),
            weights=TensorData(data=[1.0] * (prefix + count)),
            logprobs=TensorData(
                data=[0.0] * prefix + sequence.logprobs
            ),
            advantages=TensorData(
                data=[0.0] * prefix + [advantage] * count
            ),
        ),
    )
Referência: SampledSequence e LossFnInputs.
Para chamadas de ferramentas ou rollouts com múltiplas voltas, use o renderizador da receita para distinguir tokens de ação amostrados das observações do ambiente.
Cálculo de gradientes
session.forward_backward(batch, loss_fn=...) calcula o objetivo e acumula gradientes. Não atualiza os pesos dos adaptadores.
batch contém Datum valores.
loss_fn seleciona cross_entropy, importance_sampling, ppo, cispo, ou sapo. Opcional loss_fn_config usa o modelo do LossFnConfig SDK; não infira chaves de configuração aceites a partir de um artigo de algoritmo.
Cálculo completo do gradiente antes da atualização do otimizador. Mantenha a redução de perdas consistente ao acumular várias chamadas.
Com um SFT batchvivo session e um não vazio , calcule gradientes e inspecione as saídas por exemplo:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward_backward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Referência: FineTuningSession.forward_backward e LossFn.
Para um lote RL preparado, use LossFn.IMPORTANCE_SAMPLING ou outra perda de apólice suportada.
LossFn Os membros enum e os seus valores de cadeia selecionam a mesma perda.
Aplicar um passo otimizador
session.optim_step(adam_params) aplica gradientes acumulados. Python AdamParams requer os cinco campos:
| Field | Meaning |
|---|---|
learning_rate |
Tamanho da atualização do otimizador. |
beta1 |
Fator de decadência no primeiro momento. |
beta2 |
Fator de decadência do segundo momento. |
eps |
Termo de estabilidade numérica. |
weight_decay |
Configuração de perda de peso. |
Escolhe valores para o teu experimento em vez de assumir valores universais.
Este auxiliar fornece todos os campos necessários e espera pela atualização. Os valores são definições de exemplo, não recomendações independentes do modelo.
from azure.ai.finetuningsessions import FineTuningSession
from azure.ai.finetuningsessions.models import AdamParams


def apply_optimizer_step(session: FineTuningSession) -> None:
    session.optim_step(
        AdamParams(
            learning_rate=2e-5,
            beta1=0.9,
            beta2=0.95,
            eps=1e-8,
            weight_decay=0.0,
        )
    )
Referência: FineTuningSession.optim_step e AdamParams.
Recalcule learning_rate quando o seu driver usar um agendamento; não assuma que uma configuração de otimizador se aplica ao longo da execução.
Exemplo de texto
session.save_weights_for_sampler(seq_id, ...) prepara os pesos e devolve um identificador de checkpoint do amostrador. Atualize os pesos do sampler após as atualizações antes de gerar a partir do adaptador atualizado.
session.sample(prompt_tokens, sampling_params, checkpoint_id=..., ...) gera respostas a partir dos pesos selecionados do sampler.
| Parâmetro ou resultado | Meaning |
|---|---|
prompt_tokens |
Prompt tokenizado, ou suportado ModelInputpor . |
checkpoint_id |
Identificador de checkpoint de sampler concluído para esta sessão, não um caminho de checkpoint ou nome de deployment. |
num_samples |
Número de respostas ao prompt. |
SamplingParams.max_tokens |
Orçamento de tokens de conclusão. |
temperature, top_p, top_k |
Configurações de distribuição de amostragem. |
stop_criteria |
Uma lista de cadeias de paradas ou uma lista de IDs de tokens, não ambos. |
response_format |
Pedido opcional de formato de resposta; o suporte depende do modelo e do fornecedor de amostragem. |
result.sequences |
Valores gerados SampledSequence . |
O SamplingParams Python requer max_tokens, temperature, top_p, e top_k. Defina o mesmo seq_id para refresh do sampler e sampling. Fornece qualquer um path dos pesos do sampler sampling_session_seq_id .
Após uma atualização do otimizador, atualiza o sampler e gera uma resposta. Use os modelos tokenizados prompt_tokens e correspondentes tokenizer do seu driver.
from azure.ai.finetuningsessions.models import SamplingParams

step = 1
sampler = session.save_weights_for_sampler(
    seq_id=step, sampling_session_seq_id=0
)
result = session.sample(
    prompt_tokens,
    SamplingParams(
        max_tokens=128,
        temperature=0.7,
        top_p=1.0,
        top_k=-1,
    ),
    checkpoint_id=sampler.checkpoint_id,
    seq_id=step,
    num_samples=1,
)
for sequence in result.sequences:
    print(tokenizer.decode(sequence.tokens, skip_special_tokens=True))
Referência: FineTuningSession.save_weights_for_sampler, FineTuningSession.sample e SamplingParams.
O resultado contém uma sequência amostrada. Incremente o identificador de passo com as suas atualizações e atualize os pesos do sampler antes de amostrar a política atualizada.
Preparar pesos de amostragem não é o mesmo que guardar um estado de treino retomável.
Persistir ou atualizar os pesos do sampler
O método síncrono serve sampling_session_seq_id para distinguir uma atualização em memória de um checkpoint de amostrador persistente.
| Purpose | Chamada síncrona |
|---|---|
| Atualizar os pesos do sampler sem persistência | session.save_weights_for_sampler(seq_id=step, sampling_session_seq_id=0) |
| Persistir um checkpoint do sampler |
session.save_weights_for_sampler(seq_id=step, path="sampler-final"), sem sampling_session_seq_id. |
Ambas as chamadas retornam um identificador de checkpoint sampler. Mantém-no com o seu próprio ID de sessão. Um teste de amostra duradouro não estabelece retenção indefinida nem torna o checkpoint utilizável noutra sessão.
Execute um passe apenas para a frente
session.forward(batch, loss_fn=...) devolve as saídas da função de perda sem acumular gradientes. Use-o para inspecionar um lote preparado ou calcular métricas de avaliação.
O seu resultado não preenche apenas total_losso treino. Inspecionar loss_fn_outputs; não trate um agregado em falta como perda zero.
Com um live session e um preparado batch, inspecione as saídas por exemplo sem alterar os gradientes acumulados:
from azure.ai.finetuningsessions.models import LossFn

result = session.forward(batch, loss_fn=LossFn.CROSS_ENTROPY)
print(result.loss_fn_outputs)
Referência: FineTuningSession.forward.
Guardar e retomar o treino
session.save_weights(path) Poupa pesos dos adaptadores e o estado do otimizador. Regista a referência do checkpoint com a sua sessão de origem e estado do driver.
Após uma atualização concluída, guarde o estado de treino e registre a sua referência-sessão de origem/checkpoint:
saved = session.save_weights("example-final")
checkpoint_path = f"{session.session_id}/{saved.checkpoint_id}"
print("Training checkpoint:", checkpoint_path)
Referência: FineTuningSession.save_weights.
O método só regressa depois de o save estar concluído. Armazene checkpoint_path com a posição do conjunto de dados e outros estados do driver antes de fechar a sessão.
FineTuningSession.create_from_checkpoint Restaura o estado de treino numa nova sessão:
| Parameter | Meaning |
|---|---|
checkpoint_path |
Guardei a referência do ponto de controlo de treino no <source-session-id>/<checkpoint-name> formulário. |
base_model |
Modelo base compatível com o checkpoint original. |
lora_config |
Configuração de adaptador compatível com um rank explícito. |
Um checkpoint sampler não é um checkpoint de treino em estado completo. Restaure a posição do conjunto de dados e o agendamento separadamente no seu driver. Ver Pontos de Controlo.
Este ajudante restaura o estado de treino guardado através de um .client Passa o treino checkpoint_pathgravado e mantém o modelo base e o rank LoRA compatíveis com a sessão de origem.
from azure.ai.finetuningsessions import (
    FineTuningSession,
    FineTuningSessionClient,
)
from azure.ai.finetuningsessions.models import LoRAConfig


def restore_session(
    client: FineTuningSessionClient, checkpoint_path: str
) -> FineTuningSession:
    return FineTuningSession.create_from_checkpoint(
        client,
        checkpoint_path=checkpoint_path,
        base_model="Qwen/Qwen3.8-27B",
        lora_config=LoRAConfig(rank=32),
        timeout_sec=600.0,
    )
Referência: FineTuningSession.create_from_checkpoint.
A sessão devolvida tem um novo ID de sessão e inicia o seu próprio batimento cardíaco. Fecha a sessão retomada quando o seu ciclo sair, tal como fechas uma sessão recém-criada.
Utilizar operações assíncronas
O cliente assíncrono e as embalagens do livro de receitas do SDK não são intercambiáveis. Importar o cliente assíncrono de azure.ai.finetuningsessions.aio; os tipos de modelo ainda vêm de azure.ai.finetuningsessions.models.
| Interface | Padrão de conclusão |
|---|---|
Síncrono FineTuningSession |
O método devolve um resultado de operação concluída. |
Métodos brutos de conveniência do SDK assíncrono, como save_weights_for_sampler_async |
Aguarde a submissão, depois aguarde a conclusão do retorno asyncio.Task . |
Métodos de embalagem de treino em livros de receitas, como save_state_async |
Aguarda a submissão, depois aguarda os futuros result_async(). |
Para uma sessão ao vivo pertencente a um assíncrono client, este helper mantém os pesos do sampler e devolve o identificador de checkpoint completado:
from azure.ai.finetuningsessions.aio import (
    FineTuningSessionClient as AsyncSessionClient,
)


async def persist_sampler_checkpoint(
    client: AsyncSessionClient, session_id: str, name: str
) -> str:
    task = await client.save_weights_for_sampler_async(session_id, name)
    saved = await task
    return saved.checkpoint_id
Referência: Assíncrono FineTuningSessionClient.save_weights_for_sampler_async.
Use save_weights_and_get_sampling_client_async antes para uma atualização efémera do sampler. No cliente SDK bruto, esse método ainda devolve uma tarefa com um resultado de operação, e não um cliente de amostragem de livro de receitas.
Aguarde os saves necessários antes de descarregar uma sessão. O argumento de compatibilidade ttl_seconds do livro de receitas não é encaminhado para estes saves do SDK; não o trates como uma configuração de retenção forçada.
Para objetivos personalizados, o livro forward_backward_custom_async de receitas compõe resultados encaminhados para o serviço com cálculo de perdas diferenciáveis do lado do cliente. Não é um método em FineTuningSession, e o parâmetro do loss_fn SDK não aceita uma chamada arbitrária em Python.
Recursos próximos
session.close() pára o batimento cardíaco e envia um pedido de descarga. Chama-o quando o loop sair, incluindo em caso de falha; depois fecha o cliente HTTP e a credencial.
Fechar não confirma a conclusão da limpeza remota nem apaga checkpoints.
session.delete() Pode fazer cascata para recursos poupados. Veja Inspecionar e descarregar sessões.
Use o gestor de open_session contexto para executar uma única atualização SFT e guardar o estado de treino. Defina open_session e apply_optimizer_step a partir dos exemplos anteriores, e passe um SFT batchrenderizado não vazio .
from azure.ai.finetuningsessions.models import Datum


def train_one_batch(batch: list[Datum]) -> str:
    if not batch:
        raise ValueError("Provide at least one rendered training datum.")
    with open_session() as session:
        session.forward_backward(batch, loss_fn="cross_entropy")
        apply_optimizer_step(session)
        saved = session.save_weights("example-final")
        return f"{session.session_id}/{saved.checkpoint_id}"
Referência: FineTuningSession.close e FineTuningSession.save_weights.
O ajudante devolve uma referência de ponto de controlo de treino. O seu contexto submete um pedido de descarga mesmo que uma operação de treino levante uma exceção, depois fecha o cliente e a credencial.
Referência do SDK
Use a referência completa para exemplos executáveis, assinaturas de métodos, APIs assíncronas, tipos de resultados e erros: