Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Aplica-se a: SQL Server em Linux
Este artigo explica como operar uma instância de cluster de failover do SQL Server (FCI) no Linux. Para criar um FCI do SQL Server no Linux, consulte Configurar instância de cluster de failover no Linux (RHEL).
Descrição da arquitetura
A camada de clustering baseia-se no suplemento HA do Red Hat Enterprise Linux (RHEL), construído sobre o Pacemaker. O Corosync e o Pacemaker coordenam as comunicações do cluster e o gerenciamento de recursos. A instância do SQL Server está ativa num único nó de cada vez.
O diagrama a seguir ilustra os componentes em um cluster Linux com o SQL Server.
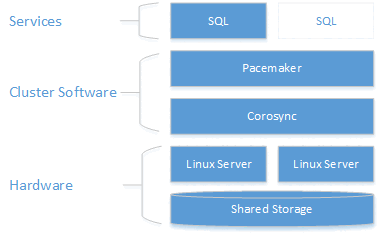
Para mais informações sobre configuração do cluster, opções de agentes de recursos e gestão, visite a documentação de referência RHEL.
Failover
O failover para FCIs é semelhante a um cluster de failover do Windows Server (WSFC). Se o nó do cluster que hospeda a FCI tiver algum tipo de falha, a FCI deverá fazer failover automaticamente para outro nó. Ao contrário de um WSFC, não há como definir proprietários preferenciais, então o Pacemaker escolhe o nó que será o novo host para o FCI.
Por vezes, pode querer comutar manualmente a FCI para outro nó. O processo não é o mesmo que com FCIs em um WSFC. Em um WSFC, você executa failover de recursos no nível de função. No Pacemaker, escolhes um recurso para mover e, se todas as restrições estiverem corretas, tudo o resto também se move.
A forma de fazer failover depende da distribuição Linux. Segue as instruções da tua distribuição Linux.
Failover manual (RHEL ou Ubuntu)
Para executar um failover manual nos servidores Red Hat Enterprise Linux (RHEL) ou Ubuntu, execute as etapas a seguir.
Emita o seguinte comando:
sudo pcs resource move <FCIResourceName> <NewHostNode><FCIResourceName>é o nome do recurso Pacemaker para a FCI do SQL Server, e<NewHostNode>é o nome do nó do cluster que pretende alojar a FCI.Durante um failover manual, o Pacemaker cria uma restrição de local no recurso que foi escolhido para ser movido manualmente. Para ver essa restrição, execute
sudo pcs constraint.Após concluir o failover, remova a restrição:
sudo pcs resource clear <FCIResourceName>
Comutação manual pós-falha (SLES)
Note
A partir do SQL Server 2025 (17.x), o SUSE Linux Enterprise Server (SLES) não é suportado. Para o SQL Server 2022 (16.x) e versões anteriores, apenas o SLES 15 é suportado.
No SUSE Linux Enterprise Server (SLES), use o comando migrate para fazer failover manualmente de uma FCI do SQL Server. Por exemplo:
crm resource migrate <FCIResourceName> <NewHostNode>
<FCIResourceName> é o nome do recurso para a instância do cluster de failover, e <NewHostNode> é o nome do novo host de destino.
Monitorizar um cluster de failover
Exibir o status atual do cluster:
sudo pcs status
Veja o estado em tempo real do cluster e dos recursos:
sudo crm_mon
Consulte os registos do agente de recursos em /var/log/cluster/corosync.log.
Adicionar um nó a um cluster
Verifique o endereço IP de cada nó. O seguinte script mostra o endereço IP do seu nó atual.
ip addr showO novo nó precisa de um nome único que tenha 15 caracteres ou menos. Defina o nome do computador adicionando-o a
/etc/hosts. O script a seguir permite editar/etc/hostscomvi.sudo vi /etc/hostsO exemplo a seguir mostra
/etc/hostscom adições para três nós chamadossqlfcivm1,sqlfcivm2esqlfcivm3.127.0.0.1 localhost localhost4 localhost4.localdomain4 ::1 localhost localhost6 localhost6.localdomain6 10.128.18.128 sqlfcivm1 10.128.16.77 sqlfcivm2 10.128.14.26 sqlfcivm3O arquivo deve ser o mesmo em todos os nós.
Interrompa o serviço SQL Server no novo nó.
Siga as instruções para montar o diretório de ficheiros da base de dados na localização partilhada.
A partir do servidor NFS, instalar
nfs-utils:sudo yum -y install nfs-utilsAbra o firewall dos clientes e do servidor NFS:
sudo firewall-cmd --permanent --add-service=nfs
sudo firewall-cmd --permanent --add-service=mountd
sudo firewall-cmd --permanent --add-service=rpc-bind
sudo firewall-cmd --reload
Edite o arquivo
/etc/fstabpara incluir o comando mount:<IP OF NFS SERVER>:<shared_storage_path> <database_files_directory_path> nfs timeo=14,intrExecute
mount -apara que as alterações entrem em vigor.No novo nó, crie um arquivo para armazenar o nome de usuário e a senha do SQL Server para o logon do Pacemaker. O comando a seguir cria e preenche esse arquivo:
sudo touch /var/opt/mssql/secrets/passwd
echo "<loginName>" | sudo tee -a /var/opt/mssql/secrets/passwd
echo "<password>" | sudo tee -a /var/opt/mssql/secrets/passwd
sudo chown root:root /var/opt/mssql/secrets/passwd
sudo chmod 600 /var/opt/mssql/secrets/passwd
Caution
A sua palavra-passe deve seguir a política de palavra-passe padrão do SQL Server . Por padrão, a senha deve ter pelo menos oito caracteres e conter caracteres de três dos quatro conjuntos a seguir: letras maiúsculas, letras minúsculas, dígitos de base 10 e símbolos. As palavras-passe podem ter até 128 caracteres. Use senhas tão longas e complexas quanto possível.
No novo nó, abra as portas de firewall do Pacemaker. Para abrir essas portas com
firewalld, execute o seguinte comando:sudo firewall-cmd --permanent --add-service=high-availability sudo firewall-cmd --reloadSe estiver a usar outro firewall que não tenha uma configuração de alta disponibilidade incorporada, abra as seguintes portas para o Pacemaker comunicar com outros nós do cluster:
- TCP: portas 2224, 3121, 21064
- UDP: porta 5405
Instale os pacotes do Pacemaker no novo nó.
sudo yum install pacemaker pcs fence-agents-all resource-agentsDefina a senha para o usuário padrão que é criado ao instalar os pacotes Pacemaker e Corosync. Use a mesma senha que os nós existentes.
sudo passwd haclusterAtive e inicie o serviço
pcsde o Pacemaker. O novo nó pode voltar a juntar-se ao cluster após um reinício. Execute o seguinte comando no novo nó.sudo systemctl enable pcsd sudo systemctl start pcsd sudo systemctl enable pacemaker sudo systemctl start pacemakerInstale o agente de recursos FCI para SQL Server. Execute o seguinte comando no novo nó.
sudo yum install mssql-server-haNum nó existente do cluster, autentique o novo nó e adicione-o ao cluster:
sudo pcs cluster auth <nodeName3> -u hacluster
sudo pcs cluster node add <nodeName3>
Remover nós de um cluster
Para remover um nó de um cluster, execute o seguinte comando:
sudo pcs cluster node remove <nodeName>
Alterar a frequência de monitorização de recursos
sudo pcs resource op monitor interval=<interval>s <sqlResourceName>
O exemplo seguinte define o intervalo de monitorização para 2 segundos para o mssqlha recurso:
sudo pcs resource op monitor interval=2s mssqlha
Troubleshoot
Quando você soluciona problemas do cluster, isso ajuda a entender como os três daemons trabalham juntos para gerenciar recursos de cluster.
| Daemon | Description |
|---|---|
| Corosync | Fornece adesão ao quórum e troca de mensagens entre os nós do cluster. |
| Marcapasso | Reside sobre o Corosync e fornece máquinas de estado para recursos. |
| PCSD | Gerencia o Pacemaker e o Corosync através das ferramentas pcs. |
PCSD deve estar em execução para usar as ferramentas pcs.
Status atual do cluster
sudo pcs status retorna informações básicas sobre o cluster, quorum, nós, recursos e status do daemon para cada nó.
O exemplo seguinte mostra uma saída saudável do quórum Pacemaker:
Cluster name: MyAppSQL
Last updated: Thu Oct 31 12:00:00 2024  Last change: Thu Oct 31 11:00:00 2024 by root via crm_resource on sqlvmnode1
Stack: corosync
Current DC: sqlvmnode1  (version 1.1.13-10.el7_2.4-44eb2dd) - partition with quorum
3 nodes and 1 resource configured

Online: [ sqlvmnode1 sqlvmnode2 sqlvmnode3 ]

Full list of resources:

mssqlha (ocf::sql:fci): Started sqlvmnode1

PCSD Status:
sqlvmnode1: Online
sqlvmnode2: Online
sqlvmnode3: Online

Daemon Status:
corosync: active/disabled
pacemaker: active/enabled
Neste exemplo, partition with quorum significa que um quórum maioritário de nós está online. Se o cluster perder a maioria do quórum de nós, pcs status retornará partition WITHOUT quorum e todos os recursos serão interrompidos.
Online: [sqlvmnode1 sqlvmnode2 sqlvmnode3] retorna o nome de todos os nós que participam atualmente do cluster. Se algum nó não estiver participando, pcs status retornará OFFLINE: [<nodename>].
PCSD Status mostra o status do cluster para cada nó.
Razões pelas quais um nó pode estar offline
Verifique os seguintes itens quando um nó estiver offline.
Firewall
Abra as seguintes portas em todos os nós para permitir a comunicação do Pacemaker:
- TCP: portas 2224, 3121, 21064
- UDP: porta 5405
Pacemaker ou serviços Corosync em execução
Comunicação do nó
Mapeamentos de nome de nó