Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Aplica-se a: SQL Server 2016 (13.x) e versões posteriores
Este é o tutorial 8 da série de tutoriais RevoScaleR sobre como usar funções RevoScaleR com SQL Server.
Neste tutorial, vais usar o modelo de regressão logística que criaste no tutorial anterior para pontuar outro conjunto de dados que usa as mesmas variáveis independentes como entradas.
- Classificar novos dados
- Crie um histograma das pontuações
Note
Precisas de privilégios de administrador DDL para alguns destes passos.
Gerar e guardar pontuações
Atualize a fonte de dados sqlScoreDS (criada no tutorial dois) para usar a informação das colunas criada no tutorial anterior.
sqlScoreDS <- RxSqlServerData(
    connectionString = sqlConnString,
    table = sqlScoreTable,
    colInfo = ccColInfo,
    rowsPerRead = sqlRowsPerRead)
Para garantir que não perde os resultados, crie um novo objeto fonte de dados. Depois, use o novo objeto fonte de dados para preencher uma nova tabela na base de dados RevoDeepDive.
sqlServerOutDS <- RxSqlServerData(table = "ccScoreOutput",
    connectionString = sqlConnString,
    rowsPerRead = sqlRowsPerRead )
Neste momento, a tabela ainda não foi criada. Esta instrução define apenas um contentor para os dados.
Verifique o contexto de computação atual usando rxGetComputeContext(), e defina o contexto de computação para o servidor, se necessário.
rxSetComputeContext(sqlCompute)Como precaução, verifique a existência da tabela de saída. Se já existir um com o mesmo nome, receberá um erro ao tentar escrever a nova tabela.
Para isso, faz uma chamada às funções rxSqlServerTableExists e rxSqlServerDropTable, passando o nome da tabela como entrada.
if (rxSqlServerTableExists("ccScoreOutput")) rxSqlServerDropTable("ccScoreOutput")- rxSqlServerTableExists consulta o driver ODBC e devolve TRUE se a tabela existir, FALSE caso contrário.
- rxSqlServerDropTable executa o DDL e devolve TRUE se a tabela for eliminada com sucesso, caso contrário, FALSE.
Execute o rxPredict para criar as pontuações e guarde-as na nova tabela definida na fonte de dados sqlScoreDS.
rxPredict(modelObject = logitObj,
    data = sqlScoreDS,
    outData = sqlServerOutDS,
    predVarNames = "ccFraudLogitScore",
      type = "link",
    writeModelVars = TRUE,
    overwrite = TRUE)
A função rxPredict é outra função que suporta a execução em contextos de computação remota. Pode usar a função rxPredict para criar pontuações a partir de modelos baseados em rxLinMod, rxLogit ou rxGlm.
O parâmetro writeModelVars está definido como TRUE aqui. Isto significa que as variáveis usadas para a estimativa serão incluídas na nova tabela.
O parâmetro predVarNames especifica a variável onde os resultados serão armazenados. Aqui está a passar uma nova variável,
ccFraudLogitScore.O parâmetro de tipo do rxPredict define como queres que as previsões sejam calculadas. Especifique a palavra-chave response para gerar pontuações com base na escala da variável de resposta. Ou, usar a palavra-chave link para gerar pontuações com base na função link subjacente, caso em que as previsões são criadas usando uma escala logística.
Passado algum tempo, pode atualizar a lista de tabelas no Management Studio para ver a nova tabela e os seus dados.
Para adicionar variáveis adicionais às previsões de saída, use o argumento extraVarsToWrite . Por exemplo, no código seguinte, a variável custID é adicionada da tabela de dados de pontuação para a tabela de saída das previsões.
rxPredict(modelObject = logitObj,
        data = sqlScoreDS,
        outData = sqlServerOutDS,
        predVarNames = "ccFraudLogitScore",
          type = "link",
        writeModelVars = TRUE,
        extraVarsToWrite = "custID",
        overwrite = TRUE)
Mostrar as pontuações num histograma
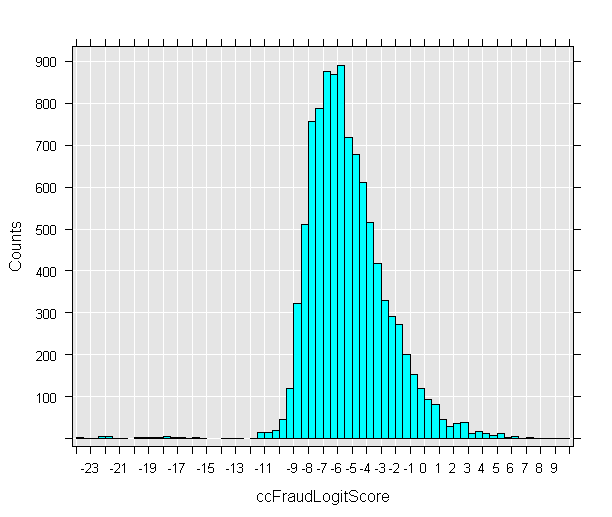
Depois de criada a nova tabela, calcula e apresenta um histograma das 10.000 pontuações previstas. O cálculo é mais rápido se especificar os valores mínimo e máximo, por isso obtenha-os da base de dados e adicione-os ao seu conjunto de trabalho.
Cria uma nova fonte de dados, sqlMinMax, que consulta a base de dados para obter os valores baixos e altos.
sqlMinMax <- RxSqlServerData(
    sqlQuery = paste("SELECT MIN(ccFraudLogitScore) AS minVal,",
    "MAX(ccFraudLogitScore) AS maxVal FROM ccScoreOutput"),
    connectionString = sqlConnString)
Neste exemplo, pode ver como é fácil usar objetos fonte de dados RxSqlServerData para definir conjuntos de dados arbitrários baseados em consultas SQL, funções ou procedimentos armazenados, e depois usá-los no seu código R. A variável não armazena os valores reais, apenas a definição da fonte de dados; a consulta é executada para gerar os valores apenas quando a usas numa função como o rxImport.
Chame a função rxImport para colocar os valores num data frame que possa ser partilhado entre contextos de computação.
minMaxVals <- rxImport(sqlMinMax)
minMaxVals <- as.vector(unlist(minMaxVals))
Results
> minMaxVals

[1] -23.970256   9.786345
Agora que os valores máximos e mínimos estão disponíveis, use esses valores para criar outra fonte de dados para as pontuações geradas.
sqlOutScoreDS <- RxSqlServerData(sqlQuery = "SELECT ccFraudLogitScore FROM ccScoreOutput",
    connectionString = sqlConnString,
    rowsPerRead = sqlRowsPerRead,
        colInfo = list(ccFraudLogitScore = list(
            low = floor(minMaxVals[1]),
                    high = ceiling(minMaxVals[2]) ) ) )
Usa o objeto fonte de dados sqlOutScoreDS para obter as pontuações e calcula e apresenta um histograma. Adicione o código para definir o contexto de computação, se necessário.
# rxSetComputeContext(sqlCompute)
rxHistogram(~ccFraudLogitScore, data = sqlOutScoreDS)
Results