Escolha uma ferramenta de ingestão de dados
Quando desenha pipelines de dados no Azure Databricks, selecionar a ferramenta de ingestão certa impacta diretamente a fiabilidade do pipeline, o esforço de manutenção e os custos a longo prazo. Cada ferramenta aborda diferentes cenários, fontes de dados e requisitos operacionais. Compreender estas diferenças ajuda-o a tomar decisões informadas que estejam alinhadas com as necessidades da sua organização.
Compreenda o panorama das ferramentas de ingestão
O Azure Databricks oferece múltiplas opções de ingestão que abrangem um espectro, desde serviços totalmente geridos até frameworks altamente personalizáveis. As ferramentas que escolher dependem de fatores como o tipo de fonte de dados, requisitos de latência e o grau de controlo necessário sobre o processo de ingestão.

No extremo mais gerido, o Lakeflow Connect oferece conectores turnkey para aplicações empresariais e bases de dados. Estes conectores tratam automaticamente da autenticação, acompanhamento de alterações, recuperação de erros e evolução do esquema. No extremo personalizável, o Spark Structured Streaming dá-lhe controlo total sobre como os dados fluem no seu pipeline, embora exija mais desenvolvimento e manutenção.
Entre estes extremos, encontram-se ferramentas como Auto Loader para ficheiros de armazenamento na cloud, COPY INTO para carregamento em lote com SQL, e abordagens baseadas em notebooks usando ligações JDBC/ODBC. Adicionalmente, o Azure Data Factory serve como uma camada de orquestração que pode coordenar o movimento de dados para o Azure Databricks a partir do ecossistema Azure mais amplo.
Conexão Lakeflow
O Lakeflow Connect representa a abordagem moderna à ingestão de dados no Azure Databricks. Oferece tanto conectores totalmente geridos como conectores padrão que se integram com os pipelines Lakeflow para uma experiência simplificada.
Os conectores geridos estão organizados em três tipos:
Os conectores SaaS fornecem integração pronta a usar com aplicações empresariais como Salesforce, ServiceNow, SharePoint, HubSpot, Jira, Microsoft Dynamics 365, Workday, Zendesk e muitas outras. Estes conectores tratam da autenticação específica da fonte, leituras incrementais, limitação de taxa da API, evolução de esquemas e tentativas automáticas. Funcionam em computação serverless e escrevem em tabelas de streaming geridas pelo Unity Catalog.
Conectores de base de dados ingerem dados de bases de dados relacionais incluindo MySQL, PostgreSQL e SQL Server utilizando captura de dados de alteração (CDC). Como os conectores baseados em CDC lêem dos registos de transações da base de dados em vez de consultar tabelas diretamente, requerem um gateway de ingestão implementado na sua rede e um volume de armazenamento temporário para guardar as alterações registadas.
Os conectores comunitários são conectores open-source construídos e mantidos pela comunidade. Eles estendem o Lakeflow Connect para fontes que ainda não têm um conector gerido. Pode usar um conector comunitário existente ou contribuir com o seu próprio.
Observação
O ecossistema de conectores está a crescer rapidamente. Consulte a documentação dos conectores gerenciados para ver a lista completa e atual de fontes suportadas.
Os conectores padrão estendem o Lakeflow Connect ao armazenamento de objetos na cloud e aos barramentos de mensagens. Pode ingerir dados do Amazon S3, Azure Data Lake Storage ou Google Cloud Storage usando o Auto Loader. Para dados em tempo real, os conectores padrão suportam Apache Kafka, Google Pub/Sub e Apache Pulsar.

Considere o Lakeflow Connect quando precisar de uma ingestão fiável e de baixa manutenção de fontes suportadas. Os conectores geridos reduzem significativamente o tempo de desenvolvimento e a manutenção contínua em comparação com soluções personalizadas. No entanto, se a sua fonte de dados não for suportada ou precisar de uma lógica de ingestão altamente especializada, poderá ter de explorar outras opções.
O Lakeflow Connect suporta tanto a ingestão programada (horária, diária, semanal) como triggers sob demanda, o que o torna adequado para ciclos regulares de atualização de dados e cenários de carregamento ad hoc.
Conectores baseados em consulta
Os conectores baseados em consulta são uma alternativa leve aos conectores de base de dados CDC para ingestão programada a partir de bases de dados relacionais. Em vez de lerem os registos de transações, consultam diretamente a tabela de origem usando uma coluna de cursor — um carimbo de data/hora ou um número inteiro que aumenta de forma monótona, indicando quais linhas são novas ou foram atualizadas desde a última execução do pipeline.
Como consultam a fonte diretamente, os conectores baseados em consultas não precisam de um gateway de ingestão nem de armazenamento temporário. Em cada execução agendada, o conector recupera todas as linhas com um valor de coluna de cursor maior do que o ponto máximo da execução anterior e depois escreve resultados em tabelas de streaming no Unity Catalog.
As fontes suportadas incluem Oracle, Teradata, SQL Server, MySQL, MariaDB, PostgreSQL e todas as fontes de dados da Lakehouse Federation.
Conectores baseados em consulta suportam três modos de rastreamento de histórico para tabelas de destino:
- SCD Tipo 1: Sobrescreve a linha existente com a linha de origem mais recente. Nenhuma história é preservada.
- SCD Tipo 2: Preserva o histórico completo ao adicionar novas linhas com metadados de versões.
- Apenas acrescentar: Anexa todas as linhas ingeridas sem fundir ou sobrescrever.
Escolha conectores baseados em consulta em vez de conectores de base de dados CDC quando a infraestrutura CDC ou binlog não estiver disponível, mas existir uma coluna cursor fiável na fonte. Escolha conectores CDC quando precisar de todos os estados intermédios da linha entre execuções de pipeline ou quando o rastreamento soft-delete for crítico. A desvantagem é que os conectores baseados em consulta colocam mais carga diretamente nas tabelas de origem em comparação com os conectores CDC, que leem do binlog.
Carregador Automático
O Auto Loader fornece processamento incremental de ficheiros para dados que chegam ao armazenamento na cloud. Em vez de analisar diretórios inteiros para encontrar novos ficheiros, o Auto Loader rastreia eficientemente quais os ficheiros que foram processados e ingere apenas as novas chegadas.
O Auto Loader funciona mantendo o estado num ponto de controlo que rastreia ficheiros processados. Quando novos ficheiros chegam ao seu armazenamento na cloud, o Auto Loader descobre-os através de listagem de diretórios ou do modo notificação de ficheiros. A listagem de diretórios analisa periodicamente novos ficheiros, enquanto o modo de notificação de ficheiros utiliza eventos nativos na cloud para deteção imediata.
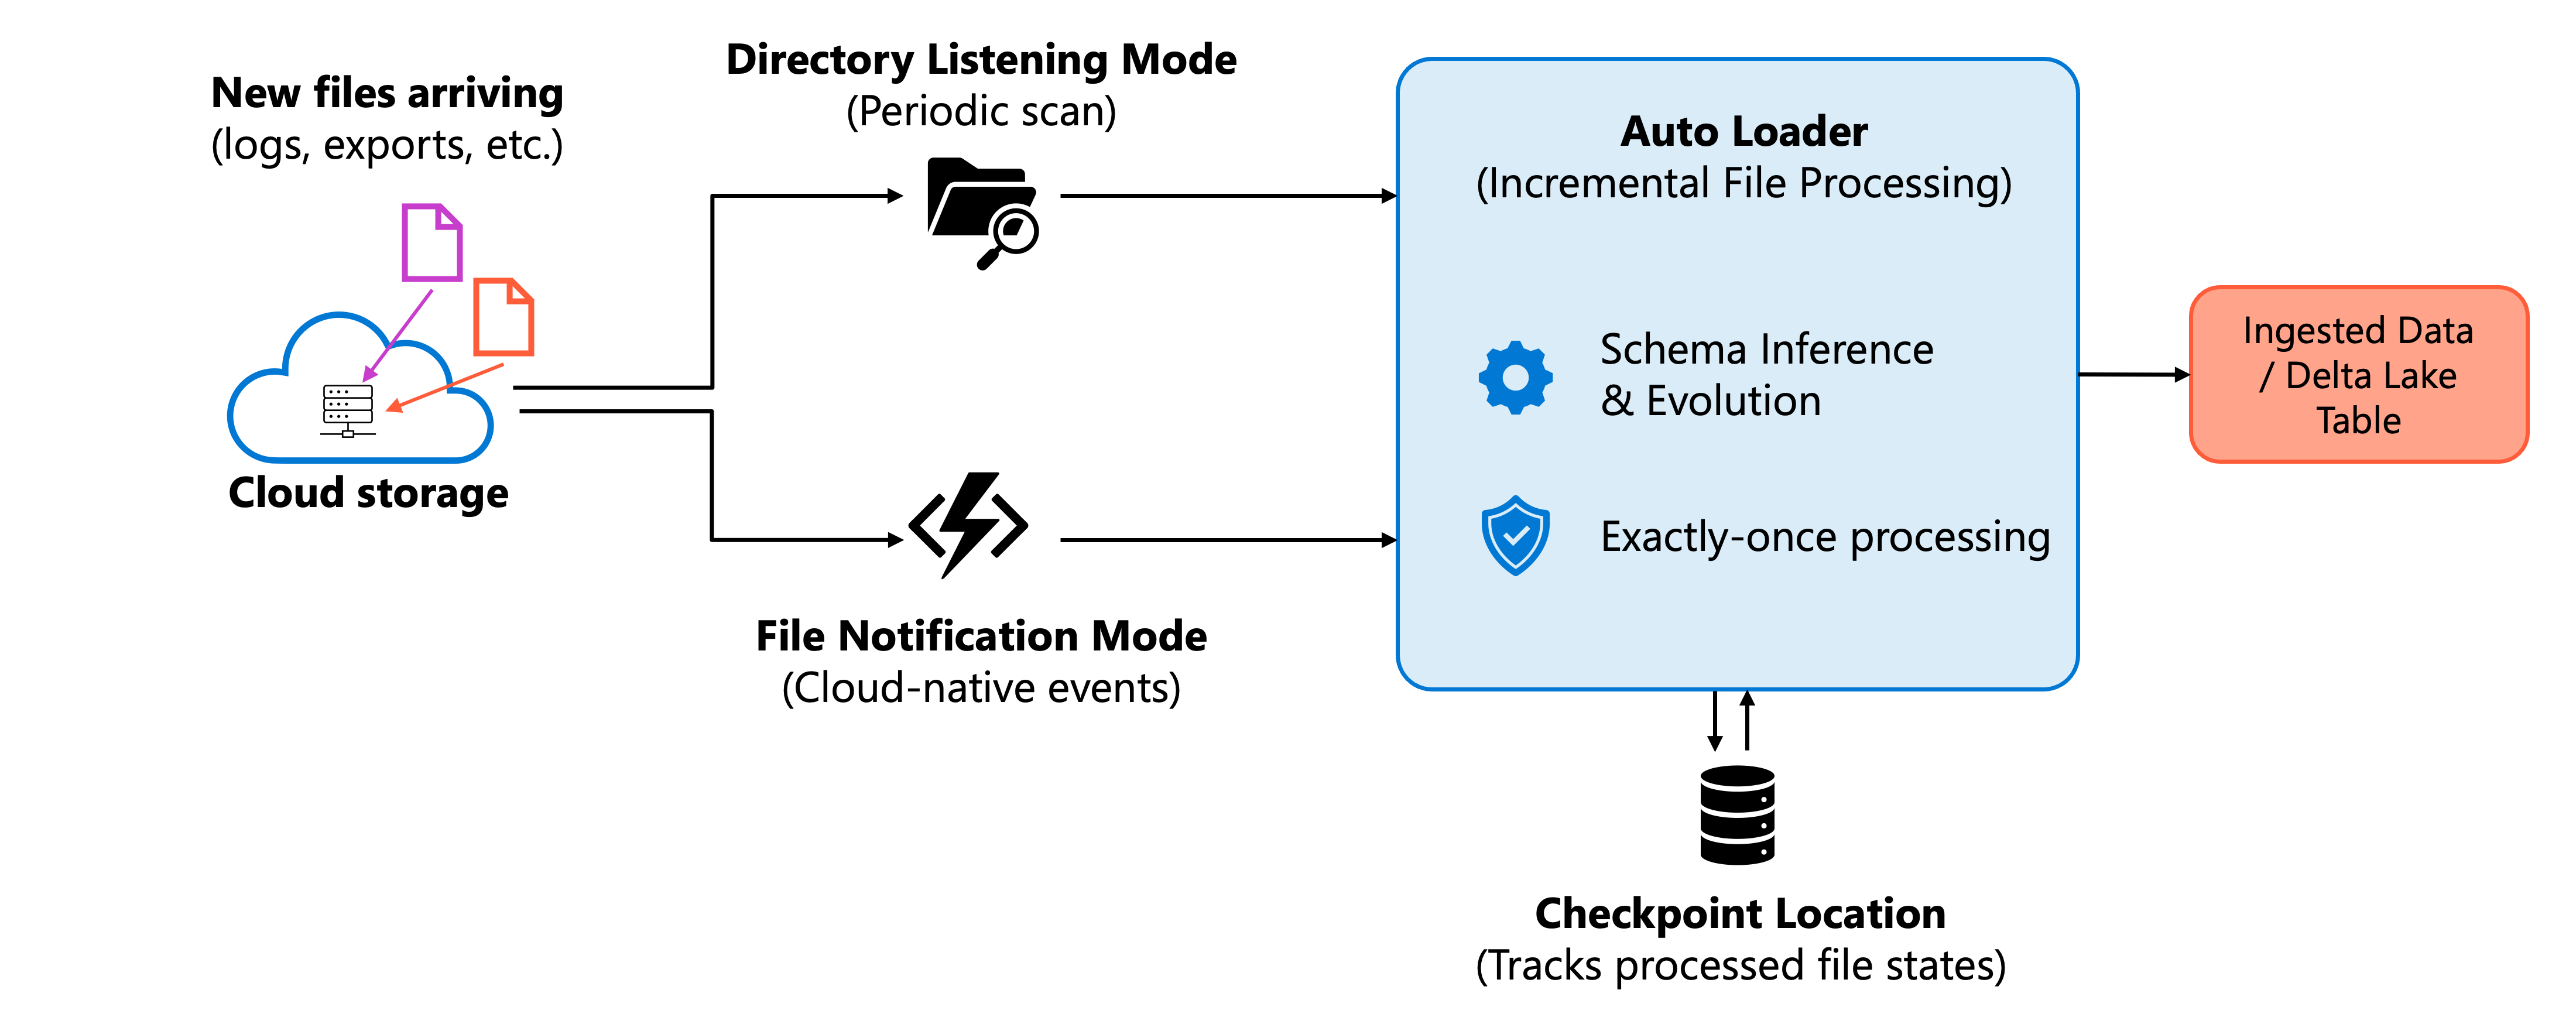
As principais capacidades do Auto Loader incluem:
- Inferência e evolução de esquemas: Detete automaticamente o esquema dos ficheiros recebidos e gere as alterações de esquema de forma elegante.
- Processamento exatamente uma vez: Garante que cada ficheiro é processado uma vez, mesmo em caso de falhas e reinícios.
- Escalabilidade: Lida eficientemente com milhares de milhões de ficheiros para preenchimentos ou migrações.
- Suporte de formato: Processa ficheiros JSON, CSV, Parquet, Avro, ORC, XML, texto e binários.
O Auto Loader adapta-se a cenários em que os dados chegam como ficheiros em armazenamento na cloud — padrões comuns incluem ficheiros de registo, exportações de sistemas upstream e zonas de aterragem de dados. Pode usar o Auto Loader com pipelines Lakeflow para uma experiência gerida ou com Structured Streaming para mais controlo.
INSERIR EM
O COPY INTO comando SQL carrega dados do armazenamento na cloud para tabelas Delta. Ao contrário do Auto Loader, que corre continuamente como um fluxo, COPY INTO executa-se como uma operação em lote que se agenda ou aciona manualmente.
COPY INTO rastreia quais os ficheiros que já processou, tornando a operação idempotente. Executar o mesmo comando várias vezes não duplica dados porque os ficheiros carregados anteriormente são saltados. Esta característica torna COPY INTO útil para trabalhos em lote agendados nos quais se deseja comportamentos previsíveis e repetíveis.
Observação
Os metadados de rastreio são armazenados como parte do registo de transações da tabela Delta (o _delta_log diretório)

Cenários comuns para COPY INTO incluem migrações de dados únicas, cargas em lote agendadas a partir das zonas de entrada e fluxos de trabalho SQL-first onde prefere sintaxe declarativa em vez das APIs de streaming.
Escolha COPY INTO em vez do Auto Loader quando estiver a realizar uma carga em lote única de um grande conjunto de dados.
COPY INTO fornece um modelo de configuração mais simples sem necessidade de infraestrutura de streaming, tornando-o ideal para carregar centenas de gigabytes ou até terabytes de dados numa única operação. O modelo de processamento contínuo e a gestão de checkpoints do Auto Loader acrescentam complexidade desnecessária quando só precisas de carregar dados uma vez.
No entanto, para uma ingestão incremental contínua em escala, o Auto Loader oferece melhor desempenho e uma descoberta de ficheiros mais robusta.
Streaming estruturado do Spark
O Spark Structured Streaming fornece a base para o processamento de dados em tempo real no Azure Databricks. Permite a ingestão contínua de várias fontes de streaming com garantias de processamento exatamente uma vez.
As fontes de streaming suportadas incluem:
- Apache Kafka e Hubs de Eventos do Azure: Para arquiteturas orientadas a eventos e processamento de filas de mensagens.
- Fluxos de alterações do Delta Lake: Para propagar alterações entre tabelas Delta.
- Armazenamento na cloud via Auto Loader: Para integração de streaming baseada em ficheiros.
- Soquete e fontes personalizadas: Para cenários especializados de ingestão.
Escolha Structured Streaming quando precisar de controlo detalhado sobre o comportamento do streaming, marca de água personalizada ou lógica de janelas, ou ao trabalhar com fontes não suportadas por abstrações de nível superior.
Ligações JDBC e ODBC
A ingestão baseada em cadernos de notas usando JDBC ou ODBC continua a ser uma abordagem prática para extrair dados de bases de dados relacionais. Escreves código que se liga diretamente às bases de dados de origem, executa consultas e carrega resultados em tabelas Delta.
Esta abordagem suporta praticamente qualquer base de dados com um driver JDBC ou ODBC: SQL Server, Oracle, PostgreSQL, MySQL e muitos outros. Implementas cargas completas ou incrementais escrevendo consultas apropriadas, muitas vezes usando colunas de referência para acompanhar o progresso da extração.
Embora os conectores geridos Lakeflow Connect estejam a substituir o JDBC/ODBC em muitos cenários, as ligações baseadas em blocos de notas continuam a ser valiosas quando:
- A sua base de dados não é suportada pelos conectores geridos do Lakeflow Connect.
- Precisas de uma lógica de extração personalizada que os conectores geridos não conseguem acomodar.
- Está a gerir pipelines existentes que adotam este padrão.
- Exigem otimizações específicas de query pushdown para tabelas grandes.
Ao usar JDBC/ODBC, armazene as credenciais de forma segura usando os segredos do Databricks em vez de os codificar fixamente em cadernos. Considere o impacto no desempenho nos sistemas fonte e implemente a limitação ou agendamento adequados para evitar bases de dados transacionais sobrecarregadas.
Para bases de dados on-premises, é necessária infraestrutura de rede adicional — seja Azure ExpressRoute/VPN para conectividade JDBC direta a partir do Databricks, ou Azure Data Factory com um Runtime de Integração Auto-Hospedado para depositar os dados primeiro no armazenamento na nuvem.
Azure Data Factory
O Azure Data Factory (ADF) serve como uma plataforma de orquestração e movimentação de dados dentro do ecossistema Azure. Destaca-se na coordenação de fluxos de trabalho que abrangem múltiplos serviços e no direcionamento de dados de diversas fontes para armazenamento na cloud, onde o Azure Databricks pode processá-los.
O ADF integra-se extensivamente com serviços da Microsoft como Dynamics 365, Base de Dados SQL do Azure e Microsoft Fabric. Quando os seus dados provêm destas fontes, o ADF fornece conectividade direta e pode colocar os dados no Azure Data Lake Storage para processamento subsequente de Databricks.
Compreender o papel adequado da ADF é importante. Use ADF para:
- Orquestração: Coordenação de fluxos de trabalho que envolvem múltiplos serviços da Azure.
- Aterragem inicial dos dados: Transferir dados das fontes Azure para armazenamento na cloud.
- Integração empresarial: Quando a política da empresa exige o ADF para a movimentação de dados.

Evite usar ADF para transformações ETL de núcleo dentro dos Databricks. Executar transformações através de atividades ADF introduz complexidade desnecessária e tem um desempenho menos eficiente do que o processamento nativo do Databricks. Deixe o ADF tratar da movimentação dos dados para o seu lakehouse, depois use as ferramentas do Azure Databricks para a lógica de transformação.
Aplicar um quadro de decisão
A escolha de uma ferramenta de ingestão torna-se mais clara quando avalia o seu cenário com base em critérios-chave de decisão.
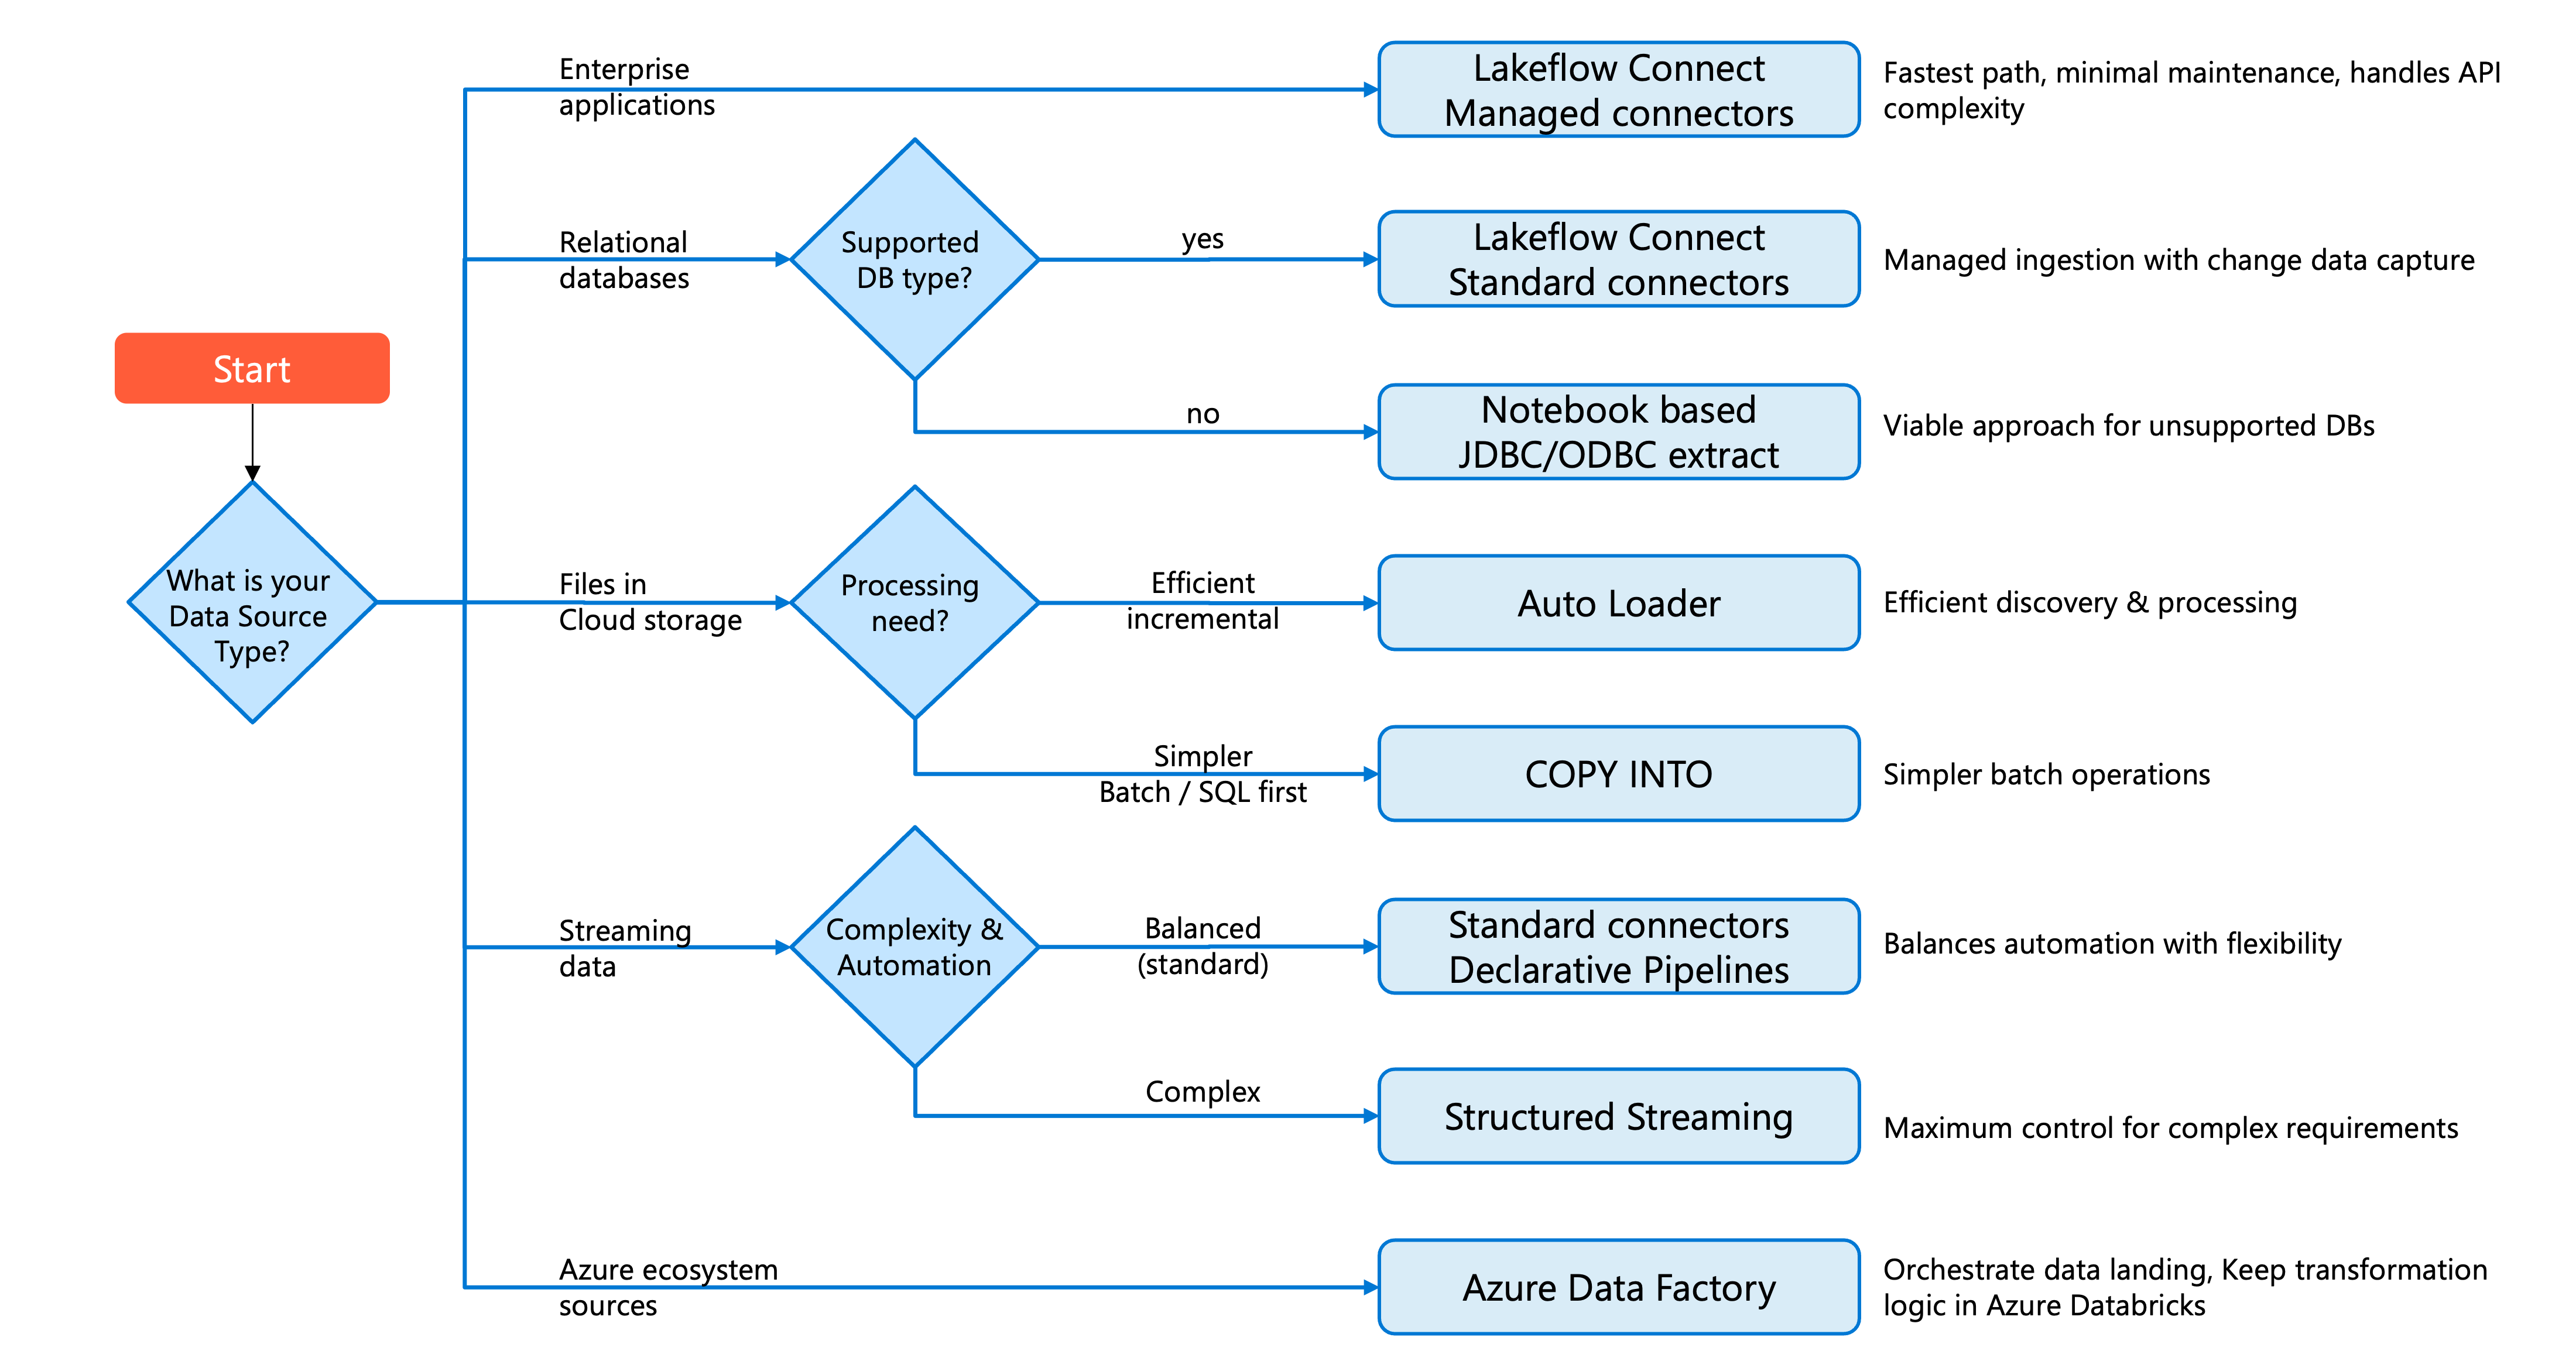
Comece por identificar o tipo de fonte de dados e depois considere os requisitos operacionais e o contexto organizacional.
Para aplicações empresariais (Salesforce, ServiceNow, SharePoint), os conectores geridos Lakeflow Connect oferecem o caminho mais rápido para a produção com manutenção mínima. Estes conectores tratam da complexidade da integração da API, limitação de taxa e acompanhamento de alterações.
Para bases de dados relacionais com tipos suportados, o Lakeflow Connect oferece dois caminhos geridos: conectores de base de dados (baseados em CDC, requerem gateway) para captura contínua de alterações, e conectores baseados em consulta para uma ingestão programada mais simples usando uma coluna de cursor. Para bases de dados não suportadas, a extração JDBC/ODBC baseada em notebooks continua a ser uma abordagem viável.
Para ficheiros em armazenamento na cloud, o Auto Loader proporciona descoberta e processamento incremental eficiente. Use COPY INTO para cenários em lote mais simples ou quando preferir fluxos de trabalho com SQL-first.
Para streaming de dados de barramentos de mensagens (Kafka, Event Hubs, Pub/Sub), conectores padrão com pipelines Lakeflow equilibram automação com flexibilidade. Para requisitos complexos de streaming, o Structured Streaming oferece controlo máximo.
Para fontes do ecossistema Azure que requerem coordenação com outros serviços, o Azure Data Factory pode orquestrar o fluxo de dados para o seu lakehouse. Mantenha a lógica de transformação dentro do Azure Databricks em vez de nos fluxos de dados ADF.
Sugestão
Comece pela opção mais gerida que satisfaz os seus requisitos. Os conectores geridos reduzem o tempo de desenvolvimento e a carga de manutenção. Só mude para abordagens mais personalizáveis quando requisitos específicos não puderem ser cumpridos por abstrações de nível superior.
A tua escolha também depende das competências da equipa e dos padrões organizacionais. Documente as suas decisões e o raciocínio por detrás delas para ajudar os futuros membros da equipa a compreender a arquitetura do pipeline.