Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Den här självstudien vägleder dig genom att konvertera Oracle-databasscheman till Azure Database for PostgreSQL med hjälp av Visual Studio Code PostgreSQL-tillägget med Microsoft Foundry för att generera och granska PostgreSQL-definitioner.
Den omfattar att ansluta till Oracle-källan och målet Azure Database for PostgreSQL, att konfigurera Microsoft Foundry, att köra migreringsguiden och att granska de genererade PostgreSQL-artefakterna. Innan du börjar kontrollerar du att du har nätverksåtkomst och autentiseringsuppgifter för både servrar och en Microsoft Foundry-distribution.
Det här kan du förvänta dig under konverteringen:
- Schemaidentifiering: Verktyget analyserar dina Oracle-schemaobjekt.
- AI-bearbetning: Microsoft Foundry bearbetar och konverterar kompatibla objekt.
- Scratch-database-kontroller: Verktyget försöker kompilering och tillgängliga statiska kontroller. Funktions-, data- och programvalidering förblir separata.
- Objektgranskning: Använd Conversion Object Explorer för att inspektera resultat och förfina genererade PostgreSQL-definitioner.
- Utdatagenerering: Objekt som konverterats sparas som PostgreSQL-filer.
Förutsättningar
I det här avsnittet beskrivs kraven för att använda schemakonverteringsfunktionen Oracle till Azure Database for PostgreSQL i Visual Studio Code innan du påbörjar en konvertering.
Systemkrav
| Kategori | Detaljer |
|---|---|
| Visual Studio Code-version | 1.95.2 eller senare |
| GitHub Copilot prenumeration | Pro+, Business, Enterprise |
Stöd för operativsystem
| Operativsystem | Supportinformation |
|---|---|
| Windows | endast x64-arkitektur |
| Linux | x64-arkitektur |
| macOS | macOS 13+ |
Målkrav för Azure Database for PostgreSQL
| Component | Versionskrav |
|---|---|
| Azure-databas för PostgreSQL | PostgreSQL version 15 eller senare |
| Scratch-databas | Azure Database för PostgreSQL – den flexibla servern |
Krav för AI-modell
Du behöver någon av följande AI-komponenter konfigurerade:
| AI-komponent | Modellversion |
|---|---|
| Microsoft Foundry | GPT-5.2-driftsättning |
distributionskonfiguration för Microsoft Foundry
I Microsoft Foundry skapar du en distribution som använder modellen gpt-5.2. Distributionsnamnet är det du valde när du skapade distributionen. Den behöver inte matcha modellnamnet.
Slutpunkten är din resurs-URL för Microsoft Foundry. Microsoft Foundry-resurser exponerar flera motsvarande värdnamn. Något av följande format är giltigt:
https://{your-resource}.services.ai.azure.comhttps://{your-resource}.openai.azure.comhttps://{your-resource}.cognitiveservices.azure.com
Ersätt {your-resource} med resursnamnet Microsoft Foundry (till exempel oracletopg). Om du behöver anropa en slutsatsdragningsväg direkt är /openai/responses?api-version=2025-04-01-previewden aktuella förhandsgranskningssökvägen .
Mer information om slutpunktsformat och slutsatsdragningsvägar finns i Endpoints för Microsoft Foundry Models.
Tip
Om du vill dirigera Microsoft Foundry-trafik via Azure API Management för centraliserad styrning, begränsning och observerbarhet konfigurerar du en AI-gateway framför din Foundry-resurs och använder gateway-URL:en som slutpunkt. Mer information finns i Konfigurera AI Gateway i dina Foundry-resurser.
Nödvändiga databasbehörigheter
Innan du kör schemakonvertering kontrollera åtkomsten till källmetadata och behörigheter för scratch-database med databasadministratörerna. Oracle-kontot behöver åtkomst till schemametadata och databasordboksvyer, inte applikationens raddata. PostgreSQL-kontot måste kunna ta bort och återskapa matchande scheman och skapa objekt för validering. Använd ett dedikerat konto där det är möjligt och följ principen om minsta behörighet.
Käll-Oracle-privilegier
Följande minimibehörigheter krävs för oracle-källdatabasen:
| Privileg | Purpose |
|---|---|
| CONNECT | Grundläggande databasanslutning |
| SELECT_CATALOG_ROLE | Åtkomst till dataordlistevyer |
| VÄLJ VALFRI ORDLISTA | Läsa systemmetadata och ordlisteobjekt |
VÄLJ SYS.ARGUMENT$ |
Åtkomst till information om procedurer och funktionsargument |
VÄLJ SYS.V_$RESOURCE_LIMIT |
Åtkomst till sessions- och processanvändning och -gränser via V$RESOURCE_LIMIT |
Behörigheter för scratch-databas
Ordna följande åtkomst på den valda scratch-databasen. Databasnivå CREATE ger inte behörighet att ta bort ett schema som ägs av en annan roll.
| Access | Purpose |
|---|---|
CONNECT i databasen |
Anslut för konvertering och validering. |
CREATE i databasen |
Skapa valideringsscheman. |
| Ägarskap för matchande scheman eller en lämplig behörig roll | Ta bort matchande scheman innan du återskapar dem. |
| Behörighet att skapa objekt i valideringsscheman | Skapa och kompilera konverterade definitioner. |
| Tilläggsinstallationsbehörigheter eller administratörshjälp | Installera de tillägg som krävs för konvertering och validering. |
Nätverkskrav
- Utgående anslutning: Microsoft Foundry-slutpunkter.
- Databasanslutning: Både källdatabasen Oracle och måldatabasen Azure Database for PostgreSQL Flexible Server.
- HTTPS-åtkomst: Visual Studio Code Extensions Marketplace och GitHub Copilot-tjänster.
- GitHub lagringsplatsåtkomst: https://github.com/microsoft/pgsql-tools/.
Oracle Instant Client (för tjockt klientläge)
Verktyget för schemakonvertering ansluter till Oracle med tunt klientläge som standard, vilket inte kräver någon extra programvara. Om din miljö kräver tjockt klientläge installerar du Oracle Instant Client på den dator som kör Visual Studio Code. Verktyget läser din sqlnet.ora och tnsnames.ora konfigurationen och växlar automatiskt till tjockt läge när en inställning kräver det.
Du kan avgöra om tjockt klientläge krävs genom att kontrollera Oracle-nätverkskonfigurationsfilerna i källmiljön. Leta efter följande parametrar i sqlnet.ora filen (finns vanligtvis i $ORACLE_HOME/network/admin/):
| Parameter | Anger att tjockt läge krävs |
|---|---|
SQLNET.CRYPTO_CHECKSUM_CLIENT |
Ange till REQUIRED eller REQUESTED för intern nätverkskryptering |
SQLNET.ENCRYPTION_CLIENT |
Ange till REQUIRED eller REQUESTED för intern nätverkskryptering |
Microsoft Foundry-autentisering
Konfigurera någon av följande autentiseringsmetoder för Microsoft Foundry:
| Autentiseringsmetod | Requirements |
|---|---|
| API-nyckel | Microsoft Foundry-slutpunkts-URL och API-nyckel. |
| Microsoft Entra-ID | Azure-kontotillägget är inloggat, och rollen Foundry User (tidigare Azure AI User) har tilldelats på Microsoft Foundry-resursen. |
Migreringsprocessen
Det här avsnittet går igenom konverteringsarbetsflödet. Du installerar tillägget, initierar ett projekt, ansluter till Oracle, granskar Discovery och konfigurerar scratch-databasen och Microsoft Foundry. Konverteringsförsök, kompilering och tillgängliga statiska kontroller i scratch-databasen. Sedan granskar och förfinar du utdata, distribuerar den till en separat icke-produktionsdatabas och verifierar den oberoende innan den tas i produktion.
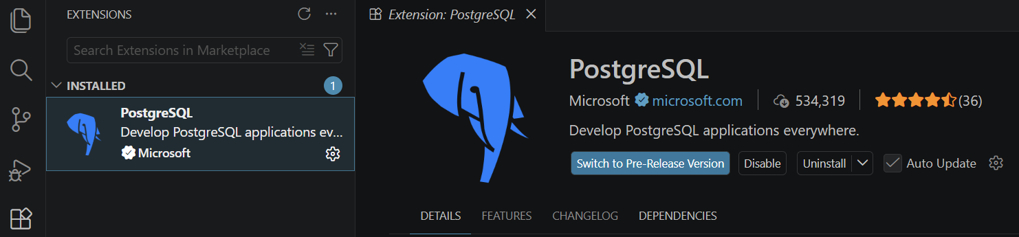
Steg 1: Installera Tillägget PostgreSQL Visual Studio Code
Öppna Visual Studio Code.
Gå till vyn Tillägg (
Ctrl+Shift+X).Sök efter PostgreSQL och installera tillägget PostgreSQL publicerat av Microsoft.
Steg 2: Skapa en Azure Database for PostgreSQL anslutning
I postgreSQL-tilläggspanelen skapar du en anslutning till din Azure Database for PostgreSQL flexibel server instans.
Ange anslutningsinformationen (värd, databas, användarnamn, lösenord).
Testa och spara anslutningen.


Steg 3: Öppna en ny arbetsyta
Skapa en ny mapp på den lokala datorn för migreringsprojektet.
Öppna mappen som en ny arbetsyta i Visual Studio Code.


Steg 4: Initiera ett migreringsprojekt
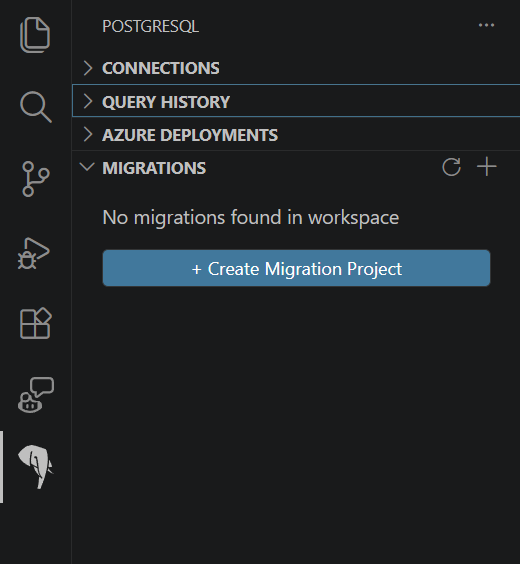
Öppna PostgreSQL-tillägget.
Gå till panelen Migreringar.
Välj Skapa migreringsprojekt.
Steg 5: Konfigurera projektinställningar
I migreringsguiden anger du projektnamnet.
Klicka på Nästa när du vill fortsätta.


Steg 6: Konfigurera Oracle-anslutningen
Ange information om Oracle-anslutningen:
- Värd- eller servernamn.
- Portnummer.
- Databas- eller tjänstnamn.
- Användarnamn och lösenord.
Verktyget väljer tunt eller tjockt klientläge automatiskt från dina
sqlnet.orainställningartnsnames.ora. Användargränssnittet exponerar inte en manuell väljare. Tunt läge används som standard. Om dinsqlnet.orakräver thick mode, se till att Oracle Instant Client är installerat och att dess sökväg finns i miljövariabelnPATHinnan du fortsätter. Mer information finns i Oracle Instant Client.Välj Läs in scheman. Verktyget testar Oracle-anslutningen och visar, om det lyckas, alla användardefinierade scheman som är tillgängliga i Oracle.
Välj ett eller flera scheman för att konvertera till PostgreSQL.
Välj Nästa: Discovery.


Steg 7: Granska Discovery-resultat
Upptäckt visar källinventeringen och det planerade extraktionsomfånget. Ingen DDL extraheras i det här skedet. En förklaring av sammanfattningsantalet och omfånget finns i Discovery i översikten över schemakonvertering.
Vänta tills Discovery är klar.
Under Källbehörigheter granskar du varje kontroll, dess syfte och dess resultat. Granska misslyckade kontroller med din Oracle-databasadministratör. När du har löst behörighetsproblem väljer du Uppdatera Discovery och granskar de uppdaterade resultaten. De behörigheter som krävs finns i Oracle-källbehörigheter.
Granska sammanfattningsantalet Identifierade, Som ska extraheras, Exkluderade och Ogiltiga objekt.
Expandera Objekttyper som stöds för att granska antalet objekt som ska extraheras, Exkluderade och Ogiltiga objekt efter typ. En typ som stöds kan fortfarande ha undantagna objekt. dessa antal är inte konverteringsresultat.
Expandera Objekttyper som inte stöds för att granska kategorier som inte stöds i källan. För supportinformation och PostgreSQL-alternativ, se Begränsningar för schemakonvertering.
Under Beroende scheman granskar du refererade scheman som du inte valde. Välj Visa diagram för att visa referenserna. Siffrorna på kopplingarna representerar beroendereferenser, inte antalet objekt som ska extraheras eller konverteras.
Granska det separata meddelandet om refererade Oracle-systemscheman som inte migreras. Behandla inte dessa referenser som ytterligare applikationsscheman som valts för konvertering.
Om du behöver ändra schemavalet väljer du Föregående för att återgå till Anslut till Oracle, uppdatera Scheman och välj Nästa: Identifiering igen. Granska den uppdaterade omfattningen innan du fortsätter.
Välj Jag har granskat objekten, undantag och beroende scheman.
Välj Nästa: PostgreSQL-anslutning.


Steg 8: Konfigurera en Azure Database for PostgreSQL scratch-databas
Använd en tom eller dedikerad, oanvänd scratch-databas utan objekt eller data som du behöver bevara. Vägledning om förberedelser finns i Förbered scratch-databasen.
Välj den Azure Database for PostgreSQL anslutning som du definierade i PostgreSQL-tillägget.
Välj måldatabasen i listrutan.
Välj Verifiera tillägg. Om varningen Rekommenderade tillägg inte är installerad visas granskar du de tillägg som saknas. Följ vägledningen för förberedelse av scratch-database för att lägga till de tillägg som behövs i listan över tillåtna för servern och installera dem i den valda databasen och välj sedan Verifiera tillägg igen. Du kan fortsätta med varningen, men objekt som är beroende av saknade tillägg kan kräva manuella ändringar.
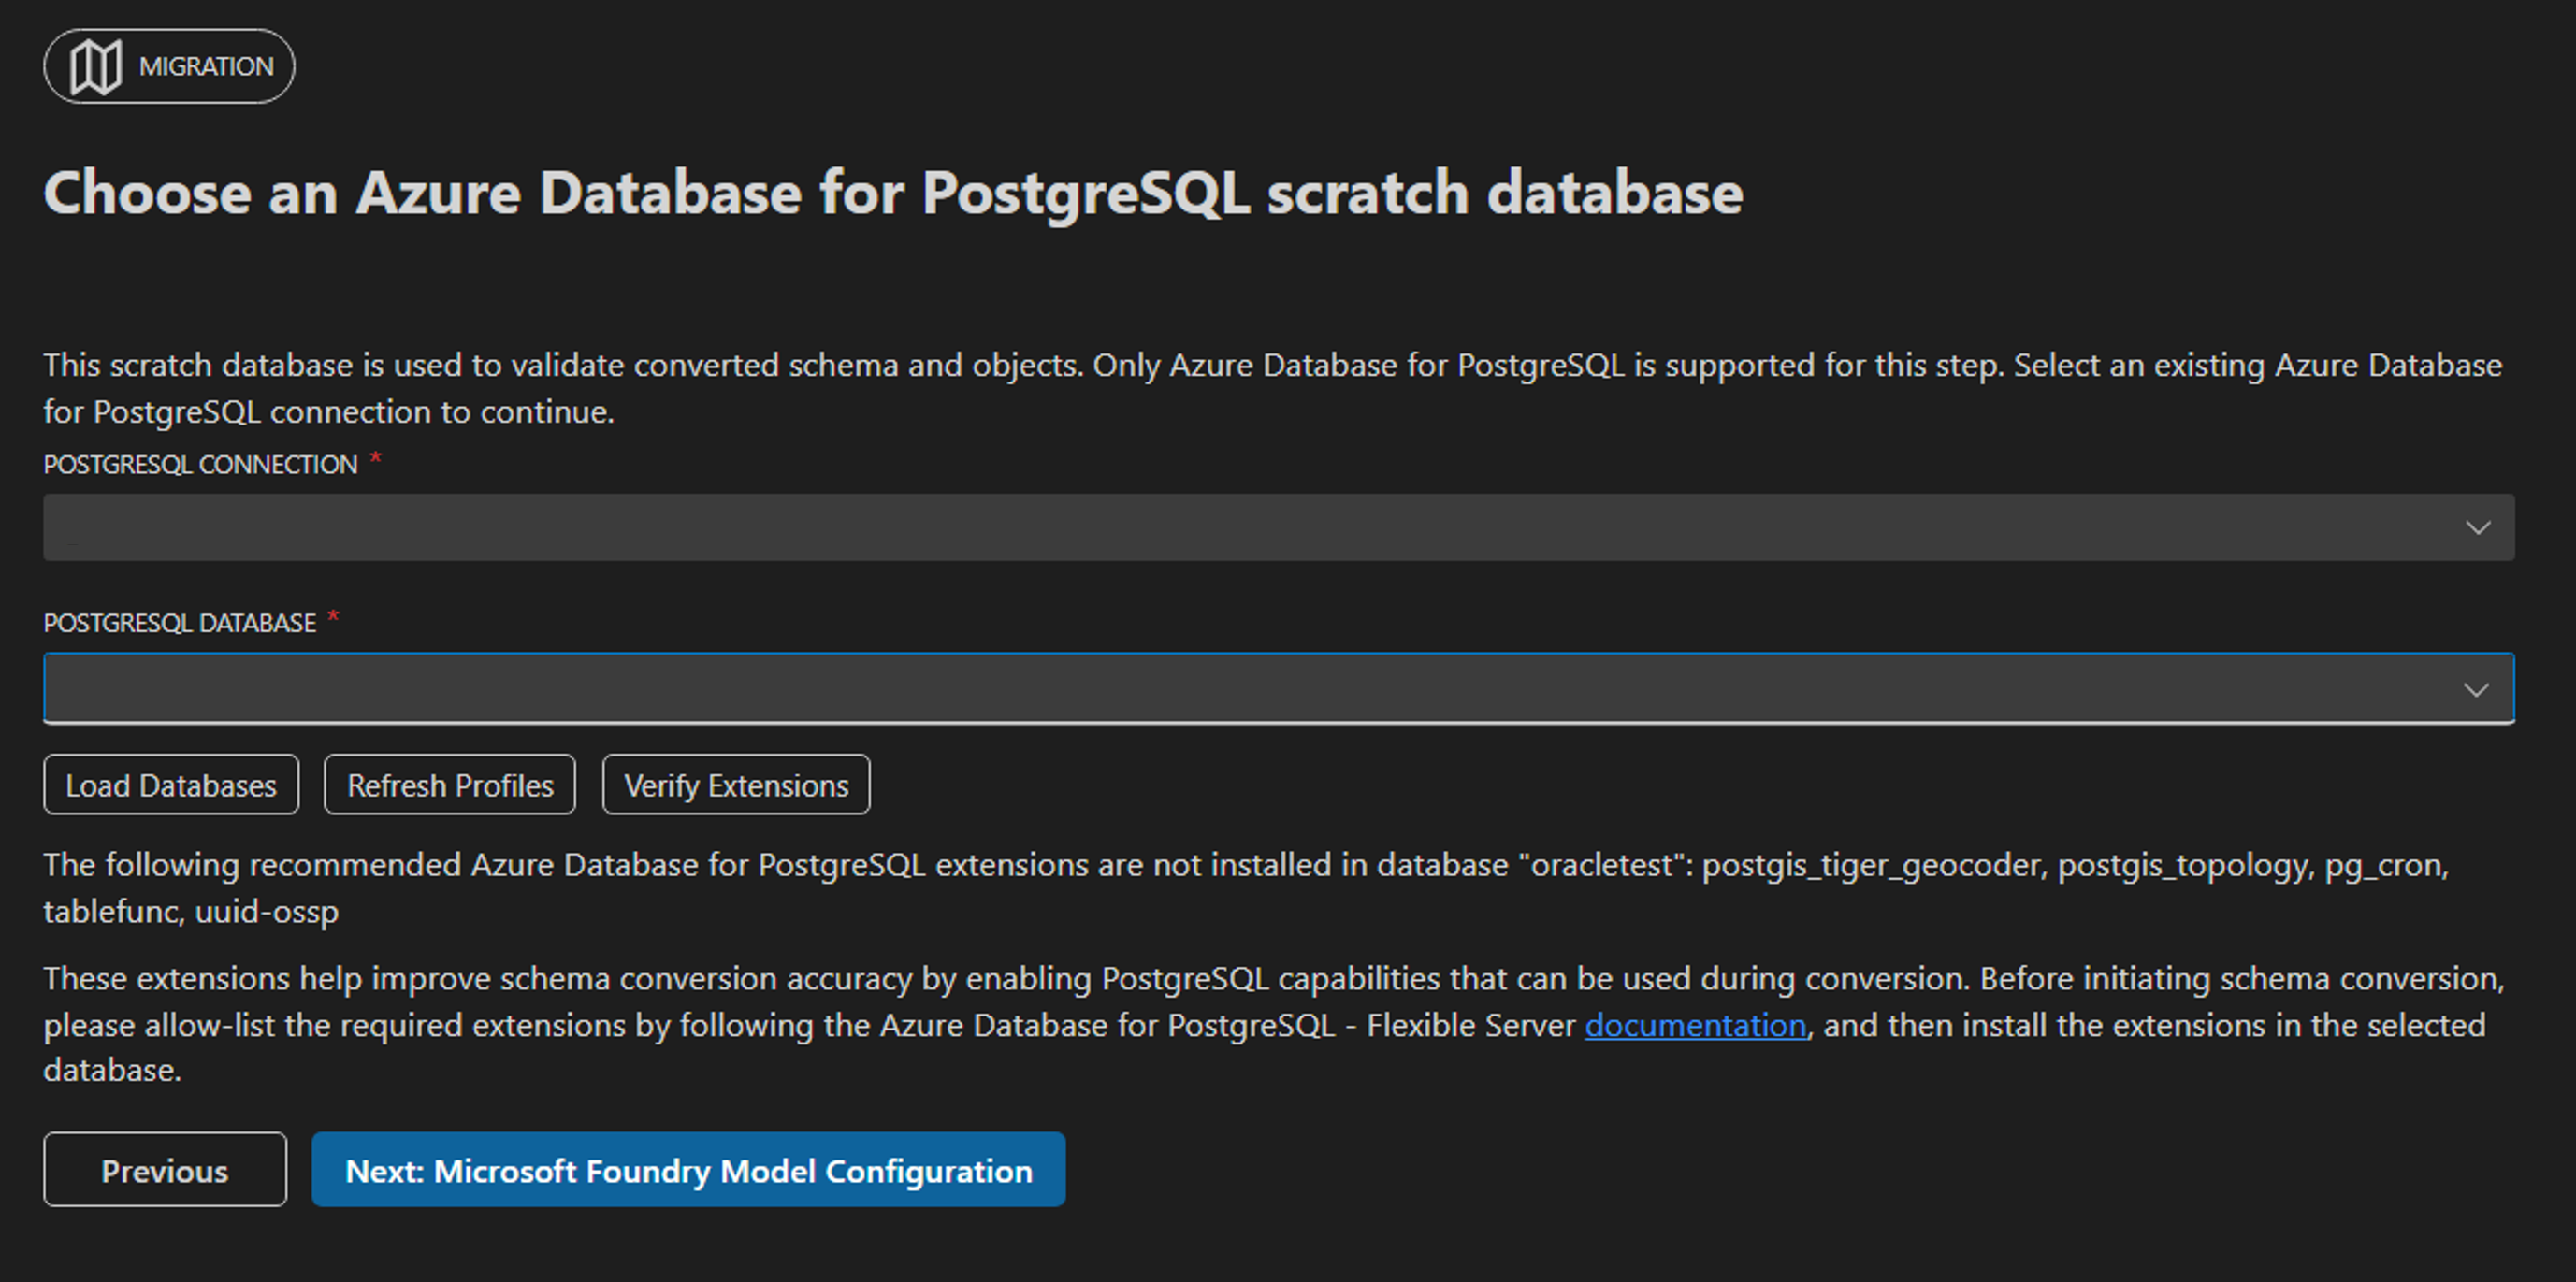
Markera kryssrutan som bekräftar att scratch-scheman som matchar de valda Oracle-schemana tas bort och återskapas under konverteringen och tar bort befintliga objekt och data.
Välj Nästa: Microsoft Foundry-modellkonfiguration.
Steg 9: Konfigurera språkmodellen Microsoft Foundry
I Microsoft Foundry allokerar du en distributionskvot för en distribution som är större än 1 000 000 token per minut (TPM). Följande distributionsexempel har konfigurerats för 2,3 miljoner TPM; den tillgängliga kvoten som visas är specifik för den miljön.

Gå tillbaka till migreringsguiden i Visual Studio Code för att konfigurera modellanslutningen:
- Ange din Microsoft Foundry-information:
- Slutpunkts-URL.
- Distributionsnamn (det namn som du tilldelade distributionen i Microsoft Foundry; den underliggande modellen måste vara
gpt-5.2).
- Välj autentiseringsmetod:
- API-nyckel: Ange API-nyckeln för din Microsoft Foundry-distribution.
- Microsoft Entra-ID: Logga in med Azure-kontotillägget. Verktyget hämtar autentiseringstoken automatiskt. Kontrollera att den inloggade identiteten har rollen Foundry User (tidigare Azure AI User) på resursen Microsoft Foundry. Mer information finns i Rollbaserad åtkomstkontroll för Microsoft Foundry.
- Välj Testa Microsoft Foundry-anslutning för att verifiera konfigurationen.
- När anslutningen har upprättats väljer du Skapa migreringsprojekt.
Steg 10: Kör schemakonverteringen
Systemet navigerar till huvudguiden för migrering.
Välj Migrera för att starta schemakonverteringsprocessen.
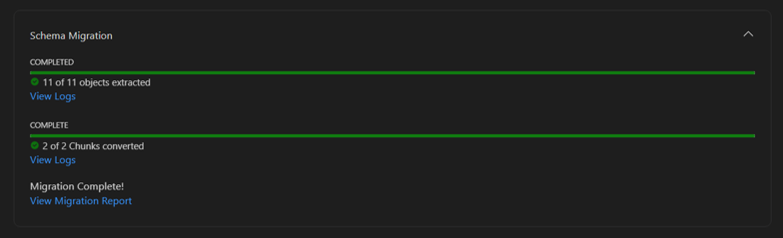
Övervaka konverteringsstatusen i Visual Studio Code-gränssnittet.
När konverteringen är klar visar projektet att schemakonverteringen är klar och åtgärden Granska konverteringssammanfattning .
Steg 11: Granska schemakonverteringsrapporten
- När schemakonverteringen är klar öppnas HTML-konverteringsrapporten automatiskt.
- Granska upptäckts-, extraherings- och konverteringsresultaten och anteckningar på objektnivå.
- Vägledning om hur du tolkar rapporten finns i Visa HTML-rapporten för Oracle-schemakonvertering.
Steg 12: Granska och förfina konverterade objekt
I det slutförda migreringsprojektet väljer du Granska konverteringssammanfattning.
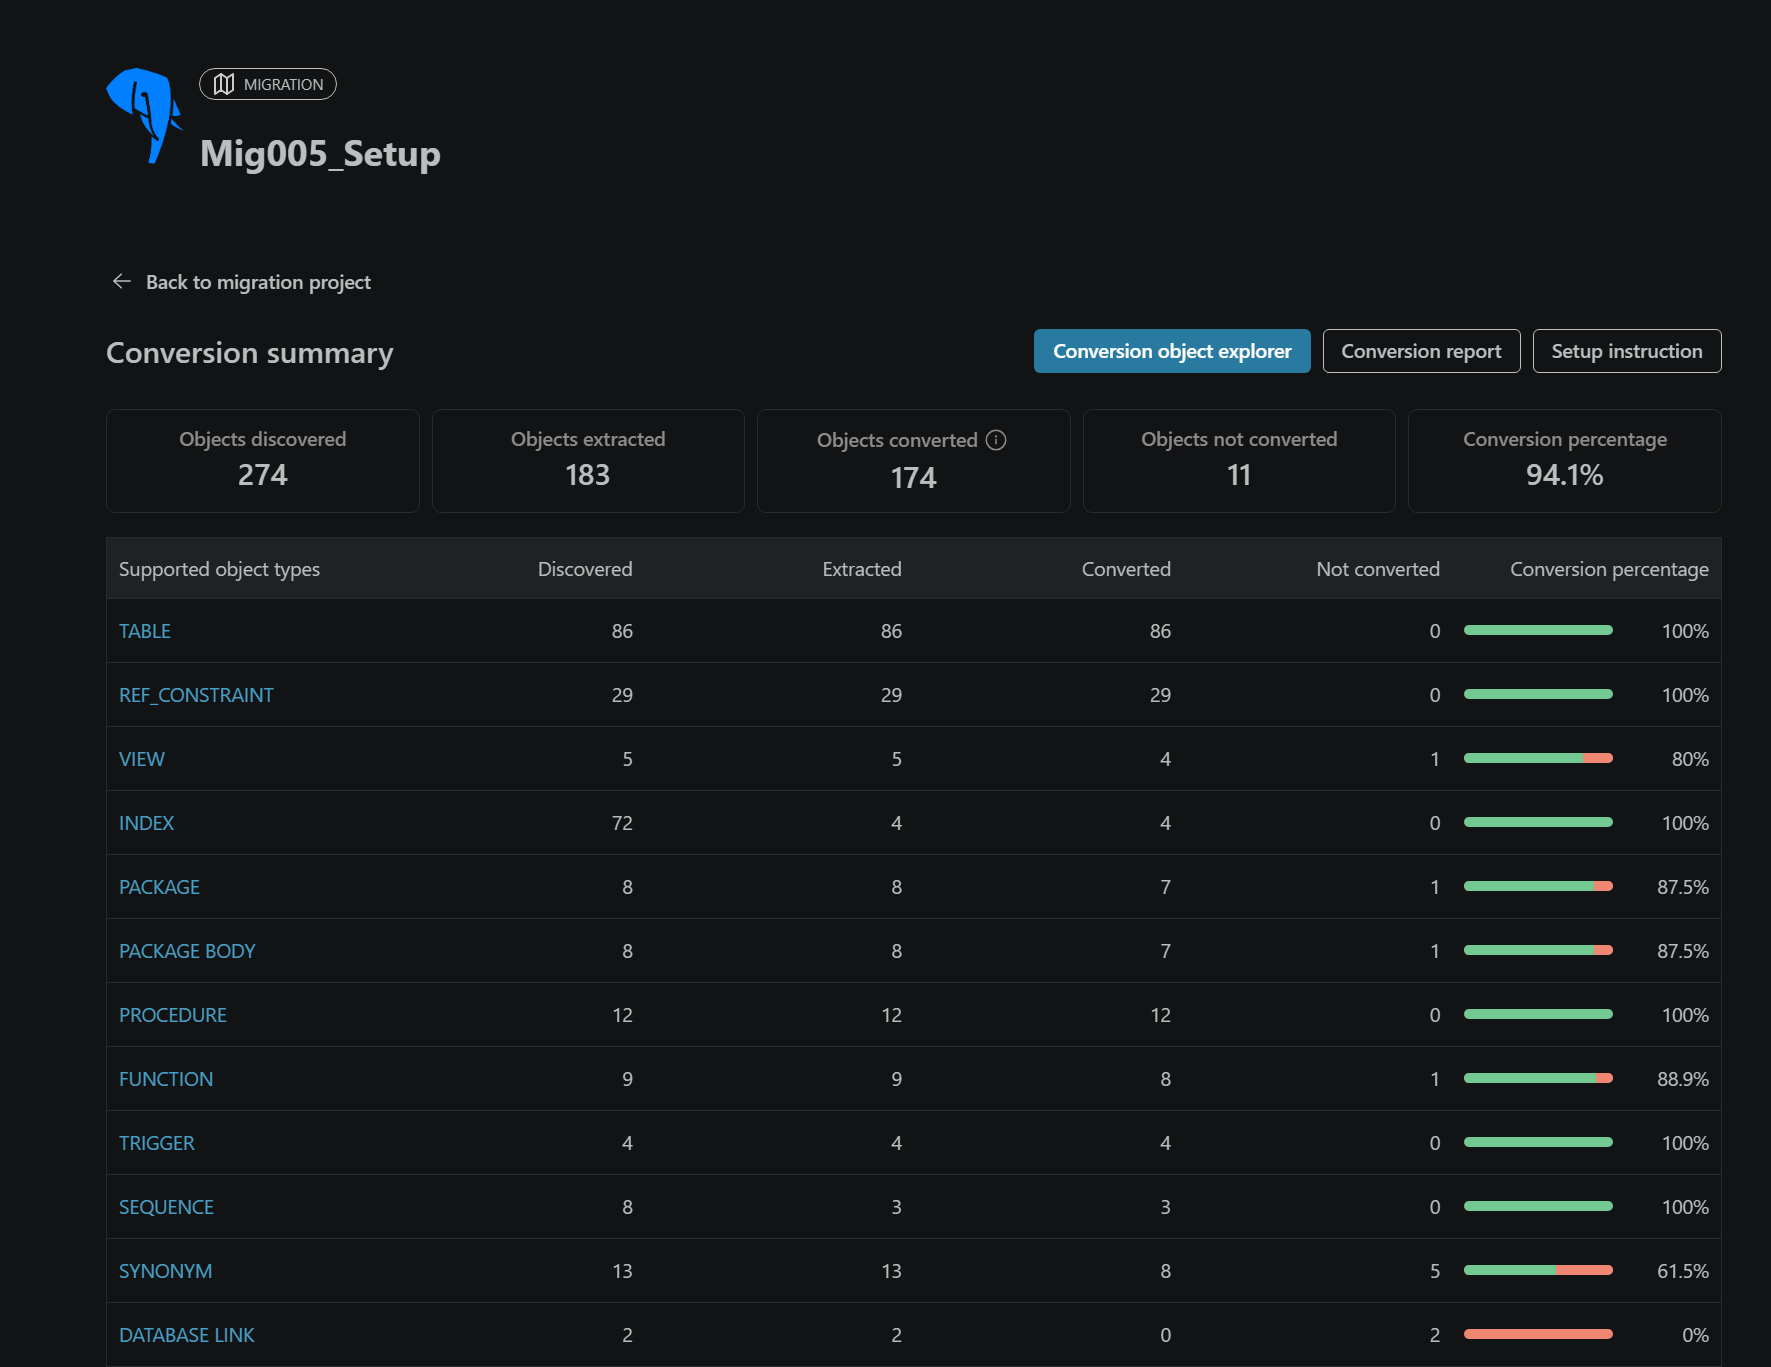
På sidan Konverteringssammanfattning väljer du Utforskaren för konverteringsobjekt.
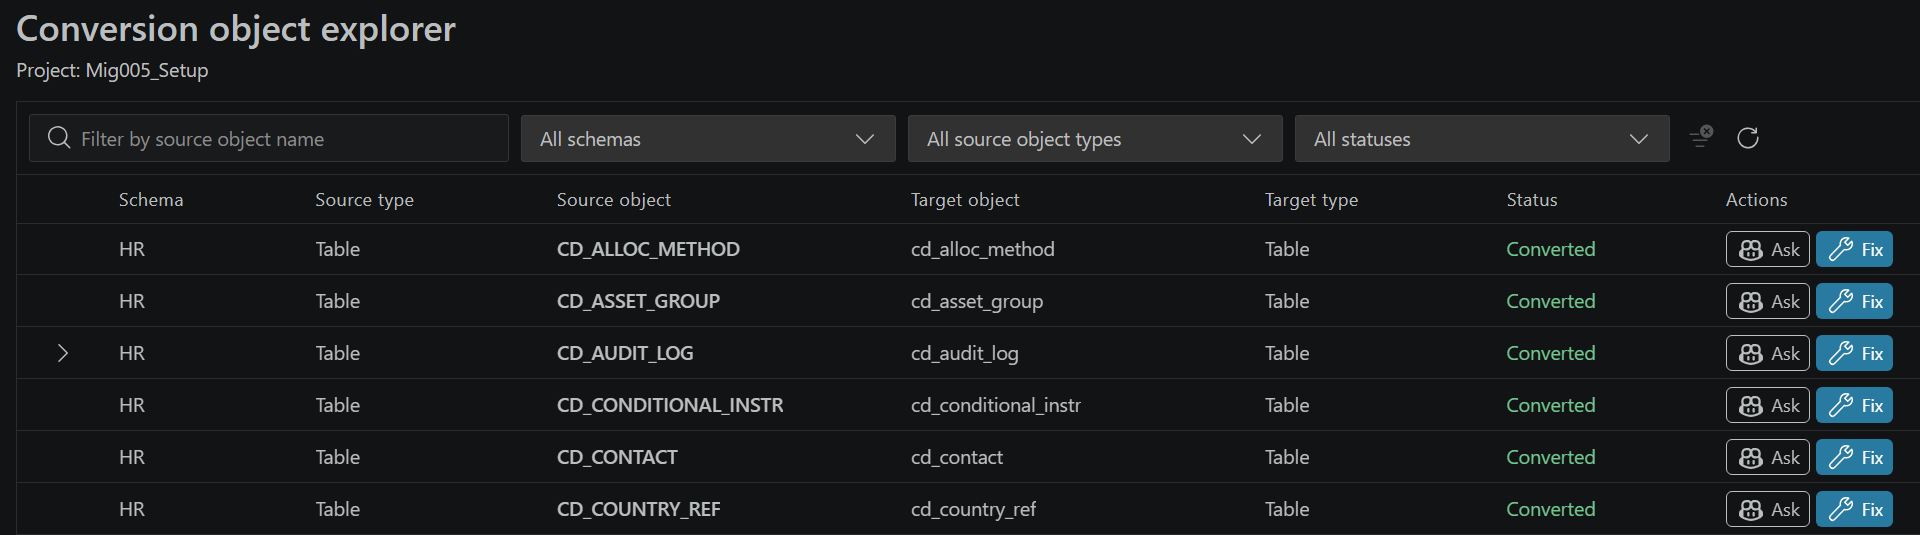
Välj ett objekt för att jämföra dess Oracle- och PostgreSQL-definitioner och läsa dess konverteringsanteckningar.
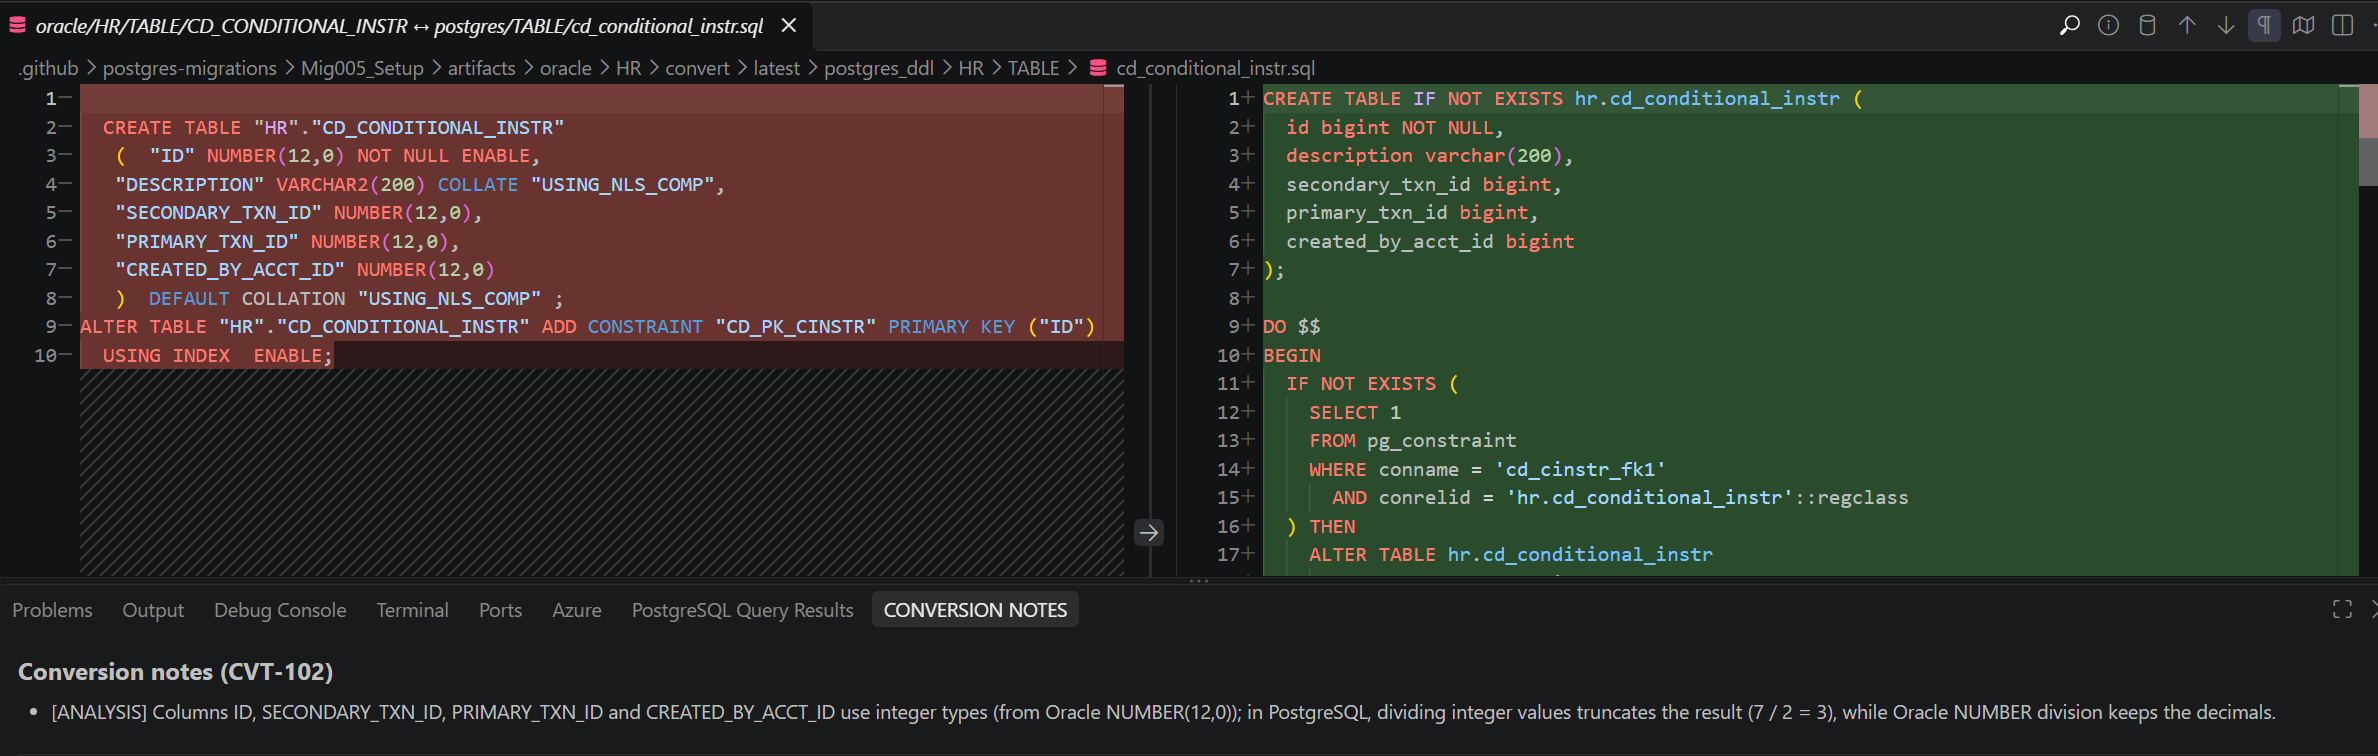
Använd Fråga för att förklara konverteringen och dess beroenden, eller Åtgärda för att öppna en Copilot-prompt och göra ändringar i PostgreSQL-filen.
Granska redigeringarna och bekräfta att driftsättnings-SQL innehåller de korrigeringar som du tänker distribuera. Anta inte att redigering av en fil per objekt uppdaterar den genererade
deploy.sql.
Information om filtrering, jämförelse och manuell kompilering finns i Granska konverterade objekt i Konvertering Object Explorer.
Steg 13: Förbereda driftsättningen med Setup Experience
Konverteringsarbetsflödet genererar automatiskt installationsfiler när det är klart. När du öppnar installationsanvisningarna startas ingen driftsättning.
- I det slutförda migreringsprojektet väljer du Granska konverteringssammanfattning.
- På sidan Konverteringssammanfattning väljer du Installationsinstruktioner. Den här åtgärden blir tillgänglig när installationsfilerna är klara.
- Granska den genererade
setup_instructions.mdfilen som öppnas i redigeraren. Visual Studio Code visar även installationsmappen i Explorer. - Följ Distribuera konverterade scheman med installationsmiljön för att förbereda en separat icke-produktionsdestinationsdatabas, köra beredskapskontroller, distribuera de konverterade schemana och granska distributionsresultaten.
Steg 14: Verifiera det distribuerade schemat före produktionsanvändning
Använd den icke-produktionsdatabas som distribuerades i föregående steg för funktions-, data- och programverifiering, inte konverteringsdatabasen.
Om du ändrar ett objekt efter distributionen måste du tillämpa korrigeringen manuellt:
- Anslut SQL-redigeraren till postgreSQL-servern som inte är produktion och databasen där det konverterade schemat distribueras. Bekräfta redigerarens aktiva databas.
- Granska schemareferenser och välj den fullständiga instruktion eller de instruktioner som du tänker köra.
- Välj Spela upp-knappen för att endast köra de valda instruktionerna. Granska körningsutdata och lös fel innan du fortsätter.
- Bekräfta att objektfilerna och distributions-SQL:et innehåller de testade korrigeringarna före produktionsdistributionen. Att uppdatera en fil, uppdatera ett distribuerat objekt och uppdatera
deploy.sqlär separata åtgärder.
Verifiera det driftsatta schemat oberoende med representativa testdata och applikationsarbetsbelastningar. Kontrollera beroenden, begränsningar, affärslogik och resultatuppsättningar mot Oracle-källan och testa igen efter korrigeringar. Granska alla objekt som inte har konverterats eller distribuerats, i stället för att bara testa lyckade konverteringar.
Important
Kundens valideringsansvar: Samma AI-motor som används för schemakonvertering kan också hjälpa till med validering och granskning. AI-system kan ibland bekräfta sina egna misstag. För att förhindra dataförlust, funktionella regressioner eller säkerhetsproblem kontrollerar du oberoende alla konverterade objekt och korrigeringar på objektnivå innan du distribuerar till produktion. Som en del av dina kontroller bör du överväga att aktivera filtrering av Microsoft Foundry-innehåll för att minska skadliga eller oönskade utdata. Vägledning finns i Content-filtrering för Microsoft Foundry Models.
Mer information om tillägget Visual Studio Code finns i PostgreSQL-tillägget för Visual Studio Code och Cursor.
Relaterat innehåll
- Vad är schemakonvertering från Oracle till Azure Database for PostgreSQL – flexibel server?
- Granska konverterade objekt i Conversion Object Explorer
- Distribuera konverterade scheman med Setup Experience
- Begränsningar för schemakonvertering från Oracle till Azure Database for PostgreSQL flexibel server