Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Gäller för: SQL ServerAzure SQL DatabaseAzure SQL Managed InstanceSQL-databas i Microsoft Fabric
Databasmotor för SQL Server bearbetar frågor om olika datalagringsarkitekturer, till exempel lokala tabeller, partitionerade tabeller och tabeller som distribueras över flera servrar. Följande avsnitt täcker hur Database Engine bearbetar frågor och optimerar återanvändning av frågor genom caching av exekveringsplaner.
Kodexemplen i denna artikel använder AdventureWorks2025, AdventureWorksDW2025, eller AdventureWorksLT2025 exempeldatabasen, som du kan ladda ner från Azure Data SQL Samples Repository GitHub-arkivet.
Körningslägen
Databasmotor för SQL Server kan bearbeta Transact-SQL (T-SQL)-satser i två olika bearbetningslägen:
- Radsvis körning
- Körning av batchläge
Radsvis körning
Körning i radläge är en frågebehandlingsmetod som används med radlagertabeller och index, där data lagras i radformat. När en fråga exekveras och får åtkomst till data i radlagringstabeller och index, läser operatorerna i exekveringsträdet och deras underordnade operatorer varje nödvändig rad över alla kolumner som specificeras i objektschemat. Från varje rad som läses hämtar Database Engine sedan de kolumner som krävs för resultatuppsättningen, som anges i en SELECT-sats, ett JOIN-predikat eller ett filterpredikat.
Not
körning i radläge är mycket effektiv för OLTP-scenarier, men kan vara mindre effektiv vid skanning av stora datamängder, till exempel i Data Warehousing-scenarier.
Körning av batchläge
Körning i batchläge är en frågebehandlingsmetod som behandlar flera rader tillsammans (därav termen batch). Varje kolumn i en batch lagras som en vektor i ett separat minnesområde, så bearbetning i batchläge är vektorbaserad. Batchbaserad bearbetning använder också algoritmer som är optimerade för avancerade instruktionsuppsättningar och ökad minnesgenomströmning i moderna processorer.
Batch-lägeskörning var ursprungligen integrerad och optimerad kring columnstore-lagringsformatet. Från och med SQL Server 2019 (15.x) och i Azure SQL Database kräver batch-utförande inte columnstore-index. Mer information finns i Batch-läge på rowstore-.
Batch-bearbetning arbetar med komprimerade data när det är möjligt, och den eliminerar exchange-operatorn som radlägesexekvering använder. Resultatet är bättre parallellitet och snabbare prestanda.
När en fråga körs i batchläge och kommer åt data i kolumnlagringsindex läser exekveringsträdsoperatorerna och underoperatorerna flera rader tillsammans i kolumnsegment. Database Engine läser endast de kolumner som krävs för resultatet, som refereras till av en SELECT sats, JOIN predikat eller filterpredikat. För mer information om kolumnlagringsindex, se Columnstore Index Architecture.
Not
Körning i batchläge är mycket effektivt för datalagerscenarier där det kan läsa och aggregera stora mängder data.
SQL-instruktionsbearbetning
Att bearbeta en enda T-SQL-sats är det mest grundläggande sättet som Database Engine utför T-SQL-satser på. Följande steg illustrerar den grundläggande processen genom att bearbeta en enda SELECT sats som endast refererar till lokala bastabeller (inga vyer eller fjärrtabeller).
Prioritet för logisk operator
När du använder mer än en logisk operator i ett sats, NOT utvärderas först, sedan AND, och slutligen OR. Aritmetiska och bitvisa operatorer hanteras före logiska operatorer. För mer information, se operatorprioritet.
I följande exempel gäller färgvillkoret för produktmodell 21, och inte för produktmodell 20, eftersom AND har företräde över OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Att använda parenteser, även när de inte är nödvändiga, kan förbättra läsbarheten hos frågor och minska risken för misstag på grund av operatörens företräde. Följande exempel är mer läsbart än det föregående exemplet och har samma betydelse.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Du kan ändra frågans innebörd genom att lägga till parenteser för att framtvinga utvärdering av OR först. Följande fråga hittar endast produkter under modellerna 20 och 21 som är röda.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Optimera SELECT-instruktioner
Ett SELECT uttalande är inte procedurmässigt. Den anger inte de exakta steg som databasservern ska använda för att hämta begärda data. Detta deklarativa beteende innebär att databasservern måste analysera SQL-satsen och databasen för att avgöra det mest effektiva sättet att extrahera den begärda datan. Denna process kallas optimering av frågeplanen. Komponenten som utför denna uppgift är Query Optimizer. Indata till frågeoptimeraren består av frågan, databasschemat (objektdefinitioner) och objektstatistiken. Utdata från frågeoptimeraren är en frågeexekveringsplan, ibland kallad en frågeplan eller exekveringsplan. Innehållet i en exekveringsplan beskrivs mer i detalj i cachelagring och återanvändning av exekveringsplan.
Följande diagram illustrerar in- och utdata från frågeoptimeraren under optimering av en enskild SELECT instruktion:

En SELECT sats definierar enbart:
- Formatet av resultatuppsättningen. Detta anges främst i urvalslistan. Andra satser som
ORDER BYochGROUP BYpåverkar dock också den slutliga formen av resultatuppsättningen. - Tabellerna som innehåller källdata. Detta anges i
FROM-satsen. - Hur tabellerna är logiskt relaterade för
SELECT-instruktionen. Detta definieras i join-uttrycket, som kan förekomma i klausulenWHEREeller i enONklausul efterFROM. - De krav som raderna i källtabellerna måste uppfylla för att kvalificera sig för
SELECT-instruktionen. Dessa anges i satsernaWHEREochHAVING.
En plan för frågeexekvering definierar:
Sekvensen där källtabellerna används.
Vanligtvis kan databasservern komma åt bastabellerna i många olika ordningar för att bygga resultatuppsättningen. Om
SELECT-instruktionen till exempel refererar till tre tabeller kan databasservern först komma åtTableA, använda data frånTableAför att extrahera matchande rader frånTableBoch sedan använda data frånTableBför att extrahera data frånTableC. De andra sekvenserna där databasservern kan komma åt tabellerna är:TableC,TableB,TableAeller
TableB,TableA,TableCeller
TableB,TableC,TableAeller
TableC,TableA,TableBDe metoder som används för att extrahera data från varje tabell.
I allmänhet finns det olika metoder för att komma åt data i varje tabell. Om endast några få rader med specifika nyckelvärden krävs kan databasservern snabbt slå upp rader eller skanna ett litet indexintervall. Om alla rader i tabellen behövs kan databasservern istället skanna hela tabellen eller indexet. Om alla rader i en tabell krävs men det finns ett index vars nyckelkolumner ingår i en
ORDER BY, kan en indexskanning i stället för en tabellskanning spara en separat sortering av resultatmängden. Om en tabell är mycket liten kan fullständiga skanningar vara den mest effektiva metoden för nästan all åtkomst till tabellen.De metoder som används för att beräkna beräkningar och hur du filtrerar, aggregerar och sorterar data från varje tabell.
När data nås från tabeller utför olika metoder beräkningar över data, såsom att beräkna skalärvärden, och aggregera och sortera data enligt definitionen i frågetexten. Till exempel när man använder en
GROUP BY- ellerORDER BY-klausul, och hur man filtrerar data, till exempel när man använder enWHERE- ellerHAVING-klausul.
Processen att välja en körningsplan från potentiellt många möjliga planer kallas optimering. Frågeoptimeraren är en av de viktigaste komponenterna i databasmotorn. Även om frågeoptimeraren använder viss overhead för att analysera frågan och välja en plan, sparas denna overhead vanligtvis flera gånger när Query Optimizer väljer en effektiv exekveringsplan. Till exempel kan två byggföretag få identiska skisser för ett hus. Om ett företag lägger några dagar i början på att planera hur huset ska byggas, och det andra företaget börjar bygga utan planering, blir det troligen det företag som tar sig tid att planera sitt projekt klart först.
Query Optimizer är en kostnadsbaserad optimerare. Varje möjlig exekveringsplan har en kostnad när det gäller mängden beräkningsresurser som används. Frågeoptimeraren måste analysera möjliga planer och välja den med den lägsta uppskattade kostnaden. Vissa komplexa uttalanden har tusentals möjliga exekveringsplaner. I dessa fall analyserar frågeoptimeraren inte alla möjliga kombinationer. I stället använder den komplexa algoritmer för att hitta en körningsplan som har en kostnad som är rimligen nära den minsta möjliga kostnaden.
Frågeoptimeraren väljer inte nödvändigtvis den exekveringsplan med lägst uppskattad kostnad. Den hittar en plan med en rimlig uppskattad kostnad inom den tid som finns tillgänglig för optimering. En parallell körningsplan kan använda fler resurser än en seriell plan samtidigt som den minskar den beräknade körtiden.
SQL Server Query Optimizer förlitar sig på statistik när den uppskattar resurskostnaderna för olika metoder för att extrahera information från en tabell eller ett index. Statistik hålls för kolumner och index och innehåller information om tätheten1 för den underliggande datan. Denna information indikerar selektiviteten hos värdena i ett visst index eller kolumn. I en tabell som till exempel representerar bilar har många bilar samma tillverkare, men varje bil har ett unikt fordonsidentifieringsnummer (VIN). Ett index på VIN är mer selektivt än ett index på tillverkaren, eftersom VIN har lägre densitet än tillverkaren. Om indexstatistiken inte är aktuell kanske frågeoptimeraren inte gör det bästa valet för tabellens aktuella tillstånd. Mer information om tätheter finns i Statistics.
1 Density definierar fördelningen av unika värden som finns i data, eller det genomsnittliga antalet duplicerade värden för en viss kolumn. När densiteten minskar ökar ett värdes selektivitet.
Frågeoptimeraren är viktig eftersom den gör det möjligt för databasservern att dynamiskt anpassa sig till förändrade förhållanden i databasen utan att behöva input från en utvecklare eller databasadministratör. Denna funktion gör det möjligt för utvecklare att fokusera på att beskriva det slutgiltiga resultatet av frågan. De kan lita på att frågeoptimeraren bygger en effektiv exekveringsplan för databasens tillstånd varje gång frågeplanen för en instruktion optimeras.
Not
SQL Server Management Studio har tre alternativ att visa exekveringsplaner:
- Den uppskattade exekveringsplanen, som är den kompilerade planen, så som den genereras av frågeoptimeraren.
- Den faktiska exekveringsplanen, som är densamma som den kompilerade planen plus dess exekveringskontext. Denna kontext inkluderar körtidsinformation som finns tillgänglig efter att exekveringen är avslutad, såsom exekveringsvarningar, eller i nyare versioner av Database Engine, förfluten tid och CPU-tid som används under exekveringen.
- Live Query Statistics är samma sak som den kompilerade planen plus dess körningskontext. Denna kontext inkluderar körtidsinformation under exekveringsprocessen och uppdateras varje sekund. Körtidsinformation inkluderar till exempel det faktiska antalet rader som flödar genom operatörerna.
Bearbeta en SELECT-instruktion
The Database Engine bearbetar en enda SELECT instruktion genom att följa dessa steg:
- Parsern söker igenom
SELECT-instruktionen och delar upp den i logiska enheter som nyckelord, uttryck, operatorer och identifierare. - Ett frågeträd, ibland kallat sekvensträd, byggs upp för att beskriva de logiska steg som behövs för att omvandla källdatan till det format som krävs av resultatuppsättningen.
- Query Optimizer analyserar olika sätt att komma åt källtabellerna. Den väljer den serie steg som ger resultaten snabbast med färre resurser. Den uppdaterar frågeträdet för att registrera just denna serie steg. Den slutliga, optimerade versionen av frågeträdet kallas för körningsplanen.
- Den relationella motorn börjar köra planen. När den bearbetar steg som behöver data från bastabellerna, begär den de nödvändiga raduppsättningarna från lagringsmotorn.
- Relationsmotorn bearbetar de data som returneras från lagringsmotorn till det format som definierats för resultatuppsättningen och returnerar resultatuppsättningen till klienten.
Konstantvikning och utvärdering av uttryck
Databasmotorn utvärderar vissa konstanta uttryck tidigt för att förbättra frågeprestandan. Denna optimeringsteknik som används av frågeoptimeraren syftar till att förenkla uttryck vid kompilering snarare än vid körning. Det handlar om att utvärdera konstanta uttryck under frågekompileringen så att den resulterande körningsplanen blir effektivare. Denna process kallas constant folding. En konstant är en T-SQL-literal, såsom 3, 'ABC', '2025-12-31', 1.0e3 eller 0x12345678. Ta till exempel den här frågan:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Här är 30 * 12 ett konstant uttryck. Database Engine utvärderar detta uttryck under kompilering och kan skriva om frågan internt som:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Vikbara uttryck
Database Engine använder konstantförenkling med följande typer av uttryck:
- Aritmetiska uttryck, till exempel
1 + 1och5 / 3 * 2, som endast innehåller konstanter. - Logiska uttryck, till exempel
1 = 1och1 > 2 AND 3 > 4, som endast innehåller konstanter. - Inbyggda funktioner som Database Engine anser vara vikbara, inklusive
CASTochCONVERT. Generellt är en intrinsisk funktion vikbar om den endast är en funktion av dess indata och inte annan kontextuell information, såsomSETalternativ, språkinställningar, databasalternativ och krypteringsnycklar. Nondeterministiska funktioner är inte sammanställbara. Deterministiska inbyggda funktioner är vikbara, med vissa undantag. - Deterministiska metoder för CLR-användardefinierade typer och deterministiska skalärvärda CLR-användardefinierade funktioner. Mer information finns i konstantvikning för CLR User-Defined funktioner och metoder.
Not
Ett undantag görs för stora objekttyper. Om utdatatypen för vikningsprocessen är en stor objekttyp (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json eller xml), viker inte Database Engine uttrycket.
Icke-mappbara uttryck
Alla andra uttryckstyper är inte vikbara. I synnerhet är följande typer av uttryck inte vikbara:
- Icke-stantiska uttryck, till exempel ett uttryck vars resultat beror på värdet för en kolumn.
- Uttryck vars resultat är beroende av en lokal variabel eller parameter, till exempel
@x. - Nondeterministiska funktioner.
- Användardefinierade T-SQL-funktioner.
- Uttryck vars resultat är beroende av språkinställningar.
- Uttryck vars resultat är beroende av
SETalternativ. - Uttryck vars resultat är beroende av serverkonfigurationsalternativ.
Exempel på vikbara och icke-hopfällbara konstanta uttryck
Överväg följande fråga:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Om PARAMETERIZATION databasalternativet inte är inställt på FORCED för denna fråga utvärderas uttrycket 117.00 + 1000.00 och ersätts av dess resultat, 1117.00, innan frågan kompileras. Fördelarna med denna konstantfällning inkluderar:
- Uttrycket behöver inte utvärderas upprepade gånger under körningstid.
- Värdet på uttrycket efter att det utvärderats används av frågeoptimeraren för att uppskatta storleken på resultatmängden för den del av frågan
TotalDue > 117.00 + 1000.00.
Å andra sidan, om dbo.f är en användardefinierad skalär funktion, förenklas inte uttrycket dbo.f(100), eftersom Database Engine inte förenklar uttryck som involverar användardefinierade funktioner, även om de är deterministiska. För mer information om parameterisering, se Forced parameterization.
Utvärdering av uttryck
Dessutom utvärderas vissa uttryck som inte är konstantfaldna men vars argument är kända under kompilering, oavsett om argumenten är parametrar eller konstanter, av kardinalitetsestimatorn som är en del av optimeraren.
Mer specifikt utvärderas följande inbyggda funktioner och särskilda operatorer vid kompileringstiden om alla deras indata är kända: UPPER, LOWER, RTRIM, DATEPART( YY only ), GETDATE, CASToch CONVERT. Följande operatorer utvärderas också vid kompileringstillfället om alla deras indata är kända:
- Aritmetiska operatorer:
+,-,*,/, unär- - Logiska operatorer:
AND,OR,NOT - Jämförelseoperatorer:
<>,>=,LIKE,IS NULL,<=,>,<,IS NOT NULL
Inga andra funktioner eller operatorer utvärderas av frågeoptimeraren vid kardinalitetsuppskattning.
Exempel på utvärdering av kompileringstiduttryck
Tänk på den här lagrade proceduren:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Under optimeringen av SELECT-instruktionen i proceduren försöker frågeoptimeraren utvärdera den förväntade kardinaliteten för resultatuppsättningen för villkoret OrderDate > @d + 1. Uttrycket @d + 1 är inte konstant vikt eftersom @d är en parameter. Men vid optimeringstid är värdet för parametern känt. Detta värde gör det möjligt för frågeoptimeraren att noggrant uppskatta storleken på resultatuppsättningen, vilket hjälper den att välja en bra frågeplan.
Överväg nu ett exempel som liknar det föregående, förutom att en lokal variabel @d2 ersätter @d + 1 i frågan och uttrycket utvärderas i en SET -instruktion i stället för i frågan.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
När satsen SELECT i MyProc2 är optimerad i Database Engine är värdet av @d2 inte känt. Därför använder frågeoptimeraren en standarduppskattning för selektiviteten på OrderDate > @d2 (i detta fall 30 procent).
Bearbeta andra uttalanden
De grundläggande stegen för att bearbeta en SELECT-sats gäller även för andra T-SQL-satser såsom INSERT, UPDATE och DELETE. Både UPDATE- och DELETE-satserna måste rikta in sig på den uppsättning rader som ska ändras eller tas bort. Processen att identifiera dessa rader är samma process som används för att identifiera de källrader som bidrar till resultatuppsättningen för en SELECT-instruktion. Både UPDATE- och INSERT-satser kan innehålla inbäddade SELECT-satser som tillhandahåller datavärden att uppdatera eller infoga.
Även Data Definition Language (DDL)-satser, såsom CREATE PROCEDURE eller ALTER TABLE, resulterar i en serie relationella operationer på systemkatalogtabellerna och ibland (såsom ALTER TABLE ADD COLUMN) mot datatabellerna.
Arbetstabeller
Den relationella motorn kan behöva bygga en arbetstabell för att utföra en logisk operation specificerad i en T-SQL-sats. Arbetstabeller är interna tabeller som innehåller mellanliggande resultat. Arbetstabeller genereras för vissa GROUP BY, ORDER BYeller UNION frågor. Till exempel, om en ORDER BY klausul refererar till kolumner som inte täcks av några index, kan relationsmotorn behöva generera en arbetstabell för att sortera resultatmängden i den ordning som efterfrågas. Arbetsbord används också ibland som spolar som tillfälligt innehåller resultatet från att köra en del av en frågeplan. Arbetsbord skapas i tempdb och tas bort automatiskt när de inte längre behövs.
Visa upplösning
Database Engine-frågeprocessorn behandlar indexerade och icke-indexerade vyer olika:
- Databasen lagrar raderna i en indexerad vy i samma format som en tabell. Om frågeoptimeraren väljer att använda en indexerad vy i en frågeplan behandlar den den indexerade vyn på samma sätt som en bastabell.
- Endast definitionen av en icke-indexerad vy lagras, inte raderna i vyn. Query Optimizer införlivar logiken från vydefinitionen i exekveringsplanen den bygger för T-SQL-satsen som refererar till den icke-indexerade vyn.
Logiken som frågeoptimeraren använder för att avgöra när en indexerad vy ska användas liknar den logik den använder för att avgöra när ett index ska användas på en tabell. Om datan i den indexerade vyn täcker hela eller delar av T-SQL-satsen, och Query Optimizer fastställer att ett index på vyn är den kostnadseffektiva åtkomstvägen, väljer den indexet oavsett om frågeställningen refererar till vyn vid namn eller inte.
När en T-SQL-sats refererar till en icke-indexerad vy analyserar parsern och frågeoptimeraren källan till både T-SQL-satsen och vyn och löser sedan upp dem i en enda exekveringsplan. T-SQL-satsen och vyn har inga separata planer.
Tänk till exempel på följande vy:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Baserat på denna syn utför båda dessa T-SQL-satser samma operationer på bastabellerna och ger samma resultat:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
Funktionen SQL Server Management Studio (SSMS) Showplan visar att relationsdatabasmotorn bygger samma exekveringsplan för båda dessa SELECT satser.
Använd tips med vyer
Om du placerar tips på vyer i en fråga kan de krocka med andra tips som upptäcks när vyn expanderar för att komma åt sina bastabeller. När denna konflikt uppstår returnerar frågan ett fel. Tänk dig till exempel följande vy som innehåller ett tabelltips i definitionen:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Anta nu att du anger den här frågan:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
Frågan misslyckas, eftersom hinten på Person.AddrState-vyn sprids till både tabellen Person.Address och tabellen Person.StateProvince i vyn när den expanderas. Emellertid, om du expanderar vyn avslöjas även ledtråden NOLOCK om Person.Address. Eftersom SERIALIZABLE och NOLOCK ledtrådar står i konflikt är den resulterande sökfrågan felaktig.
PAGLOCK, NOLOCK, ROWLOCK, TABLOCK och TABLOCKX-tabellledtrådarna står i konflikt med varandra, liksom HOLDLOCK, NOLOCK, READCOMMITTED, REPEATABLEREAD och SERIALIZABLE-tabellledtrådarna.
Tips kan spridas genom nivåer av kapslade vyer. Till exempel, anta att en fråga tillämpar HOLDLOCK ledtråd på en vy v1. När v1 är expanderad finner du att vyn v2 är en del av dess definition.
v2:s definition innehåller ett NOLOCK-tips om en av bastabellerna. Men den här tabellen ärver också HOLDLOCK anvisning från frågan i vyn v1. Eftersom indikationerna NOLOCK och HOLDLOCK konflikterar, misslyckas frågan.
När du använder FORCE ORDER hinten i en fråga som innehåller en vy, bestämmer vyns position i den ordnade konstruktionen joinordningen för tabellerna i vyn. Följande fråga väljer till exempel från tre tabeller och en vy:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
Och View1 definieras som visas i följande exempel:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
Kopplingsordningen i frågeplanen är Table1, Table2, TableA, TableB, Table3.
Lösa index för vyer
Som med alla index väljer Database Engine att använda en indexerad vy i sin frågeplan endast om Query Optimizer bedömer att det är fördelaktigt att göra det.
Du kan skapa indexerade vyer i vilken utgåva av Database Engine som helst. I vissa utgåvor beaktar Query Optimizer automatiskt den indexerade vyn, medan du i andra utgåvor behöver använda tabelltipset NOEXPAND. Automatisk användning av en indexerad vy av Query Optimizer stöds endast i specifika utgåvor av SQL Server.
Not
Azure SQL Database och Azure SQL Managed Instance tillåter automatiskt användning av indexerade vyer utan att specificera NOEXPAND hint.
Frågeoptimeraren använder en indexerad vy när följande villkor är uppfyllda:
- Dessa sessionsalternativ är inställda på
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- Sessionsalternativet
NUMERIC_ROUNDABORTär inställt påOFF. - Query Optimizer hittar en matchning mellan vyindexkolumnerna och elementen i frågan, såsom:
- Sökvillkorspredikat i
WHERE-klausulen - Sammanfogningsoperationer
- Mängdfunktioner
-
GROUP BY-satser - Tabellreferenser
- Sökvillkorspredikat i
- Den uppskattade kostnaden för att använda indexet har den lägsta kostnaden för alla åtkomstmekanismer som beaktas av Frågeoptimeraren.
- Varje tabell som refereras i frågan (antingen direkt eller genom att expandera en vy för att komma åt dess underliggande tabeller) som motsvarar en tabellreferens i den indexerade vyn måste ha samma uppsättning tips som tillämpas på den i frågan.
Not
Tipsen READCOMMITTED och READCOMMITTEDLOCK betraktas alltid som olika tips i den här kontexten, oavsett aktuell transaktionsisoleringsnivå.
Förutom kraven för SET alternativ och tabelltips är dessa samma regler som Frågeoptimeraren använder för att avgöra om ett tabellindex omfattar en fråga. Du behöver inte ange något annat i frågan för att en indexerad vy ska användas.
En fråga behöver inte uttryckligen referera till en indexerad vy i FROM-satsen för att Frågeoptimeraren ska använda den indexerade vyn. Om frågan innehåller referenser till kolumner i bastabellerna som också finns i den indexerade vyn, och Frågeoptimeraren uppskattar att användning av den indexerade vyn ger den lägsta kostnadsåtkomstmekanismen, väljer Frågeoptimeraren den indexerade vyn, på samma sätt som den väljer bastabellindex när de inte refereras direkt i en fråga. Frågeoptimeraren kan välja vyn när den innehåller kolumner som inte refereras av frågan, så länge vyn erbjuder det lägsta kostnadsalternativet för att täcka en eller flera av de kolumner som anges i frågan.
Frågeoptimeraren behandlar en indexerad vy som refereras i FROM-satsen som en standardvy. Frågeoptimeraren expanderar definitionen av vyn till frågan i början av optimeringsprocessen. Sedan utförs matchning av indexerade vyer. Den indexerade vyn kan användas i den slutliga utförandeplanen som valts av Query Optimizer, eller så kan planen istället materialisera nödvändiga data från vyn genom att komma åt de bastabeller som refereras av vyn. Frågeoptimeraren väljer det billigaste alternativet.
Använda ledtrådar med indexerade vyer
Du kan förhindra att visningsindex används för en fråga med hjälp av EXPAND VIEWS frågetips, eller så kan du använda NOEXPAND tabelltipset för att framtvinga användningen av ett index för en indexerad vy som anges i FROM-satsen i en fråga. Du bör dock låta Frågeoptimeraren dynamiskt fastställa de bästa åtkomstmetoderna som ska användas för varje fråga. Begränsa din användning av EXPAND och NOEXPAND till specifika fall där testningen har visat att de förbättrar prestanda avsevärt.
Alternativet
EXPAND VIEWSanger att Frågeoptimeraren inte använder några visningsindex för hela frågan.När du anger
NOEXPANDför en vy överväger Query Optimizer att använda alla index som definierats i vyn.NOEXPANDsom anges med den valfriaINDEX()-satsen tvingar Frågeoptimeraren att använda de angivna indexen. Du kan angeNOEXPANDbara för en indexerad vy och inte för en vy som inte är indexerad. Automatisk användning av en indexerad vy av Query Optimizer stöds endast i specifika utgåvor av SQL Server.Not
Azure SQL Database och Azure SQL Managed Instance tillåter automatiskt användning av indexerade vyer utan att specificera
NOEXPANDhint.
När varken NOEXPAND eller EXPAND VIEWS anges i en fråga som innehåller en vy, expanderas vyn för att komma åt underliggande tabeller. Om frågan som utgör vyn innehåller några tabelltips sprids dessa tips till de underliggande tabellerna. (Denna process förklaras mer ingående i View resolution.) Så länge uppsättningen hintar som finns på de underliggande tabellerna i vyn är identiska med varandra, kan frågan matchas med en indexerad vy. Oftast stämmer dessa ledtrådar överens eftersom de ärvs direkt från vyn. Men om frågan refererar till tabeller i stället för vyer och tipsen som tillämpas direkt på dessa tabeller inte är identiska, är en sådan fråga inte berättigad till matchning med en indexerad vy. Om tipsen INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCKeller XLOCK gäller för tabellerna som refereras i frågan efter visningsexpansionen är frågan inte berättigad till matchning av indexerad vy.
Om ett tabelltips i form av INDEX ( index_val [ ,...n] ) refererar till en vy i en fråga och du inte också anger NOEXPAND tips ignoreras indextipset. Om du vill ange användning av ett visst index använder du NOEXPAND.
Generellt, när frågeoptimeraren matchar en indexerad vy med en fråga, tillämpar den alla hintar som anges i tabellerna eller vyerna i frågan direkt på den indexerade vyn. Om frågeoptimeraren väljer att inte använda en indexerad vy, vidarebefordrar den alla tips direkt till tabellerna som refereras till i vyn. För mer information, se Visa upplösning. Den här spridningen gäller inte för kopplingstips. De tillämpas endast i sin ursprungliga position i frågan. Query Optimizer tar inte hänsyn till join hints när frågor matchas med indexerade vyer. Om en frågeplan använder en indexerad vy som matchar en del av en fråga som innehåller ett kopplingstips används inte kopplingstipset i planen.
Ledtrådar tillåts inte i definitionerna av indexerade vyer. Database Engine ignorerar ledtrådar i indexerade vydefinitioner när de underhålls eller när frågor som använder indexerade vyer körs.
Mer information finns i Tabelltips.
Hantera distribuerade partitionerade vyer
Database Engine-frågeprocessorn optimerar prestandan hos distribuerade partitionerade vyer. Den viktigaste aspekten av distribuerad partitionerad vyprestanda är att minimera mängden data som överförs mellan medlemsservrar.
Database Engine bygger intelligenta, dynamiska planer som effektivt använder distribuerade frågor för att komma åt data från fjärrmedlemstabeller:
- Frågeprocessorn använder först OLE DB för att hämta kontrollvillkorsdefinitionerna från varje medlemstabell. Denna metod tillåter frågeprocessorn att kartlägga fördelningen av nyckelvärden över medlemstabellerna.
- Query Processor jämför nyckelintervallen som specificeras i en T-SQL-sats
WHEREmed kartan som visar hur raderna är fördelade i medlemstabellerna. Frågeprocessorn bygger sedan en plan för frågeexekvering som använder distribuerade frågor för att endast hämta de fjärrrader som krävs för att slutföra T-SQL-satsen. Exekveringsplanen är också utformad så att all åtkomst till medlemstabeller på fjärrservern, vare sig det gäller data eller metadata, fördröjs tills informationen behövs.
Tänk dig till exempel ett system där en Customers tabell är partitionerad mellan Server1 (CustomerID från 1 till 3299999), Server2 (CustomerID från 3300000 till 6599999) och Server3 (CustomerID från 6600000 till 9999999).
Överväg körningsplanen som skapats för den här frågan som körs på Server1:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
Körningsplanen för den här frågan extraherar raderna med CustomerID nyckelvärden från 3200000 till 3299999 från den lokala medlemstabellen och utfärdar en distribuerad fråga för att hämta raderna med nyckelvärden från 3300000 till 3400000 från Server2.
Database Engine Query Processor kan också bygga in dynamisk logik i frågekörningsplaner för T-SQL-satser där nyckelvärdena inte är kända när planen måste byggas. Tänk till exempel på den här lagrade proceduren:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
Database Engine kan inte förutsäga vilket nyckelvärde som anges via parametern @CustomerIDParameter varje gång proceduren körs. Eftersom nyckelvärdet inte kan förutsägas kan frågeprocessorn inte heller förutsäga vilken medlemstabell den måste komma åt. För att hantera detta fall bygger Database Engine en exekveringsplan med villkorlig logik, kallad dynamiska filter, för att styra vilken medlemstabell som nås, baserat på indataparametervärdet. Om den lagrade GetCustomer proceduren kördes på Server1 kan exekveringsplanlogiken representeras som visas i följande utdata:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
Database Engine bygger ibland denna typ av dynamiska exekveringsplaner även för frågor som inte är parametriserade. Frågeoptimeraren kan parameterisera en fråga så att körningsplanen kan återanvändas. Om frågeoptimeraren parameteriserar en fråga som refererar till en partitionerad vy kan frågeoptimeraren inte längre anta att de nödvändiga raderna kommer från en specificerad bastabell. Den måste sedan använda dynamiska filter i exekveringsplanen.
Körning av lagrade procedurer och triggers
Database Engine lagrar endast källkoden för lagrade procedurer och triggers. När en lagrad procedur eller utlösare först körs kompileras källkoden till en körningsplan. Om den lagrade proceduren eller utlösaren körs igen innan körningsplanen har raderas från minnet identifierar den relationella motorn den befintliga planen och återanvänder den. Om planen tas bort från minnet byggs en ny plan. Denna process liknar den process som Database Engine följer för alla T-SQL-satser. Den största prestandafördelen som lagrade procedurer och triggers har i Database Engine jämfört med batchar av dynamisk T-SQL är att deras T-SQL-satser alltid är desamma. Därför matchar relationsdatabasens motor dem enkelt med alla befintliga exekveringsplaner. Lagrade procedurer och utlösarplaner återanvänds enkelt.
Körningsplanen för lagrade procedurer och utlösare körs separat från körningsplanen för batchen som anropar den lagrade proceduren eller utlöser utlösaren. Denna separation möjliggör större återanvändning av lagrade procedurers och utlösares exekveringsplaner.
Cachelagring och återanvändning av körningsplan
Database Engine använder minne för att lagra både exekveringsplaner och databuffertar. Andelen minne som tilldelas exekveringsplaner eller databuffertar justeras dynamiskt, beroende på systemets tillstånd. Den del av minnet som lagrar exekveringsplaner kallas plancache.
Plan-cachelagring
Plancachen har två lager för alla kompilerade planer:
- Object Plans-cachelagret (OBJCP) lagrar planer relaterade till persisterade objekt, såsom lagrade procedurer, funktioner och utlösare.
- SQL Plans-cachelagring (SQLCP), för planer som rör autoparametriserade, dynamiska eller förberedda frågor.
Följande frågan ger information om minnesanvändningen för dessa två cachelager:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
Plancachen har två ytterligare lager som inte lagrar planer:
- Bound Trees-cachelagret (PHDR), för datastrukturer som används vid plankompilering för vyer, begränsningar och standardinställningar. Dessa strukturer kallas bound trees eller algebrizerträd.
- cachelagret för Extended Stored Procedures (XPROC), för fördefinierade systemprocedurer, som sp_executesql eller xp_cmdshell. Dessa lagrade procedurer använder en DLL istället för T-SQL-satser. Den cachade strukturen innehåller endast funktionsnamnet och DLL-namnet där proceduren implementeras.
komponenter i körningsplanen
Database Engine-exekveringsplaner har följande huvudkomponenter:
Sammanställd plan (eller frågeplan)
Frågeplanen som skapas av kompileringsprocessen är mestadels en återinträdesbar, skrivskyddad datastruktur som kan användas av många användare. Den lagrar information om:
Fysiska operatorer som implementerar åtgärden som beskrivs av logiska operatorer.
Ordningen på dessa operatorer, som avgör i vilken ordning data används, filtreras och aggregeras.
Antalet uppskattade rader som passerar genom operatorerna.
Not
Frågeplanen lagrar också information om de statistikobjekt som används för kardinalitetsuppskattning.
Vilka stödobjekt måste skapas, till exempel arbetstabeller eller arbetsfiler i
tempdb.
Frågeplanen lagrar ingen användarkontext eller körtidsinformation. Database Engine bestämmer antalet arbetstrådar varje gång den hämtar en plan från plancachen. En cachelagrad parallellplan kan också köras seriellt.
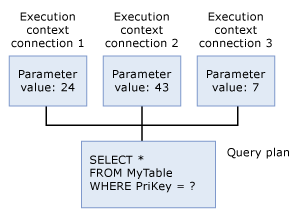
Exekveringskontext
Varje användare som för närvarande kör frågan har en datastruktur som innehåller data som är specifik för deras exekvering, såsom parametervärden. Denna datastruktur kallas exekveringskontext. Datastrukturerna för körningskontext återanvänds, men deras innehåll återanvänds inte. Om en annan användare kör samma fråga initieras datastrukturerna på nytt med kontexten för den nya användaren.
Återanvänd planer för identiska satser
När Database Engine kör en T-SQL-instruktion går den först igenom plancachen för att verifiera att det finns en befintlig exekveringsplan för samma T-SQL-instruktion. T-SQL-satsen anses vara befintlig om den bokstavligen matchar en tidigare utförd T-SQL-sats med en cachad plan, tecken för tecken. Database Engine återanvänder alla befintliga planer den hittar, vilket sparar omkostnaden för att kompilera T-SQL-satsen igen. Om ingen exekveringsplan finns genererar Database Engine en ny exekveringsplan för frågan.
Not
Plancachen behåller inte exekveringsplaner för vissa T-SQL-satser, såsom bulkoperation-satser som körs på rowstore eller satser som innehåller stora strängliteraler. Dessa planer finns endast medan sökningen körs.
Database Engine använder en effektiv algoritm för att hitta alla befintliga exekveringsplaner för en viss specifik T-SQL-sats. I de flesta system är de minimala resurser som denna skanning använder mindre än de resurser som sparas genom att återanvända befintliga planer istället för att kompilera varje T-SQL-sats.
Algoritmerna för att matcha nya T-SQL-satser med befintliga, oanvända exekveringsplaner i plancachen kräver att alla objektreferenser är fullt kvalificerade. Till exempel, anta att Person är standardschemat för användaren som kör följande SELECT satser. Även om detta exempel inte kräver att du fullständigt kvalificerar tabellen Person för att köras, betyder det att den andra satsen inte matchar en befintlig plan, men den tredje satsen gör det:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Att ändra något av följande SET alternativ för en given exekvering påverkar möjligheten att återanvända planer, eftersom Database Engine utför konstant folding och dessa alternativ påverkar resultaten av sådana uttryck:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Cachelagrar flera planer för samma fråga
Frågeställningar och exekveringsplaner är unikt identifierbara i databasmotorn, ungefär som ett fingeravtryck:
- -frågeplanens hash- är ett binärt hash-värde som beräknas på körningsplanen för en viss fråga och används för att unikt identifiera liknande körningsplaner.
- Frågehashen är ett binärt hashvärde beräknat på T-SQL-texten i en fråga och används för att unikt identifiera frågor.
Du kan hämta en kompilerad plan från plancachen genom att använda ett planhandtag. Denna transientidentifierare förblir konstant endast så länge planen finns i cachen. Planhanteraren är ett hash-värde som härleds från den kompilerade planen för hela batchen. Planhandtaget för en kompilerad plan förblir detsamma även om ett eller flera satser i batchen kompileras om.
Not
Om du kompilerar en plan för en batch istället för ett enda statement kan du använda planhandtaget och statement offsets för att få planen för individuella satser i batchen.
sys.dm_exec_requests DMV innehåller statement_start_offset- och statement_end_offset-kolumnerna för varje post. Dessa kolumner avser den pågående instruktionen för en batch eller ett sparat objekt som för närvarande körs. Mer information finns i sys.dm_exec_requests.
sys.dm_exec_query_stats DMV innehåller också dessa kolumner för varje post. Dessa kolumner avser positionen för en sats inom en batch eller ett persisterat objekt. Mer information finns i sys.dm_exec_query_stats.
Den faktiska T-SQL-texten i en batch lagras i ett separat minnesutrymme från plancachen, kallat SQL Manager-cachen (SQLMGR). Du kan hämta T-SQL-texten för en kompilerad plan från SQL Manager-cachen genom att använda ett SQL-handtag. Denna transientidentifierare förblir konstant endast så länge minst en plan som refererar till den finns kvar i plancachen. SQL-handle är ett hashvärde som härleds från hela batchtexten och garanteras vara unikt för varje batch.
Not
Likt en kompilerad plan lagras T-SQL-texten per batch, inklusive kommentarerna. SQL-handle innehåller MD5-hashen för hela batchtexten och garanteras vara unik för varje batch.
Följande fråga ger information om minnesanvändningen för SQL Manager-cachen:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Det finns en en-till-många-relation mellan ett SQL-handtag och planreferenser. Detta villkor uppstår när cache-nyckeln för de kompilerade planerna är annorlunda. Denna skillnad kan uppstå på grund av ändringar i alternativen SET mellan två körningar av samma batch.
Överväg följande lagrade procedur:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Verifiera vad du kan hitta i plancachen genom att använda följande fråga:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Här är resultatet.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Exekvera nu den lagrade proceduren med en annan parameter, utan andra ändringar i exekveringskontexten:
EXECUTE usp_SalesByCustomer 8;
GO
Kontrollera igen vad du kan hitta i plancachen. Här är resultatet.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Observera att usecounts värdet ökar till 2, vilket betyder att samma cachade plan återanvänds as-is, eftersom exekveringskontextdatastrukturerna återanvänds. Byt nu alternativet SET ANSI_DEFAULTS och kör den lagrade proceduren med samma parameter.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Kontrollera igen vad du kan hitta i plancachen. Här är resultatet.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Observera att det nu finns två poster i sys.dm_exec_cached_plans DMV-utdata:
- Kolumnen
usecountsvisar värdet1i den första posten. Detta värde representerar planen som utfördes en gång medSET ANSI_DEFAULTS OFF. - Kolumnen
usecountsvisar värdet2i den andra posten. Detta värde representerar planen som utfördes medSET ANSI_DEFAULTS ON, eftersom den utfördes två gånger. - De olika
memory_object_addressrefererar till en annan post i körningsplanen i plancachen. Detsql_handlevärdet är dock detsamma för båda posterna eftersom de refererar till samma batch.- Exekveringen med
ANSI_DEFAULTSsatt tillOFFhar en nyplan_handle, och den är tillgänglig för återanvändning för anrop som har samma uppsättningSETalternativ. Det nya plangreppet är nödvändigt eftersom körningskontexten ominitierades på grund av att alternativen förSETändrades. Men den förändringen utlöser ingen omkompilering: båda posterna hänvisar till samma plan och fråga, vilket framgår av att värdena förquery_plan_hashochquery_hashär desamma.
- Exekveringen med
Denna situation innebär att du har två planposter i cachen som motsvarar samma batch. Det understryker vikten av att säkerställa att plancachen för SET är densamma när samma frågor körs upprepade gånger. Denna metod optimerar återanvändning av planen och håller storleken på plancachen till det minsta som krävs.
Tips
En vanlig fallgrop är att olika klienter kan ha olika standardvärden för SET alternativen. Till exempel sätter QUOTED_IDENTIFIER en anslutning som görs via SQL Server Management Studio automatiskt till ON, medan SQLCMD sätter QUOTED_IDENTIFIER till OFF. Att köra samma queries från dessa två klienter resulterar i flera exekveringsplaner (som beskrivits i föregående exempel).
Ta bort utförandeplaner från plancachen
Utförandeplaner stannar i plancachen så länge det finns tillräckligt med minne för att lagra dem. När minnespress finns använder Databasmotor för SQL Server en kostnadsbaserad metod för att avgöra vilka exekveringsplaner som ska tas bort från plancachen. För att fatta ett kostnadsbaserat beslut ökar och minskar Databasmotor för SQL Server en aktuell kostnadsvariabel för varje exekveringsplan baserat på följande faktorer.
När en användarprocess infogar en exekveringsplan i cachen sätter användarprocessen den aktuella kostnaden lika med den ursprungliga kompileringskostnaden för frågan. För ad hoc-exekveringsplaner sätter användarprocessen den aktuella kostnaden till noll. Efter det, varje gång en användarprocess refererar till en exekveringsplan, återställer den den aktuella kostnaden till den ursprungliga kompileringskostnaden. För ad hoc-exekveringsplaner ökar den aktuella kostnaden för användarprocessen. För alla planer är det maximala värdet för den aktuella kostnaden den ursprungliga kompileringskostnaden.
När minnestryck finns tar Databasmotor för SQL Server bort exekveringsplaner från plancachen. För att avgöra vilka planer som ska tas bort undersöker Databasmotor för SQL Server upprepade gånger tillståndet för varje körningsplan och tar bort planer när den aktuella kostnaden är noll. En exekveringsplan med noll nuvarande kostnad tas inte bort automatiskt när minnesbrist finns. Den tas bara bort när Databasmotor för SQL Server granskar planen och den nuvarande kostnaden är noll. När du undersöker en exekveringsplan skickar Databasmotor för SQL Server den aktuella kostnaden mot noll genom att minska den aktuella kostnaden för en fråga för närvarande inte använder planen.
Databasmotor för SQL Server fortsätter att undersöka exekveringsplanerna tills den tar bort tillräckligt många planer för att uppfylla minneskraven. Även om minnesbelastningen finns kan en körningsplan få sina kostnader ökade och minskade mer än en gång. När minnestrycket inte längre finns slutar Databasmotor för SQL Server att minska den nuvarande kostnaden för oanvända exekveringsplaner. Alla utföringsplaner stannar kvar i plancachen, även om kostnaden är noll.
Databasmotor för SQL Server använder resursövervakaren och användararbetstrådarna för att frigöra minne från plancachen som svar på minnesbelastningen. Resursövervakaren och användararbets trådar kan samtidigt granska planer för att minska den aktuella kostnaden för varje oanvänd exekveringsplan. Resursövervakaren tar bort körningsplaner från plancachen när det finns ett globalt minnestryck. Det frigör minne för att tillämpa principer för systemminne, processminne, resurspoolminne och maximal storlek för alla cacheminnen.
Den maximala storleken för alla cacheminnen är en funktion av buffertpoolens storlek och får inte överskrida det maximala serverminnet. För mer information om hur du konfigurerar det maximala serverminnet, se inställningen max server memory i sp_configure.
Användararbetstrådarna tar bort körplaner från plancachen när det finns tryck på minnet från en enskild cache. De tillämpar principer för maximal storlek på en enda cache och högsta enskilda cacheposter.
Följande exempel visar vilka exekveringsplaner som tas bort från plancachen:
- En körningsplan refereras ofta för att kostnaden aldrig ska gå till noll. Planen stannar kvar i plancachen och tas inte bort om det inte uppstår minnespress och den nuvarande kostnaden är noll.
- En ad hoc-körningsplan infogas och refereras inte igen innan minnesbelastningen finns. Eftersom ad hoc-planer initieras med en aktuell kostnad på noll, ser Databasmotor för SQL Server den aktuella nollkostnaden när den granskar exekveringsplanen och tar bort planen från plancachen. Ad hoc-körningsplanen stannar kvar i plancachen med noll aktuell kostnad när det inte finns någon minnesbrist.
Om du vill ta bort en enda plan eller alla planer från cacheminnet manuellt använder du DBCC FREEPROCCACHE. Du kan också använda DBCC FREESYSTEMCACHE för att rensa vilken cache som helst, inklusive plancache. I SQL Server 2016 (13.x) och senare versioner används ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE för att rensa procedurens (plan-)cache för databasen i scope.
En ändring i vissa konfigurationsinställningar genom sp_configure och reconfigure orsakar också att planer tas bort från plancachen. Du hittar listan över dessa konfigurationsinställningar i avsnittet Anmärkningar i artikeln DBCC FREEPROCCACHE. När du gör denna konfigurationsändring skrivs följande informationsmeddelande till felloggen:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Kompilera om körningsplaner
Vissa ändringar i en databas kan göra en exekveringsplan ineffektiv eller ogiltig. Database Engine upptäcker dessa ändringar och markerar planen som ogiltig. En ny plan måste sedan omkompileras för nästa anslutning som kör databasfrågan. Villkor som ogiltigförklarar en plan inkluderar:
- Ändringar i en tabell eller vy som refereras till av frågan (
ALTER TABLEochALTER VIEW). - Ändringar i en enda procedur, vilket skulle ta bort alla planer för den proceduren från cachen (
ALTER PROCEDURE). - Ändringar i alla index som används av körningsplanen.
- Uppdateringar av statistik som används av exekveringsplanen, oavsett om den explicit genereras av en sats som
UPDATE STATISTICSeller genereras automatiskt. - Ta bort ett index som används av exekveringsplanen.
- Ett explicit anrop till
sp_recompile. - Ett stort antal ändringar av nycklar (som genereras av
INSERTellerDELETE-instruktioner från andra användare som ändrar en tabell som refereras av frågan). - Om antalet rader i de infogade eller borttagna tabellerna ökar avsevärt för tabeller med utlösare.
- Kör en lagrad procedur genom att använda alternativet
WITH RECOMPILE.
De flesta omkompileringar krävs antingen för att satsen ska vara korrekt eller för att få potentiellt snabbare planer för frågeexekvering.
När en sats inom en batch utlöser omkompilering, är det bara den satsen som kompileras om, inte hela batchen. Denna regel gäller oavsett om batchen skickas in via en lagrad procedur, trigger, ad hoc-batch eller förberett uttryck.
Omkompilering på instruktionsnivå gynnar prestandan eftersom ett litet antal satser i de flesta fall orsakar omkompileringar och deras tillhörande kostnader, i form av CPU-tid och låsningar. Dessa påföljder undviks därför för de andra satserna i batchen som inte behöver omkompileras.
Den sql_statement_recompile utökade händelsen (XEvent) rapporterar omkompileringar på instruktionsnivå. Denna XEvent inträffar när en omkompilering på instruktionsnivå krävs av någon typ av batch. Detta krav inkluderar lagrade procedurer, triggers, ad hoc-batcher och frågor. Batches kan skickas in via flera gränssnitt, inklusive sp_executesql, dynamisk SQL, Prepare-metoder eller Execute-metoder.
Kolumnen recompile_cause i sql_statement_recompile XEvent innehåller en heltalskod som anger orsaken till omkompileringen. Följande lista innehåller möjliga orsaker:
- Marköralternativen har ändrats
- Uppskjuten kompilering
-
FOR BROWSEbehörigheten har ändrats -
OPTION (RECOMPILE)begärd - Parametriserad plan utrensad
- Partitionerad vy har ändrats
- Plan som påverkar databasversionen har ändrats
- Frågemeddelandemiljön har ändrats
- Query Store saknar en plan
- Det gick inte att tvinga fram query Store-planen
- Policy för tvingande av Query Store-planer har ändrats
- Fjärrraduppsättningen har ändrats
- Schemat har ändrats
-
SETalternativet har ändrats - Statistik har ändrats
- Temporär tabell har ändrats
Not
När du sätter AUTO_UPDATE_STATISTICS databasalternativet till ON, kompileras frågor om när de riktar sig mot tabeller eller indexerade vyer vars statistik uppdateras eller vars kardinaliteter förändras avsevärt sedan senaste körning. Det här beteendet gäller för användardefinierade standardtabeller, temporära tabeller och de infogade och borttagna tabeller som skapats av DML-utlösare.
Att ställa in AUTO_UPDATE_STATISTICS på OFF stoppar dessa omkompileringar, men inaktuell statistik försämrar vanligtvis frågeprestandan mer än omkompileringarna gör. För mer information, se alternativet AUTO_UPDATE_STATISTICS . Tabellerna inserted och deleted för DML-triggers INSTEAD OF skapas i tempdb, så de följer inställningen AUTO_UPDATE_STATISTICS av tempdb.
Använd explicita parametrar för återanvändning av planer
Att använda parametrar, inklusive namngivna parametrar i ADO.NET-applikationer och parametermarkörer i OLE DB- och ODBC-applikationer, kan öka återanvändningen av exekveringsplaner.
Varning
Verifiera alltid användarindata genom att testa typ, längd, format och intervall. För mer information, se SQL-injektion.
Den enda skillnaden mellan följande två SELECT-instruktioner är de värden som jämförs i WHERE-satsen:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Den enda skillnaden mellan körningsplanerna för dessa frågor är värdet som lagras för jämförelsen med kolumnen ProductSubcategoryID. Målet är att Database Engine alltid ska känna igen att satserna genererar i princip samma plan och återanvända planerna, men Database Engine upptäcker ibland inte denna likhet i komplexa T-SQL-satser.
Att separera konstanter från T-SQL-satsen med hjälp av parametrar hjälper relationsmotorn att känna igen dubblettplaner. Använd parametrar på följande sätt:
I T-SQL, använd
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Denna metod rekommenderas för T-SQL-skript, lagrade procedurer eller triggers som genererar SQL-satser dynamiskt.
ADO.NET med
SqlClientanvänder namngivna parametrar, såsom@Parm. OLE DB och ODBC använder parametermarkörer. Parametermarkörer är frågetecken (?) som ersätter en konstant i en SQL-sats och är bundna till en programvariabel. Du skulle till exempel göra följande i ett ODBC-program:Använd
SQLBindParameterför att binda en heltalsvariabel till den första parametermarkören i en SQL-instruktion.Placera heltalsvärdet i variabeln.
Exekvera instruktionen och specificera parametermarkören (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
SQL Server Native Client OLE DB Provider och SQL Server Native Client ODBC-drivrutinen använder
sp_executesqlför att skicka satser till SQL Server när parametermarkörer används i applikationer.Skriv lagrade procedurer som är utformade för att använda parametrar.
Om du inte explicit bygger in parametrar i designen av dina applikationer kan du också lita på att Query Optimizer automatiskt parameteriserar vissa frågor genom att använda standardbeteendet för enkel parameterisering. Du kan också tvinga frågeoptimeraren att överväga att parameterisera alla frågor i databasen genom att ange alternativet PARAMETERIZATION för ALTER DATABASE-instruktionen till FORCED.
Enkel parameterisering
I Database Engine ökar användning av parametrar eller parametermarkörer i T-SQL-satser relationsmotorns förmåga att matcha nya T-SQL-satser med befintliga, tidigare kompilerade exekveringsplaner.
Varning
Verifiera alltid användarindata genom att testa typ, längd, format och intervall. För mer information, se SQL-injektion.
Om en T-SQL-sats exekveras utan parametrar parameteriserar Database Engine satsen internt för att öka möjligheten att matcha den mot en befintlig exekveringsplan. Denna process kallas parameterisering. Standardinställningen är enkel parameterisering, och du kan aktivera tvingad parameterisering för en databas.
Tänk på det här påståendet:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Du kan ange värdet 1 i slutet av uttrycket som en parameter. Relationsmotorn bygger exekveringsplanen för denna batch som om du specificerat en parameter istället för värdet 1. På grund av denna enkla parameterisering känner Database Engine igen att följande två satser genererar i princip samma exekveringsplan och återanvänder den första planen för den andra satsen:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Vid bearbetning av komplexa T-SQL-satser kan relationsmotorn ha svårt att avgöra vilka uttryck som kan parametriseras. För att öka relationsmotorns förmåga att matcha komplexa T-SQL-satser med befintliga, oanvända exekveringsplaner, specificera explicit parametrarna genom att använda antingen sp_executesql eller parametermarkörer.
Not
När du använder +, -, *, / eller % aritmetiska operatorer för att utföra implicit eller explicit konvertering av int-, smallint-, tinyint- eller bigint-konstantvärden till float-, real-, decimal- eller numeric datatyper, applicerar Database Engine specifika regler för att beräkna typ och precision i uttrycksresultaten. Dessa regler skiljer sig åt beroende på om frågan är parameteriserad. Därför kan liknande uttryck i frågor i vissa fall ge olika resultat.
Under standardbeteendet för enkel parameterisering parameteriserar Database Engine en relativt liten klass av frågor. Du kan dock ange att alla frågor i en databas ska parametriseras, med vissa begränsningar, genom att ange alternativet PARAMETERIZATION för kommandot ALTER DATABASE till FORCED. Denna förändring kan förbättra prestandan hos databaser som upplever stora volymer samtidiga queries genom att minska frekvensen av frågekompileringar.
Du kan också ange att en enskild fråga, och andra som är syntaktiskt likvärdiga men bara skiljer sig åt i deras parametervärden, ska parametriseras.
Tips
När du använder en objektrelationell mappningslösning (ORM) som Entity Framework (EF) kan frågor i applikationen, såsom manuella LINQ-frågeträd eller vissa råa SQL-frågor, vara oparametriserade. Denna begränsning påverkar återanvändning av planer och möjligheten att spåra frågor i Query Store. Mer information finns i Cachelagring och parameterisering av EF-frågor och råa SQL-frågor.
Tvingad parameterisering
Du kan åsidosätta Database Engines standardparametriseringsbeteende genom att specificera att alla SELECT, INSERT, UPDATE och DELETE-satser i en databas ska parametriseras, med vissa begränsningar. Aktivera tvingad parameterisering genom att ställa in PARAMETERIZATION alternativet till FORCED i satsen ALTER DATABASE . Tvingad parameterisering kan förbättra prestandan för vissa databaser genom att minska frekvensen för frågekompileringar och omkompileringar. Databaser som kan dra nytta av tvingad parameterisering är vanligtvis de som har stora mängder samtidiga frågor från källor som till exempel program för försäljningsställen.
När du sätter alternativet PARAMETERIZATION till FORCED, konverteras alla literala värden som förekommer i en SELECT, INSERT, UPDATE eller DELETE-sats, som skickas in i någon form, till en parameter under frågekompilering. Undantagen är literaler som visas i följande frågekonstruktioner:
-
INSERT...EXECUTE-uttalanden. - Instruktioner i organen för lagrade procedurer, utlösare eller användardefinierade funktioner. Database Engine återanvänder redan frågeplaner för dessa rutiner.
- förberedda uttryck som redan är parametriserade i klientapplikationen.
- Instruktioner som innehåller XQuery-metodanrop, där metoden visas i en kontext där dess argument vanligtvis parametriseras, till exempel en
WHERE-sats. Om en metod instansieras i ett sammanhang där dess argument inte är parametriserade, parametriseras resten av uttrycket. - Satser inuti en T-SQL-markör. (
SELECT-instruktioner inuti API-markörer parametriseras.) - Inaktuella frågekonstruktioner.
- Varje sats som körs i kontexten av
ANSI_PADDINGellerANSI_NULLSinställd påOFF. - Uttryck som innehåller fler än 2 097 literaler som kan parameteriseras.
- Satser som refererar till variabler, till exempel
WHERE T.col2 >= @bb. - Instruktioner som innehåller
RECOMPILEfrågetips. - Uttalanden som innehåller en
COMPUTE-sats. - Uttalanden som innehåller en
WHERE CURRENT OF-sats.
Följande frågeklausuler är inte parametriserade. I dessa fall är det bara satserna som inte parametriseras. Andra satser i samma fråga kan vara berättigade till tvingad parameterisering.
- Det
<select_list>av enSELECTsats. Denna lista inkluderarSELECTlistor över underfrågor ochSELECTlistor inutiINSERTsatser. - Sats för underfråga
SELECTsom förekommer i enIF-sats. - Satserna
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOellerFOR XMLi en fråga. - Argument, antingen direkt eller som underuttryck, till
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXMLeller någonFULLTEXT-operatör. - Mönstret och escape_character-argumenten i en
LIKE-sats. - Stilargumentet för en
CONVERT-sats. - Heltalskonstanter i en
IDENTITY-sats. - Konstanter som anges med hjälp av ODBC-tilläggssyntax.
- Konstant vikbara uttryck som är argument för operatorerna
+,-,*,/och%. När Database Engine betraktar behörighet för tvingad parameterisering betraktar den ett uttryck som konstant-vikbart när någon av följande villkor är uppfylld:- Inga kolumner, variabler eller underfrågor visas i uttrycket.
- Uttrycket innehåller en
CASE-sats.
- Argument till query hint-klausuler, inklusive argumentet number_of_rows i
FASTfråge-hintet, det number_of_processors-argumentet i frågeledtrådenMAXDOPoch argumentet number i frågeledtrådenMAXRECURSION.
Parameterisering sker på nivån för individuella T-SQL-satser. Med andra ord parametriseras enskilda instruktioner i en batch. Efter kompilering körs en parameteriserad fråga i kontexten av den batch där den ursprungligen skickades in. Om en exekveringsplan för en fråga är cachad kan du avgöra om frågan har parametriserats genom att referera till sql-kolumnen i den dynamiska hanteringsvyn sys.syscacheobjects. Om en fråga är parameteriserad kommer namn och datatyper av parametrar före texten i den inskickade batchen i denna kolumn, såsom (@1 TINYINT).
Not
Parameternamn är godtyckliga. Användare eller applikationer bör inte förlita sig på en särskild namnordning. Dessutom kan följande objekt ändras mellan versioner av SQL Server och kumulativa uppdateringar (CU): Parameternamn, val av parametriserade literaler och avstånd i den parameteriserade texten.
Datatyper av parametrar
När Database Engine parametriserar literaler konverteras parametrarna till följande datatyper:
- Heltalsliteraler vars storlek annars skulle passa inom int-datatypen parameteriserar till int. Större heltalsliteraler som är delar av predikat som involverar vilken jämförelseoperator som helst (inklusive
<,<=,=,!=,>,>=,!<,!>,ANY,ALL,SOME,BETWEEN,<>ochIN) parameteriserar till numeric(38,0). Större literaler som inte är delar av predikat som involverar jämförelseoperatorer parameteriseras som numeric med precis tillräckligt stor precision för att stödja dess storlek och vars skala är 0. - Numeriska litteraler med fast punkt som är delar av predikat med jämförelseoperatorer parametriseras till numeric med en precision på 38 och en skala som är precis tillräckligt stor för att stödja dess storlek. Fastpunktsnumeriska litteraler som inte är delar av predikat som involverar jämförelseoperatorer ges typen numeric, med precision och skala som är precis tillräckliga för att rymma värdets storlek.
- Flyttalsliteraler parametriserar till float(53).
- Icke-Unicode-strängliteraler parametriseras till varchar(8000) om literalen får plats inom 8 000 tecken, och till varchar(max) om den är större än 8 000 tecken.
- Unicode-strängliteraler parameteriseras till nvarchar(4000) om literalen ryms inom 4 000 Unicode-tecken, och till nvarchar(max) om literalen är större än 4 000 tecken.
- Binära literaler parametriseras till varbinary(8000) om literalen ryms inom 8 000 byte. Om den är större än 8 000 byte konverteras den till varbinary(max).
- Penningslitteraler parameteriseras till money.
Riktlinjer för användning av tvingad parameterisering
Tänk på följande punkter när du sätter PARAMETERIZATION alternativet till FORCED:
- Tvingad parameterisering ändrar de bokstavliga konstanterna i en fråga till parametrar vid kompilering av en fråga. Därför kan Frågeoptimeraren välja suboptimala planer för frågor. I synnerhet är det mindre troligt att frågeoptimeraren matchar frågan med en indexerad vy eller ett index i en beräknad kolumn. Den kan också välja suboptimala planer för frågor som ställs i partitionerade tabeller och distribuerade partitionerade vyer. Använd inte tvingad parameterisering för miljöer som är starkt beroende av indexerade vyer och index på beräknade kolumner. Generellt bör endast erfarna databasproffs använda
PARAMETERIZATION FORCEDalternativet efter att ha fastställt att det inte påverkar prestandan negativt. - Distribuerade frågor som refererar till mer än en databas är berättigade till tvingad parameterisering så länge som alternativet
PARAMETERIZATIONär inställt påFORCEDi databasen vars kontext frågan körs. - Att ställa in alternativet
PARAMETERIZATIONtillFORCEDrensar alla frågeplaner från databasens plancache, förutom de som för närvarande kompileras om, kompileras eller körs. Planer för frågor som kompileras eller körs under inställningsändringen parameteriseras nästa gång frågan körs. - Att ställa in
PARAMETERIZATIONalternativet är en onlineoperation som inte kräver några exklusiva lås på databasnivå. - Den aktuella inställningen för alternativet
PARAMETERIZATIONbevaras när du kopplar om eller återställer en databas.
Du kan åsidosätta beteendet för tvingad parameterisering genom att specificera att enkel parameterisering ska försökas på en enda fråga, samt på alla andra frågor som är syntaktiskt ekvivalenta men endast skiljer sig åt i sina parametervärden. Däremot kan du ange att tvingad parameterisering endast ska utföras på en uppsättning syntaktiskt likvärdiga frågor, även om tvingad parameterisering är inaktiverad i databasen. Använd plan guides för detta ändamål.
Not
När alternativet PARAMETERIZATION är inställt på FORCEDkan rapporteringen av felmeddelanden skilja sig från när alternativet PARAMETERIZATION är inställt på SIMPLE: flera felmeddelanden kan rapporteras under tvingad parameterisering, där färre meddelanden rapporteras under enkel parameterisering och radnumren där fel inträffar kan rapporteras felaktigt.
När tvingad parameterisering är aktiverad kan enkel parameterisering fortfarande ske. Följande fråga kan till exempel inte parametriseras enligt reglerna för tvingad parameterisering:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Den kan dock parametriseras enligt enkla parameteriseringsregler. När framtvingad parameterisering provas men misslyckas provas fortfarande enkel parameterisering.
Förbereda SQL-instruktioner
Database Engine stödjer förberedelse av T-SQL-satser innan exekvering. Om en applikation behöver köra en T-SQL-sats flera gånger kan den använda databasens API för att:
- Förbered uttalandet en gång. Detta steg kompilerar T-SQL-satsen till en exekveringsplan.
- Kör den förkompilerade exekveringsplanen varje gång den behöver exekvera satsen. Denna metod förhindrar att T-SQL-satsen kompileras om vid varje körning efter första försöket. Förberedelse och körning av instruktioner styrs av API-funktioner och -metoder. SQL Server Native Client OLE DB Provider och SQL Server Native Client ODBC-drivrutinen stödjer prepare/execute-modellen för att köra T-SQL-satser. På en förberedelsebegäran skickar antingen providern eller drivrutinen uttalandet till SQL Server med en begäran om att förbereda det. Database Engine kompilerar en exekveringsplan och returnerar en referens för den planen till leverantören eller drivrutinen. Vid en körningsbegäran skickar antingen providern eller drivrutinen en begäran till servern om att köra planen som är associerad med handtaget.
Prepared-satser kan inte skapa tillfälliga objekt i Database Engine. Förberedda instruktioner kan inte referera till system lagrade procedurer som skapar temporära objekt, till exempel temporära tabeller. Dessa procedurer måste köras direkt.
Alltför hög användning av förbereda/utföra-modellen kan försämra prestandan. Om en sats bara körs en gång krävs direkt exekvering endast en nätverksrundresa till servern. Att förbereda och köra en T-SQL-sats som bara körs en gång kräver en extra nätverksrundtur: en resa för att förbereda satsen och en för att köra den.
Att förbereda en sats är mer effektivt om du använder parametermarkörer. Anta till exempel att ett program ibland uppmanas att hämta produktinformation från AdventureWorksLT2025 exempeldatabas. Det finns två sätt att utföra den här uppgiften.
Genom att använda det första tillvägagångssättet kan applikationen köra en separat fråga för varje efterfrågad produkt:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Med den andra metoden utför applikationen följande operationer:
Förbereder en instruktion som innehåller en parametermarkör (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Binder en programvariabel till parametermarkören.
Varje gång produktinformation behövs, fylls den bundna variabeln med nyckelvärdet och instruktionen körs.
Den andra metoden är mer effektiv om satsen utförs mer än tre gånger.
I Database Engine har prepare/execute-modellen ingen betydande prestandafördel jämfört med direkt exekvering, på grund av hur Database Engine återanvänder exekveringsplaner. Database Engine har effektiva algoritmer för att matcha aktuella T-SQL-satser med exekveringsplaner som genererats för tidigare exekveringar av samma T-SQL-sats. Om en applikation kör en T-SQL-sats med parametermarkörer flera gånger, återanvänder Database Engine exekveringsplanen från den första körningen för den andra och efterföljande exekveringar (om inte planen åldras från plancachen). Modellen prepare/execute har fortfarande följande fördelar:
- Att hitta en exekveringsplan via en identifierare är mer effektivt än de algoritmer som används för att matcha en T-SQL-sats med befintliga exekveringsplaner.
- Applikationen kan kontrollera när exekveringsplanen skapas och när den återanvänds.
- Modellen prepare/execute är portabel för andra databaser, inklusive tidigare versioner av SQL Server.
Parameterkänslighet
Parameterkänslighet, även känt som parametersniffing, avser en process där Database Engine sniffar de aktuella parametervärdena under kompilering eller omkompilering och skickar dem till Query Optimizer för att potentiellt hjälpa till att generera effektivare planer för frågeexekvering.
Parametervärden sniffas under kompilering eller omkompilering för följande typer av batchar:
- Lagrade procedurer
- Frågor som skickas via
sp_executesql - Förberedda frågor
För mer information om felsökning av parametersniffing, se:
- Undersöka och lösa parameterkänsliga problem
- Använd uttryckliga parametrar för återanvändning av plan
- optimering av parameterkänslig plan
- Felsöka frågor med problem med parameterkänslig frågekörningsplan i Azure SQL Database
- Felsöka frågor med problem i exekveringsplaner för parameterkänsliga frågor i Azure SQL Managed Instance
När en fråga i Database Engine använder tipset OPTION (RECOMPILE) omvandlar Query Optimizer parameter- och lokala variabler till kompileringstidskonstanter som kan konstantförenklas och reduceras till literaler. Under kompilering känner optimeraren till och kan använda de aktuella runtime-värdena för parametrar och lokala variabler som de finns precis före den satsen. Hinten OPTION (RECOMPILE) gör det möjligt för optimeraren att generera en mer optimal frågeplan anpassad till de specifika värdena och att dra nytta av de bästa underliggande indexen vid körning. För parametrar refererar den här processen inte till de värden som ursprungligen skickades till batchen eller den lagrade proceduren, utan till deras värden vid tidpunkten för omkompileringen. Dessa värden kan modifieras inom proceduren innan de når satsen som inkluderar RECOMPILE. Detta beteende kan förbättra prestandan för frågor med mycket variabel eller snedvriden indata, men på bekostnad av att frågan måste kompileras varje gång den körs. Denna kostnad kan vara hög. Undvik att använda tipset RECOMPILE utan att bedöma dess påverkan på hela arbetsbelastningen.
Lokala variabler och kardinalitetsskattningar
När en fråga använder lokala variabler kan Database Engine inte sniffa deras värden vid kompilering, så den uppskattar kardinaliteten med hjälp av tillgänglig statistik eller heuristik. Om statistik finns använder den vanligtvis värdet All Density (kallas även genomsnittlig densitet) från det statistiska histogrammet för att uppskatta hur många rader som matchar predikatet. Om det däremot inte finns någon statistik för kolumnen använder Database Engine i stället heuristiska skattningar, såsom att anta 10 % selektivitet för likhetspredikat och 30 % för ojämlikheter och intervall. Dessa uppskattningar kan leda till mindre exakta körningsplaner. Här är ett exempel på en fråga som använder en lokal variabel.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
I det här fallet använder inte Database Engine värdet 100 för att optimera frågan. Den använder en allmän uppskattning.
Parallell frågebearbetning
Database Engine tillhandahåller parallellbearbetning av frågor för att optimera frågexekvering och indexoperationer för datorer som har mer än en mikroprocessor (CPU). Eftersom Database Engine kan utföra en fråge- eller indexoperation parallellt genom att använda flera arbetstrådar i operativsystemet, slutförs operationen snabbt och effektivt.
Under frågeoptimering letar Database Engine efter frågor eller indexoperationer som kan gynnas av parallell körning. För dessa frågor infogar Database Engine exchange-operatorer i frågeexekveringsplanen för att förbereda frågan för parallell exekvering. En utbytesoperator är en operator i en frågeexekveringsplan som tillhandahåller processhantering, omfördelning av data och flödeskontroll. Exchange-operatorn innehåller Distribute Streams, Repartition Streamsoch Gather Streams logiska operatorer som undertyper, varav en eller flera kan visas i Showplan-utdata från en frågeplan för en parallell fråga.
Viktig
Vissa konstruktioner hämmar Database Engine:s förmåga att använda parallellism på hela exekveringsplanen eller delar av exekveringsplanen.
Konstruktioner som hämmar parallellitet är:
| Konstruera | Beskrivning |
|---|---|
| skalära UDF:er | För mer information om skalära användardefinierade funktioner, se Skapa användardefinierade funktioner. Från och med SQL Server 2019 (15.x) kan Databasmotor för SQL Server infoga dessa funktioner direkt och möjliggöra parallell körning under frågebehandling. För mer information om skalär UDF-inlinning, se Intelligent frågebehandling i SQL-databaser. |
| Fjärrfråga | För mer information om Remote Query, se Referens för logiska och fysiska showplan-operatorer. |
| dynamiska markörer | För mer information om cursors, se DECLARE CURSOR. |
| Rekursiva frågor | För mer information om rekursion, se Riktlinjer för att definiera och använda rekursiva vanliga tabelluttryck och rekursion i T-SQL. |
| Flervärdeskodfunktioner (mstvf) | För mer information om MSTVF:er, se Skapa användardefinierade funktioner (databasmotor). |
TOP nyckelord |
Mer information finns i TOP. |
En frågekörningsplan kan innehålla attributet NonParallelPlanReason i elementet QueryPlan, som beskriver varför parallellitet inte användes. Värden för det här attributet är:
| NonParallelPlanReason-värde | Beskrivning |
|---|---|
MaxDOPSetToOne |
Maximal grad av parallellism är satt till 1. |
EstimatedDOPIsOne |
Uppskattad grad av parallellism är 1. |
NoParallelWithRemoteQuery |
Parallellitet stöds inte för fjärrfrågor. |
NoParallelDynamicCursor |
Parallella planer stöds inte för dynamiska markörer. |
NoParallelFastForwardCursor |
Parallella planer stöds inte för snabbåtkomstmarkörer. |
NoParallelCursorFetchByBookmark |
Parallella planer stöds inte för markörer som hämtar efter bokmärke. |
NoParallelCreateIndexInNonEnterpriseEdition |
Parallell indexskapande stöds inte för icke-Enterprise-utgåva. |
NoParallelPlansInDesktopOrExpressEdition |
Parallella planer stöds inte för Desktop och Express Edition. |
NonParallelizableIntrinsicFunction |
Frågan refererar till en inbyggda funktion som inte kan parallelliseras. |
CLRUserDefinedFunctionRequiresDataAccess |
Parallellitet stöds inte för en CLR UDF som kräver dataåtkomst. |
TSQLUserDefinedFunctionsNotParallelizable |
Frågan refererar till en användardefinierad T-SQL-funktion som inte kunde parallelliseras. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Tabellvariabeltransaktioner stöder inte parallella kapslade transaktioner. |
DMLQueryReturnsOutputToClient |
DML-frågan returnerar utdata till klienten och kan inte parallelliseras. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
En blandning av serie- och parallella planer för en enda onlineindexuppbyggnad stöds inte. |
CouldNotGenerateValidParallelPlan |
Det gick inte att verifiera den parallella planen och gick inte tillbaka till seriellt. |
NoParallelForMemoryOptimizedTables |
Parallellitet stöds inte för refererade In-Memory OLTP-tabeller. |
NoParallelForDmlOnMemoryOptimizedTable |
Parallellitet stöds inte för DML i en In-Memory OLTP-tabell. |
NoParallelForNativelyCompiledModule |
Parallellitet stöds inte för refererade nativt kompilerade moduler. |
NoRangesResumableCreate |
Intervallgenereringen misslyckades för en återupptagbar skapandeoperation. |
När exchange-operatorerna har infogats är resultatet en exekveringsplan för parallella frågor. En körningsplan för parallella frågor kan använda mer än en arbetstråd. En seriell körningsplan som används av en icke-parallell fråga (seriell) använder endast en arbetstråd för körningen. Det faktiska antalet arbetstrådar som används av en parallell fråga bestäms vid initialisering av frågeplanens exekvering och beror på planens komplexitet och graden av parallellism.
Graden av parallellism (DOP) anger det maximala antalet processorer som kan användas för att utföra en parallell uppgift. DOP anger inte det totala antalet arbetstrådar som används av en fråga. DOP-gränsen anges för uppgift. Det är inte ett gräns per begäran eller per förfrågan. Det innebär att under en parallell frågekörning kan en enskild begäran skapa flera uppgifter som har tilldelats till en schemaläggaren. Fler processorer än vad som anges av MAXDOP kan användas samtidigt vid en viss punkt under frågekörningen, när olika uppgifter utförs samtidigt. Mer information finns i tråd- och uppgiftsarkitekturguiden.
Frågeoptimeraren använder inte en parallell exekveringsplan för en fråga om något av följande villkor är uppfyllt:
Den seriella exekveringsplanen är trivial eller överskrider inte kostnadsgränsen för parallellisminställning.
Den seriella körningsplanen har en lägre total uppskattad delträdskostnad än någon parallell körningsplan som utforskas av optimeraren.
Frågan innehåller skalär- eller relationsoperatorer som inte kan köras parallellt. Vissa operatorer kan orsaka att ett avsnitt i frågeplanen körs i serieläge eller att hela planen körs i serieläge.
Not
Den totala uppskattade kostnaden för underträd för en parallell plan kan vara lägre än kostnadströskelvärdet för parallellitetsinställning. Med andra ord översteg den totala uppskattade delträdskostnaden för den seriella planen detta värde, och frågeplanen med den lägsta totala uppskattade delträdskostnaden valdes.
Grad av parallellitet (DOP)
Database Engine upptäcker automatiskt den bästa graden av parallellism för varje instans av en parallell frågeexekvering eller Index Data Definition Language (DDL)-operation. Den bestämmer detta värde baserat på följande kriterier:
Om SQL Server körs på en dator som har mer än en mikroprocessor eller processor, till exempel en symmetrisk multiprocessdator (SMP). Endast datorer som har mer än en PROCESSOR kan använda parallella frågor.
Om tillräckligt med arbetstrådar är tillgängliga. Varje fråga eller indexåtgärd kräver ett visst antal arbetstrådar för att köras. Att köra en parallell plan kräver fler arbetstrådar än en seriell plan, och antalet obligatoriska arbetstrådar ökar med graden av parallellitet. När kravet på arbets-/arbetstrådar i den parallella planen för en viss grad av parallellism inte kan uppfyllas, minskar Databasmotor för SQL Server automatiskt graden av parallellism eller kör parallellplanen seriellt.
Den typen av fråge- eller indexåtgärd som körs. Indexåtgärder som skapar eller återskapar ett index eller släpper ett klustrat index och frågor som använder CPU-cykler är de bästa kandidaterna för en parallell plan. Till exempel är kopplingar till stora tabeller, stora aggregeringar och sortering av stora resultatuppsättningar bra kandidater. Grundläggande databasfrågor, som ofta finns i transaktionsbehandlingsapplikationer, innebär att den extra samordning som krävs för att köra en databasfråga parallellt överväger den potentiella prestandaökningen. För att skilja mellan frågor som drar nytta av parallellitet och de som inte gynnas jämför Databasmotor för SQL Server den uppskattade kostnaden för att köra fråge- eller indexåtgärden med kostnadströskel för parallellitet värde. Användare kan ändra standardvärdet av
5genom att använda sp_configure om korrekt testning visar att ett annat värde passar bättre för den körande arbetsbelastningen.Om det finns tillräckligt många rader för att bearbeta. Om frågeoptimeraren bedömer att antalet rader är för lågt introducerar det inte exchange-operatorer för att distribuera raderna. Därför körs operatorerna seriellt. Att köra operatorerna i en serieplan undviker scenarier när start-, distributions- och samordningskostnaderna överskrider de vinster som uppnås vid parallell operatörskörning.
Om aktuell statistik finns tillgänglig. Om den högsta graden av parallellitet inte är möjlig beaktas lägre grader innan den parallella planen överges. Till exempel, när du skapar ett klustrat index på en vy kan statistik inte utvärderas, eftersom det klustrade indexet ännu inte existerar. I det här fallet kan Databasmotor för SQL Server inte tillhandahålla den högsta graden av parallellitet för indexåtgärden. Vissa operatorer, till exempel sortering och genomsökning, kan dock fortfarande dra nytta av parallell körning.
Not
Parallella indexåtgärder är endast tillgängliga i SQL Server Enterprise-, Utvecklar- och utvärderingsversioner.
Vid körningen avgör Databasmotor för SQL Server om den aktuella systemarbetsbelastningen och konfigurationsinformationen som beskrevs tidigare tillåter parallell körning. Om parallell körning är berättigad avgör Databasmotor för SQL Server det optimala antalet arbetstrådar och sprider körningen av den parallella planen över dessa arbetstrådar. När en fråge- eller indexåtgärd börjar köras på flera arbetstrådar för parallell körning används samma antal arbetstrådar tills åtgärden har slutförts. Databasmotor för SQL Server omvärderar det optimala antalet arbetstrådar varje gång en körningsplan hämtas från plancachen. Till exempel kan en körning av en cachad parallellplan köras seriellt, en senare körning av samma plan kan använda tre arbetstrådar, och en tredje körning kan använda fyra arbetstrådar.
Uppdaterings- och borttagningsoperatorerna i en parallell frågekörningsplan körs seriellt, men WHERE-satsen i en UPDATE- eller DELETE-instruktion kan köras parallellt. De faktiska dataändringarna tillämpas sedan seriellt på databasen.
Från och med databaskompatibilitetsnivå 110 kan satsen SELECT ... INTO exekveras parallellt. Andra former av insert-operatorer fungerar på samma sätt som beskrivits i tidigare versioner.
Från och med databaskompatibilitetsnivå 130 kan instruktionen INSERT ... SELECT köras parallellt när man infogar i heaps eller klustrade kolumnlagringsindex (CCI), och med hjälp av hinten TABLOCK. Insättningar i lokala temporära tabeller (identifierade med prefixet # ) och globala temporära tabeller (identifierade med ## prefix) aktiveras också för parallellism med hjälp av hinten TABLOCK . Mer information finns i INSERT.
Statiska och keyset-drivna markörer kan fyllas i med parallella exekveringsplaner. Beteendet för dynamiska markörer kan dock endast uppnås genom sekventiell exekvering. Frågeoptimeraren genererar alltid en seriell exekveringsplan för en fråga som ingår i en dynamisk pekare.
Åsidosätt parallellitetsgrader
Graden av parallellitet anger antalet processorer som ska användas vid parallell plankörning. Du kan ställa in denna konfiguration på olika nivåer:
På servernivå genom att använda serverkonfigurationsalternativet max degree of parallelism (
MAXDOP).Gäller för: SQL Server
SQL Server 2019 (15.x) införde automatiska rekommendationer för att ställa in
MAXDOPserverkonfigurationsalternativet under installationsprocessen. Med installationsanvändargränssnittet kan du antingen acceptera de rekommenderade inställningarna eller ange ditt eget värde. Mer information finns i Database Engine Configuration – MaxDOP-sidan.Arbetsbelastningsnivå, genom att använda
MAX_DOPkonfigurationsalternativet för arbetsbelastningsgruppen i Resource Governor.Gäller för: SQL Server
Databasnivå, genom att använda
MAXDOPdatabasspecifik konfiguration.Gäller för: SQL Server, Azure SQL Database och Azure SQL Managed Instance
På fråge- eller indexsatsnivå genom att använda
MAXDOPfrågetips ellerMAXDOPindexalternativ. Till exempel kan du använda alternativetMAXDOPför att styra, genom att öka eller minska, antalet processorer dedikerade till en onlineindexoperation. På detta sätt kan du balansera resurserna som används av en indexoperation med de samtidiga användarnas resurser.Gäller för: SQL Server, Azure SQL Database och Azure SQL Managed Instance
Genom att sätta max degree of parallelism alternativet till 0 (standard) kan Database Engine använda alla tillgängliga processorer upp till maximalt 64 processorer i en parallell planexekvering. Även om Database Engine sätter ett körtidsmål på 64 logiska processorer när MAXDOP alternativet är inställt på 0, kan du manuellt ställa in ett annat värde om det behövs. Att ställa in MAXDOP på 0 för frågor och index gör att Database Engine kan använda alla tillgängliga processorer upp till maximalt 64 processorer för de givna frågorna eller indexen i en parallell planexekvering.
MAXDOP är inte ett påtvingat värde för alla parallella frågekörningar, utan snarare ett preliminärt mål för alla frågekörningar som kan köras parallellt. Detta innebär att om inte tillräckligt många arbetstrådar finns tillgängliga vid körning kan en fråga köras med lägre grad av parallellism än vad serverkonfigurationsalternativet MAXDOP anger.
Tips
För mer information, se MAXDOP-rekommendationer för riktlinjer om hur du konfigurerar MAXDOP på server-, databas-, fråge- eller hintnivå.
Exempel på parallell fråga
Följande SQL-fråga räknar antalet beställningar som lagts under ett specifikt kvartal, med start den 1 april 2024, och där minst en orderrad i beställningen mottogs av kunden senare än det utlovade datumet. Den här frågan visar antalet sådana beställningar grupperade efter varje orderprioritet och sorterade i stigande prioritetsordning.
I det här exemplet används teoretiska tabell- och kolumnnamn.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Anta att följande index har definierats i tabellerna lineitem och orders:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Här är en möjlig parallell plan som genererats för frågan som visades tidigare:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
Följande illustration visar en frågeplan som utförs med en grad av parallellism lika med 4 och involverar en tvåtabellsjoin.

Den parallella planen innehåller tre parallellitetsoperatorer. Både indexsökningsoperatorn för o_datkey_ptr-indexet och indexgenomsökningsoperatorn för l_order_dates_idx index utförs parallellt. Denna process ger flera separata strömmar, som kan bestämmas från närmaste parallellismoperatorer ovanför Index Scan respektive Index Seek-operatorerna. Båda operatorerna ompartitionerar om typen av Exchange. De blandar om data mellan strömmarna och producerar samma antal strömmar på deras output som de har på sin indata. Det här antalet strömmar är lika med graden av parallellitet.
Parallellismoperatorn ovanför l_order_dates_idx Index Scan-operatorn ompartitionerar sina inmatningsströmmar med värdet av L_ORDERKEY som nyckel. På så sätt hamnar samma värden för L_ORDERKEY i samma utdataström. Samtidigt bibehåller utdataströmmar ordningen på kolumnen L_ORDERKEY för att säkerställa att indatakravet för operatorn Merge Join uppfylls.
Parallellismoperatorn ovanför Index Seek-operatorn ompartitionerar sina indataströmmar med värdet av O_ORDERKEY. Eftersom dess indata inte sorteras på kolumnvärdena O_ORDERKEY och denna kolumn är join-kolumnen i operatorn Merge Join , ser Sort-operatorn mellan parallellism- och Merge Join-operatorerna till att indata är sorterad för operatorn Merge Join på join-kolumnerna. Operatorn Sort, till exempel merge join-operatorn, utförs parallellt.
Den översta parallellitetsoperatorn samlar in resultat från flera strömmar till en enda ström. Partiella aggregeringar som utförs av Stream Aggregate-operatorn under parallellitetsoperatorn ackumuleras sedan till ett enda SUM värde för varje värde för O_ORDERPRIORITY i Stream Aggregate-operatorn ovanför parallellismoperatorn. Eftersom denna plan har två utbytessegment, med grad av parallellism lika med 4, använder den åtta arbetstrådar.
För mer information om operatorerna som används i detta exempel, se referensen för Logical and physical showplan-operatorer.
Parallella indexåtgärder
Frågeplaner för indexoperationer som skapar eller bygger om ett index, eller tar bort ett klustrat index, kan stödja parallella, flertrådade operationer på datorer med flera processorer.
Not
Parallella indexoperationer finns endast tillgängliga i Enterprise-versionen.
Database Engine använder samma algoritmer för att bestämma graden av parallellism (det totala antalet separata arbetstrådar som ska köras) för indexoperationer som för andra frågor.
Konfigurationsalternativet för maximal grad av parallellism för servern anger den maximala graden av parallellism för en indexoperation. Du kan åsidosätta max degree of parallelism värdet för individuella indexoperationer genom att ställa in MAXDOP indexalternativet i CREATE INDEX, ALTER INDEX, DROP INDEX, och ALTER TABLE satserna.
När Databasmotor för SQL Server bygger en indexexekveringsplan sätts antalet parallella operationer till det lägsta värdet bland dessa värden:
- Antalet processorer, eller CPU:er, i datorn.
- Numret som anges i serverkonfigurationsalternativet
max degree of parallelism. - Antalet CPU:er som inte redan har passerat en tröskel för utfört arbete för SQL Server-arbetstrådar.
Till exempel, på en dator med åtta CPU:er, men där max degree of parallelism är satt till 6, använder indexoperationen högst sex parallella arbetstrådar. Om fem av processorerna på datorn överskrider tröskelvärdet för SQL Server-arbete när en indexkörningsplan skapas anger körningsplanen endast tre parallella arbetstrådar.
De viktigaste faserna i en parallellindexoperation inkluderar:
- En koordinerande arbetstråd söker snabbt och slumpmässigt igenom tabellen för att beräkna fördelningen av indexnycklarna. Den koordinerande arbetstråden fastställer nyckelgränserna som skapar ett antal nyckelintervall lika med graden av parallella operationer, där varje nyckelintervall uppskattas täcka liknande antal rader. Till exempel, om det finns fyra miljoner rader i tabellen och graden av parallellism är 4, bestämmer den koordinerande arbetstråden nyckelvärdena som avgränsar fyra uppsättningar rader med 1 miljon rader i varje mängd. Om den koordinerande arbetstråden inte kan etablera tillräckligt många nyckelintervall för att använda alla CPU:er, minskar den graden av parallellism därefter.
- Den koordinerande arbetstråden skickar ett antal arbetstrådar som är lika med antalet parallella processer och väntar på att dessa arbetstrådar ska slutföra sitt arbete. Varje arbetstråd söker igenom bastabellen med ett filter som endast hämtar rader med nyckelvärden inom det intervall som tilldelats till arbetstråden. Varje arbetstråd skapar en indexstruktur för raderna i dess nyckelintervall. När det gäller ett partitionerat index skapar varje arbetstråd ett angivet antal partitioner. Partitioner är inte delade mellan arbetstrådar.
- När alla parallella arbetstrådar är klara kopplar den koordinerande arbetstråden indexunderenheterna till ett enda index. Den här fasen gäller endast för offlineindexåtgärder.
Individuella CREATE TABLE eller ALTER TABLE satser kan ha flera begränsningar som kräver att ett index skapas. Dessa åtgärder för att skapa flera index utförs i serie, även om varje enskild åtgärd för att skapa index kan vara en parallell åtgärd på en dator som har flera processorer.
Arkitektur för distribuerad frågehantering
Database Engine stöder två metoder för att referera till heterogena OLE DB-datakällor i T-SQL-satser:
Länkade servernamn
Använd systemlagrade procedurer
sp_addlinkedserverochsp_addlinkedsrvloginför att ge ett servernamn till en OLE DB-datakälla. Du kan referera till objekt i dessa länkade servrar i T-SQL-satser med fyrdelade namn. Om till exempel ett länkat servernamn förDeptSQLSrvrdefinieras mot en annan instans av SQL Server refererar följande instruktion till en tabell på servern:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Du kan också ange det länkade servernamnet i en
OPENQUERYsats för att öppna en raduppsättning från OLE DB-datakällan. Du kan sedan referera till denna raduppsättning som en tabell i T-SQL-satser.Namn på ad hoc-anslutningar
Vid sällan förekommande referenser till en datakälla, ange funktionerna
OPENROWSETellerOPENDATASOURCEmed den information som behövs för att ansluta till den länkade servern. Du kan sedan referera till radmängden på samma sätt som du refererar till en tabell i T-SQL-satser:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
Database Engine använder OLE DB för att kommunicera mellan relationsmotorn och lagringsmotorn. Relationsmotorn delar upp varje T-SQL-sats i en serie operationer på grundläggande OLE DB-raduppsättningar som lagringsmotorn öppnar från bastabellerna. Denna process innebär att relationsmotorn också kan öppna grundläggande OLE DB-rowsets på vilken OLE DB-datakälla som helst.

Relationsmotorn använder API :et (OLE DB Application Programming Interface) för att öppna raduppsättningarna på länkade servrar, hämta raderna och hantera transaktioner.
För varje OLE DB-datakälla du kommer åt som en länkad server måste servern som kör SQL Server ha en OLE DB-leverantör. Mängden T-SQL-operationer du kan använda mot en specifik OLE DB-datakälla beror på kapaciteten hos OLE DB-leverantören.
För varje instans av SQL Server kan medlemmar i sysadmin fasta serverrollen aktivera eller inaktivera användningen av ad hoc-kopplingsnamn för en OLE DB-leverantör genom att använda SQL Server-DisallowAdhocAccessegenskapen. När du aktiverar ad hoc-åtkomst kan vilken användare som helst som är inloggad på den instansen köra T-SQL-satser med ad hoc-anslutningsnamn och referera till vilken datakälla som helst i nätverket som OLE DB-leverantören kan nå. För att kontrollera åtkomst till datakällor kan medlemmar i den fasta serverrollen sysadmin inaktivera ad hoc-åtkomst för den OLE DB-leverantören, vilket begränsar användare till endast de datakällor som refereras till av länkade servernamn som administratörerna definierar. Som standard är ad hoc-åtkomst aktiverad för SQL Server OLE DB-providern och inaktiverad för alla andra OLE DB-leverantörer.
Distribuerade frågor kan låta användare komma åt en annan datakälla (till exempel filer, icke-relationella datakällor som služba Active Directory med mera) genom att använda säkerhetskontexten för Windows-kontot som SQL Server-tjänsten körs under. SQL Server personifierar inloggningen på rätt sätt för Windows-inloggningar. Men den personifieringen är inte möjlig för SQL Server-inloggningar. Denna begränsning kan potentiellt tillåta en distribuerad frågeanvändare att komma åt en annan datakälla som de inte har behörigheter för, men kontot som SQL Server-tjänsten körs under har behörigheter. Använd sp_addlinkedsrvlogin för att definiera de specifika inloggningar som har behörighet att komma åt motsvarande länkade server. Denna kontroll är inte tillgänglig för ad hoc-namn, så var försiktig när du aktiverar en OLE DB-leverantör för ad hoc-åtkomst.
När det är möjligt låter Database Engine utföra relationella operationer såsom sammanfogningar, begränsningar, urval, sorteringar och grupperingsoperationer i OLE DB-datakällan. Database Engine skannar inte bastabellen som standard i SQL Server och utför relationsoperationerna själv. Database Engine frågar OLE DB-leverantören för att fastställa vilken nivå av SQL-grammatik den stödjer, och skickar baserat på den informationen så många relationsoperationer som möjligt till leverantören.
Database Engine specificerar en mekanism för en OLE DB-leverantör att returnera statistik som visar hur nyckelvärden distribueras inom OLE DB-datakällan. Denna mekanism gör det möjligt för Database Engine Query Optimizer att bättre analysera mönstret av data i datakällan mot kraven för varje T-SQL-sats, vilket ökar Query Optimizers förmåga att generera optimala exekveringsplaner.
Frågebehandling på partitionerade tabeller och index
Database Engine stödjer partitionmedveten frågebehandling för partitionerade tabeller och index. Detta avsnitt beskriver hur frågeprocessorn hanterar partitionerade objekt, hur man tolkar exekveringsplaner som involverar partitionering, samt bästa praxis för att förbättra frågeprestandan på partitionerade objekt.
Not
Partitionerade tabeller och index stöds i SQL Server Standard edition, med start från SQL Server 2016 (13.x) med Service Pack 1.
Ny partitionsmedveten sökåtgärd
I Database Engine ser frågeprocessorn internt en partitionerad tabell som ett flerkolumnindex med PartitionID som ledande kolumn.
PartitionID är en dold beräknad kolumn som används internt för att representera ID för partitionen som innehåller en viss rad. Till exempel, anta att tabellen T, definierad som T(a, b, c), är uppdelad på kolumnen a, och har ett klustrat index på kolumnen b. Denna partitionerade tabell behandlas som en icke-partitionerad tabell med schemat T(PartitionID, a, b, c) och ett klustrat index på den sammansatta nyckeln (PartitionID, b). Denna representation gör det möjligt för frågeoptimeraren att utföra sökoperationer baserat på PartitionID på valfri partitionerad tabell eller index.
Partitionseliminering utförs nu i denna sökoperation.
Dessutom utökas frågeoptimeraren så att en sök- eller skanningsoperation med ett villkor kan utföras på PartitionID (som den logiska ledande kolumnen) och eventuellt andra indexnyckelkolumner. Frågeprocessorn utför sedan en sökfunktion på andra nivån, med ett annat villkor, på en eller flera ytterligare kolumner, för varje distinkt värde som uppfyller kravet för sökoperationen på första nivån. Denna operation, kallad en partition skip scan, tillåter frågeoptimeraren att utföra en sök- eller skanningsåtgärd baserat på ett villkor för att avgöra vilka partitioner som ska användas, samt en indexsökningsåtgärd på andra nivån inom operatorn för att returnera rader från dessa partitioner som uppfyller ett annat villkor. Tänk till exempel på följande fråga.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
För detta exempel, anta att tabell T, definierad som T(a, b, c), är uppdelad på kolumnen a, och har ett klustrat index på kolumnen b. Följande partitionsfunktion definierar partitionsgränserna för tabellen T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
För att lösa frågan utför frågeprocessorn en sökåtgärd på första nivån för att hitta varje partition som innehåller rader som uppfyller villkoret T.a < 10. Den här åtgärden identifierar partitionerna som ska nås. Inom varje identifierad partition utför processorn sedan en sökning på andra nivån i det klustrade indexet på kolumnen b för att hitta raderna som uppfyller villkoret T.b = 2 och T.a < 10.
Följande illustration är en logisk representation av partition skip scan-operationen. Den visar tabell T med data i kolumner a och b. Partitionerna numreras 1 till 4 med de partitionsgränser som visas av streckade lodräta linjer. En sökoperation på första nivån till partitionerna (som inte visas i illustrationen) bestämmer att partitionerna 1, 2 och 3 uppfyller sökvillkoret som anges av partitioneringen som definierats för tabellen och predikatet på kolumnen a (T.a < 10). Vägen som sökningen på andra nivån passerar illustreras av den böjda linjen. I princip söker operationen i var och en av dessa partitioner efter rader som uppfyller villkoret b = 2. Den totala kostnaden för operationen är densamma som för tre separata indexsökningar.

Visa partitioneringsinformation i frågekörningsplaner
Undersök exekveringsplanerna för frågor på partitionerade tabeller och index genom att använda T-SQL-satserna SETSET SHOWPLAN_XML eller SET STATISTICS XML, eller genom att använda utdata från den grafiska exekveringsplanen i SSMS. Till exempel kan du visa exekveringsplanen för kompileringstiden genom att välja Display Estimated Execution Plan i verktygsfältet i Editor Power Query och körtidsplanen genom att välja Inkludera faktisk exekveringsplan.
Genom att använda dessa verktyg kan du hitta följande information:
- Operationer som skanningar, sökningar, insättningar, uppdateringar, sammanslagningar och raderingar som åtkommer partitionerade tabeller eller index.
- De partitioner som nås av frågan. Till exempel inkluderar exekveringsplaner vid körning det totala antalet partitioner som nås och intervallen av sammanhängande partitioner som åtkoms.
- När en partition skip scan-operation används i en sök- eller skanningsoperation för att hämta data från en eller flera partitioner.
Förbättringar av partitionsinformation
Database Engine tillhandahåller förbättrad partitioneringsinformation för körningsplaner vid kompilering och körning. Körningsplanerna innehåller nu följande information:
- Ett valfritt
Partitionedattribut som indikerar att en operator, såsom sök, skanning, infogning, uppdatering, sammanslagning eller radering, utförs på en partitionerad tabell. - Ett nytt
SeekPredicateNew-element med ettSeekKeys-underelement som innehållerPartitionIDsom den inledande indexnyckelkolumnen och filtervillkor som specificerar intervallsökningar påPartitionID. Närvaron av tvåSeekKeysdelelement indikerar en partition skip scan påPartitionID. - Sammanfattningsinformation som ger totalt antal partitioner som används. Den här informationen är endast tillgänglig i körningstidsplaner.
Om du vill visa hur den här informationen visas i både den grafiska körningsplanens utdata och XML Showplan-utdata bör du överväga följande fråga i den partitionerade tabellen fact_sales. Den här frågan uppdaterar data i två partitioner.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
Följande bild visar egenskaperna för Clustered Index Seek-operatorn i körexekveringsplanen för den här frågeställningen. För att se definitionen av fact_sales tabellen och partitionsdefinitionen, se Exempel.

Partitionerat attribut
När en operator, till exempel en indexsökning, körs i en partitionerad tabell eller ett index, visas attributet Partitioned i kompilerings- och körningsplanen och är inställt på True (1). Attributet visas inte när det är satt på False (0).
Attributet Partitioned kan visas i följande fysiska och logiska operatorer:
- Tabellgenomsökning
- Indexgenomsökning
- Indexsökning
- Infoga
- Uppdatera
- Ta bort
- Slå ihop
Som visas i föregående illustration förekommer denna attribut i egenskaperna hos operatorn där den är definierad. I XML Showplan-utdata visas detta attribut som Partitioned="1" i RelOp noden för operatorn där det är definierat.
Nytt sökpredikat
I XML Showplan-utdata visas elementet SeekPredicateNew i operatorn där det är definierat. Den kan innehålla upp till två förekomster av SeekKeys-underelementet. Det första SeekKeys objektet anger sökåtgärden på den första nivån på partitions-ID-nivån för det logiska indexet. Det vill säga, denna sökoperation bestämmer vilka partitioner som måste nås för att uppfylla villkoren för frågan. Den andra SeekKeys punkten specificerar den andra nivåns sökning som sker inom varje partition som identifierats i första nivåns sökning.
Information om partitionssammanfattning
I körningsplaner ger information om partitionssammanfattning ett antal partitioner som används och identiteten för de faktiska partitioner som används. Du kan använda den här informationen för att kontrollera att rätt partitioner används i frågan och att alla andra partitioner tas bort från övervägandet.
Följande information tillhandahålls: Actual Partition Countoch Partitions Accessed.
Actual Partition Count är det totala antalet partitioner som används av frågan.
Partitions Accessed, i XML Showplan-utdata, är den partitionssammanfattningsinformation som visas i det nya RuntimePartitionSummary elementet i RelOp noden i operatorn där den är definierad. I följande exempel visas innehållet i elementet RuntimePartitionSummary som anger att två totala partitioner används (partitionerna 2 och 3).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Visa partitionsinformation genom att använda andra showplan-metoder
Showplan-metoderna SHOWPLAN_ALL, SHOWPLAN_TEXToch STATISTICS PROFILE rapporterar inte partitionsinformationen som beskrivs i den här artikeln, med följande undantag. Som en del av SEEK predikat identifieras de partitioner som ska nås av ett intervallpredikat på den beräknade kolumnen som representerar partitions-ID:t. I följande exempel visas ett SEEK-predikat för en Clustered Index Seek-operator. Partitionerna 2 och 3 nås och sökoperatorn filtrerar på de rader som uppfyller villkoret date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Tolka körningsplaner för partitionerade heaps
En partitionerad heap behandlas som ett logiskt index på partitions-ID:t. I en exekveringsplan representeras partitionseliminering på en partitionerad heap som en Table Scan operator med ett SEEK predikat på partitions-ID. I följande exempel visas den Showplan-information som tillhandahålls:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Tolka körningsplaner för samlokala kopplingar
Kollokation av koppling kan inträffa när två tabeller partitionas med samma eller motsvarande partitioneringsfunktion och partitioneringskolumnerna på båda sidor av kopplingen anges i kopplingsvillkoret i frågan. Frågeoptimeraren kan generera en plan där partitionerna i varje tabell som har samma partitions-ID är anslutna separat. Sorterade kopplingar kan vara snabbare än icke-sorterade kopplingar eftersom de kan kräva mindre minne och bearbetningstid. Frågeoptimeraren väljer en icke-samordnad plan eller en samordnad plan baserat på kostnadsuppskattningar.
I en sammanställd plan läser Nested Loops-kopplingen en eller flera anslutna tabell- eller indexpartitioner från den inre sidan. Talen i Constant Scan-operatorerna representerar partitionsnumren.
När parallella planer för sorterade kopplingar genereras för partitionerade tabeller eller index visas en parallellitetsoperator mellan operatorerna Constant Scan och Nested Loops koppling. I det här fallet läser och arbetar flera arbetstrådar på den yttre sidan av sammanfogningen på olika partitioner.
Följande illustration visar en parallell frågeplan för en samplacerad sammanfogning.

Strategi för parallell frågekörning för partitionerade objekt
Frågeprocessorn använder en parallell körningsstrategi för frågor som väljs från partitionerade objekt. Som en del av körningsstrategin avgör frågeprocessorn de tabellpartitioner som krävs för frågan och andelen arbetstrådar som ska allokeras till varje partition. I de flesta fall allokerar frågeprocessorn lika många eller nästan lika många arbetstrådar till varje partition och kör sedan frågan parallellt mellan partitionerna. Följande stycken förklarar arbetstrådsallokering i detalj.

Om antalet arbetstrådar är mindre än antalet partitioner tilldelar frågeprocessorn varje arbetstråd till en annan partition, vilket till en början lämnar en eller flera partitioner utan en tilldelad arbetstråd. När en arbetstråd har avslutat körningen på en partition tilldelar frågeprocessorn den till nästa partition tills varje partition tilldelas en enda arbetstråd. Denna tilldelning är det enda fallet där frågeprocessorn omfördelar arbetstrådar till andra partitioner.
Visar att en arbetstråd blir omtilldelad efter att den har slutfört sitt arbete. Om antalet arbetstrådar är lika med antalet partitioner tilldelar frågeprocessorn en arbetstråd till varje partition. När en arbetstråd är klar omallokeras den inte till en annan partition.

Om antalet arbetstrådar är större än antalet partitioner allokerar frågeprocessorn lika många arbetstrådar till varje partition. Om antalet arbetstrådar inte är en exakt multipel av antalet partitioner, allokerar frågeprocessorn en extra arbetstråd till vissa partitioner för att använda alla tillgängliga arbetstrådar. Om det bara finns en partition tilldelas alla arbetstrådar till den partitionen. I följande diagram finns fyra partitioner och 14 arbetstrådar. Varje partition har tre arbetstrådar tilldelade, och två partitioner har en extra arbetstråd, totalt 14 tilldelningar av arbetstrådar. När en arbetstråd är klar tilldelas den inte till en annan partition.

Även om de tidigare exemplen antyder ett enkelt sätt att allokera arbetstrådar, är själva strategin mer komplex och tar hänsyn till andra variabler som uppstår under frågeexekveringen. Till exempel, om tabellen är partitionerad och har ett klustrat index på kolumnen A och en fråga har predikatklausulen WHERE A IN (13, 17, 25), allokerar frågeprocessorn en eller flera arbetstrådar till var och en av dessa tre sökvärden (A = 13, A = 17, och A = 25) istället för varje tabellpartition. Det är bara nödvändigt att köra frågan i de partitioner som innehåller dessa värden, och om alla dessa sökpredikat råkar finnas i samma tabellpartition, tilldelas alla arbetstrådar samma tabellpartition.
För att ta ett annat exempel, anta att tabellen har fyra partitioner på kolumnen A med randpunkter (10, 20, 30), ett index på kolumnen B, och frågan har en predikatklausul WHERE B IN (50, 100, 150). Eftersom tabellpartitionerna baseras på värdena av A, kan värdena på B förekomma i vilken av tabellpartitionerna som helst. Därför söker frågeprocessorn efter var och en av de tre värdena på B (50, 100, 150) i var och en av de fyra tabellpartitionerna. Frågeprocessorn tilldelar arbetstrådar proportionellt så att den kan köra var och en av dessa 12 frågeskanningar parallellt.
Tabellpartitioner baserade på kolumn A |
Söker kolumn B i varje tabellpartition |
|---|---|
Tabellpartition 1: A < 10 |
B = 50, B = 100, B = 150 |
Tabellpartition 2: A >= 10 AND A < 20 |
B = 50, B = 100, B = 150 |
Tabellpartition 3: A >= 20 AND A < 30 |
B = 50, B = 100, B = 150 |
Tabellpartition 4: A >= 30 |
B = 50, B = 100, B = 150 |
Metodtips
För att förbättra prestandan hos frågor som får tillgång till stora mängder data från stora partitionerade tabeller och index, följ dessa bästa praxis:
Randa varje partition över många diskar. Denna metod är särskilt relevant vid användning av roterande diskar.
När det är möjligt kan du använda en server med tillräckligt med huvudminne för att få plats med partitioner som används ofta, eller alla partitioner i minnet, för att minska I/O-kostnaden.
Om datan du frågar efter inte får plats i minnet, komprimera tabeller och index för att minska I/O-kostnaden.
Använd en server med snabba processorer och så många processorkärnor som du har råd med för att dra nytta av parallell frågebearbetning.
Kontrollera att servern har tillräckligt med I/O-styrbandbredd.
Skapa ett grupperat index i varje stor partitionerad tabell för att dra nytta av B-trädgenomsökningsoptimeringar.
När du bulkladdar data i partitionerade tabeller, följ bästa praxis-rekommendationerna i vitboken The Data Loading Performance Guide.
Exempel
I följande exempel skapas en testdatabas som innehåller en enskild tabell med sju partitioner. För att se partitioneringsinformation för både kompilerings- och körtidsplaner, använd verktygen som beskrivs i Display partitioning information in query execution plans när du kör frågorna i detta exempel.
Not
Det här exemplet infogar mer än 1 miljon rader i tabellen. Det kan ta flera minuter att köra det här exemplet beroende på maskinvaran. Innan du kör det här exemplet kontrollerar du att du har mer än 1,5 GB ledigt diskutrymme.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Relaterat innehåll
- logisk och fysisk showplansoperatorreferens
- översikt över Extended Events
- Metodtips för övervakning av arbetsbelastningar med Query Store
- kardinalitetsuppskattning (SQL Server)
- Intelligent frågebearbetning i SQL-databaser
- Operatorprioritet (Transact-SQL)
- Översikt över exekveringsplan
- Performance Center för SQL Server-databasens databas-motor och Azure SQL-databas