Profildata
Innan du rensar eller transformerar data måste du förstå vad som finns i tabellerna. Profilering av data innebär att undersöka dina datauppsättningar för att generera sammanfattningsstatistik – antal, medelvärden, värdefördelningar och nullprocent – som visar kvaliteten och strukturen på dina data. Den här grunden hjälper dig att identifiera problem som saknade värden, extremvärden och oväntade mönster innan de orsakar problem nedströms.
I den här lektionen får du lära dig hur du genererar sammanfattningsstatistik med hjälp av SQL-kommandon och funktionen för dataprofilering i Azure Databricks.
Generera sammanfattningsstatistik med SQL
Azure Databricks tillhandahåller SQL-kommandon som samlar in och visar statistik om dina tabeller. Dessa statistiker hjälper frågeoptimeraren att välja effektiva körningsplaner och ger dig insikt i datats egenskaper.
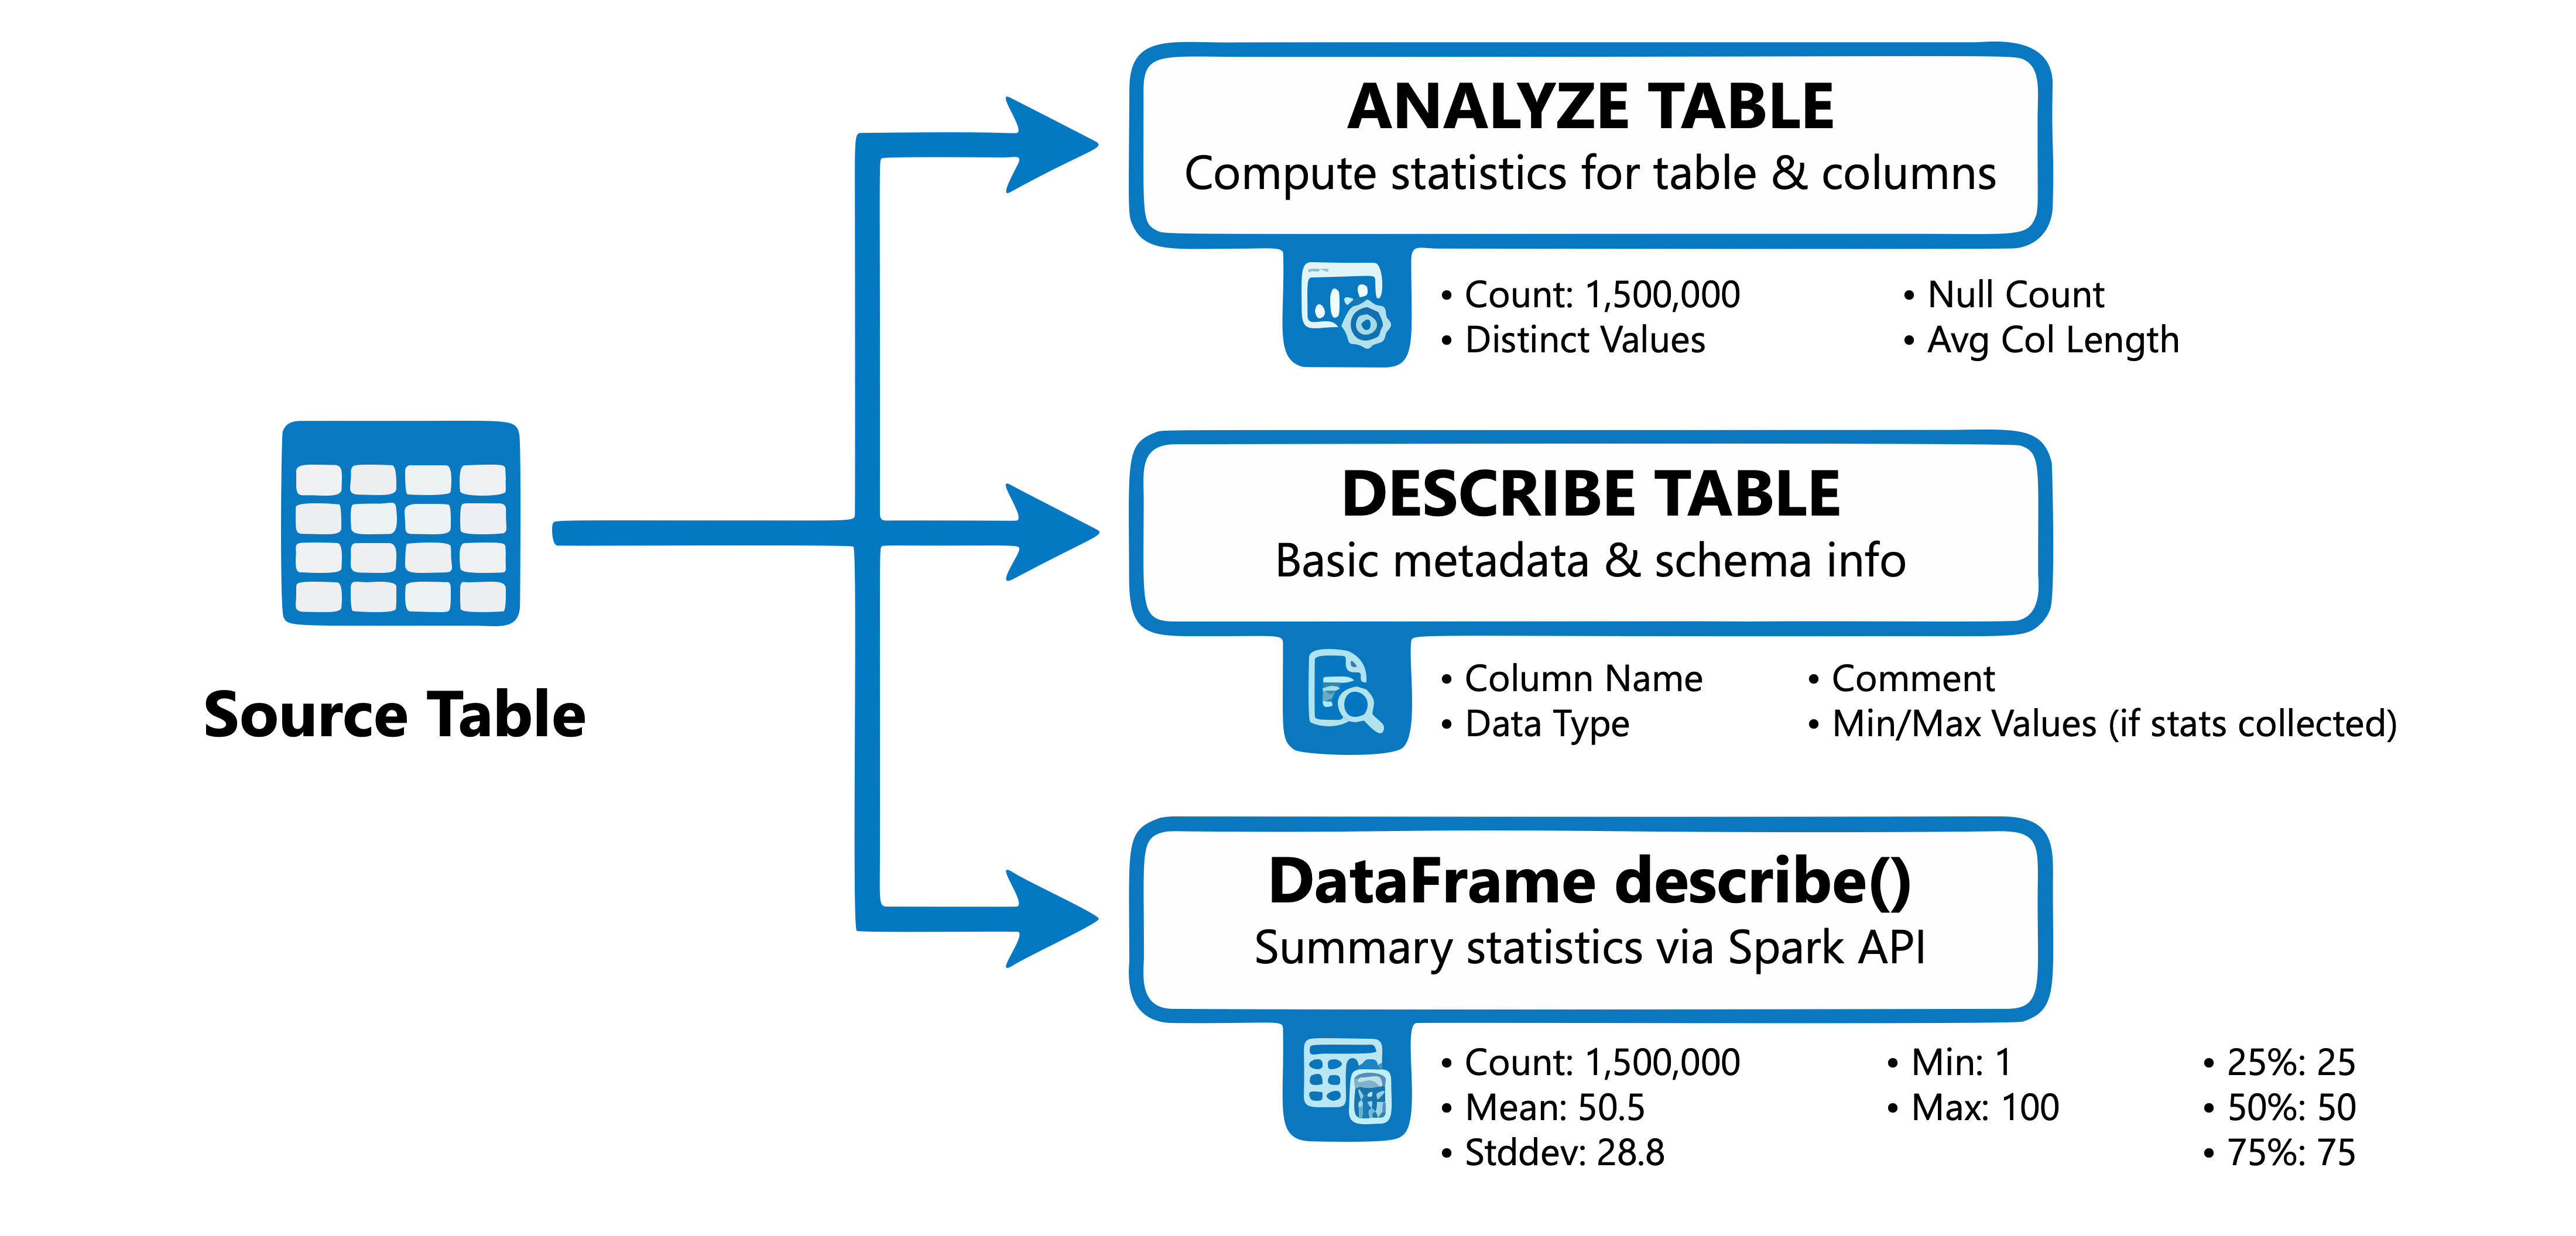
Samla in statistik med ANALYZE TABLE
Kommandot ANALYZE TABLE beräknar statistik för en tabell eller specifika kolumner. Den här statistiken omfattar radantal, mått på kolumnnivå som lägsta och högsta värden, null-antal och distinkta värdeantal.
-- Collect basic table statistics (row count and size)
ANALYZE TABLE sales.transactions COMPUTE STATISTICS;

-- Collect statistics for specific columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR COLUMNS
    transaction_id, amount, customer_id;

-- Collect statistics for all columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR ALL COLUMNS;
När du analyserar en specifik kolumn får du detaljerade mått:
-- View column-level statistics
DESC EXTENDED sales.transactions amount;
Detta returnerar mått som minsta värde, maximalt värde, antal nullvärden, distinkt antal, genomsnittlig kolumnlängd och maximal kolumnlängd.
Visa statistik med DESCRIBE TABLE
Kommandot DESCRIBE TABLE EXTENDED visar insamlad statistik tillsammans med tabellmetadata:
DESCRIBE TABLE EXTENDED sales.transactions;
Du kan också använda PySpark för att hämta tabellmetadata och generera sammanfattningsstatistik:
# Generate summary statistics for numeric columns using the DataFrame API
df = spark.table("sales.transactions")
df.describe().show()
Metoden describe() returnerar antal, medelvärde, standardavvikelse, min och max för numeriska kolumner och strängkolumner.
DESCRIBE TABLE EXTENDED-utdata innehåller en Statistics-rad som visar tabellens storlek i byte och, när du har kört ANALYZE TABLE ... COMPUTE STATISTICS, radantalet. För hanterade tabeller i Unity Catalog körs ANALYZE förutsägelseoptimering automatiskt för att hålla statistiken aktuell.
Tips/Råd
Kör ANALYZE TABLE efter massdatainläsningar eller betydande ändringar för att säkerställa att frågeoptimeraren har korrekt statistik för att planera effektiva frågor.
Använda dataprofilering i Unity Catalog
Utöver SQL-kommandon tillhandahåller Azure Databricks övervakning av datakvalitet i Unity Catalog – ett paraply som omfattar två olika funktioner:
- Avvikelseidentifiering (offentlig förhandsversion) övervakar alla tabeller i schemat automatiskt. Den analyserar historiska mönster för att utvärdera varje tabells färskhet (hur nyligen den uppdaterades) och fullständighet (om det förväntade antalet rader kom). Du aktiverar den en gång på schemanivå i Katalogutforskaren och Azure Databricks avgör hur ofta varje tabell ska genomsökas. Använd avvikelseidentifiering för bred, automatiserad täckning i alla dina tabeller utan konfiguration per tabell.
- Dataprofilering ger djup statistisk analys per tabell – spårning av distributioner, nullprocent, driftmått och modellprestanda över tid. Du konfigurerar den individuellt för varje tabell. Använd dataprofilering för dina mest kritiska tabeller där du behöver detaljerade historiska trender.
För datateknikarbete som fokuserar på rensning och kvalitet använder du båda: avvikelsedetektering som ett system för tidig varning i alla tabeller och dataprofilering för djupgående övervakning av nyckeltabeller.

Förstå profiltyper
Dataprofilering stöder tre analystyper som var och en passar olika scenarier:
| Profiltyp | Användningsfall | Viktiga egenskaper |
|---|---|---|
| Snapshot | Allmänna tabeller | Beräknar mått över hela tabellen med varje uppdatering |
| Tidsserier | Tabeller med tidsstämpelkolumner | Spårar mått över tidsfönster för att identifiera trender |
| Slutledning | ML-modellinferensstabeller | Övervakar modellindata, förutsägelser och noggrannhet över tid |
För datateknikuppgifter som fokuserar på datakvalitet är profilerna för ögonblicksbilder och tidsserier mest relevanta.
Skapa en profil med hjälp av användargränssnittet
Så här skapar du en profil i Katalogutforskaren:
- Gå till tabellen i Katalogutforskaren.
- Välj fliken Kvalitet .
- Om avvikelseidentifiering inte är aktiverad för schemat, välj Aktivera. Om avvikelseidentifiering redan är aktiverat väljer du Konfigurera.
- I dialogrutan Datakvalitetsövervakning går du till fältet Dataprofilering och väljer Konfigurera.
- Välj din profiltyp och konfigurera alternativ som kornighet och schemaläggning.
Profilen genererar en tabell med profilmått med sammanfattningsstatistik och en tabell med mått för drift som spårar distributionsändringar över tid. Azure Databricks fyller i tabellen för avdriftsmått när en baslinjetabell eller ett sammanhängande tidsfönster är tillgängligt.
Skapa en profil med hjälp av API:et
För programmatisk åtkomst använder du Databricks SDK. Installera eller uppgradera SDK:n för att hämta det aktuella API:et:
%pip install "databricks-sdk>=0.68.0"
Skapa sedan en ögonblicksbildsprofil för en tabell:
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.dataquality import Monitor, DataProfilingConfig, SnapshotConfig

w = WorkspaceClient()

# Retrieve the table ID and schema ID required by the API
table = w.tables.get(full_name="main.sales.transactions")
schema = w.schemas.get(full_name="main.sales")

w.data_quality.create_monitor(
    monitor=Monitor(
        object_type="table",
        object_id=table.table_id,
        data_profiling_config=DataProfilingConfig(
            output_schema_id=schema.schema_id,
            assets_dir="/Workspace/Users/user@example.com/monitoring",
            snapshot=SnapshotConfig()
        )
    )
)
Så här uppdaterar du profilen och uppdaterar måtten:
from databricks.sdk.service.dataquality import Refresh

w.data_quality.create_refresh(
    object_type="table",
    object_id=table.table_id,
    refresh=Refresh(object_type="table", object_id=table.table_id)
)
Tolka profileringsresultat
Profilering genererar mått som hjälper dig att utvärdera datakvaliteten och identifiera problem som kräver uppmärksamhet.
Viktiga mått att undersöka
Tabellen profilmått innehåller statistik för varje kolumn:
| Mätvärde | Vad det avslöjar |
|---|---|
count och num_nulls |
Data fullständighet – höga nullprocentvärden kan tyda på problem med inmatning |
distinct_count |
Kardinalitet – oväntade värden kan tyda på datakvalitetsproblem |
min, max, , avgstddev |
Distributionsegenskaper – extremvärden eller skeva fördelningar |
frequent_items |
De vanligaste värdena – hjälper till att identifiera dominerande kategorier eller dubbletter |
quantiles |
Värdefördelning – användbart för att identifiera skevhet |
Identifiera problem med datakvalitet
När du undersöker profileringsresultat letar du efter följande vanliga indikatorer:
- Höga nullprocentvärden i kolumner som ska ha värden
- Oväntade distinkta antal, till exempel unika identifierare som inte är unika
- Värdeintervall utanför förväntade gränser, till exempel negativa belopp där endast positiva värden är giltiga
- Distributionsändringar över tid, vilket kan tyda på dataavvikelse
Tabellen driftmått beräknar statistiska tester som Kolmogorov-Smirnov (KS) för numeriska kolumner och chi-squared-test för kategoriska kolumner. Dessa tester kvantifierar hur mycket distributioner som har ändrats.
Genom att förstå dessa mönster kan du utforma lämpliga regler för rensning och validering för dina datapipelines.