Välj ett datainmatningsverktyg
Tips/Råd
Mer information finns på fliken Text och bilder !
När du utformar datapipelines i Azure Databricks påverkar valet av rätt inmatningsverktyg direkt tillförlitligheten, underhållsinsatsen och de långsiktiga kostnaderna. Varje verktyg hanterar olika scenarier, datakällor och driftskrav. Genom att förstå dessa skillnader kan du fatta välgrundade beslut som överensstämmer med organisationens behov.
Förstå landskapet av inmatningsverktyg
Azure Databricks tillhandahåller flera inmatningsalternativ som sträcker sig över ett spektrum från fullständigt hanterade tjänster till mycket anpassningsbara ramverk. Vilka verktyg du väljer beror på faktorer som datakällans typ, svarstidskrav och hur mycket kontroll du behöver över inmatningsprocessen.

På den mest hanterade änden erbjuder Lakeflow Connect nyckelfärdiga anslutningslösningar för företagsapplikationer och databaser. Dessa anslutningsappar hanterar autentisering, ändringsspårning, felåterställning och schemautveckling automatiskt. I den anpassningsbara änden ger Spark Structured Streaming fullständig kontroll över hur data flödar genom din pipeline, även om det kräver mer utveckling och underhåll.
Mellan dessa extremiteter hittar du verktyg som Automatisk inläsning för molnlagringsfiler, KOPIERA TILL för SQL-baserad batchinläsning och notebook-baserade metoder med JDBC/ODBC-anslutningar . Dessutom fungerar Azure Data Factory som ett orkestreringslager som kan samordna dataflytt till Azure Databricks från det bredare Azure-ekosystemet.
Lakeflow Connect
Lakeflow Connect representerar den moderna metoden för datainmatning i Azure Databricks. Den erbjuder både fullständigt hanterade anslutningar och standardanslutningar som integreras med Lakeflow-pipelines för en smidig upplevelse.
Hanterade kontakter är indelade i tre typer:
SaaS-anslutningsappar tillhandahåller färdiga integreringar med företagsprogram som Salesforce, ServiceNow, SharePoint, HubSpot, Jira, Microsoft Dynamics 365, Workday, Zendesk och många andra. Dessa anslutningsappar hanterar källspecifik autentisering, inkrementella läsningar, API-hastighetsbegränsning, schemautveckling och automatiserade återförsök. De körs på serverlös beräkning och skriver till strömmande tabeller som styrs av Unity Catalog.
Databaskopplingar hämtar data från relationsdatabaser, inklusive MySQL, PostgreSQL och SQL Server, med hjälp av förändringslagring (CDC). Eftersom CDC-baserade kopplingar läser från databastransaktionsloggar i stället för att köra frågor mot tabeller direkt, kräver de en inmatningsgateway som distribueras i ditt nätverk och en buffertlagringsvolym för att buffra insamlade ändringar.
Community-anslutningsappar är anslutningsappar med öppen källkod som skapats och underhålls av communityn. De utökar Lakeflow Connect till källor som ännu inte har en hanterad konnektor. Du kan använda en befintlig community-koppling eller bidra med din egen.
Anmärkning
Kontaktors ekosystem växer snabbt. Se dokumentationen för hanterade kontakter för en fullständig aktuell lista över stödjda källor.
Standardanslutningar utökar Lakeflow Connect till molnobjektlagring och meddelandebussar. Du kan mata in data från Amazon S3, Azure Data Lake Storage eller Google Cloud Storage med automatisk inläsning. För realtidsdata stöder standardanslutningsprogram Apache Kafka, Google Pub/Sub och Apache Pulsar.

Överväg Lakeflow Connect när du behöver tillförlitlig, låg underhållsinmatning från källor som stöds. De hanterade anslutningarna minskar avsevärt utvecklingstiden och det pågående underhållet jämfört med anpassade lösningar. Men om din datakälla inte stöds eller om du behöver mycket specialiserad inmatningslogik kan du behöva utforska andra alternativ.
Lakeflow Connect stöder både schemalagd inmatning (varje timme, varje dag, varje vecka) och utlösare på begäran , vilket gör det lämpligt för regelbundna datauppdateringscykler och ad hoc-inläsningsscenarier.
Frågebaserade kontakter
Frågebaserade anslutningar är ett lättviktsalternativ till CDC-databasanslutningar för att schemalägga inmatning från relationsdatabaser. I stället för att läsa transaktionsloggar frågar de källtabellen direkt med hjälp av en markörkolumn – en monotont ökande tidsstämpel eller heltal som spårar vilka rader som är nya eller uppdaterade sedan den senaste pipelinekörningen.
Eftersom de frågar källan direkt kräver frågebaserade anslutningsappar inte någon inmatningsgateway eller mellanlagring. Vid varje schemalagd körning hämtar anslutningsappen alla rader med ett markörkolumnvärde som är större än högvattenmärket från föregående körning och skriver sedan resultat till strömmande tabeller i Unity Catalog.
Källor som stöds är Oracle, Teradata, SQL Server, MySQL, MariaDB, PostgreSQL och alla Lakehouse Federation-datakällor.
Frågebaserade anslutningsappar stöder tre historikspårningslägen för måltabeller:
- SCD-typ 1: Skriver över den befintliga raden med den senaste källraden. Ingen historik bevaras.
- SCD-typ 2: Bevarar den fullständiga historiken genom att lägga till nya rader med versionsmetadata.
- Endast tillägg: Lägger till varje inmatad rad utan sammanslagning eller överskrivning.
Välj frågebaserade kopplingar istället för CDC-databasanslutningar när CDC- eller binloginfrastrukturen inte är tillgänglig, men det finns en tillförlitlig markörkolumn i källan. Välj CDC-anslutningskomponenter när du behöver varje mellanliggande radens tillstånd mellan pipelinekörningar eller när spårning av mjuk borttagning är kritisk. Kompromissen är att frågebaserade anslutningsappar lägger mer belastning direkt på källtabeller jämfört med CDC-anslutningsappar, som läser från binlog.
Automatisk Laddare
Automatisk inläsning (Auto Loader) ger sekventiell filbearbetning för data som anländer till molnbaserad lagring. I stället för att söka igenom hela kataloger för att hitta nya filer spårar Auto Loader effektivt vilka filer som har bearbetats och matar in endast nya ankomster.
Automatisk inläsning fungerar genom att upprätthålla tillståndet på en kontrollpunkt som spårar bearbetade filer. När nya filer hamnar i molnlagringen identifierar Auto Loader dem via kataloglistan eller filmeddelandeläget. Kataloglistan söker regelbundet efter nya filer, medan filmeddelandeläget använder molnbaserade händelser för omedelbar identifiering.

Viktiga funktioner hos Auto Loader inkluderar:
- Schemainferens och utveckling: Identifierar automatiskt schemat för inkommande filer och hanterar schemaändringar korrekt.
- Bearbetning exakt en gång: Garanterar att varje fil bearbetas en gång, även över fel och omstarter.
- Skalbarhet: Hanterar effektivt miljarder filer för återfyllnad eller migreringar.
- Formatstöd: Bearbetar JSON, CSV, Parquet, Avro, ORC, XML, text och binära filer.
Automatisk inläsning passar scenarier där data tas emot som filer i molnlagring – vanliga mönster är loggfiler, exporter från överordnade system och datalandningszoner. Du kan använda Auto Loader med Lakeflow-pipelines för en hanterad upplevelse eller med Structured Streaming för mer kontroll.
KOPIERA TILL
SQL-kommandot COPY INTO läser in data från molnlagring i Delta-tabeller. Till skillnad från Auto Loader, som körs kontinuerligt som en ström, COPY INTO körs som en batchåtgärd som du schemalägger eller utlöser manuellt.
COPY INTO spårar vilka filer som den redan har bearbetat, vilket gör åtgärden idempotent. Om du kör samma kommando flera gånger dupliceras inte data eftersom tidigare inlästa filer hoppar över. Den här egenskapen är COPY INTO användbar för schemalagda batchjobb där du vill ha förutsägbart, repeterbart beteende.
Anmärkning
Spårningsmetadata lagras som en del av Delta-tabellens transaktionslogg ( _delta_log katalogen)

Vanliga scenarier för COPY INTO inkluderar engångsdatamigreringar, schemalagda batchinläsningar från landningszoner och SQL-första arbetsflöden där du föredrar deklarativ syntax framför strömmande API:er.
Välj COPY INTO över Automatisk inläsning när du utför en engångs batchbelastning av en stor datauppsättning.
COPY INTO tillhandahåller en enklare konfigurationsmodell utan att kräva direktuppspelningsinfrastruktur, vilket gör den idealisk för att läsa in hundratals gigabyte eller terabyte data i en enda åtgärd. Auto Loaders kontinuerliga bearbetningsmodell och hanteringen av kontrollpunkter ger onödig komplexitet när du bara behöver läsa in data en gång.
Men för pågående inkrementell inmatning i stor skala ger Auto Loader bättre prestanda och mer robust filidentifiering.
Spark Structured Streaming (strukturerad strömning i Spark)
Spark Structured Streaming utgör grunden för databearbetning i realtid i Azure Databricks. Det möjliggör kontinuerlig inmatning från olika strömningskällor med garanti för bearbetning exakt en gång.
Bland de strömmande källor som stöds finns:
- Apache Kafka och Azure Event Hubs: För händelsedrivna arkitekturer och bearbetning av meddelandeköer.
- Delta Lake-ändringsflöden: För spridning av ändringar mellan Delta-tabeller.
- Molnlagring via Auto Loader: För filbaserad strömningsinmatning.
- Socket och anpassade källor: För specialiserade inmatningsscenarier.
Välj Strukturerad direktuppspelning när du behöver detaljerad kontroll över strömningsbeteende, anpassad vattenstämpel eller fönsterlogik eller när du arbetar med källor som inte stöds av abstraktioner på högre nivå.
JDBC- och ODBC-anslutningar
Notebook-baserad inmatning med JDBC eller ODBC är fortfarande en praktisk metod för att extrahera data från relationsdatabaser. Du skriver kod som ansluter direkt till källdatabaser, kör frågor och läser in resultat i Delta-tabeller.
Den här metoden stöder praktiskt taget alla databaser med en JDBC- eller ODBC-drivrutin: SQL Server, Oracle, PostgreSQL, MySQL och många andra. Du implementerar fullständig eller inkrementell belastning genom att skriva lämpliga frågor, ofta med hjälp av vattenstämpelkolumner för att spåra extraheringsförloppet.
Även om hanterade anslutningar i Lakeflow Connect ersätter JDBC/ODBC i många scenarier, är notebook-baserade anslutningar fortfarande värdefulla när:
- Din databas stöds inte av anslutningar hanterade av Lakeflow Connect.
- Du behöver anpassad extraheringslogik som hanterbara kopplingar inte kan tillgodose.
- Du underhåller befintliga pipelines som använder det här mönstret.
- Du behöver specifika optimeringar av pushdown-frågor för stora tabeller.
När du använder JDBC/ODBC lagrar du autentiseringsuppgifter på ett säkert sätt med Databricks-hemligheter i stället för att hårdkoda dem i notebook-filer. Överväg prestandapåverkan på källsystem och implementera lämplig begränsning eller schemaläggning för att undvika överväldigande transaktionsdatabaser.
För lokala databaser krävs ytterligare nätverksinfrastruktur – antingen Azure ExpressRoute/VPN för direkt JDBC-anslutning från Databricks eller Azure Data Factory med en Self-Hosted Integration Runtime för att först landa data i molnlagring.
Azure Data Factory
Azure Data Factory (ADF) fungerar som en orkestrerings- och dataförflyttningsplattform i Azure-ekosystemet. Den utmärker sig genom att samordna arbetsflöden som omfattar flera tjänster och landningsdata från olika källor till molnlagring där Azure Databricks kan bearbeta dem.
ADF integreras mycket med Microsoft-tjänster som Dynamics 365, Azure SQL Database och Microsoft Fabric. När dina data kommer från dessa källor ger ADF enkel anslutning och kan landa data i Azure Data Lake Storage för efterföljande Databricks-bearbetning.
Det är viktigt att förstå ADF:s lämpliga roll. Använd ADF för:
- Orkestrering: Samordna arbetsflöden som omfattar flera Azure-tjänster.
- Inledande datalandning: Flytta data från Azure-källor till molnlagring.
- Företagsintegrering: När företagspolicyn ger ADF mandat för dataflytt.

Undvik att använda ADF för ETL-kärntransformeringar i Databricks. Att köra transformeringar via ADF-aktiviteter medför onödig komplexitet och presterar mindre effektivt än databricks-intern bearbetning. Låt ADF hantera dataflytt till lakehouse och använd sedan Azure Databricks-verktyg för omvandlingslogik.
Tillämpa ett beslutsramverk
När du väljer ett inmatningsverktyg blir det tydligare när du utvärderar ditt scenario mot viktiga beslutskriterier.
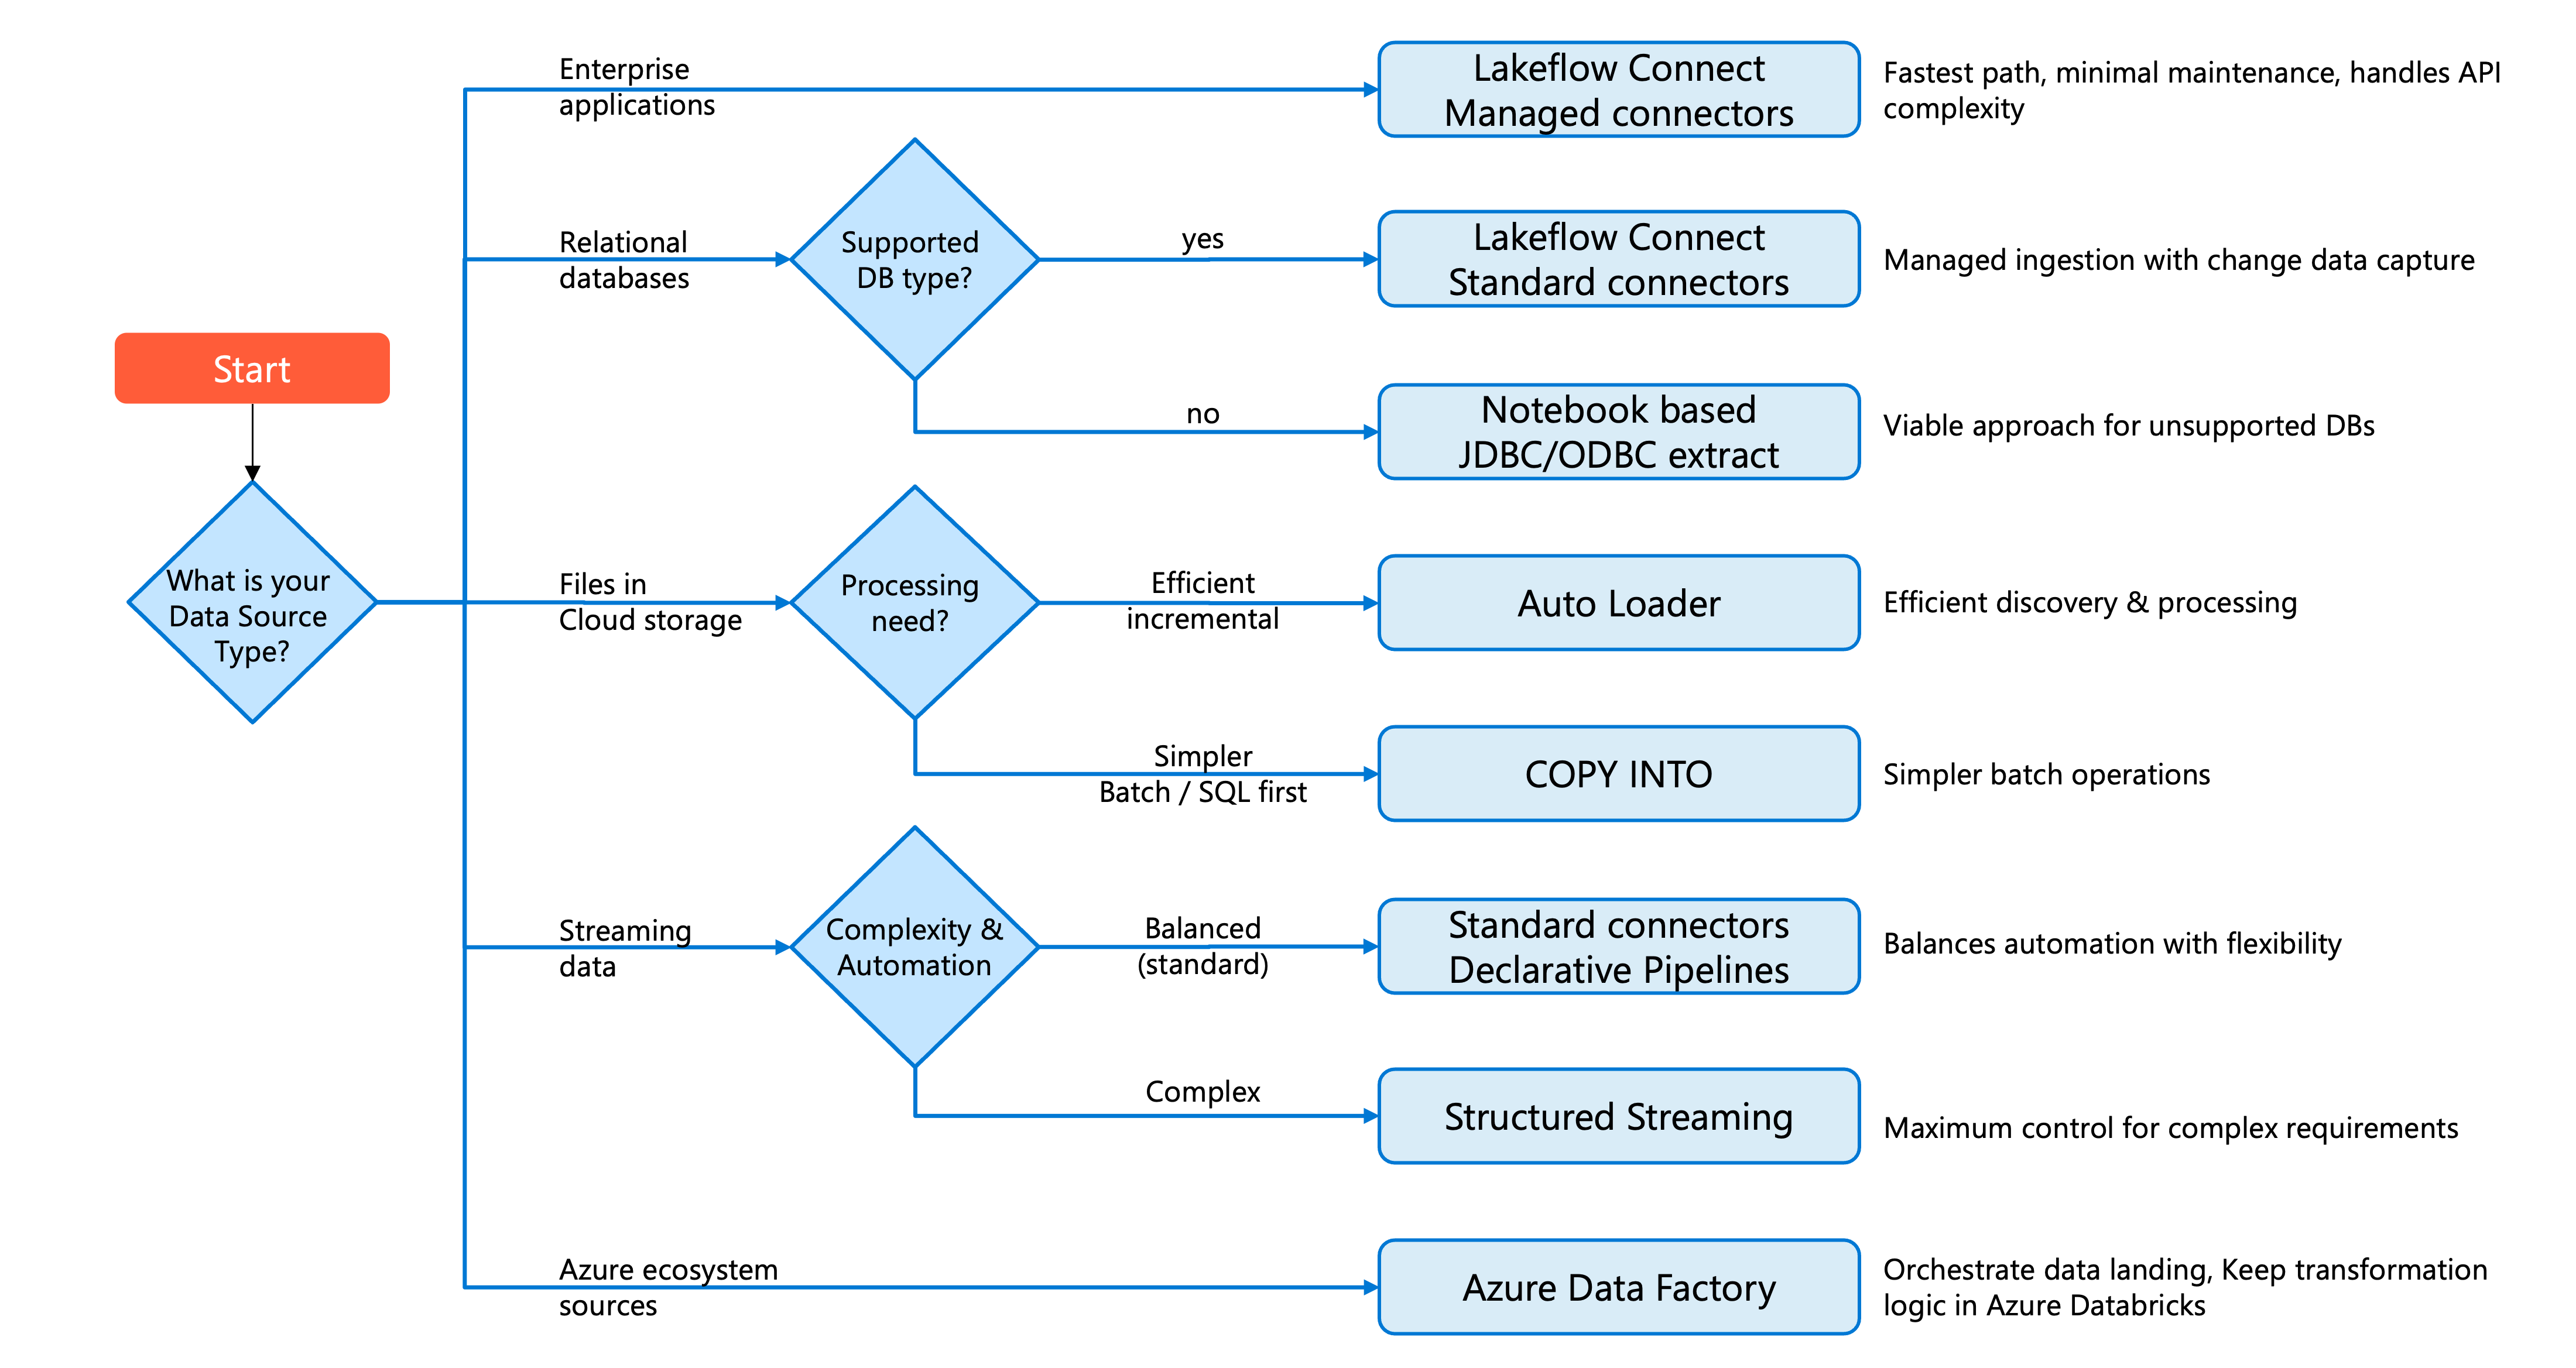
Börja med att identifiera datakällans typ och överväg sedan driftkrav och organisationskontext.
För företagsprogram (Salesforce, ServiceNow, SharePoint) erbjuder Lakeflow Connect-hanterade anslutningar det snabbaste sättet till produktion med minimalt underhåll. Dessa anslutningsappar hanterar komplexiteten i API-integrering, hastighetsbegränsning och ändringsspårning.
För relationsdatabaser med typer som stöds erbjuder Lakeflow Connect två hanterade sökvägar: databasanslutningar (CDC-baserade, kräver gateway) för kontinuerlig ändringsinsamling och frågebaserade anslutningsappar för enklare schemalagd inmatning med hjälp av en markörkolumn. För databaser som inte stöds är notebook-baserad JDBC/ODBC-extrahering fortfarande en användbar metod.
För filer i molnlagring ger Auto Loader effektiv inkrementell identifiering och bearbetning. Använd COPY INTO för enklare batchscenarier eller när du föredrar SQL-första arbetsflöden.
För strömmande data från meddelandebussar (Kafka, Event Hubs, Pub/Sub) balanserar standardanslutningar med Lakeflow-pipelines automatisering och flexibilitet. För komplexa strömningskrav erbjuder Structured Streaming maximal kontroll.
För Azure-ekosystemkällor som kräver samordning med andra tjänster kan Azure Data Factory samordna datalandning i ditt lakehouse. Behåll transformeringslogik i Azure Databricks i stället för I ADF-dataflöden.
Tips/Råd
Börja med det mest hanterade alternativet som uppfyller dina krav. Hanterade kontakter minskar utvecklingstiden och underhållsbördan. Flytta bara till mer anpassningsbara metoder när specifika krav inte kan uppfyllas av abstraktioner på högre nivå.
Ditt val beror också på teamkunskaper och organisationsstandarder. Dokumentera dina beslut och resonemanget bakom dem för att hjälpa framtida teammedlemmar att förstå pipelinearkitekturen.