หมายเหตุ
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลอง ลงชื่อเข้าใช้หรือเปลี่ยนไดเรกทอรีได้
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลองเปลี่ยนไดเรกทอรีได้
Fabric Runtime มอบการผสานรวมอย่างไร้รอยต่อในระบบนิเวศ Fabric มอบสภาพแวดล้อมที่แข็งแกร่งสําหรับโครงการวิศวกรรมข้อมูลและวิทยาศาสตร์ข้อมูลที่ขับเคลื่อนด้วย Apache Spark
บทความนี้แนะนํา Fabric Runtime 2.0 ซึ่งเป็นเวอร์ชันล่าสุดที่มีให้ใช้งานทั่วไป (GA) และเป็นรันไทม์เริ่มต้นใน Microsoft Fabric Runtime 2.0 เป็นตัวเลือกเริ่มต้นสําหรับพื้นที่ทํางานและรายการสภาพแวดล้อมใหม่ มีฟีเจอร์และส่วนประกอบสําหรับการวิเคราะห์ที่ขยายได้และงานขั้นสูง
Fabric Runtime 2.0 รวมส่วนประกอบและการอัปเกรดต่อไปนี้ที่ออกแบบมาเพื่อปรับปรุงความสามารถในการประมวลผลข้อมูลของคุณ:
- อาปาเช่ สปาร์ค 4.1
- ระบบปฏิบัติการ: Azure Linux 3.0 (Mariner 3.0)
- ชวา: 21
- สกาล่า: 2.13
- Python: 3.13
- ทะเลสาบเดลต้า: 4.2
- อาร์: 4.5.2
สําคัญ
ช่องทางการปล่อยเวอร์ชัน Fabric runtime ช่วยให้คุณทดสอบการเปลี่ยนแปลง runtime ที่จะเกิดขึ้นได้ตั้งแต่เนิ่น ๆ และตรวจสอบความเข้าได้ของงานก่อนที่การอัปเดตจะกลายเป็นค่าเริ่มต้น แนวทางนี้ช่วยลดความหยุดชะงักที่ไม่คาดคิดในการผลิตและให้การควบคุมที่ดีขึ้นในการอัปเกรดขณะรันไทม์ เรียนรู้เพิ่มเติมเกี่ยวกับช่องทางการปล่อย
เคล็ดลับ
Fabric Runtime 2.0 รองรับ Native Execution Engine ซึ่งสามารถเพิ่มประสิทธิภาพได้อย่างมีนัยสําคัญโดยไม่มีค่าใช้จ่ายเพิ่มเติม คุณสามารถเปิดใช้งานกลไกการดําเนินการดั้งเดิมในระดับสภาพแวดล้อม เพื่อให้งานและสมุดบันทึกทั้งหมดสืบทอดความสามารถด้านประสิทธิภาพที่ได้รับการปรับปรุงโดยอัตโนมัติ
เปิดใช้งานรันไทม์ 2.0
พื้นที่ทํางานใหม่และรายการสภาพแวดล้อมจะใช้ Runtime 2.0 เป็นค่าเริ่มต้น หากพื้นที่ทํางานหรือสภาพแวดล้อมของคุณใช้ runtime ก่อนหน้า ให้ทําตามขั้นตอนเหล่านี้เพื่อเลือก Runtime 2.0 หลังจากตรวจสอบความเข้าได้ของงานแล้ว การเลือกขณะรันไทม์ของรายการสภาพแวดล้อมจะมีผลเหนือค่าเริ่มต้นของพื้นที่ทํางานสําหรับโน้ตบุ๊กและนิยามงาน Spark ที่แนบกับสภาพแวดล้อมนั้น
เปิดใช้งานรันไทม์ 2.0 ในการตั้งค่าพื้นที่ทํางาน
เมื่อต้องการตั้งค่ารันไทม์ 2.0 เป็นค่าเริ่มต้นสําหรับพื้นที่ทํางานทั้งหมดของคุณ:
นําทางไปยังหน้า การตั้งค่าพื้นที่ทํางาน ภายในพื้นที่ทํางาน Fabric ของคุณ
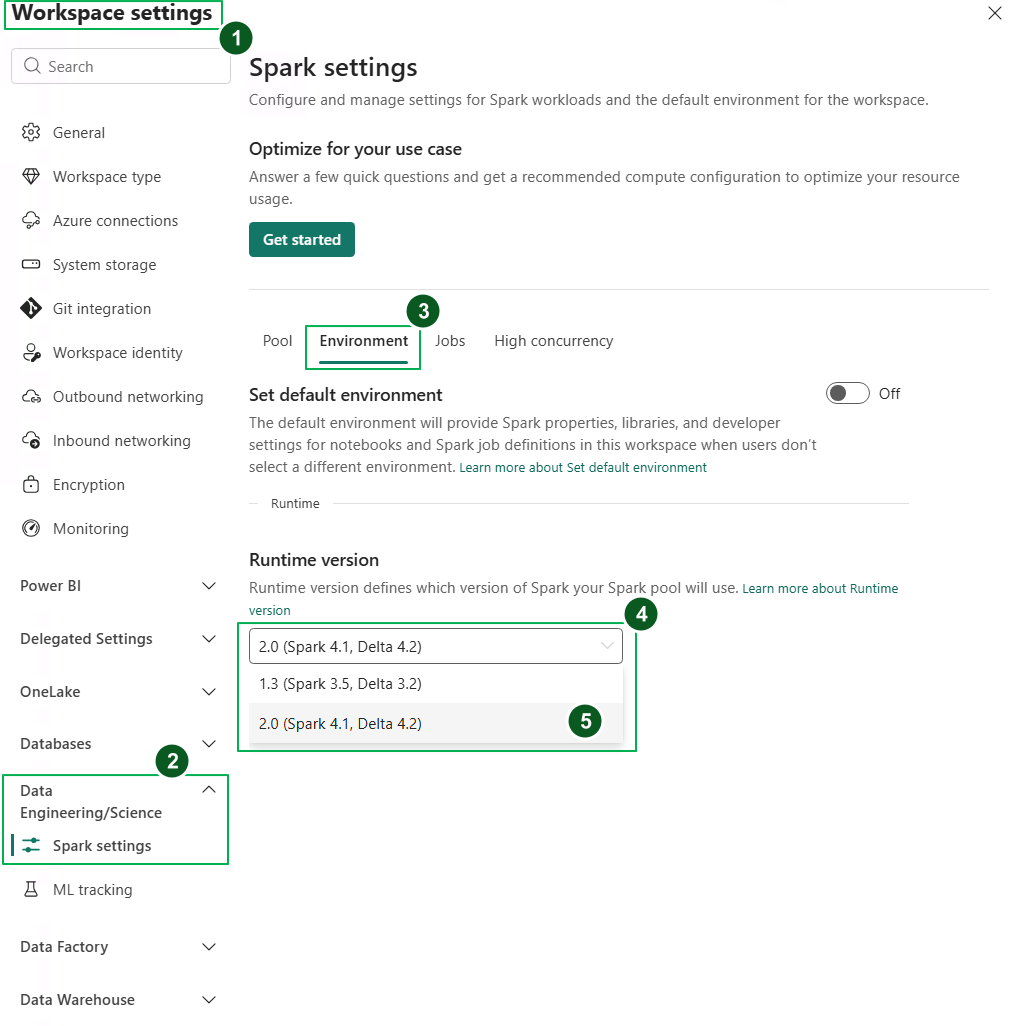
เลือกแท็บ วิศวกรรมข้อมูล/วิทยาศาสตร์ แล้วเลือก การตั้งค่า Spark
เลือกแท็บ สภาพแวดล้อม
ภายใต้เมนูแบบเลื่อนลงเวอร์ชัน รันไทม์ ให้เลือก 2.0 (Spark 4.1, Delta 4.2) และบันทึกการเปลี่ยนแปลงของคุณ
รันไทม์ 2.0 ถูกตั้งค่าเป็นรันไทม์เริ่มต้นสําหรับพื้นที่ทํางานของคุณ
เปิดใช้งานรันไทม์ 2.0 ในรายการสภาพแวดล้อม
หากต้องการใช้ Runtime 2.0 กับสมุดบันทึกเฉพาะหรือข้อกําหนดงาน Spark:
สร้างรายการสภาพแวดล้อมใหม่หรือเปิดรายการที่มีอยู่
ภายใต้เมนูแบบเลื่อนลง Runtime ให้เลือก 2.0 (Spark 4.1, Delta 4.2),บันทึก และ เผยแพร่ การเปลี่ยนแปลงของคุณ
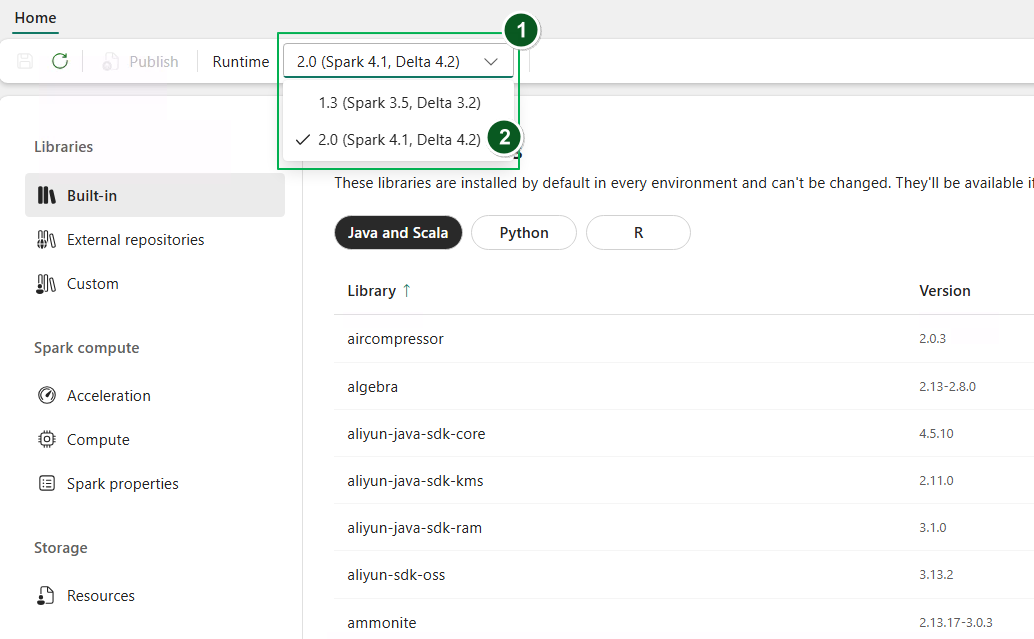
ถัดไป ใช้รายการ Environment นี้กับ Notebook หรือ Spark Job Definition ของคุณ
ตอนนี้คุณสามารถเริ่มใช้งานกับการปรับปรุงและฟังก์ชันใหม่ล่าสุดที่เพิ่มเข้ามาใน Fabric Runtime 2.0 (Spark 4.1 และ Delta Lake 4.2) ได้แล้ว
Note
ก่อนเปลี่ยนพื้นที่ทํางานหรือสภาพแวดล้อมที่มีอยู่เป็น Runtime 2.0 ให้ตรวจสอบไลบรารี การตั้งค่า Spark และปริมาณงานของคุณ สําหรับข้อพิจารณาด้านความเข้ากันได้และกระบวนการย้ายข้อมูลแบบเป็นขั้นตอน ดูที่ ย้ายจาก Runtime 1.3 ไปยัง Runtime 2.0
เคล็ดลับ
สําหรับข้อมูลล่าสุด รายการการเปลี่ยนแปลงโดยละเอียด และบันทึกย่อประจํารุ่นเฉพาะสําหรับ Fabric runtimes ตรวจสอบและสมัครใช้งาน การเผยแพร่และการอัปเดต Spark Runtimes
จุดเด่นหลัก
การปรับปรุงกลไกประสิทธิภาพและการดําเนินการ
Fabric Runtime 2.0 มี Native Execution Engine ซึ่งให้การปรับปรุงประสิทธิภาพที่สําคัญเหนือ Spark แบบโอเพนซอร์ส กลไกจัดการใช้การประมวลผลแบบเวกเตอร์เพื่อเร่งการสืบค้น Spark บนโครงสร้างพื้นฐานเลคเฮาส์โดยไม่ต้องเปลี่ยนโค้ด
คุณสมบัติด้านประสิทธิภาพที่สําคัญใน Runtime 2.0:
- เร็วขึ้นสูงสุดหกเท่า: เกณฑ์มาตรฐานแสดงประสิทธิภาพที่เร็วขึ้นถึงหกเท่าเมื่อเทียบกับ Spark แบบโอเพนซอร์สในปริมาณงาน TPC-DS
- การแยกวิเคราะห์ CSV แบบเวกเตอร์: เอ็นจิ้นการดําเนินการแบบเนทีฟประกอบด้วยตัวแยกวิเคราะห์ CSV แบบเวกเตอร์ที่เร่งการนําเข้า CSV และปริมาณงานการสืบค้น มีการวางแผนการแยกวิเคราะห์ JSON แบบเวกเตอร์และการรองรับการสตรีมที่มีโครงสร้างของ Spark สําหรับการอัปเดตในอนาคต
หากต้องการเปิดใช้งานกลไกการดําเนินการแบบเนทีฟ โปรดดู กลไกการดําเนินการแบบเนทีฟสําหรับวิศวกรรมข้อมูล Fabric
อาปาเช่ สปาร์ค 4.1
Apache Spark 4.0 ถือเป็นก้าวสําคัญในการเปิดตัวครั้งแรกในซีรีส์ 4.x ซึ่งรวบรวมความพยายามร่วมกันของชุมชนโอเพ่นซอร์สที่มีชีวิตชีวา Fabric Runtime 2.0 ทํางานบน Apache Spark 4.1 ซึ่งสร้างขึ้นบนรากฐานนั้นพร้อมการปรับปรุงเพิ่มเติม
ในเวอร์ชันนี้ Spark SQL ได้รับการเสริมสร้างอย่างมีนัยสําคัญด้วยคุณสมบัติใหม่ที่ทรงพลังซึ่งออกแบบมาเพื่อเพิ่มการแสดงออกและความเก่งกาจสําหรับปริมาณงาน SQL เช่น การสนับสนุนประเภทข้อมูล VARIANT, ฟังก์ชันที่ผู้ใช้กําหนดโดย SQL, ตัวแปรเซสชัน, ไวยากรณ์ไปป์ และการเปรียบเทียบสตริง PySpark เห็นความทุ่มเทอย่างต่อเนื่องทั้งในด้านการทํางานและประสบการณ์โดยรวมของนักพัฒนา โดยนํา API การพล็อตดั้งเดิม API แหล่งข้อมูล Python ใหม่ รองรับ Python UDTF และการสร้างโปรไฟล์แบบรวมสําหรับ PySpark UDF ควบคู่ไปกับการปรับปรุงอื่นๆ อีกมากมาย การสตรีมแบบมีโครงสร้างพัฒนาขึ้นด้วยการเพิ่มคีย์ที่ให้การควบคุมที่ดีขึ้นและง่ายต่อการดีบัก โดยเฉพาะอย่างยิ่งการแนะนํา Arbitrary State API v2 เพื่อการจัดการสถานะที่ยืดหยุ่นยิ่งขึ้น และแหล่งข้อมูลของรัฐเพื่อการดีบักที่ง่ายขึ้น
คุณสามารถตรวจสอบรายการทั้งหมดและการเปลี่ยนแปลงโดยละเอียดได้ที่นี่:
Note
ใน Spark 4.x SparkR ถูกเลิกใช้และอาจถูกลบออกในเวอร์ชันในอนาคต
เดลต้าเลค 4.2
Delta Lake 4.2 สร้างขึ้นจากการเปิดตัว Delta Lake ก่อนหน้านี้ โดยสานต่อความมุ่งมั่นในการทําให้ Delta Lake ทํางานร่วมกันได้ในทุกรูปแบบ ทํางานได้ง่ายขึ้น และมีประสิทธิภาพมากขึ้น การเพิ่มประสิทธิภาพ และการปรับปรุงพื้นฐานสําหรับอนาคตของเลคเฮาส์ข้อมูลแบบเปิด
สําหรับรายการทั้งหมดและการเปลี่ยนแปลงโดยละเอียดที่นํามาใช้กับ Delta Lake 3.3, 4.0, 4.1 และ 4.2 โปรดดู:
เค้าโครงข้อมูลและการเพิ่มประสิทธิภาพ
รันไทม์ 2.0 รองรับเค้าโครงข้อมูลและคุณสมบัติการเพิ่มประสิทธิภาพสําหรับตารางเดลต้า:
- การเรียงลําดับ Z: จัดระเบียบข้อมูลภายในไฟล์ตารางเดลต้าตามคอลัมน์ที่ระบุเพื่อปรับปรุงประสิทธิภาพการสืบค้นสําหรับการค้นหาที่กรอง
- Liquid Clustering: วิธีการจัดกลุ่มที่ยืดหยุ่นซึ่งปรับเค้าโครงข้อมูลให้เหมาะสมโดยอัตโนมัติโดยไม่ต้องบํารุงรักษาด้วยตนเอง
- การโหลดสแนปช็อตเดลต้าแบบขนาน: เอ็นจิ้นการดําเนินการดั้งเดิมจะโหลดสแนปช็อตตารางเดลต้าแบบขนาน ซึ่งช่วยลดเวลาเริ่มต้นคิวรีสําหรับตารางขนาดใหญ่
สําคัญ
ฟีเจอร์เฉพาะของ Delta Lake 4.2 เป็นฟีเจอร์ทดลองและใช้งานได้กับประสบการณ์ Spark เท่านั้น เช่น สมุดบันทึกและคําจํากัดความงาน Spark หากคุณต้องการใช้ตาราง Delta Lake เดียวกันในปริมาณงาน Microsoft Fabric หลายรายการ อย่าเปิดใช้งานคุณลักษณะเหล่านั้น หากต้องการเรียนรู้เพิ่มเติมเกี่ยวกับเวอร์ชันและคุณลักษณะของโปรโตคอลที่เข้ากันได้กับประสบการณ์การใช้งาน Microsoft Fabric ทั้งหมด โปรดดู การทํางานร่วมกันของรูปแบบตาราง Delta Lake
การจัดการการประมวลผลใน Runtime 2.0
รันไทม์ 2.0 รองรับคุณสมบัติการจัดการการประมวลผลต่อไปนี้:
- โปรไฟล์ทรัพยากร: กําหนดค่าการจัดสรรทรัพยากรที่กําหนดไว้ล่วงหน้าสําหรับเซสชัน Spark เพื่อให้ตรงกับความต้องการของปริมาณงานและควบคุมต้นทุน
- พูลสดแบบกําหนดเอง (พรีวิว): สร้างพูล Spark เฉพาะที่อุ่นเครื่องไว้ล่วงหน้า ซึ่งช่วยลดเวลาเริ่มต้นเซสชัน พูลสดแบบกําหนดเองพร้อมใช้งานในการแสดงตัวอย่างสําหรับปริมาณงานรันไทม์ 2.0
ข้อจํากัดและหมายเหตุ
- คุณลักษณะเฉพาะของ Delta Lake 4.x เป็นการทดลองและใช้งานได้กับประสบการณ์ Spark เท่านั้น เช่น สมุดบันทึกและข้อกําหนดงาน Spark หากคุณต้องการใช้ตาราง Delta Lake เดียวกันในปริมาณงาน Fabric หลายรายการ อย่าเปิดใช้งานคุณลักษณะเหล่านั้น สําหรับข้อมูลเพิ่มเติม โปรดดู ความสามารถในการทํางานร่วมกันของรูปแบบตาราง Delta Lake
- ส่วนขยาย VS Code สําหรับ Fabric Spark รองรับรันไทม์ 2.0 สําหรับการพัฒนาข้อกําหนดงานของโน้ตบุ๊กและ Spark
เนื้อหาที่เกี่ยวข้อง
- ย้ายจาก Runtime 1.3 ไปยัง Runtime 2.0
- รันไทม์ Apache Spark ใน Fabric - ภาพรวม การกําหนดเวอร์ชัน และการสนับสนุนรันไทม์หลายรายการ
- คู่มือการโยกย้าย Spark Core
- คู่มือการโยกย้าย SQL, ชุดข้อมูล และ DataFrame
- คู่มือการโยกย้ายแบบสตรีมมิ่งที่มีโครงสร้าง
- คู่มือการโยกย้าย MLlib (Machine Learning)
- คู่มือการโยกย้าย PySpark (Python บน Spark)
- คู่มือการโยกย้าย SparkR (R บน Spark)