หมายเหตุ
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลอง ลงชื่อเข้าใช้หรือเปลี่ยนไดเรกทอรีได้
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลองเปลี่ยนไดเรกทอรีได้
SparkR เป็นแพ็คเกจ R ที่ให้ส่วนหน้าที่มีน้ําหนักเบาเพื่อใช้ Apache Spark จาก R SparkR ให้การใช้งานเฟรมข้อมูลแบบกระจายที่รองรับการดําเนินการต่างๆ เช่น การเลือก การกรอง การรวม และอื่นๆ SparkR ยังรองรับการเรียนรู้ของเครื่องแบบกระจายโดยใช้ MLlib
ใช้ SparkR ผ่านข้อกําหนดชุดงาน Spark หรือกับสมุดบันทึก Microsoft Fabric แบบโต้ตอบ
การสนับสนุน R มีเฉพาะใน Spark 3.1 หรือใหม่กว่าเท่านั้น ไม่รองรับ R ใน Spark 2.4
ข้อกำหนดเบื้องต้น
รับการสมัครใช้งาน Microsoft Fabric หรือลงทะเบียนเพื่อทดลองใช้ Microsoft Fabric ฟรี
ลงชื่อเข้าใช้ Microsoft Fabric
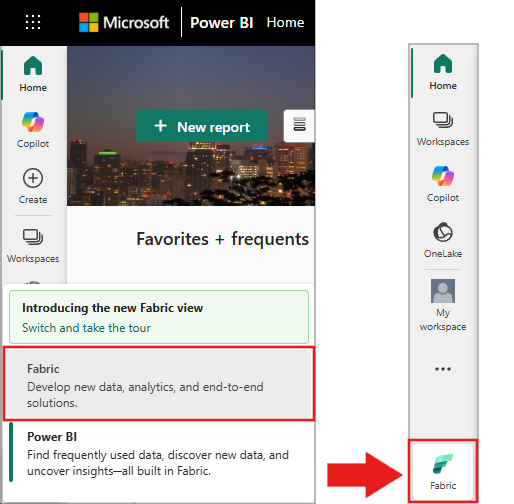
สลับไปยัง Fabric โดยใช้ตัวสลับประสบการณ์ที่ด้านซ้ายล่างของโฮมเพจของคุณ
เปิดหรือสร้างสมุดบันทึก เมื่อต้องการเรียนรู้วิธีการ ให้ดูที่ วิธีใช้สมุดบันทึก Microsoft Fabric
ตั้งค่าตัวเลือกภาษาเป็น SparkR (R) เพื่อเปลี่ยนภาษาหลัก
แนบสมุดบันทึกของคุณเข้ากับเลคเฮ้าส์ ทางด้านซ้าย เลือก เพิ่ม เพื่อเพิ่มเลคเฮาส์ที่มีอยู่ หรือเพื่อสร้างเลคเฮ้าส์
อ่านและเขียน SparkR DataFrames
อ่าน SparkR DataFrame จากเฟรมข้อมูล R ภายในเครื่อง
วิธีที่ง่ายที่สุดในการสร้าง DataFrame คือการแปลง R data.frame ภายในเครื่องเป็น Spark DataFrame
# load SparkR package
library(SparkR)

# read a SparkR DataFrame from a local R data.frame
df <- createDataFrame(faithful)

# displays the content of the DataFrame
display(df)
อ่านและเขียน SparkR DataFrame จาก Lakehouse
คุณสามารถจัดเก็บข้อมูลบนระบบไฟล์โลคัลของโหนดคลัสเตอร์ หากต้องการอ่านและเขียน SparkR DataFrame จาก Lakehouse ให้ใช้เมธอด read.df และwrite.df วิธีการเหล่านี้ใช้เส้นทางสําหรับไฟล์ที่จะโหลดและชนิดของแหล่งข้อมูล SparkR สนับสนุนการอ่านไฟล์ CSV, JSON, text และ Parquet โดยดั้งเดิม
หากต้องการอ่านและเขียนไปยังเลคเฮ้าส์ ก่อนอื่นให้เพิ่มชุดข้อมูลลงในเซสชั่นของคุณ ทางด้านซ้ายของสมุดบันทึก ให้เลือก เพิ่ม เพื่อเพิ่มเลคเฮ้าส์ที่มีอยู่แล้ว หรือสร้างเลคเฮ้าส์
หมายเหตุ
หากต้องการเข้าถึงไฟล์ Lakehouse โดยใช้แพ็กเกจ read.df Spark เช่น หรือ write.df, ให้ใช้เส้นทาง ABFS หรือเส้นทางสัมพัทธ์สําหรับ Spark ใน Lakehouse explorer ให้คลิกขวาที่ไฟล์หรือโฟลเดอร์ที่คุณต้องการเข้าถึง แล้วคัดลอก เส้นทาง ABFS หรือ เส้นทางสัมพัทธ์สําหรับ Spark จากเมนูทางลัด
# write data in CSV using relative path for Spark
temp_csv_spark<-"Files/data/faithful.csv"
write.df(df, temp_csv_spark ,source="csv", mode = "overwrite", header = "true")

# read data in CSV using relative path for Spark
faithfulDF_csv <- read.df(temp_csv_spark, source= "csv", header = "true", inferSchema = "true")

# displays the content of the DataFrame
display(faithfulDF_csv)
# write data in parquet using an ABFS path
temp_parquet_spark<-"abfss://xxx/xxx/data/faithful.parquet"
write.df(df, temp_parquet_spark ,source="parquet", mode = "overwrite", header = "true")

# read data in parquet using an ABFS path
faithfulDF_pq <- read.df(temp_parquet_spark, source= "parquet", header = "true", inferSchema = "true")

# displays the content of the DataFrame
display(faithfulDF_pq)
Microsoft Fabric มี tidyverse ติดตั้งไว้ล่วงหน้า คุณสามารถเข้าถึงไฟล์ Lakehouse ในแพ็คเกจ R ที่คุณคุ้นเคย เช่น การอ่านและเขียนไฟล์ Lakehouse โดยใช้ readr::read_csv() และ readr::write_csv().
หมายเหตุ
ในการเข้าถึงไฟล์ Lakehouse โดยใช้แพ็คเกจ R คุณต้องใช้เส้นทาง File API ใน Lakehouse explorer ให้คลิกขวาที่ไฟล์หรือโฟลเดอร์ที่คุณต้องการเข้าถึงและคัดลอก เส้นทาง File API จากเมนูตามบริบท
# read data in CSV using API path
# To find the path, navigate to the csv file, right click, and  Copy File API path.
temp_csv_api<-'/lakehouse/default/Files/data/faithful.csv/part-00000-d8e09a34-bd63-41bd-8cf8-f4ed2ef90e6c-c000.csv'
faithfulDF_API <- readr::read_csv(temp_csv_api)

# display the content of the R data.frame
head(faithfulDF_API)
คุณยังสามารถอ่าน SparkR Dataframe บน Lakehouse ของคุณได้โดยใช้คิวรี SparkSQL
# Register earlier df as temp view
createOrReplaceTempView(df, "eruptions")

# Create a df using a SparkSQL query
waiting <- sql("SELECT * FROM eruptions")

head(waiting)
การดําเนินการ DataFrame
SparkR DataFrames สนับสนุนฟังก์ชันมากมายเพื่อทําการประมวลผลข้อมูลที่มีโครงสร้าง ต่อไปนี้คือตัวอย่างพื้นฐานบางส่วน สามารถพบรายการทั้งหมดได้ในเอกสาร SparkR API
เลือกแถวและคอลัมน์
# Select only the "waiting" column
head(select(df,df$waiting))
# Pass in column name as strings
head(select(df, "waiting"))
# Filter to only retain rows with waiting times longer than 70 mins
head(filter(df, df$waiting > 70))
การจัดกลุ่มและการรวม
เฟรมข้อมูล SparkR สนับสนุนฟังก์ชันที่ใช้กันทั่วไปมากมายเพื่อรวบรวมข้อมูลหลังจากการจัดกลุ่ม ตัวอย่างเช่น คุณสามารถคํานวณฮิสโตแกรมของเวลารอในชุดข้อมูลที่ซื่อสัตย์ดังที่แสดงในตัวอย่างต่อไปนี้
# we use the `n` operator to count the number of times each waiting time appears
head(summarize(groupBy(df, df$waiting), count = n(df$waiting)))
# we can also sort the output from the aggregation to get the most common waiting times
waiting_counts <- summarize(groupBy(df, df$waiting), count = n(df$waiting))
head(arrange(waiting_counts, desc(waiting_counts$count)))
การดําเนินการคอลัมน์
SparkR มีฟังก์ชันมากมายที่คุณสามารถนําไปใช้กับคอลัมน์ได้โดยตรงสําหรับการประมวลผลและการรวมข้อมูล ตัวอย่างต่อไปนี้แสดงการใช้ฟังก์ชันทางคณิตศาสตร์พื้นฐาน
# convert waiting time from hours to seconds.
# you can assign this to a new column in the same DataFrame
df$waiting_secs <- df$waiting * 60
head(df)
ใช้ฟังก์ชันที่ผู้ใช้กําหนดเอง
SparkR สนับสนุนฟังก์ชันที่ผู้ใช้กําหนดเองหลายชนิด:
เรียกใช้ฟังก์ชันบนชุดข้อมูลขนาดใหญ่ที่มี dapply หรือ dapplyCollect
dapply
นําฟังก์ชันไปใช้กับแต่ละพาร์ติชันของSparkDataFrame ฟังก์ชันที่จะนําไปใช้กับแต่ละพาร์ติชันของควร SparkDataFrame มีพารามิเตอร์เพียงตัวเดียว ซึ่งสอดคล้องกับ data.frame สําหรับแต่ละพาร์ติชัน ผลลัพธ์ของฟังก์ชันควรเป็นdata.frame Schema ระบุรูปแบบแถวของผลลัพธ์SparkDataFrame ต้องตรงกับ ชนิดข้อมูล ของค่าที่ส่งคืน
# convert waiting time from hours to seconds
df <- createDataFrame(faithful)
schema <- structType(structField("eruptions", "double"), structField("waiting", "double"),
                     structField("waiting_secs", "double"))

# apply UDF to DataFrame
df1 <- dapply(df, function(x) { x <- cbind(x, x$waiting * 60) }, schema)
head(collect(df1))
dapplyCollect
ชอบ dapplyใช้ฟังก์ชันกับแต่ละพาร์ติชันของ a SparkDataFrame และรวบรวมผลลัพธ์กลับมา ผลลัพธ์ของฟังก์ชันควรเป็นdata.frame แต่คราวนี้คุณไม่จําเป็นต้องผ่านสคีมา โปรดทราบว่า dapplyCollect อาจล้มเหลวหากไม่สามารถดึงเอาต์พุตของฟังก์ชันที่ทํางานบนพาร์ติชันทั้งหมดไปยังไดรเวอร์และพอดีกับหน่วยความจําไดรเวอร์ได้
# convert waiting time from hours to seconds
# apply UDF to DataFrame and return a R's data.frame
ldf <- dapplyCollect(
         df,
         function(x) {
           x <- cbind(x, "waiting_secs" = x$waiting * 60)
         })
head(ldf, 3)
เรียกใช้ฟังก์ชันในการจัดกลุ่มชุดข้อมูลขนาดใหญ่ตามคอลัมน์ข้อมูลป้อนเข้าที่มี gapply หรือ gapplyCollect
gapply
นําฟังก์ชันไปใช้กับแต่ละกลุ่มของSparkDataFrame ฟังก์ชันที่จะใช้กับแต่ละกลุ่มของ a SparkDataFrame ควรมีพารามิเตอร์เพียงสองตัว: คีย์การจัดกลุ่มและ R data.frame ที่สอดคล้องกับคีย์นั้น คุณเลือกกลุ่มจาก SparkDataFrames คอลัมน์ ผลลัพธ์ของฟังก์ชันควรเป็นdata.frame Schema ระบุรูปแบบแถวของผลลัพธ์SparkDataFrame ต้องแสดง Schema เอาต์พุตของฟังก์ชัน R จาก ชนิดข้อมูล Spark คุณตั้งค่าชื่อคอลัมน์ของไฟล์ . ที่ส่งกลับdata.frame
# determine six waiting times with the largest eruption time in minutes.
schema <- structType(structField("waiting", "double"), structField("max_eruption", "double"))
result <- gapply(
    df,
    "waiting",
    function(key, x) {
        y <- data.frame(key, max(x$eruptions))
    },
    schema)
head(collect(arrange(result, "max_eruption", decreasing = TRUE)))
gapplyCollect
ชอบgapplyใช้ฟังก์ชันกับแต่ละกลุ่มของ a SparkDataFrame และรวบรวมผลลัพธ์กลับไปที่ R data.frame ผลลัพธ์ของฟังก์ชันควรเป็นdata.frame แต่คุณไม่จําเป็นต้องผ่านสคีมา โปรดทราบว่า gapplyCollect อาจล้มเหลวหากไม่สามารถดึงเอาต์พุตของฟังก์ชันที่ทํางานบนพาร์ติชันทั้งหมดไปยังไดรเวอร์และพอดีกับหน่วยความจําไดรเวอร์ได้
# determine six waiting times with the largest eruption time in minutes.
result <- gapplyCollect(
    df,
    "waiting",
    function(key, x) {
        y <- data.frame(key, max(x$eruptions))
        colnames(y) <- c("waiting", "max_eruption")
        y
    })
head(result[order(result$max_eruption, decreasing = TRUE), ])
เรียกใช้ฟังก์ชัน R ภายในเครื่องที่กระจายด้วย spark.lapply
spark.lapply
คล้ายกับ lapply ใน R spark.lapply ดั้งเดิม เรียกใช้ฟังก์ชันเหนือรายการขององค์ประกอบและแจกจ่ายการคํานวณโดยใช้ Spark ใช้ฟังก์ชันในลักษณะที่คล้ายกับ doParallel หรือ lapply กับองค์ประกอบของรายการ ผลลัพธ์ของการคํานวณทั้งหมดควรพอดีกับเครื่องเดียว หากเงื่อนไขนั้นไม่เป็นความจริง คุณสามารถทําบางอย่างเช่นdf <- createDataFrame(list)แล้วใช้dapply
# perform distributed training of multiple models with spark.lapply. Here, we pass
# a read-only list of arguments which specifies family the generalized linear model should be.
families <- c("gaussian", "poisson")
train <- function(family) {
  model <- glm(Sepal.Length ~ Sepal.Width + Species, iris, family = family)
  summary(model)
}
# return a list of model's summaries
model.summaries <- spark.lapply(families, train)

# print the summary of each model
print(model.summaries)
เรียกใช้คิวรี SQL จาก SparkR
คุณสามารถลงทะเบียน SparkR DataFrame เป็นมุมมองชั่วคราว เพื่อให้คุณสามารถเรียกใช้การสืบค้น SQL บนข้อมูลได้ ฟังก์ชันนี้ sql ช่วยให้แอปพลิเคชันสามารถเรียกใช้แบบสอบถาม SQL โดยทางโปรแกรมและส่งคืนผลลัพธ์เป็น SparkR DataFrame
# Register earlier df as temp view
createOrReplaceTempView(df, "eruptions")

# Create a df using a SparkSQL query
waiting <- sql("SELECT waiting FROM eruptions where waiting>70 ")

head(waiting)
การเรียนรู้ของเครื่อง
SparkR เปิดอัลกอริทึม MLLib ส่วนใหญ่ ภายใต้ประทุน SparkR ใช้ MLlib เพื่อฝึกแบบจําลอง
ตัวอย่างต่อไปนี้แสดงวิธีการสร้างแบบจําลอง Gaussian GLM โดยใช้ SparkR เมื่อต้องการเรียกใช้การถดถอยเชิงเส้น ให้ตั้งค่าตระกูลเป็น"gaussian" หากต้องการเรียกใช้การถดถอยโลจิสติกส์ ให้ตั้งค่าตระกูลเป็น"binomial" เมื่อใช้ SparkML GLM SparkR จะทําการเข้ารหัสคุณลักษณะตามหมวดหมู่แบบ one-hot โดยอัตโนมัติ คุณไม่จําเป็นต้องทําด้วยตนเอง นอกเหนือจากคุณสมบัติประเภท String และ Double แล้ว คุณยังสามารถใส่คุณสมบัติ MLlib Vector เพื่อความเข้ากันได้กับส่วนประกอบ MLlib อื่นๆ
หากต้องการเรียนรู้เพิ่มเติมเกี่ยวกับอัลกอริทึมการเรียนรู้ของเครื่องที่รองรับ โปรดไปที่เอกสารประกอบสําหรับ SparkR และ MLlib
# create the DataFrame
cars <- cbind(model = rownames(mtcars), mtcars)
carsDF <- createDataFrame(cars)

# fit a linear model over the dataset.
model <- spark.glm(carsDF, mpg ~ wt + cyl, family = "gaussian")

# model coefficients are returned in a similar format to R's native glm().
summary(model)