除了 Azure SQL Database 之外,建議您將使用目前分割保留為選取的值。 當你從所有其他來源系統讀取資料時,資料流會根據資料大小自動平均分割資料。 每約 128 MB 的資料會建立一個新分割區。 隨著資料大小增加,分割區數量也會增加。
任何自訂分割都是在 Spark 讀取資料 後 才發生,這會負面影響你的資料流效能。 由於讀取時資料會平均分割,因此除非您先了解資料的形狀與基數,否則不建議這麼做。
備註
讀取速度可能會受到來源系統吞吐量的限制。
Azure SQL Database 資料來源
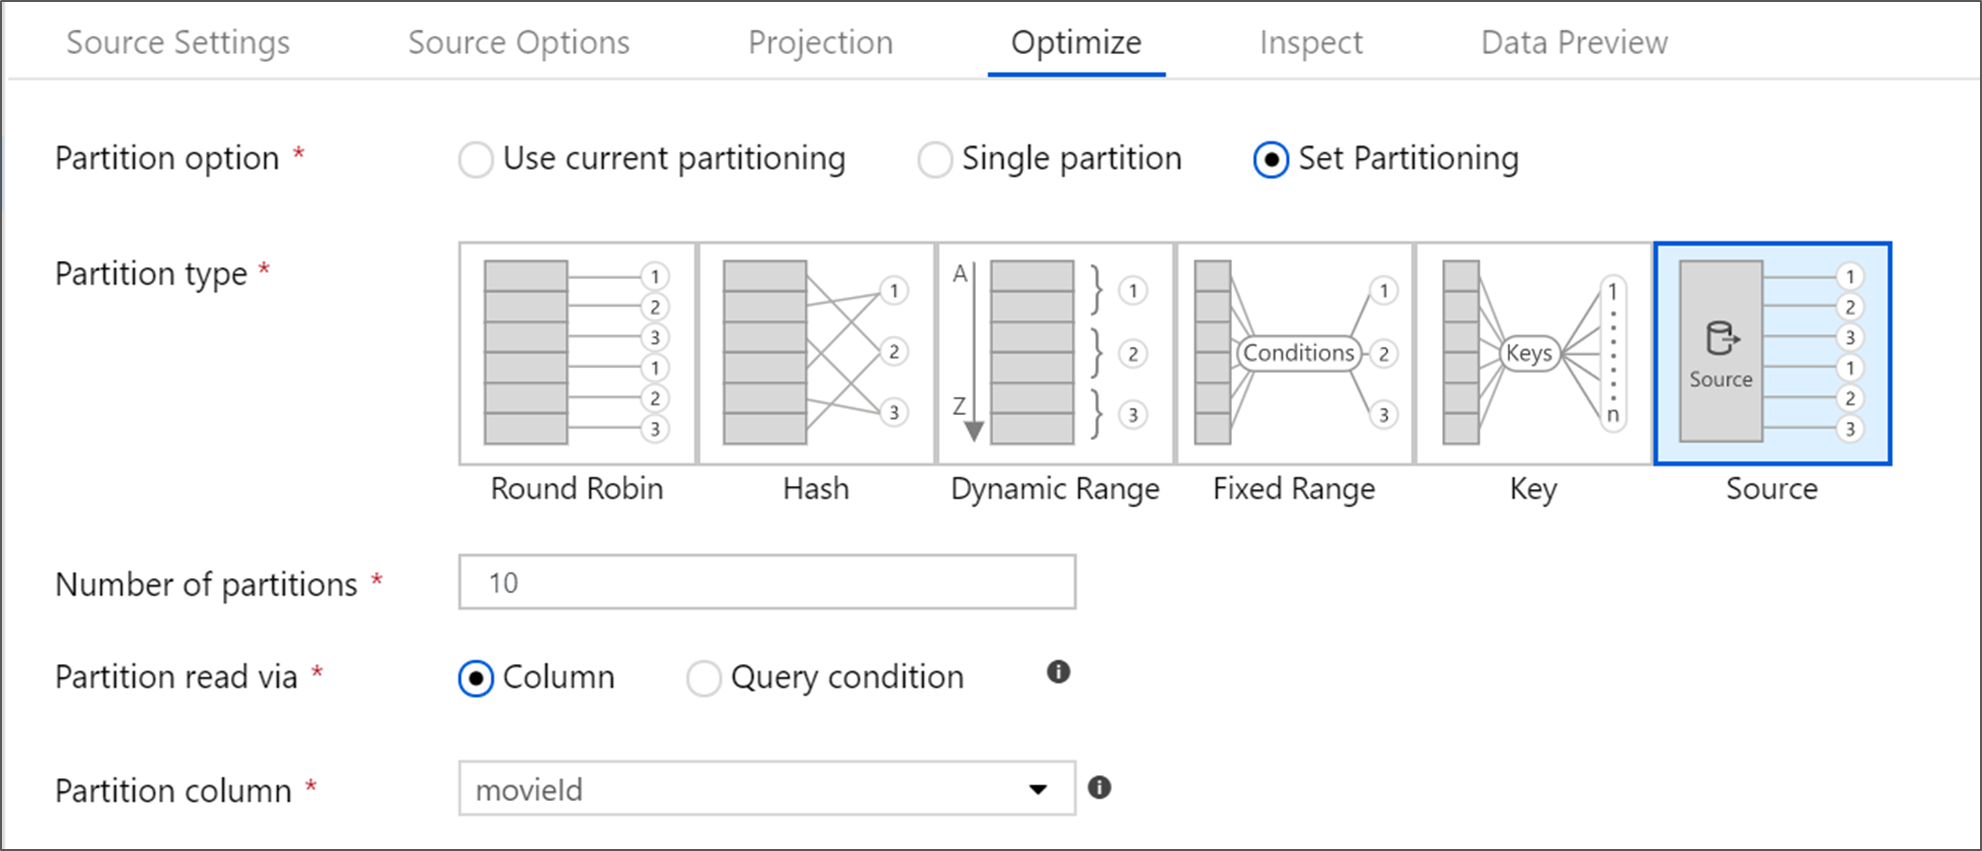
Azure SQL Database 有一個獨特的分割選項,稱為「來源」分割。 啟用原始碼分割可以透過啟用原始碼系統上的平行連線,提升 Azure SQL 資料庫的讀取時間。 指定分割區數量以及如何分割資料。 使用具有高基數的分區欄。 你也可以輸入與來源資料表分割方案相符的查詢。
小提示
對於原始碼分割來說,SQL Server 的 I/O 是瓶頸。 新增太多分割區可能會讓你的原始資料庫飽和。 通常使用此選項時,四到五個分區是理想的。
隔離等級
Azure SQL 原始碼系統讀取的隔離程度會影響效能。 選擇「Read uncommitted」能提供最快的效能,並防止任何資料庫鎖定。 欲了解更多關於 SQL 隔離層級的資訊,請參閱 「理解隔離層級」。
使用查詢進行閱讀
你可以用表格或 SQL 查詢從 Azure SQL 資料庫讀取資料。 如果你執行的是 SQL 查詢,查詢必須完成後才能開始轉換。 SQL 查詢可用於下推操作,這些操作可能執行得更快,並減少從 SQL 伺服器讀取的資料量,例如 SELECT、WHERE 和 JOIN 語句。 當進行下推操作時,你會失去在資料進入資料流之前追蹤轉換的脈絡和效能的能力。
Azure Synapse Analytics 資料來源
使用 Azure Synapse Analytics 時,來源選項中有個叫 做「啟用暫存 」的設定。 這讓該服務能夠利用 Staging 從 Synapse 中進行讀取,並通過使用效能最高的批量載入功能,如 CETAS 和 COPY 指令,顯著提高讀取效能。 啟用 Staging 需要你在資料流活動設定中指定 Azure Blob Storage 或 Azure Data Lake Storage gen2 的暫存位置。

基於檔案的資料來源
Parquet 與分隔文字
雖然資料流支援多種檔案類型,但建議採用 Spark 原生的 Parquet 格式以達到最佳讀寫時間。
如果你在一組檔案上執行相同的資料流,我們建議從資料夾讀取、使用通配碼路徑或從檔案清單讀取。 一次資料流活動的執行可以批次處理你所有檔案。 關於如何設定這些設定的更多資訊,請參閱 Azure Blob Storage 連接器文件中的原始碼轉換部分。
如果可能,避免使用 For-Each 操作來對一組檔案進行資料流。 這會導致每次 for-each 迭代都會啟動自己的 Spark 叢集,這通常不是必要的,且成本較高。
內嵌資料集與共享資料集
ADF 和 Synapse 資料集是你工廠和工作空間中的共享資源。 然而,當您閱讀包含大量分隔文字和 JSON 來源的資料夾和檔案時,可以藉由在「投影 | 架構選項」對話框中設定「使用者投影架構」選項來提升資料流檔案探索的效能。 此選項關閉 ADF 預設的結構自動發現功能,並大幅提升檔案發現的效能。 在設定這個選項之前,請確保匯入投影,讓 ADF 有現有的投影架構。 這個選項無法支援 schema drift。
相關內容
請參閱其他與效能相關的資料流程文章: