適用於: Azure Data Factory Azure Synapse Analytics
提示
Data Factory in Microsoft Fabric 是下一代的 Azure Data Factory,擁有更簡單的架構、內建 AI 及新功能。 如果你是資料整合新手,建議先從 Fabric Data Factory 開始。 現有的 ADF 工作負載可升級至 Fabric,以存取資料科學、即時分析與報告等新能力。
本文說明如何在 Azure Data Factory 或 Synapse 管線中使用複製活動(Copy Activity)來從Azure Synapse Analytics複製資料,並利用 Data Flow 在Azure Data Lake Storage Gen2中轉換資料。 想了解Azure Data Factory,請閱讀入門文章。
注意
此連接器也可在 Microsoft Fabric 的 Data Factory 中取得。 關於Fabric專屬的設定與功能,請參閱 Fabric Azure Synapse Analytics 連接器文件。
支援的功能
此 Azure Synapse Analytics 連接器支援以下功能:
| 支援的功能 | IR | 管理的私人端點 |
|---|---|---|
| 複製活動 (來源/接收) | (1) (2) | ✓ |
| 映射資料流 (來源/匯入) | 1. | ✓ |
| 查找活動 | (1) (2) | ✓ |
| GetMetadata 活動 | (1) (2) | ✓ |
| 指令碼活動 | (1) (2) | ✓ |
| 預存程序活動 | (1) (2) | ✓ |
(1) Azure 整合執行時 (2) 自架整合執行時
對於 複製活動,這個 Azure Synapse Analytics 連接器支援以下功能:
- 使用 SQL 驗證,以及搭配服務主體或 Azure 資源受控識別的 Microsoft Entra 應用程式權杖驗證來複製資料。
- 作為來源時,使用 SQL 查詢或預存程序來擷取資料。 你也可以選擇從Azure Synapse Analytics來源平行複製,詳情請參見從Azure Synapse Analytics平行複製部分。
- 作為接收時,使用 COPY 陳述式、PolyBase 或大量插入來載入資料。 建議使用 COPY 陳述式或 PolyBase,以獲得較佳的複製效能。 此連接器也支援根據來源結構描述,在目的地資料表不存在時,自動建立具有 DISTRIBUTION = ROUND_ROBIN 的目的地資料表。
重要
如果你用 Azure Integration Runtime 複製資料,請設定一個
開始
提示
為了達到最佳效能,請使用 PolyBase 或 COPY 陳述式將資料載入 Azure Synapse Analytics。 Use PolyBase 將資料載入 Azure Synapse Analytics 以及 Use COPY 陳述式將資料載入 Azure Synapse Analytics 部分則有詳細資料。 有關使用案例的攻略,請參考 用 Azure Data Factory 在 15 分鐘內將 1 TB 載入 Azure Synapse Analytics。
若要使用管線執行複製活動,您可以使用下列其中一個工具或 SDK:
使用 UI 建立 Azure Synapse Analytics 連結服務
請依照以下步驟在 Azure 入口網站介面中建立一個與 Azure Synapse Analytics 連結的服務。
請瀏覽 Azure Data Factory 或 Synapse 工作區的管理標籤,選擇連結服務,然後點選新建:
搜尋 Synapse,選擇 Azure Synapse Analytics 連接器。

設定服務詳細資料,測試連線,然後建立新的連結服務。


連接器設定詳細資料
下列各節提供屬性詳細資料,這些屬性定義了 Azure Synapse Analytics 連接器專屬的 Data Factory 和 Synapse 管線實體。
連結服務屬性
Azure Synapse Analytics連接器推薦版本支援 TLS 1.3。 請參考此 section,將你的 Azure Synapse Analytics 連接器版本從 Legacy 升級。 如需屬性詳細資料,請參閱對應的章節。
提示
在 Azure Synapse 入口網站建立 serverless SQL 池的連結服務時:
- 針對 [帳戶選取方法],選擇 [手動輸入]。
- 貼上無伺服器端點的完整網域名稱。 你可以在 Synapse 工作區的 Azure 入口網站概覽頁面,在 Serverless SQL endpoint 的屬性中找到這個。 例如:
myserver-ondemand.sql-azuresynapse.net。 - 針對 [資料庫名稱],提供無伺服器 SQL 集區中的資料庫名稱。
提示
如果你遇到錯誤碼為「UserErrorFailedToConnectToSqlServer」且訊息顯示「資料庫的會話限制為 XXX,且已達到限制」,請在連接字串中加入 Pooling=false 並重新嘗試。
建議的版本
當你套用 Recommended版本時,這些通用屬性都支援於Azure Synapse Analytics連結服務:
| 屬性 | 描述 | 必要 |
|---|---|---|
| 型別 | 類型屬性必須設為 AzureSqlDW。 | Yes |
| 伺服器 | 您想要連線的 SQL Server 執行個體名稱或其網路位址。 | Yes |
| 資料庫 | 資料庫的名稱。 | Yes |
| 認證類型 | 用於驗證的類型。 允許的值為 SQL (預設值)、ServicePrincipal、SystemAssignedManagedIdentity、UserAssignedManagedIdentity。 移至特定屬性和必要條件的相關驗證一節。 | Yes |
| 加密 | 指出用戶端與伺服器之間傳送的所有資料是否都需要 TLS 加密。 選項:強制 (若為 true,預設值)/選擇性 (若為 false)/strict。 | No |
| trustServerCertificate | 指出通道是否會加密,同時略過驗證信任的憑證鏈結。 | No |
| 證書中的主機名 | 針對連線驗證伺服器憑證時要使用的主機名稱。 未指定時,伺服器名稱會用於憑證驗證。 | No |
| connectVia | 用來連線到資料存放區的整合執行階段。 您可以使用 Azure Integration Runtime 或自我裝載 Integration Runtime (如果您的資料存放區位於私人網路中)。 若未指定,則使用預設Azure Integration Runtime。 | No |
如需其他連線屬性,請參閱下表:
| 屬性 | 描述 | 必要 |
|---|---|---|
| 應用程序意圖 | 連線至伺服器時的應用程式工作負載類型。 允許值為:ReadOnly 和 ReadWrite。 |
No |
| connectTimeout | 等待連接到伺服器的時間長度(以秒為單位),在達到此時限後將終止嘗試並產生錯誤。 | No |
| connectRetryCount | 識別到閒置連線失敗之後,嘗試重新連線的次數。 此值應為介於 0 到 255 之間的整數。 | No |
| connectRetryInterval | 識別閒置連線失敗之後,每次重新連線嘗試之間的時間 (以秒為單位)。 此值應為介於 1 到 60 之間的整數。 | No |
| loadBalanceTimeout | 在連線終結之前,連線在連線集區中存在的最短時間 (以秒為單位)。 | No |
| commandTimeout | 終止嘗試執行命令並產生錯誤之前的預設等候時間 (以秒為單位)。 | No |
| integratedSecurity | 允許的值為 true 或 false。 指定 false 時,指出是否已在連線中指定 userName 和 password。 在指定 true 時,表示是否使用目前的Windows帳號憑證進行驗證。 |
No |
| failoverPartner | 當主要伺服器關閉時,應連線的合作夥伴伺服器名稱或位址。 | No |
| 最大池大小 | 特定連線的連線集區中允許的連線數目上限。 | No |
| minPoolSize (最小池大小) | 特定連線的連線集區中允許的連線數目下限。 | No |
| 多重主動結果集 (multipleActiveResultSets) | 允許的值為 true 或 false。 當您指定 true 時,應用程式可以維護多個使用中結果集 (MARS)。 當您指定 false 時,應用程式必須先處理或取消一個批次的所有結果集,才能在該連線上執行任何其他批次。 |
No |
| multiSubnetFailover | 允許的值為 true 或 false。 如果您的應用程式連線至不同子網路上的 AlwaysOn 可用性群組 (AG),則將此屬性設定為 true 可以更快地偵測並連線到目前使用中的伺服器。 |
No |
| 封包大小 (packetSize) | 用來與伺服器執行個體通訊的網路封包大小 (位元組)。 | No |
| 共用 | 允許的值為 true 或 false。 當您指定 true 時,連線會是集區式連線。 當您指定 false 時,每次要求連線時都會明確開啟連線。 |
No |
SQL 驗證
若要使用 SQL 驗證,除了上一節所述的泛型屬性外,請指定下列屬性:
| 屬性 | 描述 | 必要 |
|---|---|---|
| userName | 用來連線到伺服器的使用者名稱。 | Yes |
| 密碼 | 使用者名稱的密碼。 將此欄位標記為 SecureString 以將其安全地儲存。 或者,你可以引用儲存在 Azure Key Vault 中的秘密。 | Yes |
範例:使用 SQL 驗證
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SQL",
            "userName": "<user name>",
            "password": {
                "type": "SecureString",
                "value": "<password>"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
範例:Azure Key Vault 中的密碼
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SQL",
            "userName": "<user name>",
            "password": {
                "type": "AzureKeyVaultSecret",
                "store": {
                    "referenceName": "<Azure Key Vault linked service name>",
                    "type": "LinkedServiceReference"
                },
                "secretName": "<secretName>"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
服務主帳戶驗證
若要使用服務主體驗證,除了上一節所述的一般屬性外,請指定下列屬性:
| 屬性 | 描述 | 必要 |
|---|---|---|
| servicePrincipalId | 指定應用程式的用戶端識別碼。 | Yes |
| servicePrincipalCredential | 服務主體認證。 指定應用程式的金鑰。 將此欄位標記為 SecureString 以安全地儲存,或指向儲存在 Azure Key Vault 中的秘密。 | Yes |
| 用戶 | 指定您的應用程式所在租戶的資訊 (網域名稱或租戶識別碼)。 你可以將滑鼠懸停在 Azure 入口的右上角來取得。 | Yes |
| azureCloudType | 對於服務主體認證,請指定您的 Microsoft Entra 應用程式註冊到哪種 Azure 雲端環境類型。 允許的值為 AzurePublic、AzureChina、AzureUsGovernment 和 AzureGermany。 預設會使用 Data Factory 或 Synapse 管線的雲端環境。 |
No |
此外,請依照下列步驟操作:
從Azure入口建立Microsoft Entra應用程式。 請記下應用程式名稱,以及下列可定義連結服務的值:
- 應用程式識別碼
- 應用程式金鑰
- 租戶識別碼
如果還沒做的話,請在Azure入口網站為你的伺服器配置一位Microsoft Entra管理員。 Microsoft Entra 管理員可以是 Microsoft Entra 使用者或 Microsoft Entra 群組。 如果您為擁有受控識別的群組授予管理員角色,請略過步驟 3 和 4。 系統管理員將擁有資料庫的完整存取權。
為服務主體建立自主資料庫使用者。 使用具有至少 ALTER ANY USER 權限的 Microsoft Entra 身分識別,透過 SSMS 等工具連線到您要從中複製資料或要將資料複製到其中的資料倉儲。 執行下列 T-SQL:
CREATE USER [your_application_name] FROM EXTERNAL PROVIDER;如同您一般對 SQL 使用者或其他人所做的一樣,將所需的權限授與服務主體。 執行下列程式碼,或參閱這裡的更多選項。 如果您想要使用 PolyBase 來載入資料,請瞭解所需的資料庫權限。
EXEC sp_addrolemember db_owner, [your application name];在Azure Data Factory或Synapse工作區中配置一個Azure Synapse Analytics連結服務。
使用服務主體驗證的連結服務範例
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "connectionString": "Server=tcp:<servername>.database.windows.net,1433;Database=<databasename>;Connection Timeout=30",
            "servicePrincipalId": "<service principal id>",
            "servicePrincipalCredential": {
                "type": "SecureString",
                "value": "<application key>"
            },
            "tenant": "<tenant info, e.g. microsoft.onmicrosoft.com>"
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
系統指派的受控身分識別用於 Azure 資源的身份驗證
資料工廠或 Synapse 工作區可與 Azure 資源的系統指派管理身分關聯,此身分代表該資源。 你可以使用這個管理身份來進行 Azure Synapse Analytics 認證。 指定的資源可以使用此身分識別來存取資料倉儲和從中來回複製資料。
若要使用系統指派的受控識別驗證,請指定上一節所述的一般屬性,並依照下列步驟操作。
請在Azure入口網站為您的伺服器配置一位Microsoft Entra管理員,如果尚未這樣做。 Microsoft Entra 管理員可以是 Microsoft Entra 使用者或 Microsoft Entra 群組。 如果您為具有系統指派的受控識別的群組授與系統管理員角色,請略過步驟 3 和 4。 系統管理員將擁有資料庫的完整存取權。
為系統指派的受控身分建立包含式資料庫使用者。 使用具有至少 ALTER ANY USER 權限的 Microsoft Entra 身分識別,透過 SSMS 等工具連線到您要從中複製資料或要將資料複製到其中的資料倉儲。 執行下列 T-SQL。
CREATE USER [your_resource_name] FROM EXTERNAL PROVIDER;依照您平常為 SQL 使用者和其他人所進行的操作一樣,授與系統指派的受控識別所需的權限。 執行下列程式碼,或參閱這裡的更多選項。 如果您想要使用 PolyBase 來載入資料,請瞭解所需的資料庫權限。
EXEC sp_addrolemember db_owner, [your_resource_name];配置一個Azure Synapse Analytics連結服務。
範例:
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "SystemAssignedManagedIdentity"
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
使用者指定的受控身分識別驗證
Data Factory 或 Synapse 工作區可以與代表資源的使用者指派受控識別相關聯。 你可以使用這個管理身份來進行 Azure Synapse Analytics 認證。 指定的資源可以使用此身分識別來存取資料倉儲和從中來回複製資料。
若要使用使用者指派的受控識別驗證,除了上一節所述的一般屬性外,請指定下列屬性:
| 屬性 | 描述 | 必要 |
|---|---|---|
| 憑證 | 將使用者指派的受控身分識別指定為認證物件。 | Yes |
此外,請依照下列步驟操作:
請在Azure入口網站為您的伺服器配置一位Microsoft Entra管理員,如果尚未這樣做。 Microsoft Entra 管理員可以是 Microsoft Entra 使用者或 Microsoft Entra 群組。 如果您為具有使用者指派的受控身分識別的群組授與系統管理員角色,請略過步驟 3。 系統管理員將擁有資料庫的完整存取權。
為使用者指派的受控識別建立自主資料庫使用者。 使用具有至少 ALTER ANY USER 權限的 Microsoft Entra 身分識別,透過 SSMS 等工具連線到您要從中複製資料或要將資料複製到其中的資料倉儲。 執行下列 T-SQL。
CREATE USER [your_resource_name] FROM EXTERNAL PROVIDER;依照您平常為 SQL 使用者和其他人所進行的操作一樣,建立一或多個使用者指派的受控識別,並授與使用者指派的受控識別所需的權限。 執行下列程式碼,或參閱這裡的更多選項。 如果您想要使用 PolyBase 來載入資料,請瞭解所需的資料庫權限。
EXEC sp_addrolemember db_owner, [your_resource_name];將一或多個使用者指派的受控身分識別指派給資料處理站,並為每個使用者指派的受控身分識別建立認證。
配置一個Azure Synapse Analytics連結服務。
範例
{
    "name": "AzureSqlDWLinkedService",
    "properties": {
        "type": "AzureSqlDW",
        "typeProperties": {
            "server": "<name or network address of the SQL server instance>",
            "database": "<database name>",
            "encrypt": "<encrypt>",
            "trustServerCertificate": false,
            "authenticationType": "UserAssignedManagedIdentity",
            "credential": {
                "referenceName": "credential1",
                "type": "CredentialReference"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
舊版
當你套用 Legacy版本時,這些通用屬性是支援於Azure Synapse Analytics連結服務的:
| 屬性 | 描述 | 必要 |
|---|---|---|
| 型別 | 類型屬性必須設為 AzureSqlDW。 | Yes |
| connectionString | 指定連接 Azure Synapse Analytics 實例所需的資訊,以符合 connectionString 屬性。 將此欄位標記為 SecureString 以將其安全地儲存。 您也可以將密碼/服務主體金鑰放在 Azure Key Vault 中;如果是 SQL 驗證,請將連接字串中的 password 組態擷取出來。 如需詳細資訊,請參閱在 Azure Key Vault 中儲存憑證的文章。 |
Yes |
| connectVia | 用來連線到資料存放區的整合執行階段。 您可以使用 Azure Integration Runtime 或自我裝載 Integration Runtime (如果您的資料存放區位於私人網路中)。 若未指定,則使用預設Azure Integration Runtime。 | No |
針對不同的驗證類型,請分別參閱下列各節特定的屬性和必要條件:
舊版的 SQL 驗證
若要使用 SQL 驗證,請指定上一節所述的泛型屬性。
舊版的服務主體驗證
若要使用服務主體驗證,除了上一節所述的一般屬性外,請指定下列屬性:
| 屬性 | 描述 | 必要 |
|---|---|---|
| servicePrincipalId | 指定應用程式的用戶端識別碼。 | Yes |
| 服務主體鍵 (servicePrincipalKey) | 指定應用程式的金鑰。 將此欄位標記為 SecureString 以安全儲存,或參考儲存在 Azure Key Vault 的機密。 | Yes |
| 用戶 | 指定您應用程式所屬的租用戶資訊,例如網域名稱或租用戶識別碼。 將滑鼠懸停在 Azure 傳送門的右上角即可取得。 | Yes |
| azureCloudType | 對於服務主體認證,請指定您的 Microsoft Entra 應用程式註冊到哪種 Azure 雲端環境類型。 允許的值為 AzurePublic、AzureChina、AzureUsGovernment 和 AzureGermany。 預設會使用 Data Factory 或 Synapse 管線的雲端環境。 |
No |
您也需要依照服務主體驗證中的步驟,授與對應的權限。
系統指派受控身分識別驗證適用於舊版
如果要使用系統指派的受控識別驗證,請遵循系統指派的受控識別驗證中建議版本的相同步驟。
舊版的使用者指派受控識別驗證
如果要使用使用者指派的受控識別驗證,請遵循使用者指派的受控識別驗證中建議版本的相同步驟。
資料集屬性
如需可用來定義資料集的區段和屬性完整清單,請參閱資料集一文。
以下屬性支援 Azure Synapse Analytics 資料集:
| 屬性 | 描述 | 必要 |
|---|---|---|
| 型別 | 資料集的類型屬性必須設定為 AzureSqlDWTable。 | Yes |
| 結構描述 | 架構名稱。 | 來源為否,接收為是 |
| 表格 | 資料表/檢視的名稱。 | 來源為否,接收為是 |
| 資料表名稱 | 具有結構描述的資料表/檢視名稱。 此屬性支援是為了向後相容性。 對於新的工作負載,請使用 schema 和 table。 |
來源為否,接收為是 |
資料集屬性範例
{
    "name": "AzureSQLDWDataset",
    "properties":
    {
        "type": "AzureSqlDWTable",
        "linkedServiceName": {
            "referenceName": "<Azure Synapse Analytics linked service name>",
            "type": "LinkedServiceReference"
        },
        "schema": [ < physical schema, optional, retrievable during authoring > ],
        "typeProperties": {
            "schema": "<schema_name>",
            "table": "<table_name>"
        }
    }
}
複製活動屬性
如需可用來定義活動的區段和屬性完整清單,請參閱管線一文。 本節提供 Azure Synapse Analytics 來源與匯項所支援的屬性清單。
Azure Synapse Analytics 作為來源
提示
若要使用資料分割有效地從 Azure Synapse Analytics 載入資料,請參考 Parallel copy from Azure Synapse Analytics。
若要從Azure Synapse Analytics複製資料,請在複製活動來源中將
| 屬性 | 描述 | 必要 |
|---|---|---|
| 型別 | 複製活動來源的類型屬性必須設定為 SqlDWSource。 | Yes |
| sqlReaderQuery | 使用自訂 SQL 查詢來讀取資料。 範例:select * from MyTable。 |
No |
| sqlReaderStoredProcedureName(SQL 資料讀取存儲過程名稱) | 從來源資料表讀取資料的預存程序名稱。 最後一個 SQL 陳述式必須是預存程序中的 SELECT 陳述式。 | No |
| 儲存過程參數 | 預存程序的參數。 允許的值為名稱或值組。 參數的名稱和大小寫必須符合預存程序參數的名稱和大小寫。 |
No |
| 隔離級別 (isolationLevel) | 指定 SQL 來源的交易鎖定行為。 允許的值為:ReadCommitted、ReadUncommitted、RepeatableRead、Serializable、Snapshot。 如果未指定,則會使用資料庫的預設隔離等級。 如需詳細資訊,請參閱 system.data.isolationlevel。 | No |
| 分割選項 | 指定用於載入 Azure Synapse Analytics 資料的資料分割選項。 允許的值為:None (預設值)、PhysicalPartitionsOfTable 和 DynamicRange。 當啟用分割區選項(即非 None)時,會透過複製活動中的 parallelCopies 設定來控制從 Azure Synapse Analytics 並行載入數據的程度。 |
No |
| 分割設定 | 指定資料分割的設定群組。 當分割選項不是 None 時套用。 |
No |
partitionSettings 底下: |
||
| partitionColumnName (分區列名稱) | 以整數類型或日期/日期時間類型 (int、smallint、bigint、date、smalldatetime、datetime、datetime2 或 datetimeoffset) 指定來源資料行的名稱,供平行複製的範圍分割使用。 如果未指定,則會自動偵測資料表的索引或主鍵,並用作分區欄位。當分割選項是 DynamicRange 時套用。 如果您使用查詢來取出來源資料,請在 WHERE 子句中加上 ?DfDynamicRangePartitionCondition 。 如需範例,請參閱從 SQL 資料庫平行複製一節。 |
No |
| partitionUpperBound(分區上限) | 用於分割分割範圍的分割欄位最大值。 這個值用於決定分割區的跨距,而不是用於篩選資料表中的資料列。 資料表或查詢結果中的所有資料列都會進行分割和複製。 如果未指定,複製活動會自動偵測該值。 當分割選項是 DynamicRange 時套用。 如需範例,請參閱從 SQL 資料庫平行複製一節。 |
No |
| partitionLowerBound | 用於分割分割範圍的分割欄位最小值。 這個值用於決定分割區的跨距,而不是用於篩選資料表中的資料列。 資料表或查詢結果中的所有資料列都會進行分割和複製。 如果未指定,複製活動會自動偵測該值。 當分割選項是 DynamicRange 時套用。 如需範例,請參閱從 SQL 資料庫平行複製一節。 |
No |
請注意下列幾點:
- 在來源中使用預存程序來擷取資料時,請注意,如果您的預存程序設計為在傳入不同的參數值時傳回不同的結構描述,在從 UI 匯入結構描述,或使用自動資料表建立將資料複製到 SQL 資料庫時,您可能遇到失敗,或看到非預期的結果。
範例:使用 SQL 查詢
"activities":[
    {
        "name": "CopyFromAzureSQLDW",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<Azure Synapse Analytics input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SqlDWSource",
                "sqlReaderQuery": "SELECT * FROM MyTable"
            },
            "sink": {
                "type": "<sink type>"
            }
        }
    }
]
範例:使用預存程序
"activities":[
    {
        "name": "CopyFromAzureSQLDW",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<Azure Synapse Analytics input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SqlDWSource",
                "sqlReaderStoredProcedureName": "CopyTestSrcStoredProcedureWithParameters",
                "storedProcedureParameters": {
                    "stringData": { "value": "str3" },
                    "identifier": { "value": "$$Text.Format('{0:yyyy}', <datetime parameter>)", "type": "Int"}
                }
            },
            "sink": {
                "type": "<sink type>"
            }
        }
    }
]
範例預存程序:
CREATE PROCEDURE CopyTestSrcStoredProcedureWithParameters
(
    @stringData varchar(20),
    @identifier int
)
AS
SET NOCOUNT ON;
BEGIN
    select *
    from dbo.UnitTestSrcTable
    where dbo.UnitTestSrcTable.stringData != stringData
    and dbo.UnitTestSrcTable.identifier != identifier
END
GO
Azure Synapse Analytics 接收器
Azure Data Factory 與 Synapse pipelines 支援三種方式將資料載入 Azure Synapse Analytics。
- 使用 COPY 陳述式
- 使用 PolyBase
- 使用大量插入
載入資料的最快速且可調整的方式是透過 COPY 陳述式或 PolyBase。
若要將資料複製到 Azure Synapse Analytics,請在複製活動中將匯入類型設為 SqlDWSink。 複製活動的 sink 區段支援下列屬性:
| 屬性 | 描述 | 必要 |
|---|---|---|
| 型別 | 複製活動接收端的類型屬性必須設定為 SqlDWSink。 | Yes |
| allowPolyBase | 指示是否使用 PolyBase 將資料載入 Azure Synapse Analytics。
allowCopyCommand 和 allowPolyBase 不可同時為 true。 請參見使用 PolyBase 載入資料至 Azure Synapse Analytics 章節了解限制與細節。 允許的值為 True 和 False (預設值)。 |
否。 使用 PolyBase 時套用。 |
| polyBaseSettings | 可以在 allowPolybase 屬性設定為 true 時指定的一組屬性。 |
否。 使用 PolyBase 時套用。 |
| 允許複製命令 | 指示是否使用 COPY 陳述式 來載入資料至 Azure Synapse Analytics。
allowCopyCommand 和 allowPolyBase 不可同時為 true。 請參見Use COPY 陳述式將資料載入 Azure Synapse Analytics 章節以了解限制與細節。 允許的值為 True 和 False (預設值)。 |
否。 使用 COPY 時適用。 |
| 複製指令設定 | 可以在 allowCopyCommand 屬性設定為 TRUE 時指定的一組屬性。 |
否。 使用 COPY 時適用。 |
| writeBatchSize |
每個批次插入 SQL 資料表的資料列數。 允許的值為整數 (資料列數目)。 根據預設,服務會依據資料列大小動態決定適當的批次大小。 |
否。 適用於進行批量插入(bulk insert)時使用。 |
| writeBatchTimeout | 插入、Upsert 和預存程序作業在逾時之前完成的等待時間。 允許的值為時間範圍。 例如 “00:30:00” 為 30 分鐘。 如果未指定任何值,逾時預設為 “00:30:00”。 |
否。 適用於進行批量插入(bulk insert)時使用。 |
| preCopyScript | 在每次執行時,先指定一個執行複製活動的 SQL 查詢,再把資料寫入 Azure Synapse Analytics。 使用此屬性來清除預先載入的資料。 | No |
| 表格選項 | 指定當接收資料表不存在時,是否根據來源結構描述自動建立接收資料表。 允許的值包為:none (預設) 或 autoCreate。 |
No |
| 停用度量收集 | 該服務收集如 Azure Synapse Analytics 的 DWU 等指標,用於複製效能優化及建議,進而引入額外的主資料庫存取權限。 如果您擔心此行為,請指定 true 將其關閉。 |
否 (預設值為 false) |
| 最大併發連線數 | 在活動執行期間建立至資料存放區的併發連線上限。 僅在想要限制並行連線時,才需要指定值。 | No |
| WriteBehavior | 指定複製活動的寫入行為,以將資料載入 Azure Synapse Analytics。 允許的值為 Insert 和 Upsert。 根據預設,服務會使用 Insert 載入資料。 |
No |
| upsertSettings | 指定寫入行為的設定群組。 當 WriteBehavior 選項為 Upsert 時套用。 |
No |
upsertSettings 底下: |
||
| 金鑰 | 指定用於唯一識別資料列的欄位名稱。 您可以使用單一按鍵或一組按鍵。 如果未指定,則會使用主索引鍵。 | No |
| interimSchemaName | 指定用於建立臨時資料表的中間架構。 注意:使用者必須具有建立和刪除資料表的權限。 根據預設,過渡資料表會與接收資料表共用相同的結構描述。 | No |
範例 1:Azure Synapse Analytics 接收
"sink": {
    "type": "SqlDWSink",
    "allowPolyBase": true,
    "polyBaseSettings":
    {
        "rejectType": "percentage",
        "rejectValue": 10.0,
        "rejectSampleValue": 100,
        "useTypeDefault": true
    }
}
範例 2:Upsert 資料
"sink": {
    "type": "SqlDWSink",
    "writeBehavior": "Upsert",
    "upsertSettings": {
        "keys": [
             "<column name>"
        ],
        "interimSchemaName": "<interim schema name>"
    },
}
從 Azure Synapse Analytics 平行複製
Azure Synapse Analytics 的複製活動連接器提供內建的資料分割功能,以平行複製資料。 您可以在複製活動的 [來源] 索引標籤上找到資料分割選項。

啟用分割複製時,複製活動會對你的 Azure Synapse Analytics 來源執行平行查詢,並依分割區載入資料。 平行程度由複製活動的 parallelCopies 設定所控制。 例如,如果你將 parallelCopies 設為四,服務會根據你指定的分割選項和設定同時產生並執行四個查詢,每個查詢都會從你的Azure Synapse Analytics中擷取一部分資料。
建議你啟用並行複製並進行資料分割,特別是當你從 Azure Synapse Analytics 載入大量資料時。 以下針對各種情節的建議設定。 將資料複製到以檔案為基礎的資料存放區時,建議分成多個檔案來寫入資料夾 (僅指定資料夾名稱),這樣效能會比寫入單一檔案更好。
| 情境 | 建議的設定 |
|---|---|
| 從大型資料表進行完整載入,並使用實體分割。 |
分割選項:資料表的實體分割區。 在執行期間,服務會自動偵測實體分割區,並依分割區複製資料。 若要檢查您的資料表是否有實體分割區,您可以參考此查詢。 |
| 從大型資料表進行完整載入,不使用實體分區,但需使用整數或日期時間欄位進行資料分區。 |
分割選項:動態範圍分割。 分割資料行 (選用):指定用來分割資料的資料行。 若未指定,則會使用索引或主索引鍵資料行。 分割區上限和分割區下限 (選用):指定是否要決定分割區跨距。 這不適用於篩選資料表中的資料列,資料表中的所有資料列都會分割並複製。 如果未指定,複製活動會自動偵測值。 例如,如果您的分割區資料行「識別碼」具有範圍 1 到 100 之間的值,而您將下限設定為 20、上限設定為 80,且平行複製為 4,則服務會分別依 4 個分割區擷取資料 - 範圍中的識別碼分別為 <=20、[21, 50]、[51, 80] 和 >=81。 |
| 使用自訂查詢載入大量資料,不使用實體分割區,同時包含整數或日期/日期時間資料行用於資料分割。 |
分割選項:動態範圍分割。 查詢: SELECT * FROM <TableName> WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>。分割資料行:指定用來分割資料的資料行。 分割區上限和分割區下限 (選用):指定是否要決定分割區跨距。 這不適用於篩選資料表中的資料列,查詢結果中的所有資料列都會分割並複製。 如果未指定,複製活動會自動偵測該值。 例如,如果您的分割區資料行「識別碼」具有範圍 1 到 100 之間的值,而您將下限設定為 20、上限設定為 80,且平行複製為 4,則服務會分別依 4 個分割區擷取資料 - 範圍中的識別碼分別為 <=20、[21, 50]、[51, 80] 和 >=81。 以下是不同案例的更多範例查詢: 1.查詢整個資料表: SELECT * FROM <TableName> WHERE ?DfDynamicRangePartitionCondition2. 執行來自資料表的查詢,包含欄位選擇及附加的 where 子句篩選: SELECT <column_list> FROM <TableName> WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>3.使用子查詢進行查詢: SELECT <column_list> FROM (<your_sub_query>) AS T WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>4.在子查詢中使用分割區進行查詢: SELECT <column_list> FROM (SELECT <your_sub_query_column_list> FROM <TableName> WHERE ?DfDynamicRangePartitionCondition) AS T |
使用分割區選項載入資料的最佳做法:
- 選擇獨特的欄位作為分割欄位(例如主鍵或唯一鍵)以避免資料不均。
- 如果資料表有內建分割區,請使用分割選項「資料表的實體分割區」,以獲得更佳的效能。
- 如果你用 Azure Integration Runtime 複製資料,可以設定較大的「Data Integration Units (DIU)」(>4)來利用更多運算資源。 檢查該處適用的案例。
- 「複製平行處理原則的程度」會控制分割區數目,將此數目設定過大有時會損害效能,建議將此數目設定為 (DIU 或自我裝載 IR 節點數目) * (2 到 4)。
- 注意 Azure Synapse Analytics 最多可同時執行 32 筆查詢,若「複製平行程度」設定過大,可能會導致 Synapse 限速問題。
範例:從實體分割區的大型資料表進行完整載入
"source": {
    "type": "SqlDWSource",
    "partitionOption": "PhysicalPartitionsOfTable"
}
範例:使用動態範圍分割進行查詢
"source": {
    "type": "SqlDWSource",
    "query": "SELECT * FROM <TableName> WHERE ?DfDynamicRangePartitionCondition AND <your_additional_where_clause>",
    "partitionOption": "DynamicRange",
    "partitionSettings": {
        "partitionColumnName": "<partition_column_name>",
        "partitionUpperBound": "<upper_value_of_partition_column (optional) to decide the partition stride, not as data filter>",
        "partitionLowerBound": "<lower_value_of_partition_column (optional) to decide the partition stride, not as data filter>"
    }
}
用於檢查實體分割的範例查詢
SELECT DISTINCT s.name AS SchemaName, t.name AS TableName, c.name AS ColumnName, CASE WHEN c.name IS NULL THEN 'no' ELSE 'yes' END AS HasPartition
FROM sys.tables AS t
LEFT JOIN sys.objects AS o ON t.object_id = o.object_id
LEFT JOIN sys.schemas AS s ON o.schema_id = s.schema_id
LEFT JOIN sys.indexes AS i ON t.object_id = i.object_id
LEFT JOIN sys.index_columns AS ic ON ic.partition_ordinal > 0 AND ic.index_id = i.index_id AND ic.object_id = t.object_id
LEFT JOIN sys.columns AS c ON c.object_id = ic.object_id AND c.column_id = ic.column_id
LEFT JOIN sys.types AS y ON c.system_type_id = y.system_type_id
WHERE s.name='[your schema]' AND t.name = '[your table name]'
如果資料表具有實體分區,您會看到 "HasPartition" 顯示為 "yes"。
使用 COPY 陳述式將資料載入 Azure Synapse Analytics
使用 COPY 陳述式 是一種簡單且靈活的方式,能以高吞吐量將資料載入Azure Synapse Analytics。 若要了解更多詳細資訊,請參閱使用 COPY 陳述式大量載入資料
- 如果你的來源資料是 Azure Blob 或 Azure Data Lake Storage Gen2,且 format 是 COPY 陳述相容,你可以使用 copy activity 直接呼叫 COPY 陳述式,讓Azure Synapse Analytics從原始碼拉取資料。 如需詳細資料,請參閱使用 COPY 陳述式直接複製。
- 如果您的來源資料存放區和格式原本不受 COPY 陳述式支援,請改用使用 COPY 陳述式的預備複製功能。 分段複製功能也能提供更高的效能。 它會自動將資料轉換成相容 COPY 語句格式,將資料儲存在 Azure Blob 儲存中,然後呼叫 COPY 語句將資料載入 Azure Synapse Analytics。
提示
使用 COPY 語句配合 Azure Integration Runtime 時,Data Integration Units(DIU) 的有效單位數總是為 2。 調整 DIU 不會影響效能,因為從儲存裝置載入資料是由 Azure Synapse 引擎驅動。
使用 COPY 陳述式直接複製
Azure Synapse Analytics COPY 陳述式直接支援 Azure Blob 和 Azure Data Lake Storage Gen2。 如果您的來源資料符合本節所述條件,請使用 COPY 陳述式直接從來源資料庫複製到 Azure Synapse Analytics。 否則,請使用COPY 陳述式來進行分段複製。 該服務會檢查設定,並在不符合準則時讓複製活動執行失敗。
來源連結服務和格式使用下列類型和驗證方法:
支援的來源資料存放區類型 支援的格式 支援的來源驗證類型 Azure Blob 限界文字 帳戶金鑰驗證、共用存取簽章驗證、服務主體驗證 (使用 ServicePrincipalKey)、系統指派受控識別驗證 Parquet 帳戶金鑰驗證、共用存取簽章驗證 ORC 帳戶金鑰驗證、共用存取簽章驗證 Azure Data Lake Storage Gen2 限界文字
Parquet
ORC帳戶金鑰驗證、服務主體金鑰驗證 (使用 ServicePrincipalKey)、共用存取簽章驗證、系統指派的(受控)身分識別驗證 重要
- 當你為儲存連結服務使用管理身份驗證時,請學習
Azure Blob 和 Azure Data Lake Storage Gen2 所需的設定。 - 如果你的Azure 儲存體設定了 VNet 服務端點,必須在儲存帳號啟用「允許可信Microsoft服務」的管理身份驗證,詳見 使用 VNet 服務端點與 Azure storage 的影響。
- 當你為儲存連結服務使用管理身份驗證時,請學習
格式設定如下̇:
- 對於 Parquet:
compression可以是不壓縮、Snappy 或GZip。 - 對於 ORC:
compression可以是不壓縮、zlib或 Snappy。 - 對於定界文字:
-
rowDelimiter明確設定為單一字元或「\r\n」,不支援預設值。 -
nullValue會保留為預設值,或設定為空字串 ("")。 -
encodingName會保留為預設值,或設定為 utf-8 或 utf-16。 -
escapeChar必須與quoteChar相同,而且不是空的。 -
skipLineCount會保留為預設值或設定為 0。 -
compression可以是不壓縮或GZip。
-
- 對於 Parquet:
如果您的來源是資料夾,則複製活動中的
recursive必須設定為 true,而且wildcardFilename必須是*或*.*。未指定
wildcardFolderPath、wildcardFilename(*或*.*以外)、modifiedDateTimeStart、modifiedDateTimeEnd、prefix、enablePartitionDiscovery和additionalColumns。
複製活動中 allowCopyCommand 底下支援下列 COPY 陳述式設定:
| 屬性 | 描述 | 必要 |
|---|---|---|
| 預設值 | 指定 Azure Synapse Analytics 中每個目標欄位的預設值。 屬性中的預設值會覆寫資料倉儲中設定的預設條件約束,而且識別欄位不可有預設值。 | No |
| 其他選項 | 其他選項會直接以「With」子句傳遞至 Azure Synapse Analytics COPY 陳述式中的 COPY 陳述式。 請依需要為值加上引號,以符合 COPY 陳述式需求。 | No |
"activities":[
    {
        "name": "CopyFromAzureBlobToSQLDataWarehouseViaCOPY",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "ParquetDataset",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "AzureSQLDWDataset",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "ParquetSource",
                "storeSettings":{
                    "type": "AzureBlobStorageReadSettings",
                    "recursive": true
                }
            },
            "sink": {
                "type": "SqlDWSink",
                "allowCopyCommand": true,
                "copyCommandSettings": {
                    "defaultValues": [
                        {
                            "columnName": "col_string",
                            "defaultValue": "DefaultStringValue"
                        }
                    ],
                    "additionalOptions": {
                        "MAXERRORS": "10000",
                        "DATEFORMAT": "'ymd'"
                    }
                }
            },
            "enableSkipIncompatibleRow": true
        }
    }
]
使用 COPY 陳述式的預備複製
當你的來源資料原生不相容於 COPY 語句時,可以透過 Azure Blob Storage 或 Azure Data Lake Storage Gen2 的臨時暫存來啟用資料複製(不能使用 Azure 進階儲存體)。 在此情況下,該服務會自動轉換資料,以符合 COPY 陳述式的資料格式需求。 然後它會呼叫 COPY 陳述式,將資料載入 Azure Synapse Analytics。 最後,它會清除儲存體中的暫存資料。 如需透過分段複製資料的詳細資料,請參閱分段複製。
使用此功能時,建立一個
重要
- 當你為預備連結服務使用受管身份驗證時,請分別學習 Azure Blob 和 Azure Data Lake Storage Gen2 所需的設定。 您也需要在預備 Azure Blob 儲存體或 Azure Data Lake Storage Gen2 帳戶中,授與 Azure Synapse Analytics 工作區受控識別權限。 若要了解如何授與此權限,請參閱將權限授與工作區受控識別。
- 如果您的預備 Azure 儲存體 已設定 VNet 服務端點,則必須使用受控識別驗證,並在儲存體帳戶上啟用「允許受信任的 Microsoft 服務」,請參閱使用 VNet 服務端點搭配 Azure 儲存體的影響。
重要
如果你的 Azure 儲存體 是用 Managed Private Endpoint 設定,並且啟用了儲存防火牆,你必須使用管理身份驗證,並賦予 Storage Blob Data Reader 權限給 Synapse SQL Server,以確保它能在 COPY 語句載入時存取已分階段的檔案。
"activities":[
    {
        "name": "CopyFromSQLServerToSQLDataWarehouseViaCOPYstatement",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "SQLServerDataset",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "AzureSQLDWDataset",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SqlSource",
            },
            "sink": {
                "type": "SqlDWSink",
                "allowCopyCommand": true
            },
            "stagingSettings": {
                "linkedServiceName": {
                    "referenceName": "MyStagingStorage",
                    "type": "LinkedServiceReference"
                }
            }
        }
    }
]
使用 PolyBase 將資料載入 Azure Synapse Analytics
使用 PolyBase 是將大量資料載入 Azure Synapse Analytics 且高吞吐量的高效方法。 使用 PolyBase 而不是預設的 BULKINSERT 機制,將可看到輸送量大幅提升。
- 如果你的來源資料是在 Azure Blob 或 Azure Data Lake Storage Gen2,且 格式相容 PolyBase,你可以用複製活動直接呼叫 PolyBase,讓Azure Synapse Analytics從來源抓取資料。 如需詳細資料,請參閱使用 PolyBase 直接複製。
- 如果您的來源資料存放區和格式原本不受 PolyBase 支援,請改用使用 PolyBase 的預備複製功能。 分段複製功能也能提供更高的效能。 它會自動將資料轉換成相容 PolyBase 格式,將資料儲存在 Azure Blob 儲存中,然後呼叫 PolyBase 將資料載入 Azure Synapse Analytics。
提示
深入瞭解使用 PolyBase 的最佳做法。 使用 PolyBase 搭配 Azure Integration Runtime,直接或分階段儲存至 Synapse 的有效 Data Integration Units (DIU) 始終為 2。 調整 DIU 不會影響效能,因為從儲存體載入資料是由 Synapse 引擎所提供。
複製活動中 polyBaseSettings 底下支援下列 PolyBase 設定:
| 屬性 | 描述 | 必要 |
|---|---|---|
| rejectValue | 指定在查詢失敗前可以拒絕的資料列數目或百分比。 想了解更多 PolyBase 的拒絕選項,請參考 CREATE EXTERNAL TABLE (Transact-SQL) 的參數部分。 允許的值為 0 (預設值)、1、2 等其他值。 |
No |
| 拒絕類型 | 指定 rejectValue 選項為常值或百分比。 允許的值為值 (預設值) 和百分比。 |
No |
| 拒絕樣本值 | 決定在 PolyBase 重新計算已拒絕的資料列百分比之前,所要擷取的資料列數目。 允許的值為 1、2 等其他值。 |
是,如果 rejectType 是百分比。 |
| useTypeDefault(使用類型預設) | 指定當 PolyBase 從文字檔擷取資料時,如何處理分隔符號文字檔中遺漏的值。 想了解更多關於此屬性的資訊,請參閱 CREATE EXTERNAL FILE FORMAT (Transact-SQL) 的參數部分。 允許的值為 True 和 False (預設值)。 |
No |
使用 PolyBase 直接複製
Azure Synapse Analytics PolyBase 直接支援 Azure Blob 同 Azure Data Lake Storage Gen2。 如果您的來源資料符合本節所述條件,請使用 PolyBase 直接從來源資料庫複製到 Azure Synapse Analytics。 否則,請使用 PolyBase 進行分段複製。
提示
為了有效地將資料複製到Azure Synapse Analytics,從 Azure Data Factory 學習更多,使用Azure Synapse Analytics 的 資料湖 Store 時,更方便且容易地從數據中發掘洞見。
如果需求不符合,該服務會檢查設定,然後自動回退到用於資料傳輸的 BULKINSERT 機制。
來源連結服務使用下列類型和驗證方法:
支援的來源資料存放區類型 支援的來源驗證類型 Azure Blob 帳戶金鑰驗證、系統指派的受控識別驗證 Azure Data Lake Storage Gen2 帳戶金鑰驗證、系統指派的受控識別驗證 重要
- 當你為儲存連結服務使用管理身份驗證時,請學習
Azure Blob 和 Azure Data Lake Storage Gen2 所需的設定。 - 如果你的Azure 儲存體設定了 VNet 服務端點,必須在儲存帳號啟用「允許可信Microsoft服務」的管理身份驗證,詳見 使用 VNet 服務端點與 Azure storage 的影響。
- 當你為儲存連結服務使用管理身份驗證時,請學習
來源資料格式是 Parquet、ORC 或分隔的文字,並具有下列設定:
- 資料夾路徑不包含萬用字元篩選條件。
- 檔案名稱是空的,或指向單一檔案。 如果您在複製活動中指定萬用字元檔案名稱,則只能是
*或*.*。 -
rowDelimiter是預設值、\n、\r\n 或 \r。 -
nullValue會保留預設值或設定為空字串 (""),而treatEmptyAsNull則保留預設值或設定為 true。 -
encodingName會保留為預設值,或設定為 utf-8。 - 未指定
quoteChar、escapeChar與skipLineCount。 PolyBase 支援略過標頭列,可以設定為firstRowAsHeader。 -
compression可以是不壓縮、GZip或 Deflate。
如果您的來源是資料夾,則複製活動中的
recursive必須設定為 true。wildcardFolderPath、wildcardFilename、modifiedDateTimeStart、modifiedDateTimeEnd、prefix、enablePartitionDiscovery和additionalColumns未指定。
注意
如果您的來源是資料夾,請注意 PolyBase 會從資料夾及其所有子資料夾擷取檔案,而且不會從檔案名稱開頭為底線 (_) 或句號 (.) 的檔案中擷取資料,如這裡 - LOCATION 引數所述。
"activities":[
    {
        "name": "CopyFromAzureBlobToSQLDataWarehouseViaPolyBase",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "ParquetDataset",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "AzureSQLDWDataset",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "ParquetSource",
                "storeSettings":{
                    "type": "AzureBlobStorageReadSettings",
                    "recursive": true
                }
            },
            "sink": {
                "type": "SqlDWSink",
                "allowPolyBase": true
            }
        }
    }
]
使用 PolyBase 階段性複製
當您的來源資料與 PolyBase 不原生相容時,可以透過 Azure Blob 存儲或 Azure Data Lake Storage Gen2 的臨時暫存來啟用資料複製,但不能使用 Azure 進階儲存體。 在此情況下,該服務會自動轉換資料,以符合 PolyBase 的資料格式需求。 接著它會呼叫 PolyBase 將資料載入 Azure Synapse Analytics。 最後,它會清除儲存體中的暫存資料。 如需透過分段複製資料的詳細資料,請參閱分段複製。
使用此功能時,請建立一個
重要
- 當你為預備連結服務使用受管身份驗證時,請分別學習 Azure Blob 和 Azure Data Lake Storage Gen2 所需的設定。 您也需要在預備 Azure Blob 儲存體或 Azure Data Lake Storage Gen2 帳戶中,授與 Azure Synapse Analytics 工作區受控識別權限。 若要了解如何授與此權限,請參閱將權限授與工作區受控識別。
- 如果您的預備 Azure 儲存體 已設定 VNet 服務端點,則必須使用受控識別驗證,並在儲存體帳戶上啟用「允許受信任的 Microsoft 服務」,請參閱使用 VNet 服務端點搭配 Azure 儲存體的影響。
重要
如果你的 Azure 儲存體 是用 Managed Private Endpoint 設定,並且啟用了儲存防火牆,你必須使用 Managed ID 認證,並授權 Storage Blob Data Reader 權限給 Synapse SQL Server,以確保它能在 PolyBase 載入時存取分階段檔案。
"activities":[
    {
        "name": "CopyFromSQLServerToSQLDataWarehouseViaPolyBase",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "SQLServerDataset",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "AzureSQLDWDataset",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SqlSource",
            },
            "sink": {
                "type": "SqlDWSink",
                "allowPolyBase": true
            },
            "enableStaging": true,
            "stagingSettings": {
                "linkedServiceName": {
                    "referenceName": "MyStagingStorage",
                    "type": "LinkedServiceReference"
                }
            }
        }
    }
]
使用 PolyBase 的最佳做法
以下章節提供了除Azure Synapse Analytics 中提到的最佳實務之外的其他最佳實務。
必要的資料庫權限
使用 PolyBase 時,將資料載入 Azure Synapse Analytics 的使用者必須在目標資料庫上擁有 「CONTROL」權限。 達到此目標的其中一個方法是將該使用者新增為 db_owner 角色的成員。 在Azure Synapse Analytics概述中學習如何操作。
資料列大小和資料類型限制
PolyBase 負載的限制為小於 1 MB 的資料列。 不能用來載入至 VARCHR(MAX)、NVARCHAR(MAX) 或 VARBINARY(MAX)。 欲了解更多資訊,請參閱 Azure Synapse Analytics 服務容量限制。
當您來源資料中的資料列大於 1 MB 時,您可能要將來源資料表垂直分割成幾個小的資料表。 務必確認每一列的大小不會超過限制。 這些較小的資料表可透過 PolyBase 載入,並在 Azure Synapse Analytics 中合併。
或者,若資料具有這類寬資料行,您可以關閉「allow PolyBase」設定,改用非 PolyBase 來載入資料。
Azure Synapse Analytics 資源類別
為了達到最佳吞吐量,請為使用者指派一個較大的資源類別,讓使用者透過 PolyBase 將資料載入 Azure Synapse Analytics。
PolyBase, 疑難排解
載入至 Decimal 資料行
如果你的來源資料是文字格式或其他非 PolyBase 相容的儲存(使用分階段複製和 PolyBase),且包含空值,需載入 Azure Synapse Analytics 十進位欄位,你可能會遇到以下錯誤:
ErrorCode=FailedDbOperation, ......HadoopSqlException: Error converting data type VARCHAR to DECIMAL.....Detailed Message=Empty string can't be converted to DECIMAL.....
解決方法是在複製活動接收 - PolyBase 設定中,取消選取「>」選項 (設為 False)。 「USE_TYPE_DEFAULT」是 PolyBase原生設定,會指定當 PolyBase 從文字檔擷取資料時,如何處理分隔符號文字檔中遺漏的值。
檢查 Azure Synapse Analytics 中的 tableName 屬性
下表是如何在 JSON 資料集中指定 tableName 屬性的範例。 其中會顯示數個結構描述和資料表名稱的組合。
| DB 結構描述 | 資料表名稱 | tableName JSON 屬性 |
|---|---|---|
| dbo | MyTable | MyTable 或 dbo.MyTable 或 [dbo].[MyTable] |
| dbo1 | MyTable | dbo1.MyTable 或 [dbo1].[MyTable] |
| dbo | My.Table | [My.Table] 或 [dbo].[My.Table] |
| dbo1 | My.Table | [dbo1].[My.Table] |
如果您看到下列錯誤,可能是您為 tableName 屬性指定的值有問題。 請參閱前面的資料表,以正確的方式指定 tableName JSON 屬性的值。
Type=System.Data.SqlClient.SqlException,Message=Invalid object name 'stg.Account_test'.,Source=.Net SqlClient Data Provider
包含預設值的資料行
PolyBase 功能目前只接受與目標資料表中相同的資料行數目。 範例是內含四個資料行的資料表,且其中一個資料行已使用預設值進行定義。 輸入資料仍需要有四個欄位。 三資料行輸入資料集會產生如下訊息所示的錯誤:
All columns of the table must be specified in the INSERT BULK statement.
NULL 值是一種特殊形式的預設值。 如果資料行可為 Null,則 Blob 中對應該資料行的輸入資料可能為空白。 但輸入資料集中不能缺少它。 PolyBase 在 Azure Synapse Analytics 中插入 NULL 以表示缺失值。
外部檔案存取失敗
若您收到以下錯誤,請確認您使用管理身份驗證,並已授權 Storage Blob 資料讀取器權限給 Azure Synapse 工作空間的管理身份。
Job failed due to reason: at Sink '[SinkName]': shaded.msdataflow.com.microsoft.sqlserver.jdbc.SQLServerException: External file access failed due to internal error: 'Error occurred while accessing HDFS: Java exception raised on call to HdfsBridge_IsDirExist. Java exception message:\r\nHdfsBridge::isDirExist
如需詳細資訊,請參閱在建立工作區之後,授與受控識別權限。
映射資料流屬性
在映射資料流中轉換資料時,你可以從 Azure Synapse Analytics 讀取並寫入資料表。 如需詳細資訊,請參閱對應資料流程中的來源轉換和接收轉換。
來源轉換
針對Azure Synapse Analytics的設定可在來源轉換的 Source Options 標籤中取得。
輸入 選取您是要將來源指向資料表 (相當於 Select * from <table-name>) 或輸入自訂的 SQL 查詢。
Enable Staging強烈建議在使用Azure Synapse Analytics原始碼的生產工作負載中使用此選項。 當您從管線執行使用 Azure Synapse Analytics 來源的資料流程活動時,系統會提示您提供預備位置儲存體帳戶,並將其用於預備資料載入。 它是從 Azure Synapse Analytics 載入資料最快的機制。
- 當你為儲存連結服務使用管理身份驗證時,請學習
Azure Blob 和 Azure Data Lake Storage Gen2 所需的設定。 - 如果你的Azure 儲存體設定了 VNet 服務端點,必須在儲存帳號啟用「允許可信Microsoft服務」的管理身份驗證,詳見 使用 VNet 服務端點與 Azure storage 的影響。
- 當你使用 Azure Synapse serverless SQL 池作為原始碼時,不支援啟用暫存。
查詢:如果您在 [輸入] 欄位中選取 [查詢],請對於來源輸入 SQL 查詢。 此設定會覆寫您在資料集中選擇的任何資料表。 這裡不支援 Order By 子句,但您可以設定完整的 SELECT FROM 陳述式。 您也可使用使用者定義的資料表函數。 select * from udfGetData() 是 SQL 中傳回資料表的 UDF。 此查詢會產生您可以在資料流程中使用的來源資料表。 使用查詢也是縮減資料列以進行測試或查閱的絕佳方式。
SQL 範例:Select * from MyTable where customerId > 1000 and customerId < 2000
批次大小:輸入批次大小,將大型資料分塊進行讀取。 在資料流程中,此設定會用來設定 Spark 資料行快取。 這是選項欄位,如果將其保留空白,則會使用 Spark 預設值。
隔離層級:對應資料流程中 SQL 來源的預設值是讀取未認可。 您可以在這裡將隔離等級變更為下列其中一個值:
- 讀取認可
- 讀取未認可
- 可重複讀取
- 可序列化
- None (忽略隔離等級)

接收轉換
針對Azure Synapse Analytics的設定可在水槽變形的Settings標籤中取得。
Update 方法:決定您的資料庫目的地所允許的作業。 預設僅允許插入。 若要更新、Upsert 或刪除資料列,需要 alter-row 轉換來標記要執行這些動作的資料列。 若要更新、Upsert 和刪除,必須設定一個或多個索引鍵資料行,以決定要變更哪一個資料列。
資料表動作: 決定在寫入之前,是否要重新建立或移除目的地資料表中的所有資料列。
- 無:不會對資料表執行任何操作。
- 重新建立:系統會卸除資料表並重新建立。 如果要動態建立新的資料表,則為必要。
- 截斷:系統將會移除目標資料表中的所有資料列。
啟用預備:這會啟用使用複製命令載入至 Azure Synapse Analytics SQL 集區,且建議大多數 Synapse 接收都使用此方式。 暫存儲存空間的配置為 執行資料流活動。
- 當你為儲存連結服務使用管理身份驗證時,請學習
Azure Blob 和 Azure Data Lake Storage Gen2 所需的設定。 - 如果你的Azure 儲存體設定了 VNet 服務端點,必須在儲存帳號啟用「允許可信Microsoft服務」的管理身份驗證,詳見 使用 VNet 服務端點與 Azure storage 的影響。
批次大小:控制每個貯體中會寫入多少資料列。 較大的批次大小可改善壓縮與記憶體最佳化,但快取資料時有發生記憶體不足例外狀況的風險。
使用接收結構描述:依預設,系統會在接收結構描述下建立暫存資料表,作為預備使用。 或者,您也可以取消勾選「使用匯入結構描述」 選項,並在「選取使用者資料庫結構描述」 中指定一個結構描述名稱,以便 Data Factory 建立中繼表以載入上游資料,並在完成時自動清除它們。 請確定您的資料庫中具有建立資料表的權限,以及改變結構描述的權限。

前置與後置 SQL 指令碼:輸入多行 SQL 指令碼,這些指令碼會在資料寫入接收資料庫之前 (前置處理) 和之後 (後置處理) 執行
截圖顯示在 Azure Synapse Analytics 資料流中進行的 SQL 前處理和後處理腳本。
提示
- 建議將含有多個命令的單一批次指令碼分成多個批次。
- 只有傳回簡單更新計數的資料定義語言 (DDL) 和資料操作語言 (DML) 陳述式可以當作批次的一部份來執行。 若要深入了解,請參閱執行批次作業
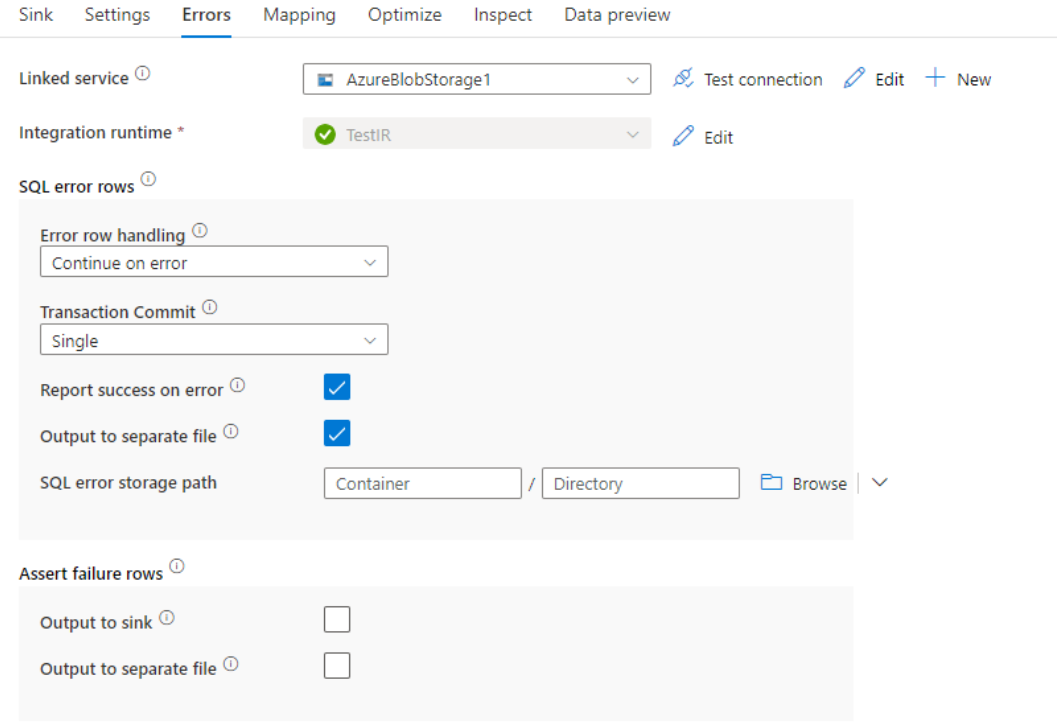
處理資料列時發生錯誤
當寫入 Azure Synapse Analytics 時,某些資料列可能因目的地設定的限制而失敗。 常見錯誤包括:
- 資料表中的字串或二進位資料會遭到截斷
- 無法將 NULL 值插入資料行
- 將值轉換成資料類型時轉換失敗
根據預設,資料流程執行會在它遇到的第一個錯誤時失敗。 您可以選擇 [發生錯誤時繼續],讓您的資料流程即使在個別資料列發生錯誤時也能夠完成。 該服務會提供不同的選項,讓您處理這些錯誤資料列。
交易提交:選擇您的資料是以單一交易寫入還是以批次交易方式寫入。 單一交易可提供較佳的效能,而且在交易完成之前,其他人看不到寫入的資料。 批次交易的效能較差,但可用於大型資料集。
Output rejected data: 如果啟用此功能,你可以將錯誤列輸出成 Azure Blob 儲存體 中的 csv 檔案,或你選擇的 Azure Data Lake Storage Gen2 儲存體。 這會寫入含有三個額外資料行的錯誤資料列:INSERT 或 UPDATE 之類的 SQL 作業、資料流程錯誤碼,以及資料列上的錯誤訊息。
發生錯誤時回報成功:如果啟用,即使找到發生錯誤的資料列,資料流程也會標示為成功。
查閱活動屬性
若要了解屬性的詳細資料,請參閱查詢活動。
GetMetadata 活動屬性
若要了解關於屬性的詳細資料,請參閱 GetMetadata 活動
Azure Synapse Analytics 的數據類型映射
當你從 Azure Synapse Analytics 複製資料時,會使用以下從 Azure Synapse Analytics 資料型別到 Azure Data Factory 臨時資料型別的映射。 這些映射也用於在使用 Synapse 管線時從或向 Azure Synapse Analytics 複製資料,因為在 Azure Synapse 中,這些管線包含了 Azure Data Factory 的功能。 請參閱結構描述和資料類型對應,以便了解 Copy Activity 如何將來源結構描述和資料類型對應至匯集端。
提示
請參考Azure Synapse Analytics中的「Table 資料型態」文章,以了解Azure Synapse Analytics支援的資料型態及對不支援的資料型態的變通方法。
| Azure Synapse Analytics 資料類型 | Data Factory 過渡期資料類型 |
|---|---|
| Bigint | Int64 |
| 二進位 | Byte[] |
| 位元 | 布林值 |
| Char | 字串、字符[] |
| 日期 | 日期時間 |
| 日期與時間 | 日期時間 |
| datetime2 | 日期時間 |
| Datetimeoffset | DateTimeOffset |
| Decimal | Decimal |
| FILESTREAM 屬性(varbinary(max)) | Byte[] |
| 浮點數 | Double |
| 圖片 | Byte[] |
| int(整數) | Int32 |
| 錢 | Decimal |
| NCHAR | 字串、字符[] |
| 數值型 | Decimal |
| Nvarchar | 字串、字符[] |
| real | Single |
| rowversion | Byte[] |
| smalldatetime | 日期時間 |
| SMALLINT | Int16 |
| smallmoney | Decimal |
| 時間 | TimeSpan |
| Tinyint | Byte |
| 唯一識別碼 | Guid |
| varbinary | Byte[] |
| varchar | 字串、字符[] |
升級 Azure Synapse Analytics 版本
要升級 Azure Synapse Analytics 版本,請在編輯連結服務頁面中,選擇Version下的Recommended,並參考推薦版本的連結服務屬性來設定連結服務。
建議的版本與舊版之間的差異
下表顯示 Azure Synapse Analytics 使用推薦版本與舊版版本的差異。
| 建議的版本 | 舊版 |
|---|---|
使用 encrypt 以作為 strict 支援 TLS 1.3。 |
不支援 TLS 1.3。 |
相關內容
如需複製活動支援作為來源和接收器的資料存放區清單,請參閱支援的資料存放區和格式。