本頁說明如何管理無伺服器運算存取,以及如何實作無伺服器速率限制。 工作區管理員透過內建的無伺服器運算物件來管理無伺服器運算。 無伺服器計算物件是一種資源類型,定義無伺服器工作負載的權限邊界。 你的工作區會自動獲得兩個預設的運算物件:
- 預設互動運算:管理對筆記本與 Databricks Connect 的存取。
- 預設自動化運算:管理 Lakeflow 上的工作存取及 Spark 宣告式管線。
預設情況下,所有工作區使用者在兩個物件上都有 「可使用 」,因此現有的工作負載能持續運行,沒有任何變更。 工作區管理員可以從任一物件中移除使用者或群組,以限制存取權限。 失去存取權限的使用者會在產品介面中看到 無伺服器 運算選項顯示為無法使用。
管理無伺服器運算的存取
為了控制誰有權限使用無伺服器運算,工作區管理員可以編輯 預設互動計算 與 預設自動計算 物件的權限。 Workspace 管理員預設有 「可管理 」權限,但他們可以授權任何使用者。 這些預設計算物件無法重新命名或刪除。
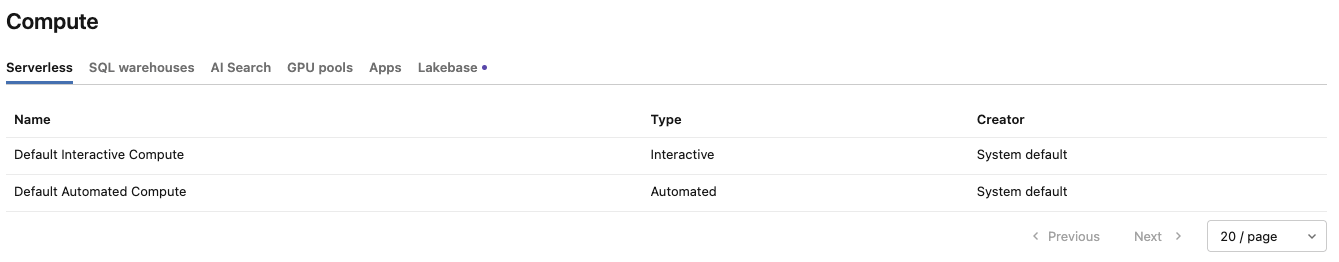
每個無伺服器計算物件支援兩種權限等級:
| 許可 | 可讓您 |
|---|---|
| 可以使用 | 在這份運算上執行工作負載 |
| 可管理 | 在這台運算上執行工作負載並編輯該運算的權限 |
你也可以用 Permissions API 程式化管理無伺服器運算物件的權限。 無伺服器運算物件使用 serverless-compute 物件類型,且每個物件皆以其 ID 識別。
限制對無伺服器互動式功能的存取
要限制誰能用無伺服器管理筆記型電腦和 Databricks Connect:
- 在工作區側欄中按一下 運算。
- 在 Serverless 索引標籤中,按一下位於
 Kebab menu icon.預設互動式計算 旁的 ,然後按一下 編輯權限。
- 移除 所有使用者 群組,或包含所有工作空間使用者的群組。
- 只新增你想授權的特定使用者、群組或服務主體。
如果您撤銷使用者的互動式 Serverless 權限,已連接至 Serverless 的筆記本會在使用者執行儲存格時無法連線,而且使用者也將無法在筆記本的運算選擇器中看到可用的 Serverless 選項。 如果他們嘗試執行 Databricks Connect,連線請求會失敗,錯誤表示使用者無法存取無伺服器。
限制對無伺服器工作與管線的存取
若要限制哪些人可以在工作和管線中使用無伺服器:
- 在工作區側欄中按一下 運算。
- 在 Serverless 索引標籤中,按一下 Kebab menu icon.預設自動化運算 旁的 kebab 選單 ,然後按一下 編輯權限。
- 移除 所有使用者 群組,或包含所有工作空間使用者的群組。
- 只新增你想授權的特定使用者、群組或服務主體。
如果您撤銷使用者對 預設自動化運算 的存取權,則以該使用者身分執行且使用該運算物件的作業和管線將無法執行。 選取自訂自動化運算物件的工作負載,必須具有所選物件的權限。
在你撤銷使用者對 預設自動運算的存取權之前,先審核受影響使用者擁有哪些工作和管線。 以下查詢用以識別特定使用者近期的無伺服器工作負載:
SELECT *
FROM system.billing.usage
WHERE usage_date >= date_add(now(), -30)
  AND billing_origin_product IN ('JOBS', 'DLT')
  AND identity_metadata.run_as = '<user_email>';
請查看 usage_metadata 欄位,查看受影響的資源,例如工作 ID 和管線 ID。
稽核無伺服器用量
無伺服器帳單記錄在 usage_metadata 中包含一個 serverless_compute_id 欄位。 用它來追蹤工作負載運行在哪個運算物件上:
SELECT
  usage_metadata.serverless_compute_id,
  identity_metadata.run_as,
  SUM(usage_quantity) AS total_dbus
FROM system.billing.usage
WHERE billing_origin_product IN ('JOBS', 'DLT', 'INTERACTIVE')
  AND usage_metadata.serverless_compute_id IS NOT NULL
  AND usage_date >= date_add(now(), -30)
GROUP BY 1, 2
ORDER BY 3 DESC;
支援的無伺服器運算存取控制功能
以下功能已整合於無伺服器運算存取控制系統。
互動式(預設互動式運算)
- 筆記簿與 AI 執行階段筆記簿
- Databricks Connect
自動(預設自動運算資源)
- 工作與 AI Runtime 工作
- Lakeflow 上的 Spark 聲明式管道
不支援的無伺服器運算存取控制功能
以下功能未整合於無伺服器運算存取控制系統:
- Databricks SQL (DBSQL)
- 批次推論(
ai_query()) - 模型服務
- 基礎模型 API 的預配置吞吐量端點
- Lakebase
- Databricks 應用程式
- 代理人評估與合成資料
- AI 搜尋索引
- 預測性最佳化
- 資料剖析
- 專用運算上的細粒度存取控制。 對專用運算的存取決定使用者是否可以使用細粒度的存取控制。
若有未列入的功能,請聯絡您的 Azure Databricks 帳戶團隊詢問其狀態。
無伺服器存取控制的限制
Important
若發生服務中斷,存取檢查可能會以開放狀態失敗,導致原本應被拒絕存取的使用者也可能啟動無伺服器工作負載。 此功能旨在協助管理無伺服器運算的存取。 請勿使用此功能來確保最終帳單金額的絕對支出上限。 Azure Databricks 不負責此類事件期間工作負載所產生的成本。
- 你無法重新命名或刪除預設的計算物件。
- 使用 預設自動化運算 的作業與管線需要具有該物件的權限。 在移除使用者存取權限前,先檢視正在進行的工作負載。
- 背景運算(系統啟動的工作)不受無伺服器運算存取控制。
對無伺服器運算設定速率限制
Important
無伺服器速率限制目前仍處於 測試階段。 工作區管理員可在「預覽」頁面中,使用「無伺服器運算速率限制」設定啟用速率限制。
速率限制會控制自動化工作負載的 Spark 執行器可自動擴展的上限。 工作區管理員可以建立自訂的自動化計算物件,並為每個物件指派大小。 當工作負載使用該運算物件時,該大小會設定該工作負載的 Spark 執行器自動調整容量上限。
速率限制僅適用於自動化工作負載(作業與 Lakeflow 管線)。 互動式工作負載(筆記本和 Databricks Connect)沒有速率限制。
A 大小對應到 Spark 執行器的 Databricks 單位(DBU)消耗率。 速率限制並不會對總工作負載成本或最終帳單金額設硬性上限。 它們不會對驅動程式、REPL 虛擬機器、GPU,或具體化檢視和串流資料表的重新整理成本設上限。
速率限制會獨立適用於使用該計算物件的每個工作負載。 使用相同運算物件的兩個工作各自獲得全額上限。 在同一工作中,即使任務在不同叢集執行,該上限也會在無伺服器任務間共享。 運算物件不會對所有使用該物件的工作負載施加整體限制。
速率限制要求
- 要建立無伺服器運算物件,您必須是工作區管理員或擁有不受限制的叢集建立權限。
- 若要編輯自訂運算物件的大小或權限,您必須對該物件具有「可管理」權限。
- 若要在運算物件上執行工作負載,您必須在該物件上設定「可使用」或「可管理」。
建立一個有速率限制的無伺服器運算
- 在工作區側欄中按一下 運算。
- 在 Serverless 標籤中,點選 建立 serverless 運算。
- 輸入名稱。
- 對於 Size ,請選擇適用的速率上限,從 Small 到 2X-Large。 把它設為 預設 ,這樣才能使用你工作區的預設上限。
- 點擊 建立。

新的計算物件會出現在 Serverless 分頁中,並以一種 Automated 類型出現。 先授予使用者對其的存取權限,再讓他們在其上執行工作負載。 你無法編輯預設計算物件的大小。
授予存取速率受限運算資源的權限
- 在 Serverless 索引標籤上,開啟自訂運算資源物件。
- 按一下 動作,然後按一下 編輯權限。
- 新增需要存取權限的使用者、群組或服務主體。
- 授與 「可使用」 以執行工作負載,或授與 「可管理」 也可編輯大小與權限。
- 選取儲存。
變更速率限制
- 在 Serverless 索引標籤上,開啟自訂運算資源物件。
- 按一下 [編輯] 。
- 在 「大小」 中,選擇大小。
- 選取儲存。
速率限制尺寸
以下大小大致對應 Spark 執行器的消耗速率:
| Size | 執行器的大約消耗率 |
|---|---|
| 小 | ~60 DBU 每小時 |
| 中等 | ~120 DBU 每小時 |
| 大型 | 約每小時 240 DBUs |
| X-Large | ~每小時480 DBU |
| 2X-Large | ~960 DBU 每小時 |
這些數值都是估計值。 實際使用量可能超過這些,因為無伺服器基礎設施的變異性以及速率限制無法涵蓋的成本。
選擇 預設 會使用您工作區現有的無伺服器自動化工作負載最大自動擴充容量。 預設值取決於您工作區的層級以及任何特定工作區的限制。
在速率限制的運算上執行一個工作負載
在計算物件上擁有 Can Use 的使用者,可以在設定工作或管線時選擇它。 工作負載則在計算速率限制下執行。 如果工作負載沒有指定計算物件,它會退回到你工作區 的預設自動化運算。 如果使用者無法存取該預設值,工作負載就會無法執行。
- 作業:在作業的 計算 設定中,使用 計算原則 選擇自動化的無伺服器計算物件。 選擇器也可以標示為 無伺服器運算。 清單會顯示作業的 run-as(執行身分)可使用的運算物件。 若要使用 Jobs API 設定工作,請參閱「 使用速率限制運算搭配 Jobs API」。
- 管線:在 Lakeflow 編輯器中選擇自動化計算物件作為管線的無伺服器計算。
當速率限制限制某個工作或管線時,你可以在 Lakeflow UI 中查看其查詢歷史 COMPUTE_SIZE 中的洞察,或針對管線檢視其影響。
在 Jobs API 中使用受速率限制的運算資源
若要使用 Jobs API 在速率有限的運算物件上執行作業,請定義一個工作叢集,並設定 serverless_compute.policy_id 為該運算物件的 ID。 這與作業的運算原則所選取的自動化無伺服器運算物件相同。 然後在作業中的每個無伺服器任務上設定 job_cluster_key 參照該工作叢集。 要複製 ID,在 Serverless 標籤中,針對計算物件,按一下其 ,然後按一下 複製 compute ID。
{
  "job_clusters": [
    {
      "job_cluster_key": "rate_limited",
      "serverless_compute": { "policy_id": "<compute-id>" }
    }
  ],
  "tasks": [
    {
      "task_key": "ingest",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/ingest" }
    },
    {
      "task_key": "transform",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/transform" }
    }
  ]
}
一個工作最多只能定義一個工作叢集,該叢集設定為 serverless_compute。 當您建立、更新、重設或提交工作,以及使用宣告式自動化套件部署工作時,相同的設定同樣適用。 完整請求結構請參閱 REST API 參考中的 建立新工作 。
Note
這個 job_clusters[].serverless_compute_id 欄位已經被棄用了。 請改用 serverless_compute.policy_id。
速率限制
- 速率限制只限制 Spark 執行者的自動擴展。 其他成本元件,如驅動程式、REPL 虛擬機、GPU,以及實體化檢視或串流資料表刷新,則沒有上限。
- 每個尺寸的DBU每小時上限只是估計值。 由於適用限制的波動適度及無伺服器基礎設施的固有變異性,實際使用量可能超過目標。
- 2X-Large 工作負載可能表現低於預期,因為實體叢集大小限制在 256 個執行者。 若在同一個執行階段叢集上排定兩個以上的 2X-Large 工作負載,各自可能無法達到預期效能。
- 由於計費實作上的細節,相同的工作負載在不同的速率限制大小下,可能會有不同的 DBU 用量。
- 你無法對預設的計算物件設定速率限制。