這很重要
dataflow gen2 中的映射資料流轉換目前處於公開預覽階段,可能會有所變動。
dataflow gen2 中的映射資料流程(MDF)轉換功能,讓您能直接在 Microsoft Fabric 的 Data Factory 中撰寫、執行並監控基於 Spark 的資料轉換。
MDF 轉型將 Azure Data Factory 與 Azure Synapse Analytics Mapping Data Flow 的能力,透過熟悉的低程式碼視覺化創作體驗,整合於 Dataflow gen2 中,導入 Microsoft Fabric。
透過MDF轉換,你可以:
- 將現有的 Azure Data Factory 和 Azure Synapse Analytics Mapping Data Flows pipelines 遷移到 Fabric.
- 直接在 Fabric 中創建新的基於 Spark 的轉換。
- 使用 Fabric 資料管線執行 MDF 轉換。
- 利用整合監控體驗監控轉型執行。
- 繼續在 Fabric 中使用熟悉的 Mapping Data Flow 轉換模式。
什麼是映射資料流轉換?
MDF 轉換為第二代資料流擴充了由 Spark 驅動的轉換功能,用於大規模資料準備與轉換工作負載。
MDF 轉換可提供:
- 低程式碼視覺創作體驗
- 以 Spark 為基礎的執行
- 透過 Fabric 管線進行整合式編排
- 直接在 Fabric 中監控與執行洞察
利用 MDF 轉換來:
- 將現有的 Azure Data Factory 或 Azure Synapse Analytics Mapping Data Flows pipelines 遷移到 Fabric.
- 在 Fabric 中原生建構新的基於 Spark 的轉型管線。
MDF 轉換與 dataflow gen2 完全整合,並提供類似 Azure Data Factory 與 Azure Synapse Analytics Mapping Data Flows 的熟悉撰寫體驗。

支援劇本
MDF 轉換目前支援以下情境。
遷移現有的地圖資料流
你可以利用 Azure Data Factory/Synapse Analytics 內建的遷移體驗,將現有的 Azure Data Factory 和 Azure Synapse Analytics Mapping Data Flow 遷移到 Fabric。

遷徙期間:
- 在 dataflow gen2 中,Mapping Data Flows 會轉換為 MDF 轉換。
- 管線與轉換邏輯會一起遷移。
- MDF 轉換會在 dataflow gen2 的內嵌轉換畫布中開啟。
- 現有的轉換邏輯可以持續在 Fabric 中被撰寫、驗證、執行與監控。
在 Fabric 中建立新的映射資料流程轉換
你也可以直接在 dataflow gen2 中建立新的 MDF 轉換。 這段經驗能讓你:
- 利用視覺介面建構基於 Spark 的轉換。
- 使用熟悉的 Mapping Data Flow 轉換功能。
- 使用 Fabric 資料管線執行轉換。
- 透過整合式監控介面監視執行情況。
本影片示範如何在 Microsoft Fabric Dataflow Gen2 中建置、預覽、執行及監控 Mapping Data Flow 轉換。
先決條件
在 dataflow gen2 中使用 MDF 轉換前,請確保以下先決條件已達成:
- 一個 Fabric 容量。
- Fabric 工作區的「參與者」或更高權限。
- 支援資料來源的現有 Fabric 連線。
- (可選)如果你使用遷移場景,請考慮現有的 Azure Data Factory 或 Azure Synapse Analytics 工作空間。
Limitations
以下功能目前未在公開預覽版中支援:
| 適用範圍 | 限度 |
|---|---|
| Flowlets | 不支援。 |
| Data Flow 函式庫 | 不支援。 |
| 使用者定義函數(UDF) | 不支援。 |
| 資料流執行 | MDF 轉換只能透過管線資料流活動執行。 目前不支援從 dataflow gen2 直接執行。 只有 存檔 動作能從 「儲存與執行 」選單中使用。 |
| 受控虛擬網路 | 此預覽版本不支援受控虛擬網路 (Managed VNet)。 |
| 執行時執行 | MDF 轉換執行目前使用基礎的 Synapse Spark 執行階段,這與 Azure Data Factory 和 Azure Synapse Analytics 的對應資料流程類似。 |
| 功能一致性 | 此預覽版並非所有 Mapping Data Flow 功能皆可用。 |
支援的連接器
MDF 轉換支援最常用的來源與匯連接器,這些連接器可在 Azure Data Factory 及 Azure Synapse Analytics Mapping Data Flows 中提供。
目前支援的連接器如下:
| 類別 | 資料存放區 | MDF 在 dataflow gen2(來源/匯)中進行轉換 | 支援的認證類型 |
|---|---|---|---|
| Azure | Azure Blob 儲存體 | ✓/✓ | 基本帳號、組織帳號、管理身份/工作區身份、服務主體 |
| Azure Cosmos DB for NoSQL | ✓/✓ | 基本、組織帳號 | |
| Azure Data Explorer | ✓/✓ | 組織帳號,管理身份 / 工作區身份 | |
| Azure Data Lake Storage Gen1 | ✓/✓ | 基本、受管理身份/工作區身份、服務主體 | |
| Azure Data Lake Storage Gen2 | ✓/✓ | 基本帳號、組織帳號、管理身份/工作區身份、服務主體 | |
| 適用於 MySQL 的 Azure 資料庫 | ✓/✓ | 基本 | |
| 適用於 PostgreSQL 的 Azure 資料庫 | ✓/✓ | 基本 | |
| Azure Databricks Delta Lake | ✓/✓ 使用差異格式 | 基本 | |
| Azure SQL Database | ✓/✓ | 基本帳號、組織帳號、管理身份/工作區身份、服務主體 | |
| Azure SQL 受控執行個體 | ✓/✓ | 基本帳號、組織帳號、管理身份/工作區身份、服務主體 | |
| Azure Synapse Analytics | ✓/✓ | 基本、組織帳號 | |
| Database | Snowflake | ✓/✓ | 基本 |
| 檔案 | Amazon S3 | ✓/✓ | 基本 |
| SFTP | ✓/✓ | 基本 | |
| 泛型 REST | ✓/✓ | 基礎、組織帳戶、服務負責人 | |
| Microsoft Fabric | Fabric湖倉 | ✓/✓ | 組織帳戶 |
| 布料倉庫 | ✓/✓ | 組織帳戶 |
Note
組織帳號驗證使用已登入使用者的 Microsoft Entra 組織身份。 可用性可能取決於連接器、閘道設定以及該身份所獲得的權限。
撰寫過程中:
- 現有的 Fabric 連接可重複使用。
- 可透過 Get Data 體驗,直接從創作體驗建立新連結。
- 來源與接收端的設定遵循常見的 Mapping Data Flow 模式。
支援的轉換
MDF 轉換提供了熟悉的低程式碼視覺化轉換體驗,用於在 Fabric 中建構可擴展的基於 Spark 的資料轉換管線。
目前支援以下轉換:
| Name | 類別 | Description |
|---|---|---|
| Aggregate | 架構修飾器 | 定義如 SUM、MIN、MAX 和 COUNT 等彙總,並依現有或計算出的欄位分組。 |
| 變更資料列 | 資料列修飾元 | 在資料列上設定插入、刪除、更新和更新插入原則。 |
| Assert | 資料列修飾元 | 為資料串流中的列定義斷言規則。 |
| Cast | 架構修飾器 | 使用類型檢查來變更資料行資料類型。 |
| 條件式分割 | 多重輸入/輸出 | 根據匹配條件將資料列導向不同的串流。 |
| 衍生的資料行 | 架構修飾器 | 使用表達式產生新欄位或修改現有欄位。 |
| 外部呼叫 | 架構修飾器 | 針對每一列內聯呼叫外部端點。 |
| Exists | 多重輸入/輸出 | 檢查資料是否存在於其他來源或串流中。 |
| 篩選 | 資料列修飾元 | 根據條件篩選列。 |
| Flatten | 格式器 | 將階層結構如 JSON 陣列扁平化成列。 |
| 加入 | 多重輸入/輸出 | 結合兩個來源或資料流中的資料。 |
| Lookup | 多重輸入/輸出 | 參考來自其他來源或資料流的資料。 |
| 新增分支 | 多重輸入/輸出 | 在同一條流上套用多條轉換路徑。 |
| Parse | 格式器 | 解析 JSON、分隔文字或 XML 格式字串。 |
| Pivot | 架構修飾器 | 將不同的列值轉換成欄位。 |
| Rank | 架構修飾器 | 根據排序條件產生排序順序。 |
| Select | 架構修飾器 | 重新命名、重新排序或移除欄位。 |
| Sink | - | 定義轉換後資料的目的地。 |
| Sort | 資料列修飾元 | 在目前的資料串流中排序資料列。 |
| Source | - | 定義資料流的來源。 |
| Stringify | 格式器 | 將複雜型態轉換成字串值。 |
| 代理鍵 | 架構修飾器 | 產生遞增的替代鍵值。 |
| Union | 多重輸入/輸出 | 垂直結合多個數據流。 |
| Unpivot | 架構修飾器 | 將欄位轉換成列值。 |
| Window | 架構修飾器 | 定義基於視窗的資料串流聚合。 |
在 dataflow gen2 中建立映射資料流轉換
若要在 Fabric 中建立新的 MDF 轉換:
開啟您的 Fabric 工作區。
選擇 新增專案。
選擇 Dataflow Gen2。
為資料流 gen2 項目設定名稱,並選擇 「建立」。
在資料流程 Gen2 畫布中,使用下列其中一個選項:
- 在 dataflow gen2 主功能區中,從新動作分組中選擇執行「執行映射資料流轉換」。
- 從畫布中選擇 執行映射資料流轉換(ADF 映射資料流) 圖塊。


新的 MDF 轉換動作會出現在 dataflow gen2 畫布上,並開啟嵌入的 MDF 轉換創作體驗。
Tip
MDF 轉換創作體驗使用類似 Azure Data Factory 和 Azure Synapse Analytics Mapping Data Flows 的熟悉視覺介面。
作者映射資料流程轉換
建立 MDF 轉換後,就可以開始撰寫轉換邏輯。
啟用除錯模式
用於互動式編寫與資料預覽:
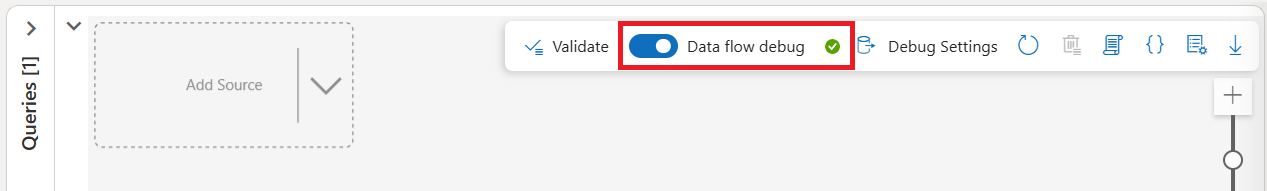
- 從浮動工具列開啟 資料流程除錯 開關。
- 等待除錯會話初始化。
- 啟用後,你可以在撰寫時預覽原始碼和轉換資料。
Note
在開始資料流程除錯會話前,請確保至少有一個管線與資料流 Gen2 項目存在於同一工作區。 否則,除錯工作階段將無法啟動。 除錯會話的初始化可能需要數分鐘,視 Spark 執行時的可用性而定。
新增來源
要設定來源:
- 選擇 新增來源。
- 選擇連線類型。
- 選擇現有的 Fabric 連線,或如有需要,直接透過 Get Data 體驗建立新連線。
- 瀏覽並選擇來源檔案、表格或資料集。

設定好原始資料連結與資料集後,使用 資料預覽 標籤,在互動式創作中驗證並預覽原始資料。

新增變換
若要新增轉換:
- 選擇來源或轉換旁邊的 + 圖示。
- 選擇變換類型。
- 設定變形設定。
你可以繼續使用視覺化轉換畫布來建構轉換邏輯。

設定接收器
轉換邏輯完成後:
- 新增接收轉換。
- 設定目的地連線。
- 配置寫入設定。

驗證並儲存
執行前:
從 MDF 變換工具列選擇 「驗證 」。

如果有驗證問題被報告,請立即解決。
從「儲存與執行」選單中選擇「儲存」。


Note
目前對於處於公開預覽的含 MDF 轉換 Dataflow Gen2,僅支援 儲存 動作。
使用 Fabric 管線執行映射資料流程轉換
您可透過 Fabric 資料管線中的資料流活動來執行 MDF 轉換。
若要執行 MDF 轉換:
- 建立新的 Fabric 管線。
- 在管線中新增 一個資料流 活動。
- 在活動的 設定 中,選取包含 MDF 轉換的資料流 Gen2 項目。
- 選擇 MDF 轉換查詢來執行。
- 根據需要設定 Spark 執行時設定。
- 驗證並發布流程。
- 手動執行管線,或設定排程或觸發條件。

設定 Spark 執行時設定
MDF 轉換會使用與 Microsoft Fabric 中的 Data Factory 整合的受控 Spark 執行階段來執行。 您可以在管線執行時設定 Spark 執行時設定,包括:
- 計算大小調整
- 接收屬性

監視映射資料流轉換的執行情況
您可以透過以下方式監控 MDF 轉換的執行:
管線輸出窗格

監測中心


查看監測細節:
- 打開管線運行細節。
- 從 活動執行 中選取資料流活動。
- 檢視執行狀態與執行時細節。
