適用於: Linux 上的 SQL Server
本文說明如何在 Linux 上操作 SQL Server 故障轉移叢集實例(FCI)。 要在 Linux 上建立 SQL Server FCI,請參見「在 Linux 上配置故障轉移叢集實例(RHEL)」。
架構描述
叢集層以建構於 Pacemaker 之上的 Red Hat Enterprise Linux(RHEL)HA 附加元件為基礎。 Corosync 和 Pacemaker 協調叢集通訊和資源管理。 SQL Server 實例一次只在一個節點上啟用。
下圖說明了使用 SQL Server 的 Linux 叢集中的元件。
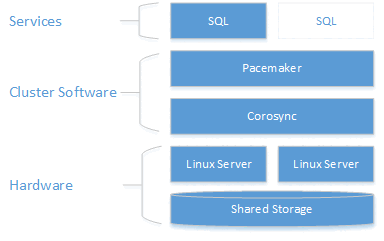
欲了解更多關於叢集配置、資源代理選項及管理的資訊,請造訪 RHEL 參考文件。
Failover
FCI 容錯移轉類似於 Windows Server 容錯移轉叢集 (WSFC)。 如果負責 FCI 的叢集節點發生故障,FCI 應自動轉移到其他節點。 不同於 WSFC,您無法設定慣用的擁有者,因此由 Pacemaker 挑選的節點會成為 FCI 新主機。
有時你可能會想手動將 FCI 故障轉移到另一個節點。 此程序與 WSFC 上的 FCI 不同。 在 WSFC 上,您會在角色層級對資源進行容錯移轉。 在 Pacemaker 中,你選擇要移動的資源,如果所有限制都正確,其他資源也會一起移動。
故障切換的方式視 Linux 發行版而定。 請依照你 Linux 發行版的說明操作。
手動故障轉移(RHEL 或 Ubuntu)
若要執行手動容錯移轉,請在 Red Hat Enterprise Linux (RHEL) 或 Ubuntu 伺服器上執行下列步驟。
發出下列命令:
sudo pcs resource move <FCIResourceName> <NewHostNode><FCIResourceName>是 SQL Server FCI 的 Pacemaker 資源名稱,而<NewHostNode>則是你想用來承載 FCI 的叢集節點名稱。手動故障轉移期間,Pacemaker 會在選擇手動移動的資源上建立位置約束。 若要查看此限制式,請執行
sudo pcs constraint。故障轉移完成後,移除以下約束:
sudo pcs resource clear <FCIResourceName>
手動容錯移轉(SLES)
Note
從 SQL Server 2025(17.x)開始,SUSE Linux Enterprise Server(SLES)不再支援。 針對 SQL Server 2022(16.x)及更早版本,僅支援 SLES 15。
在 SUSE Linux Enterprise Server (SLES) 中,使用 migrate 命令手動容錯移轉至 SQL Server FCI。 例如:
crm resource migrate <FCIResourceName> <NewHostNode>
<FCIResourceName> 是故障轉移叢集實例的資源名稱,是 <NewHostNode> 新的目的地主機名稱。
監控一個故障轉移叢集
檢視目前的叢集狀態:
sudo pcs status
查看叢集及資源的即時狀態:
sudo crm_mon
在 /var/log/cluster/corosync.log 查看資源代理程式日誌。
將節點新增至叢集
檢查每個節點的 IP 位址。 下列指令碼會顯示您目前節點的 IP 位址。
ip addr show新節點需要一個不超過 15 字元的唯一名稱。 在
/etc/hosts中設定電腦名稱。 下列指令碼可讓您使用/etc/hosts編輯vi。sudo vi /etc/hosts下列範例顯示
/etc/hosts,其中包含三個名為sqlfcivm1、sqlfcivm2和sqlfcivm3之節點的新增。127.0.0.1 localhost localhost4 localhost4.localdomain4 ::1 localhost localhost6 localhost6.localdomain6 10.128.18.128 sqlfcivm1 10.128.16.77 sqlfcivm2 10.128.14.26 sqlfcivm3每個節點上的檔案應該都相同。
停止新節點上的 SQL Server 服務。
依照指示將資料庫檔案目錄掛載到共享位置。
從 NFS 伺服器安裝
nfs-utils:sudo yum -y install nfs-utils在用戶端和 NFS 伺服器上開啟防火牆:
sudo firewall-cmd --permanent --add-service=nfs
sudo firewall-cmd --permanent --add-service=mountd
sudo firewall-cmd --permanent --add-service=rpc-bind
sudo firewall-cmd --reload
編輯
/etc/fstab檔案以包含裝載命令:<IP OF NFS SERVER>:<shared_storage_path> <database_files_directory_path> nfs timeo=14,intr執行
mount -a讓變更生效。在新的節點上,建立檔案以儲存 SQL Server 使用者名稱和密碼,以供 Pacemaker 登入使用。 下列命令會建立並填入這個檔案:
sudo touch /var/opt/mssql/secrets/passwd
echo "<loginName>" | sudo tee -a /var/opt/mssql/secrets/passwd
echo "<password>" | sudo tee -a /var/opt/mssql/secrets/passwd
sudo chown root:root /var/opt/mssql/secrets/passwd
sudo chmod 600 /var/opt/mssql/secrets/passwd
注意事項
您的密碼應遵循 SQL Server 預設 密碼原則。 根據預設,密碼長度必須至少為8個字元,且包含下列四個集合中的三個字元:大寫字母、小寫字母、基底10位數和符號。 密碼長度最多可達 128 個字元。 盡可能使用長且複雜的密碼。
在新的節點上,開啟 Pacemaker 防火牆連接埠。 若要使用
firewalld開啟這些連接埠,請執行下列命令:sudo firewall-cmd --permanent --add-service=high-availability sudo firewall-cmd --reload如果你使用的是沒有內建高可用性設定的防火牆,請開啟以下埠口讓 Pacemaker 與叢集內其他節點通訊:
- TCP:連接埠 2224、3121、21064
- UDP:連接埠 5405
在新節點上安裝 Pacemaker 套件。
sudo yum install pacemaker pcs fence-agents-all resource-agents設定安裝 Pacemaker 和 Corosync 封裝時建立的預設使用者密碼。 使用與現有節點相同的密碼。
sudo passwd hacluster啟用
pcsd服務並啟動心跳管理器服務。 新節點在重啟後可以重新加入叢集。 在新的節點上執行下列命令。sudo systemctl enable pcsd sudo systemctl start pcsd sudo systemctl enable pacemaker sudo systemctl start pacemaker安裝 SQL Server 的 FCI 資源代理程式。 在新的節點上執行下列命令。
sudo yum install mssql-server-ha在叢集中已有的節點上,驗證新節點並將其加入叢集:
sudo pcs cluster auth <nodeName3> -u hacluster
sudo pcs cluster node add <nodeName3>
從叢集中移除節點
若要移除叢集的節點,請執行下列命令:
sudo pcs cluster node remove <nodeName>
更改資源監控頻率
sudo pcs resource op monitor interval=<interval>s <sqlResourceName>
以下範例將資源的監控間隔設為 2 秒 mssqlha :
sudo pcs resource op monitor interval=2s mssqlha
Troubleshoot
當您進行叢集疑難排解時,了解三個守護程式如何協同運作以管理叢集資源是很有幫助的。
| Daemon | Description |
|---|---|
| Corosync | 提供叢集節點之間的仲裁成員資格和訊息傳遞。 |
| 心律調節器 | 位於 Corosync 頂端,並針對資源提供狀態機器。 |
| PCSD | 透過 pcs 工具管理 Pacemaker 和 Corosync。 |
必須執行 PCSD 才能使用 pcs 工具。
目前的叢集狀態
sudo pcs status 會傳回有關叢集、仲裁、節點、資源以及每個節點的背景程式狀態的基本資訊。
以下範例顯示健康的 Pacemaker 法定人數輸出:
Cluster name: MyAppSQL
Last updated: Thu Oct 31 12:00:00 2024  Last change: Thu Oct 31 11:00:00 2024 by root via crm_resource on sqlvmnode1
Stack: corosync
Current DC: sqlvmnode1  (version 1.1.13-10.el7_2.4-44eb2dd) - partition with quorum
3 nodes and 1 resource configured

Online: [ sqlvmnode1 sqlvmnode2 sqlvmnode3 ]

Full list of resources:

mssqlha (ocf::sql:fci): Started sqlvmnode1

PCSD Status:
sqlvmnode1: Online
sqlvmnode2: Online
sqlvmnode3: Online

Daemon Status:
corosync: active/disabled
pacemaker: active/enabled
在此例中,表示 partition with quorum 節點的多數法定人數已在線。 如果叢集失去多數節點的仲裁,則 pcs status 會傳回 partition WITHOUT quorum,而且所有資源都會停止。
Online: [sqlvmnode1 sqlvmnode2 sqlvmnode3] 會傳回目前參與叢集的所有節點名稱。 如果沒有任何節點參與,則 pcs status 會傳回 OFFLINE: [<nodename>]。
PCSD Status 顯示每個節點的叢集狀態。
節點可能處於離線狀態的原因
當節點離線時,請檢查下列項目。
防火牆
在所有節點上開啟以下埠口,讓 Pacemaker 能通訊:
- TCP:連接埠 2224、3121、21064
- UDP:連接埠 5405
Pacemaker 或 Corosync 服務正在執行
節點通訊
節點名稱對應