個人資料
在清理或轉換資料之前,你需要先了解資料表裡的內容。 資料分析 是指檢視你的資料集,產生摘要統計數據——包括計數、平均值、價值分布和零百分比——以揭示資料的品質與結構。 此基礎功能可協助您在問題影響下游之前,識別遺漏值、離群值以及非預期的模式。
在這個單元中,你會學習如何使用 SQL 指令產生統計摘要,以及 Azure Databricks 中的資料剖析功能。
使用 SQL 產生摘要統計
Azure Databricks 提供 SQL 指令,可以收集並顯示關於你資料表的統計資料。 這些統計數據幫助查詢優化器選擇有效率的執行計畫,並讓您洞察資料的特性。
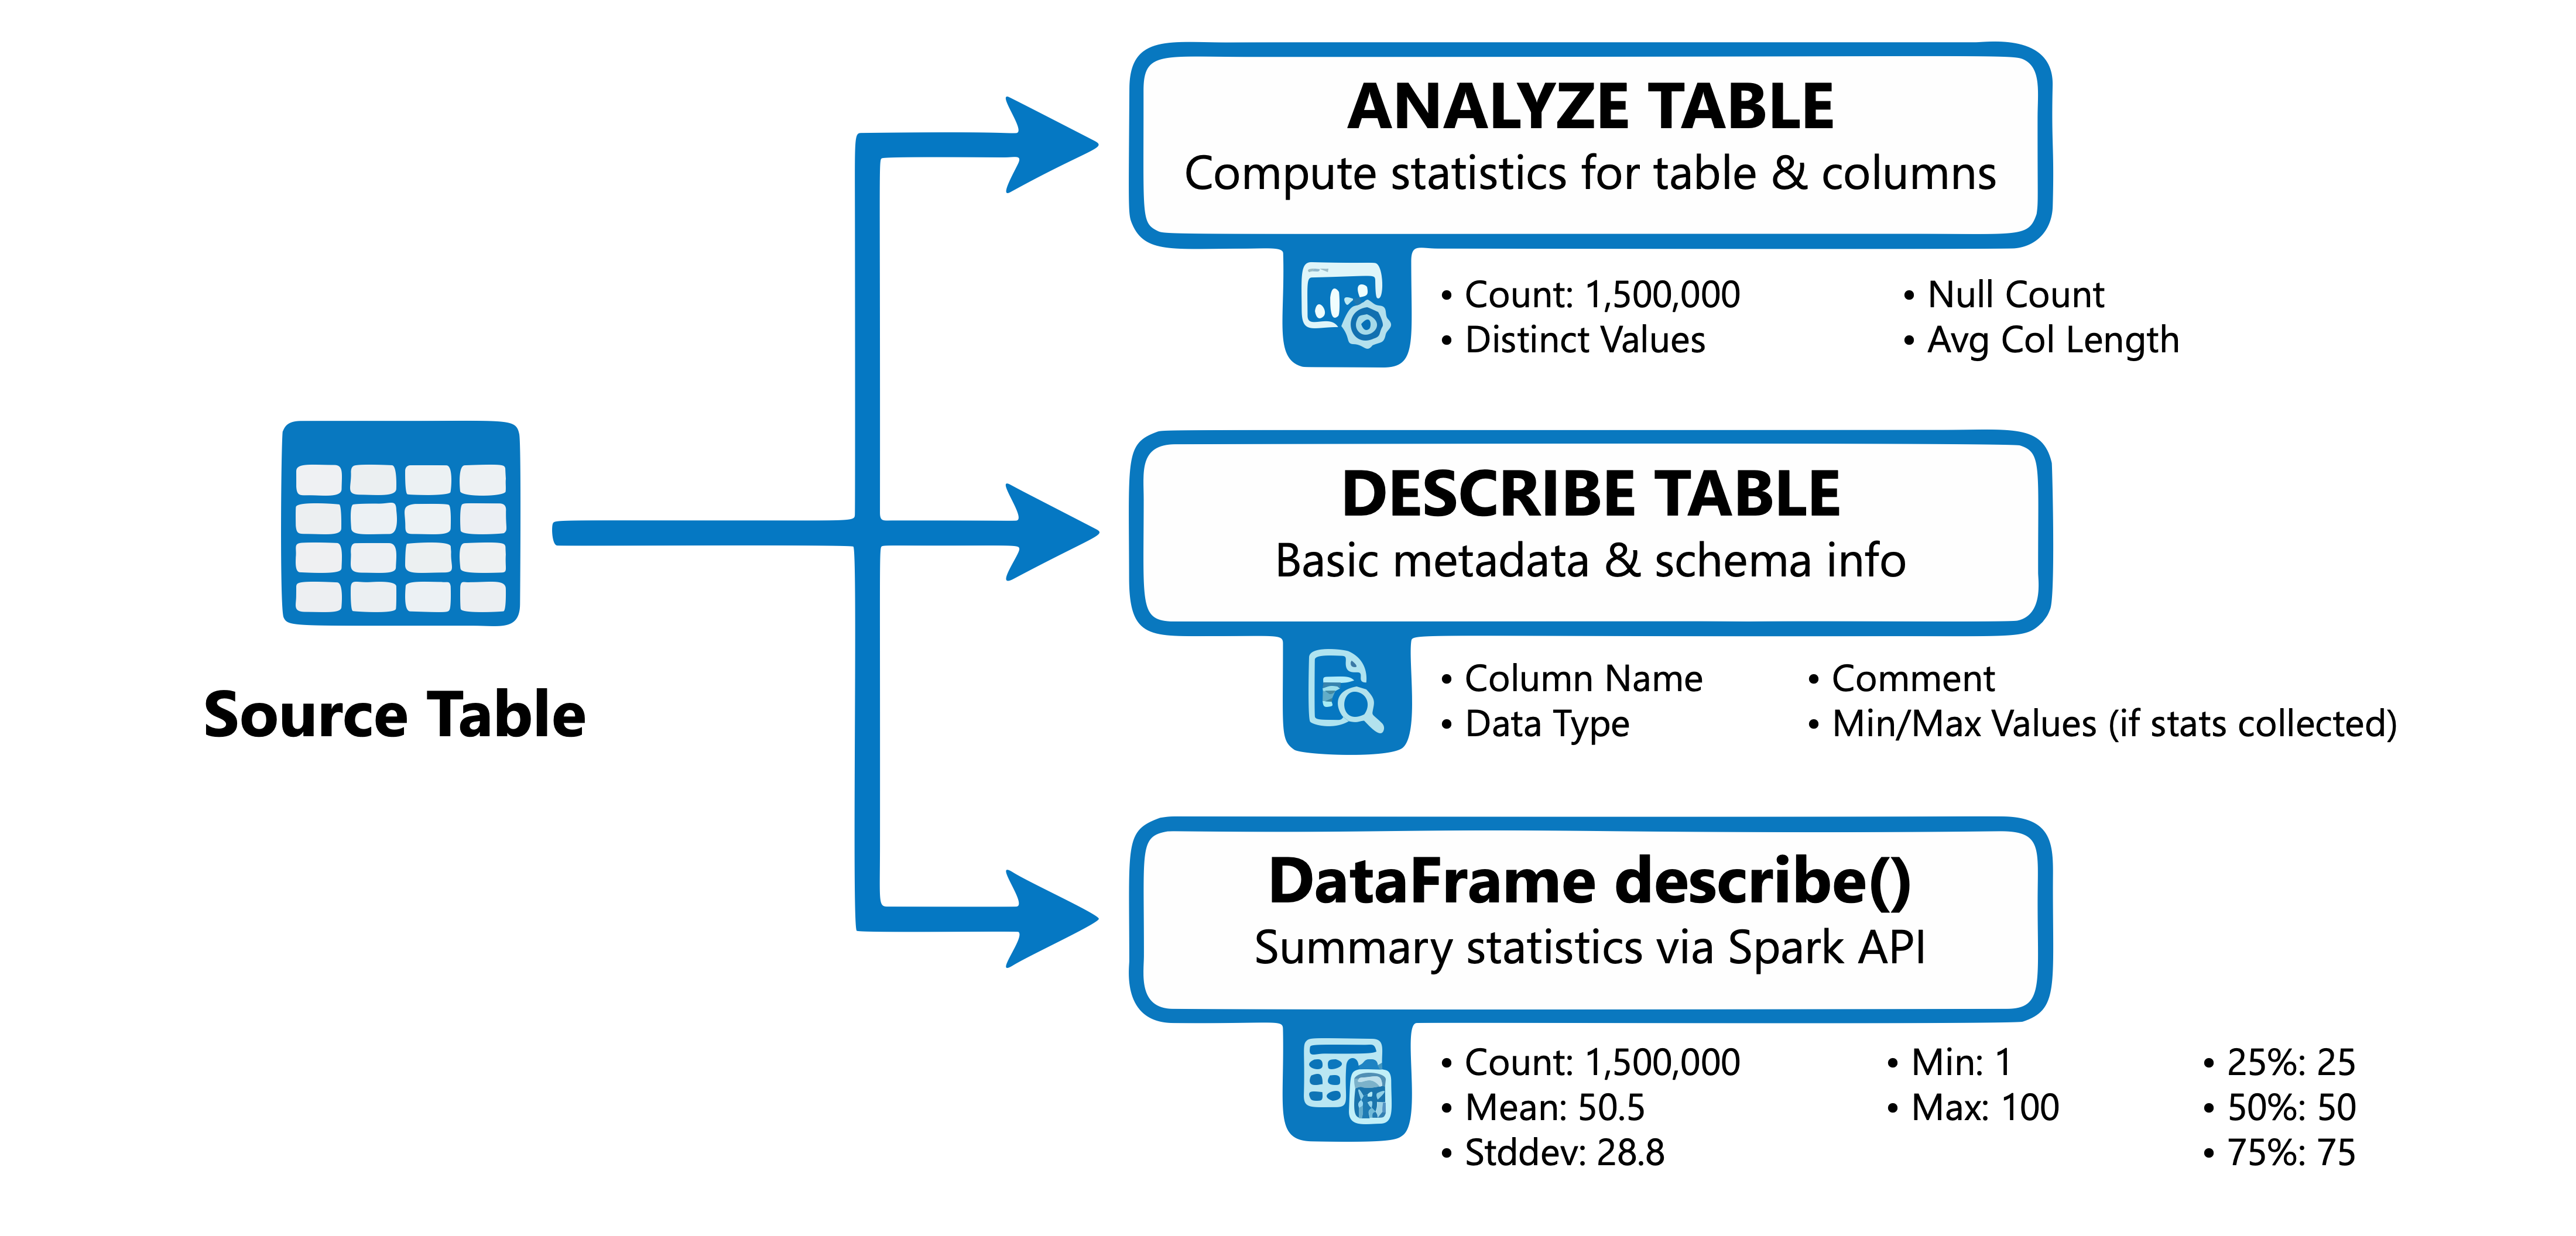
使用 ANALYZE TABLE 收集統計資料
此 ANALYZE TABLE 指令用於計算表格或特定欄位的統計數據。 這些統計資料包括列數、欄位層級的指標(如最小值與最大值)、空計數,以及不同的值計數。
-- Collect basic table statistics (row count and size)
ANALYZE TABLE sales.transactions COMPUTE STATISTICS;

-- Collect statistics for specific columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR COLUMNS
    transaction_id, amount, customer_id;

-- Collect statistics for all columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR ALL COLUMNS;
當你分析特定欄位時,你會得到詳細的指標:
-- View column-level statistics
DESC EXTENDED sales.transactions amount;
這會返回包括最小值、最大值、空值數、不同項目數量、平均欄位長度及最大欄位長度等指標。
使用描述表格查看統計資料
DESCRIBE TABLE EXTENDED 指令顯示收集的統計數據以及表格的中繼資料:
DESCRIBE TABLE EXTENDED sales.transactions;
你也可以使用 PySpark 來取得表格的元資料並產生摘要統計:
# Generate summary statistics for numeric columns using the DataFrame API
df = spark.table("sales.transactions")
df.describe().show()
該 describe() 方法會回傳數值、平均值、標準差、最小值和最大值,針對數值欄位。
輸出顯示資料表的大小(以位元組和列數計),確認已完成剖析。 對於 Unity Catalog 管理的資料表,預測優化會自動執行 ANALYZE 以保持統計數據的即時性。
小提示
在大量資料載入或重大變更後執行 ANALYZE TABLE ,以確保查詢優化器擁有準確的統計數據,以規劃有效率的查詢。
在 Unity 目錄系統中使用資料剖析
除了 SQL 指令外,Azure Databricks 還在 Unity Catalog 中提供 資料品質監控 ——這是一個涵蓋兩大功能的完整範圍:
- 異常偵測 會自動監控結構中的所有資料表。 它分析歷史模式,以評估每張資料表的更新度(更新時間)及完整性(是否達到預期列數)。 你只需在目錄檔案總管的結構層啟用一次,Azure Databricks 會用智慧掃描來處理剩下的部分。 使用異常偵測,在所有資料表中進行廣泛且自動化的覆蓋,無需每張表設定。
- 資料剖析 提供深入的每表統計分析——追蹤分布、零百分比、漂移指標及模型隨時間的表現。 你可以為每個資料表單獨設定。 針對需要詳細歷史趨勢的最關鍵表格,請使用資料剖析。
在專注於淨化與品質的資料工程工作中,你會同時使用兩者:異常偵測作為所有資料表的早期警示系統,以及用於深入監控關鍵資料表的資料剖析。

了解配置檔類型
資料剖析支援三種分析類型,每種都適用於不同情境:
| 設定檔類型 | 用例 | 主要特性 |
|---|---|---|
| Snapshot | 通用表格 | 每次刷新時會計算整個資料表的指標 |
| 時間序列 | 帶有時間戳記欄位的資料表 | 跨時間窗口追蹤指標以偵測趨勢 |
| 推論 | 機器學習模型推論表 | 監控模型輸入、預測及準確度隨時間變化 |
對於專注於資料品質的資料工程任務,快照與時間序列剖面最為相關。
用介面建立個人檔案
若要在目錄總管中建立設定檔:
- 在目錄總管中瀏覽至您的資料表。
- 選擇 品質 標籤。
- 若結構 未 啟用異常偵測,請選擇 啟用。 如果異常偵測已經啟用,請選擇 配置。
- 在 資料品質監控 對話框中,資料 剖析 欄位中選擇 「配置」。
- 選擇你的配置類型,並設定選項,例如細緻度和排程。
該剖面產生兩個指標表:一個包含摘要統計量的剖面指標表,以及追蹤分布變化的漂移指標表。
使用 API 建立個人檔案
程式存取方面,請使用 Databricks SDK。 安裝或升級 SDK 以取得目前的 API:
%pip install "databricks-sdk>=0.68.0"
接著為資料表建立快照設定檔:
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.dataquality import Monitor, DataProfilingConfig, SnapshotConfig

w = WorkspaceClient()

# Retrieve the table ID and schema ID required by the API
table = w.tables.get(full_name="main.sales.transactions")
schema = w.schemas.get(full_name="main.sales")

w.data_quality.create_monitor(
    monitor=Monitor(
        object_type="table",
        object_id=table.table_id,
        data_profiling_config=DataProfilingConfig(
            output_schema_id=schema.schema_id,
            assets_dir="/Workspace/Users/user@example.com/monitoring",
            snapshot=SnapshotConfig()
        )
    )
)
要更新個人資料並更新指標:
from databricks.sdk.service.dataquality import Refresh

w.data_quality.create_refresh(
    object_type="table",
    object_id=table.table_id,
    refresh=Refresh(object_type="table", object_id=table.table_id)
)
解讀剖析結果
剖析產生的指標有助於評估資料品質並識別需要關注的問題。
需要檢視的關鍵指標
資料指標表包括每欄的統計數據:
| 計量 | 它揭示了什麼 |
|---|---|
count 和 num_nulls |
資料完整性:高 Null 百分比可能表示資料擷取問題 |
distinct_count |
基數——意外值可能暗示資料品質問題 |
min、max、avg、stddev |
分布特性—離群值或偏斜分布 |
frequent_items |
最常見的值——有助於辨識主導類別或重複值 |
quantiles |
值分布——對偵測偏態非常有用 |
偵測資料品質問題
在檢視分析結果時,請注意以下常見指標:
- 高 Null 百分比在應該具有值的資料行中
- 非預期的相異計數,例如本應唯一但實際上不唯一的唯一識別碼
- 超出預期界限的值範圍,例如僅允許正值卻出現負數的金額
- 分布隨時間變化,可能顯示資料漂移
漂移計量資料表會針對數值資料行計算 Kolmogorov-Smirnov (KS) 檢定,並針對類別資料行計算卡方檢定。 這些檢定量化了分布變化的程度。
了解這些模式有助於你設計適當的資料管線清潔與驗證規則。