選擇資料擷取工具
小提示
有關更多詳細信息,請參閱 文本和圖像 選項卡!
當你在 Azure Databricks 設計資料管線時,選擇合適的資料擷取工具會直接影響管線的可靠性、維護工作量及長期成本。 每個工具針對不同的情境、資料來源及營運需求進行調整。 了解這些差異,有助於你做出符合組織需求的明智決策。
了解資料引入工具的概況
Azure Databricks 提供多種擷取選項,涵蓋從全託管服務到高度客製化框架的廣泛範圍。 你選擇的工具取決於資料來源類型、延遲需求,以及你對擷取過程的控制程度。

在管理最完善的層面上,Lakeflow Connect 會為企業應用程式和資料庫提供周全的連接器。 這些連接器能自動處理認證、變更追蹤、錯誤復原及結構演化。 在可自訂的層面, Spark 結構化串流 讓你完全掌控資料如何透過管線流動,雖然需要更多的開發與維護工作。
在極端情況之間,您會發現一些工具,例如用於雲端儲存檔案的 Auto Loader、用於基於 SQL 的批次載入的 COPY INTO,以及使用 JDBC/ODBC 連接的基於筆記本的方法。 此外,Azure Data Factory 作為一個編排層,能協調資料從更廣泛的 Azure 生態系統移動至 Azure Databricks。
Lakeflow 連線
Lakeflow Connect 代表了 Azure Databricks 中現代的資料擷取方式。 它同時提供全受控連接器和標準連接器,可與 Lakeflow 管線整合,帶來流暢的體驗。
管理型連接器分為三種類型:
SaaS 連接器 提供開箱即用的整合,適用於 Salesforce、ServiceNow、SharePoint、HubSpot、Jira、Microsoft Dynamics 365、Workday、Zendesk 等多種企業應用程式。 這些連接器處理特定來源認證、增量讀取、API 速率限制、結構演進及自動重試。 它們運行於無伺服器運算系統,並寫入由 Unity Catalog 管理的串流資料表。
Database connectors 透過變更資料擷取(CDC)從關聯式資料庫(包括 MySQL、PostgreSQL 及 SQL Server)擷取資料。 由於基於 CDC 的連接器是從資料庫交易日誌讀取,而非直接查詢資料表,因此需要在網路中部署一個擷取 閘道 器,並有一個暫存儲存卷來緩衝擷取的變更。
社群連接器 是由社群自行建立與維護的開源連接器。 他們將 Lakeflow Connect 延伸到尚未有管理接頭的水源。 你可以使用現有的社群連結器,或是自己貢獻連結。
備註
連接器生態系統正在快速成長。 請參閱 管理連接器文件 以了解目前完整支援來源清單。
標準連接器將 Lakeflow Connect 擴展至雲端物件儲存與訊息匯流排。 你可以使用 Autoloader 從 Amazon S3、Azure Data Lake Storage 或 Google Cloud Storage 匯入資料。 對於即時資料,標準連接器支援 Apache Kafka、Google Pub/Sub 及 Apache Pulsar。

當您需要從支援的來源獲得可靠且低維護的匯入時,請考慮使用 Lakeflow Connect。 與客製化解決方案相比,管理式連接器大幅縮短開發時間與持續維護。 不過,如果你的資料來源不被支援,或需要高度專業的擷取邏輯,你可能需要考慮其他選項。
Lakeflow Connect 支援 排程 擷取(每小時、每日、每週)及 按需 觸發,適合定期資料刷新週期及臨時載入場景。
基於查詢的連接器
基於查詢的連接器是一種輕量的替代方案,用於從關聯式資料庫中排程性地擷取資料,相較於 CDC 資料庫連接器更為輕便。 他們不讀取交易日誌,而是直接使用 游標欄位 查詢來源資料表——這是一個單調遞增的時間戳記或整數,用來追蹤自上次管線運行以來哪些列是新建或更新的。
由於這些連接器可以直接查詢來源,查詢式連接器不需要使用擷取閘道或暫存儲存。 在每次排程執行時,連接器會擷取資料指標欄位值大於上次執行高水位線的所有資料列,然後將結果寫入 Unity Catalog 中的串流資料表。
支援的來源包括 Oracle、Teradata、SQL Server、MySQL、MariaDB、PostgreSQL 以及所有 Lakehouse Federation 的資料來源。
基於查詢的連接器支援三種目的資料表的歷史追蹤模式:
- SCD 類型 1:用最新的原始資料列覆蓋現有資料列。 沒有任何歷史被保存下來。
- SCD 類型 2:透過新增帶有版本元資料的列來保留完整歷史。
- 僅限附加:附加每個已內嵌的資料列,不進行合併或覆寫。
當沒有 CDC 或 binlog 基礎設施,但來源中有可靠的游標欄位時,請選擇基於查詢的連接器而非 CDC 資料庫連接器。 當您在管線執行之間需要每個中繼資料列狀態,或虛刪除追蹤至關重要時,請選擇 CDC 連接器。 折衷之處在於,查詢型連接器會直接對來源資料表施加更多負載,而 CDC 連接器則是從 binlog 讀取。
自動加載器
自動載入提供了對存儲於雲端的數據進行增量式文件處理。 自動載入器不需掃描整個目錄尋找新檔案,而是有效追蹤已處理的檔案,並只接收新到的檔案。
自動載入器透過在檢查點位置維護狀態來追蹤已處理的檔案。 當新檔案進入雲端儲存時,Auto Loader 會透過目錄列表或檔案通知模式來偵測它們。 目錄列表會定期掃描新檔案,而檔案通知模式則使用雲端原生事件以即時偵測。

自動裝載機的主要功能包括:
- 結構推論與演化:自動偵測進來檔案的結構,並優雅地處理結構變更。
- 精確一次處理:保證每個檔案都能處理一次,即使失敗或重啟。
- 可擴展性:有效率地處理數十億檔案,進行回填或遷移。
- 格式支援:處理 JSON、CSV、Parquet、Avro、ORC、XML、文字及二進位檔案。
Auto Loader 適用於資料以檔案形式進入雲端儲存的情境——常見模式包括日誌檔案、上游系統的匯出,以及資料著陸區。 您可以將 Auto Loader 與 Lakeflow 管線搭配使用,以獲得受控體驗,或與結構化串流搭配使用,以取得更多控制權。
COPY INTO
COPY INTO SQL 指令將資料從雲端儲存載入到 Delta 表格。 與自動載入器不同,COPY INTO 是以批次操作形式執行的,你可以手動排程或觸發它,而自動載入器則是以串流的方式連續執行。
COPY INTO 追蹤其已處理的檔案,使得操作具備冪等性。 重複執行同一個指令不會重複資料,因為之前載入的檔案會被跳過。 這個特性對於排程批次工作非常有用 COPY INTO ,因為你希望有可預測且可重複的行為。
備註
追蹤中繼資料儲存在 Delta 資料表的交易記錄 (_delta_log 目錄) 中

COPY INTO 的常見案例包括一次性資料移轉、從登陸區域安排批次載入,以及偏好宣告式語法而非串流 API 的 SQL 優先工作流程。
當你執行一次性批次載入大型資料集時,請選擇 COPY INTO 而非 Auto Loader。
COPY INTO 提供更簡單的配置模型,無需串流基礎設施,非常適合一次載入數百 GB 甚至 TB 的資料。 自動載入器的持續處理模型和檢查點管理,當你只需要載入一次資料時,會增加不必要的複雜性。
然而,對於持續的增量大規模擷取,Auto Loader 提供更佳的效能與更穩健的檔案發現。
Spark 結構化串流
Spark 結構化串流為 Azure Databricks 中的即時資料處理奠定基礎。 它允許從多個串流來源持續擷取資料,並保證精確一次處理。
支援的串流來源包括:
- Apache Kafka 與 Azure 事件中樞:用於事件驅動架構與訊息隊列處理。
- Delta Lake 變更摘要:用於在 Delta 資料表之間傳播變更。
- 透過 Auto Loader 進行雲端儲存:用於基於檔案的串流擷取。
- 插槽與自訂來源:適用於專門的擷取情境。
當您需要對串流行為進行精細控制、自訂浮水印或視窗邏輯,或處理不受更高層級抽象支援的來源時,請選擇結構化串流。
JDBC 與 ODBC 連接
使用 JDBC 或 ODBC 進行筆記本式擷取仍然是從關聯式資料庫擷取資料的實用方法。 你寫的程式碼直接連接到原始資料庫,執行查詢,並將結果載入 Delta 表格。
此方法幾乎支援任何帶有 JDBC 或 ODBC 驅動程式的資料庫:SQL Server、Oracle、PostgreSQL、MySQL 及其他多種。 你可以透過撰寫適當的查詢來實現完整或增量載入,通常會用浮水印欄位來追蹤擷取進度。
雖然 Lakeflow Connect 管理連接器在許多情境下正取代 JDBC/ODBC,但基於筆記本的連接在以下情況下仍然具價值:
- 你的資料庫不支援 Lakeflow Connect 管理型連接器。
- 你需要自訂的解壓邏輯,而管理型連接器無法支援。
- 你在維護使用這種模式的現有流程。
- 你需要針對大型資料表進行特定的查詢下推優化。
使用 JDBC/ODBC 時,應使用 Databricks 密鑰安全地儲存憑證,而不是將其硬式編碼在筆記本中。 考慮對原始碼系統的效能影響,並實施適當的限速或排程,以避免讓交易式資料庫過於繁重。
對於本地資料庫,則需要額外的網路基礎設施——要麼使用 Azure ExpressRoute/VPN 直接連接 Databricks 的 JDBC,要麼使用 Azure Data Factory 的 Self-Hosted Integration Runtime,先將資料放入雲端儲存。
Azure Data Factory
Azure Data Factory(ADF)作為 Azure 生態系統中的協調與資料移動平台。 它擅長協調跨越多項服務的工作流程,並將來自多元來源的資料匯入至雲端儲存中,以便 Azure Databricks 處理。
ADF 廣泛整合 Microsoft 服務,如 Dynamics 365、Azure SQL Database 及 Microsoft Fabric。 當您的資料來自這些來源時,ADF 提供直接連接,並能將資料放入 Azure Data Lake Storage 進行後續 Databrick 處理。
了解澳洲國防軍的適當角色非常重要。 ADF 可用來:
- 協調:協調涉及多個 Azure 服務的工作流程。
- 初始資料投放:將資料從 Azure 來源遷移到雲端儲存。
- 企業整合:當公司政策強制 ADF 進行資料移動時。

避免在 Databricks 內使用 ADF 進行核心 ETL 轉換。 透過 ADF 活動執行轉換會帶來不必要的複雜性,且效率不如 Databricks 原生處理。 讓 ADF 處理資料移入你的數據湖倉,然後使用 Azure Databricks 工具進行資料轉換邏輯。
套用決策框架
當你根據關鍵決策標準評估你的情境時,選擇資料匯入工具會變得更清晰。
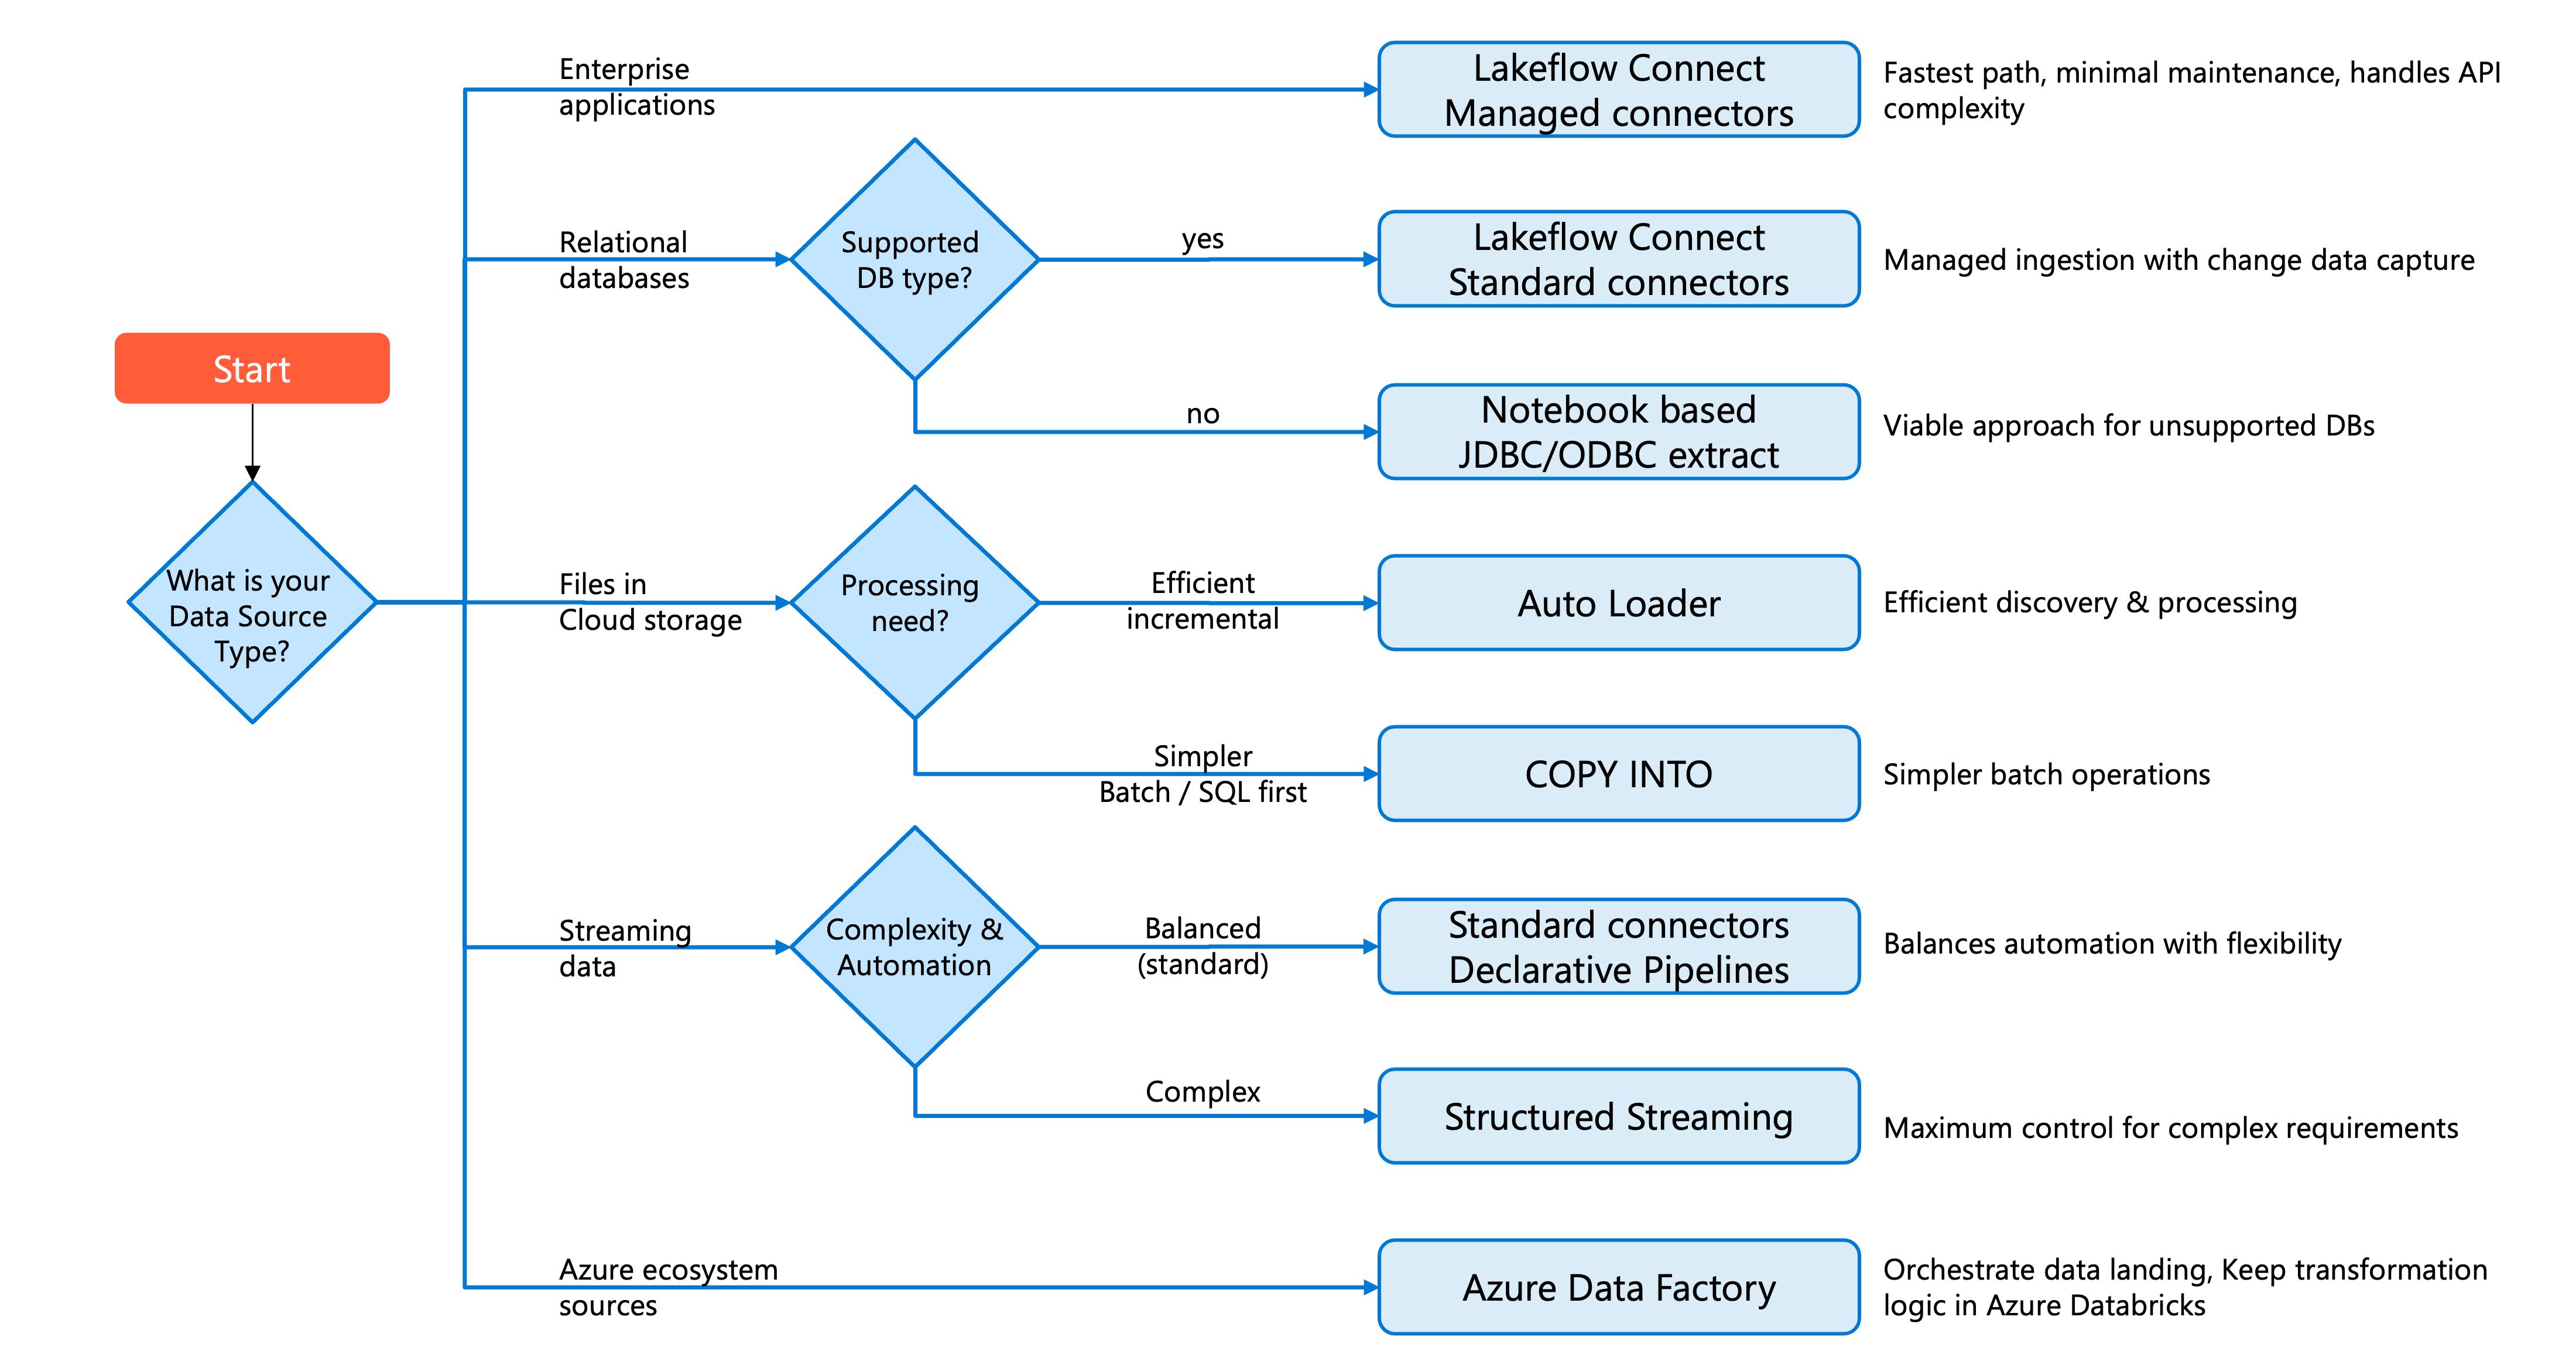
首先要確定你的資料來源類型,然後考慮營運需求與組織背景。
對於 企業應用 (Salesforce、ServiceNow、SharePoint),Lakeflow Connect 管理型連接器提供最快速的生產路徑,維護成本極低。 這些連接器處理 API 整合、速率限制及變更追蹤的複雜性。
對於支援型別的 關聯式資料庫 ,Lakeflow Connect 提供兩種管理路徑:資料庫 連接器 (基於 CDC,需閘道)用於持續變更擷取,以及基於 查詢的連接器 ,用於使用游標欄位進行更簡單的排程擷取。 對於不支援的資料庫,基於筆記本的 JDBC/ODBC 擷取仍是可行的做法。
對於 雲端儲存中的檔案,Auto Loader 提供高效的增量發現與處理。 對於較簡單的批次處理或偏好 SQL 優先工作流程時,可以使用 COPY INTO。
對於來自訊息匯流排(Kafka、Event Hubs、Pub/Sub)的 串流資料 ,標準連接器搭配 Lakeflow 管線在自動化與彈性之間取得平衡。 對於複雜的串流需求,結構化串流提供最大控制。
對於需要與其他服務協調的 Azure 生態系統來源,Azure Data Factory 可以協調資料進入您的湖存放庫。 將轉換邏輯保留在 Azure Databricks 裡,而不是 ADF 資料流。
小提示
從最符合你需求的管理方案開始。 管理式連接器可降低開發時間與維護負擔。 只有當特定需求無法被更高層次的抽象滿足時,才會轉向更具客製化的方法。
你的選擇也取決於團隊技能和組織標準。 記錄你的決策及其背後的理由,幫助未來團隊成員了解流程架構。