Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Las funciones de IA son funciones integradas que puedes utilizar para aplicar LLMs o técnicas de investigación de última generación sobre datos almacenados en Azure Databricks para la transformación y análisis de datos. Se pueden ejecutar desde Databricks SQL, cuadernos, canalizaciones de Lakeflow y flujos de trabajo.
Las funciones de IA son fáciles de usar, rápidas y escalables. Los analistas pueden usarlos para aplicar la inteligencia de datos a sus datos propietarios, mientras que los ingenieros de datos, los científicos de datos y los ingenieros de aprendizaje automático pueden usarlos para crear canalizaciones por lotes de nivel de producción.
Cuando llamas a una Función de IA, tu consulta se ejecuta sobre el cómputo desde el que la envías, como un almacén SQL, un cuaderno, un clúster o un pipeline. Dependiendo de la función, la inferencia del modelo puede ejecutarse en infraestructuras gestionadas por Databricks separadas que se facturan además de ese cálculo. Consulte Costes de las cargas de trabajo de AI Function.
Requisitos
- Las funciones de IA no están disponibles en los almacenes SQL clásicos.
- Se requiere Databricks Runtime 15.4 LTS o superior. Se recomienda Databricks Runtime 18.2 o superior para el mejor rendimiento y acceso a las últimas funciones.
Tarea específica y de uso general
Ai Functions tiene funciones específicas de tareas y de uso general:
- Funciones de IA específicas de tareas: funciones diseñadas específicamente optimizadas para una tarea específica, como el análisis de documentos, la extracción de entidades, la clasificación y el análisis de sentimiento. Estas funciones están respaldadas por sistemas gestionados por Azure Databricks y basados en investigación. Algunas funciones incluyen experiencias de interfaz de usuario. Consulte Funciones de IA específicas de la tarea para conocer las funciones y modelos admitidos.
-
ai_query— Función de uso general para la flexibilidad de tareas y modelos. Proporcione un mensaje y elija cualquier API de Foundation Model compatible. Vea Usarai_query.
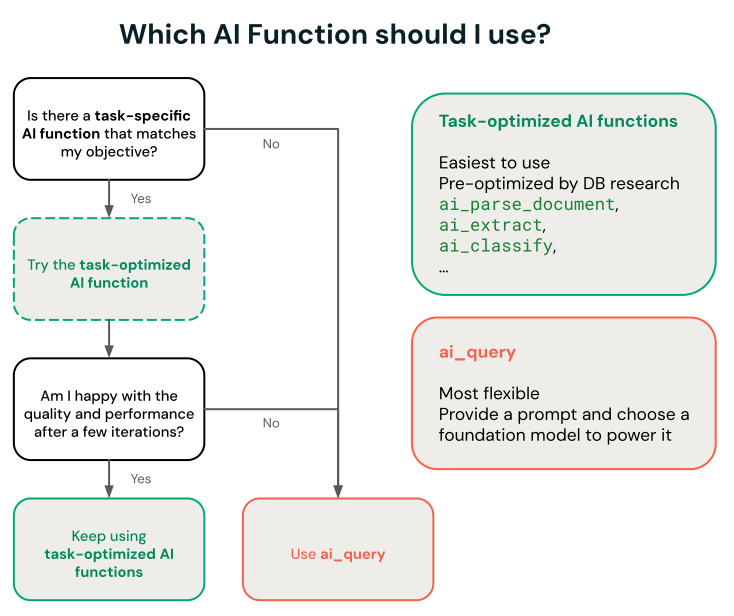
Para restringir a qué funciones de IA específicas para cada tarea puede acceder su organización, consulte los permisos de Unity Catalog para AI Functions.
Funciones de IA específicas de la tarea
Las funciones específicas de la tarea se limitan a una determinada tarea para que pueda automatizar transformaciones rutinarias, como la extracción de entidades, la traducción y la clasificación. Databricks recomienda estas funciones para empezar porque invocan técnicas de investigación de última generación mantenidas por Databricks y no requieren ninguna personalización.
Consulte Análisis de opiniones de clientes con AI Functions para obtener un ejemplo.
Las siguientes funciones se agrupan por tarea. Utiliza las columnas SQL y API REST para abrir la referencia de cada interfaz. Un guion en la columna API REST significa que no hay ninguna referencia de API REST específica en la lista.
Procesamiento inteligente de documentos:
| Función | Descripción | SQL | REST API |
|---|---|---|---|
ai_parse_document |
Analizar contenido estructurado (texto, tablas, descripciones de figura) y diseño de documentos no estructurados mediante técnicas de investigación de última generación. | Referencia SQL | Referencia de la API REST |
ai_extract |
Extraiga campos estructurados de documentos o texto mediante un esquema que defina. | Referencia SQL | Referencia de la API REST |
ai_classify |
Clasifique el texto de entrada según las etiquetas que proporcione mediante técnicas de investigación de última generación. | Referencia SQL | Referencia de la API REST |
ai_prep_search (Beta) |
Transforma documentos analizados o texto sin formato y Markdown en fragmentos listos para la búsqueda, optimizados para AI Search y los flujos de trabajo de RAG. | Referencia SQL | — |
ai_search (Beta) |
Recupera documentos clasificados y deduplicados y una respuesta fundamentada para una consulta en lenguaje natural sobre una o más fuentes de conocimiento. | Referencia SQL | — |
ai_enrich (Beta) |
Genera nuevas columnas para cada fila a partir de un esquema que definas, opcionalmente basadas en índices de búsqueda de IA o búsqueda web. | Referencia SQL | — |
Transformar texto:
| Función | Descripción | SQL | REST API |
|---|---|---|---|
ai_fix_grammar |
Corregir errores gramaticales en el texto usando un modelo de IA de última generación. | Referencia SQL | — |
ai_translate |
Traduce texto a un idioma objetivo especificado usando un modelo de IA de última generación. | Referencia SQL | — |
ai_summarize |
Genera un resumen del texto usando SQL y un modelo de IA de última generación. | Referencia SQL | — |
ai_mask |
Enmascara entidades específicas en el texto usando un modelo de IA de última generación. | Referencia SQL | — |
Analizar texto no estructurado:
| Función | Descripción | SQL | REST API |
|---|---|---|---|
ai_decide (Beta) |
Evalúa preguntas en relación con texto o datos estructurados y devuelve probabilidades, opciones o puntuaciones. | Referencia SQL | Referencia de la API REST |
ai_analyze_sentiment |
Realiza un análisis de sentimiento sobre el texto de entrada utilizando un modelo de IA de última generación. | Referencia SQL | — |
ai_similarity |
Compara dos cadenas y calcula la puntuación de similitud semántica usando un modelo de IA de última generación. | Referencia SQL | — |
Generar contenido. Para obtener indicaciones personalizadas o un modelo específico, consulte Usar ai_query:
| Función | Descripción | SQL | REST API |
|---|---|---|---|
ai_gen |
Responde a una pregunta proporcionada por el usuario usando un modelo de IA de última generación. | Referencia SQL | — |
Predecir resultados:
| Función | Descripción | SQL | REST API |
|---|---|---|---|
ai_predict_class (Beta) |
Entrene un modelo de clasificación y prediga etiquetas de clase para las filas en las que la columna objetivo es NULL. |
Referencia SQL | — |
ai_predict_value (Beta) |
Entrenar un modelo de regresión y predecir valores numéricos en las filas en las que la columna objetivo es NULL. |
Referencia SQL | — |
Serie temporal de previsión:
| Función | Descripción | SQL | REST API |
|---|---|---|---|
ai_forecast |
Previsión de datos hasta un horizonte especificado. Esta función con valores de tabla está diseñada para extrapolar los datos de series temporales en el futuro. | Referencia SQL | — |
ai_detect_anomalies (Beta) |
Identificar valores anómalos en los datos históricos de series temporales y devolver los valores esperados, límites de predicción y puntuaciones de anomalía. | Referencia SQL | — |
Análisis de los cambios de métricas:
| Función | Descripción | SQL | REST API |
|---|---|---|---|
ai_top_drivers (Beta) |
Clasificar los valores de dimensión que contribuyen más a un cambio en una métrica entre un grupo de control y un grupo de prueba. | Referencia SQL | — |
Búsqueda con incrustaciones de búsqueda de IA:
| Función | Descripción | SQL | REST API |
|---|---|---|---|
vector_search |
Busca y consulta un índice de búsqueda de IA usando un modelo de IA de última generación. | Referencia SQL | Referencia de la API REST |
Uso de funciones de IA en flujos de trabajo de producción
Para la inferencia por lotes a gran escala, puedes integrar funciones de IA específicas para cada tarea, o la función de uso general ai_query, en tus flujos de trabajo de producción, como los pipelines de Lakeflow, los flujos de trabajo de Databricks y Structured Streaming. Esto permite el procesamiento de nivel de producción a escala.
Procedimientos recomendados para las funciones de inteligencia artificial en producción:
Permitir que AI Functions controle la carga de trabajo a escala: Ai Functions administra automáticamente la paralelización, los reintentos y el escalado. Se recomienda enviar el conjunto de datos completo en una sola consulta en lugar de dividirlo manualmente en lotes pequeños. Es posible que el rendimiento no se escale linealmente de cargas de trabajo muy pequeñas a cargas de trabajo a gran escala.
Use modelos de base hospedados en Databricks: Al usar la función de ia de ai_query, use modelos de base hospedados en Databricks (prefijo con databricks-), no con rendimiento aprovisionado. Estos puntos de conexión sin aprovisionamiento están totalmente administrados y funcionan mejor para el procesamiento por lotes.
Consulte Implementación de canalizaciones de inferencia por lotes para obtener ejemplos y detalles.
Supervisión del progreso de las funciones de IA
Para comprender cuántas inferencias se han completado o producido errores y solucionar problemas de rendimiento, puede supervisar el progreso de las funciones de IA mediante la característica de perfil de consulta.
En Databricks Runtime 16.1 ML y versiones posteriores, desde la ventana de consulta del editor de SQL del área de trabajo:
- Seleccione el vínculo En ejecución--- en la parte inferior de la ventana Resultados sin procesar. La ventana de rendimiento aparece a la derecha.
- Haga clic en Ver perfil de consulta para ver los detalles del rendimiento.
- Haga clic en Consulta de IA para ver las métricas de esa consulta concreta, incluido el número de inferencias completadas y con errores y el tiempo total que tardó la solicitud en completarse.
Visualización de los costos de las cargas de trabajo de la función de IA
El cómputo que ejecuta tu consulta siempre se factura, por ejemplo un almacén SQL o un clúster de trabajos. Si existe un coste adicional de inferencia del modelo depende de la función:
-
Las funciones específicas de la tarea (por ejemplo,
ai_classify,ai_summarize,ai_translate) ejecutan inferencia en infraestructura de GPU serverless gestionada por Databricks a través de Model Serving. No es necesario que aprovisiones esta infraestructura, pero se factura además de tu proceso de consultas. -
ai_queryse te factura según el endpoint de Model Serving que especifiques. Los puntos de conexión de modelos base hospedados por Databricks se facturan como las funciones específicas de las tareas; los modelos personalizados y los puntos de conexión de rendimiento aprovisionados se ejecutan en su propia infraestructura de proceso dedicada y se facturan en consecuencia. -
ai_forecast,ai_detect_anomalies,ai_predict_class,ai_predict_value, yai_top_driversse ejecutan completamente sobre el cálculo desde el que los envías, sin coste de inferencia separado. -
vector_searchconsulta tu índice de búsqueda de IA a través del servicio de búsqueda de IA gestionado por Databricks.
Los costes de inferencia de funciones de IA se registran en la system.billing.usage tabla bajo uno de dos productos:
-
ai_similarity,ai_mask,MODEL_SERVING,BATCH_INFERENCE,ai_fix_grammaryai_translatese registran en el productoai_summarizecon el tipo de ofertaai_analyze_sentiment. - Otras funciones de IA específicas de la tarea que generan costes de inferencia separados se registran bajo el
AI_FUNCTIONSproducto, incluyendoai_classify,ai_extract,ai_parse_document, yai_search.
Visualización de los costos de las cargas de trabajo de inferencia por lotes
Los siguientes ejemplos muestran cómo filtrar los registros MODEL_SERVING con el tipo de oferta BATCH_INFERENCE en función del trabajo, la proceso, los almacenes SQL y los flujos de Lakeflow. Estos registros incluyen ai_query cargas de trabajo y las funciones específicas de la tarea que se registran bajo MODEL_SERVING.
Consulte Supervisión de los costos de servicio del modelo para obtener ejemplos generales sobre cómo ver los costos de las cargas de trabajo de inferencia por lotes que usan AI Functions.
Jobs
En la consulta siguiente se muestran los trabajos que se utilizan para la inferencia por lotes mediante una tabla de sistemas system.workflow.jobs. Consulte Supervisión de costos y rendimiento de trabajos con tablas del sistema.
SELECT *
FROM system.billing.usage u
  JOIN system.workflow.jobs x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.job_id = x.job_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Compute
A continuación se muestran los clústeres que se están utilizando para la inferencia por lotes con la tabla de sistemas system.compute.clusters.
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Canalizaciones declarativas de Spark de Lakeflow
A continuación se muestra qué canalizaciones de Lakeflow se están utilizando para la inferencia por lotes mediante la tabla del sistema system.lakeflow.pipelines.
SELECT *
FROM system.billing.usage u
  JOIN system.lakeflow.pipelines x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.dlt_pipeline_id = x.pipeline_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Almacén de SQL
A continuación se muestran los almacenes de SQL que se usan para la inferencia en lotes mediante la tabla de sistemas system.compute.warehouses.
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Consulta los costes registrados bajo el AI_FUNCTIONS producto
El siguiente ejemplo muestra cómo consultar los costes registrados bajo el producto AI_FUNCTIONS. Para filtrar por una función específica, usa el campo product_features.ai_functions.ai_function. Por ejemplo, para ver solo los costes de ai_parse_document, añade AND u.product_features.ai_functions.ai_function = "AI_PARSE_DOCUMENT".
SELECT *
FROM system.billing.usage u
WHERE u.workspace_id = <workspace_id>
  AND u.billing_origin_product = "AI_FUNCTIONS";
Ver el coste total de la Función de IA por usuario
Para calcular el coste total de inferencia de AI Function, incluye el uso de ambos productos. La siguiente consulta devuelve el coste mensual por usuario para el mes actual y los 12 meses anteriores:
SELECT
  DATE_TRUNC('MONTH', u.usage_date)::DATE AS usage_month,
  COALESCE(
    u.identity_metadata.run_as,
    u.identity_metadata.run_by,
    'UNATTRIBUTED'
  ) AS principal,
  ROUND(
    SUM(u.usage_quantity * p.pricing.effective_list.default),
    2
  ) AS list_cost_usd
FROM system.billing.usage u
JOIN system.billing.list_prices p
  ON u.cloud = p.cloud
  AND u.sku_name = p.sku_name
  AND u.usage_unit = p.usage_unit
  AND u.usage_end_time >= p.price_start_time
  AND (p.price_end_time IS NULL OR u.usage_end_time < p.price_end_time)
WHERE p.currency_code = 'USD'
  AND u.usage_date >= ADD_MONTHS(DATE_TRUNC('MONTH', CURRENT_DATE()), -12)
  AND (
    (
      u.billing_origin_product = 'MODEL_SERVING'
      AND u.product_features.model_serving.offering_type = 'BATCH_INFERENCE'
    )
    OR u.billing_origin_product = 'AI_FUNCTIONS'
  )
GROUP BY 1, 2
ORDER BY 1 DESC, 3 DESC;