Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Les fonctions d’IA sont des fonctions intégrées que vous pouvez utiliser pour appliquer des LLM ou des techniques de recherche de pointe sur des données stockées sur Azure Databricks pour la transformation et l’analyse de données. Ils peuvent être exécutés à partir de Databricks SQL, de notebooks, de pipelines Lakeflow et de flux de travail.
Les fonctions IA sont simples à utiliser, rapides et évolutives. Les analystes peuvent les utiliser pour appliquer l’intelligence des données à leurs données propriétaires, tandis que les ingénieurs données, les scientifiques des données et les ingénieurs Machine Learning peuvent les utiliser pour créer des pipelines par lots de niveau production.
Lorsque vous appelez une fonction IA, votre requête s’exécute sur le calcul depuis lequel vous la soumettez, comme un entrepôt SQL, un notebook, un cluster ou un pipeline. Selon la fonction, l’inférence du modèle peut s’exécuter sur une infrastructure distincte gérée par Databricks, facturée en plus de ce calcul. Voir les coûts des charges de travail de la fonction IA.
Requirements
- Les fonctions IA ne sont pas disponibles sur les entrepôts SQL classiques.
- Databricks Runtime 15.4 LTS ou supérieur est requis. Databricks Runtime 18.2 ou supérieur est recommandé pour les meilleures performances et l’accès aux dernières fonctionnalités.
Tâche spécifique et usage général
AI Functions a des fonctions spécifiques aux tâches et à usage général :
- Fonctions IA spécifiques à une tâche : fonctions conçues à des fins optimisées pour une tâche spécifique, telles que l’analyse de document, l’extraction d’entités, la classification et l’analyse des sentiments. Ces fonctions sont alimentées par des systèmes gérés par Azure Databricks et dédiés à la recherche. Certaines fonctions incluent des expériences d’interface utilisateur. Consultez les fonctions IA spécifiques à la tâche pour les fonctions et les modèles pris en charge.
-
ai_query— Fonction à usage général pour la flexibilité des tâches et des modèles. Fournissez une invite et choisissez n’importe quelle API Foundation Model prise en charge. Voir Utiliserai_query.
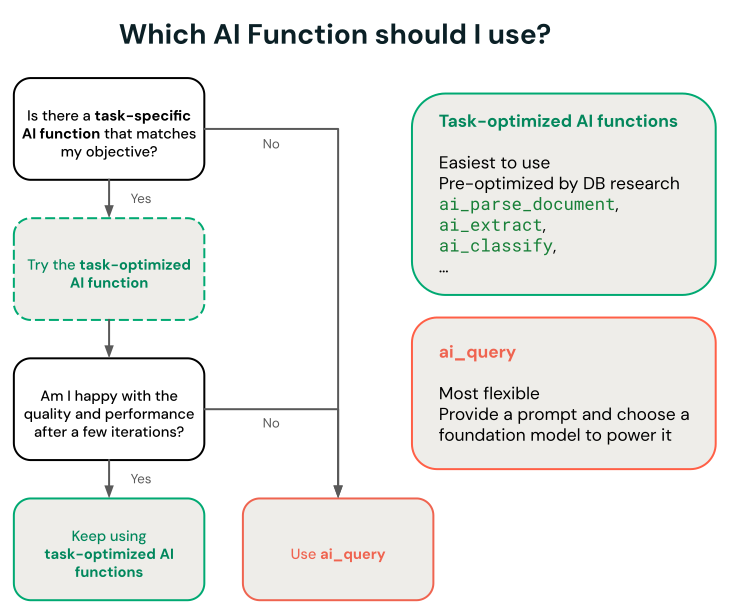
Pour restreindre les fonctions IA spécifiques à une tâche auxquelles votre organisation peut accéder, consultez les autorisations du catalogue Unity d’AI Functions.
Fonctions IA spécifiques à une tâche
Les fonctions spécifiques à une tâche sont limitées pour une tâche spécifique afin de pouvoir automatiser les transformations de routine, telles que l’extraction d’entités, la traduction et la classification. Databricks recommande ces fonctions pour commencer, car elles appellent des techniques de recherche de pointe gérées par Databricks et ne nécessitent aucune personnalisation.
Consultez Analyser les avis des clients à l’aide d’AI Functions pour obtenir un exemple.
Les fonctions suivantes sont regroupées par tâche. Utilisez les colonnes SQL et API REST pour ouvrir la référence de chaque interface. Un tiret dans la colonne de l’API REST signifie qu’aucune référence dédiée à l’API REST n’est indiquée.
Traitement intelligent des documents :
| Fonction | Descriptif | SQL | REST API |
|---|---|---|---|
ai_parse_document |
Analyser le contenu structuré (texte, tableaux, descriptions de figure) et la disposition à partir de documents non structurés à l’aide de techniques de recherche de pointe. | Référence d’SQL | Référence d’API REST |
ai_extract |
Extrayez des champs structurés à partir de documents ou de texte à l’aide d’un schéma que vous définissez. | Référence d’SQL | Référence d’API REST |
ai_classify |
Classifiez le texte d’entrée en fonction des étiquettes que vous fournissez à l’aide de techniques de recherche de pointe. | Référence d’SQL | Référence d’API REST |
ai_prep_search (bêta) |
Transformez les documents analysés ou le texte brut et le markdown en segments prêts à la recherche, optimisés pour les pipelines IA Search et RAG. | Référence d’SQL | — |
ai_search (bêta) |
Récupérez des documents classés et dédupliqués ainsi qu’une réponse fondée pour une requête en langage naturel sur une ou plusieurs sources de connaissances. | Référence d’SQL | — |
ai_enrich (bêta) |
Générez de nouvelles colonnes pour chaque ligne à partir d’un schéma que vous définissez, éventuellement basé sur des sources de connaissances telles que des index AI Search ou un outil de recherche sur un serveur externe Model Context Protocol (MCP). | Référence d’SQL | — |
Transformer le texte :
| Fonction | Descriptif | SQL | REST API |
|---|---|---|---|
ai_fix_grammar |
Corrigez les erreurs grammaticales dans le texte à l’aide d’un modèle d’IA de pointe. | Référence d’SQL | — |
ai_translate |
Traduisez du texte dans une langue cible spécifiée à l’aide d’un modèle d’IA de pointe. | Référence d’SQL | — |
ai_summarize |
Générez un résumé du texte en utilisant SQL et un modèle d’IA de pointe. | Référence d’SQL | — |
ai_mask |
Masquez les entités spécifiées dans le texte à l’aide d’un modèle d’IA de pointe. | Référence d’SQL | — |
Analysez le texte non structuré :
| Fonction | Descriptif | SQL | REST API |
|---|---|---|---|
ai_decide (bêta) |
Évaluez les questions en fonction d’un texte ou de données structurées et renvoyez des probabilités, des choix ou des scores. | Référence d’SQL | Référence d’API REST |
ai_analyze_sentiment |
Effectuez une analyse de sentiment sur le texte d’entrée à l’aide d’un modèle d’IA de pointe. | Référence d’SQL | — |
ai_similarity |
Comparez deux chaînes de caractères et calculez le score de similarité sémantique à l’aide d’un modèle d’IA de pointe. | Référence d’SQL | — |
Générez du contenu. Pour obtenir des invites personnalisées ou un modèle spécifique, consultez Utiliser ai_query:
| Fonction | Descriptif | SQL | REST API |
|---|---|---|---|
ai_gen |
Répondez à une demande fournie par l’utilisateur en utilisant un modèle d’IA de pointe. | Référence d’SQL | — |
Prédire les résultats :
| Fonction | Descriptif | SQL | REST API |
|---|---|---|---|
ai_predict_class (bêta) |
Entraînez un modèle de classification et prédisez les étiquettes de classe pour les lignes où la colonne cible est NULL. |
Référence d’SQL | — |
ai_predict_value (bêta) |
Entraînez un modèle de régression et prédisez des valeurs numériques pour les lignes où la colonne cible est NULL. |
Référence d’SQL | — |
Série chronologique de prévision :
| Fonction | Descriptif | SQL | REST API |
|---|---|---|---|
ai_forecast |
Prévision des données jusqu’à un horizon spécifié. Cette fonction TVF est conçue pour extrapoler les données de série chronologique dans le futur. | Référence d’SQL | — |
ai_detect_anomalies (bêta) |
Identifier les valeurs anormales dans les données historiques de séries temporelles et retourner les valeurs attendues, les bornes de prédiction et les scores d’anomalie. | Référence d’SQL | — |
Analyser les modifications des métriques :
| Fonction | Descriptif | SQL | REST API |
|---|---|---|---|
ai_top_drivers (bêta) |
Valeurs de dimension de classement qui contribuent le plus à une modification d’une métrique entre un groupe de contrôles et un groupe de tests. | Référence d’SQL | — |
Effectuez une recherche avec des incorporations de recherche IA :
| Fonction | Descriptif | SQL | REST API |
|---|---|---|---|
vector_search |
Effectuez une recherche et des requêtes dans un index AI Search à l’aide d’un modèle d’IA de pointe. | Référence d’SQL | Référence d’API REST |
Utiliser ai Functions dans les flux de travail de production
Pour l’inférence par lots à grande échelle, vous pouvez intégrer des fonctions d’IA spécifiques à certaines tâches, ou la fonction polyvalente ai_query, dans vos workflows de production, comme les pipelines Lakeflow, les workflows Databricks et Structured Streaming. Cela permet un traitement de niveau industriel à grande échelle.
Meilleures pratiques pour les fonctions IA en production :
Laissez AI Functions gérer votre charge de travail à grande échelle : AI Functions gère automatiquement la parallélisation, les nouvelles tentatives et la mise à l’échelle. Il est recommandé d’envoyer votre jeu de données complet dans une seule requête plutôt que de le fractionner manuellement en petits lots. Les performances peuvent ne pas être mises à l’échelle linéairement entre les charges de travail très petites et les charges de travail à grande échelle.
Utilisez des modèles de base hébergés par Databricks : Lorsque vous utilisez la fonction IA ai_query, utilisez des modèles de base hébergés par Databricks (préfixés avec databricks-), et non un débit provisionné. Ces points de terminaison provisionless sont entièrement gérés et fonctionnent le mieux pour le traitement par lots.
Consultez Déployer des pipelines d’inférence par lots pour obtenir des exemples et des détails.
Surveiller la progression des fonctions IA
Pour comprendre le nombre d’inférences terminées ou ayant échoué et dépanner les performances, vous pouvez surveiller la progression des fonctions IA à l’aide de la fonctionnalité de profil de requête.
Dans Databricks Runtime 16.1 ML et versions ultérieures, à partir de la fenêtre de requête de l’éditeur SQL dans votre espace de travail :
- Sélectionnez le lien, En cours d’exécution--- en bas de la fenêtre Résultats bruts . La fenêtre de performances s’affiche à droite.
- Cliquez sur Afficher le profil de requête pour afficher les détails des performances.
- Cliquez sur REQUÊTE IA pour afficher les métriques de cette requête particulière, y compris le nombre d’inférences terminées et ayant échoué et le temps total nécessaire à la fin de la requête.
Afficher les coûts des charges de travail de fonction IA
Le calcul qui exécute votre requête est toujours facturé, par exemple un entrepôt SQL ou un cluster de tâches. L’existence d’un coût d’inférence supplémentaire du modèle dépend de la fonction :
-
Les fonctions spécifiques à la tâche (par exemple,
ai_classify,ai_summarize,ai_translate) exécutent l’inférence sur une infrastructure GPU serverless gérée par Databricks via Model Serving. Vous ne provisionnez pas cette infrastructure, mais elle est facturée en plus de votre calcul de requête. -
ai_queryest facturé pour le terminau de service modèle que vous spécifiez. Les points de terminaison de modèles de base hébergés par Databricks sont facturés comme les fonctions spécifiques à une tâche ; les points de terminaison de modèles personnalisés et avec débit provisionné s’exécutent sur leurs propres ressources de calcul dédiées au serving et sont facturés en conséquence. -
ai_forecast,ai_detect_anomalies,ai_predict_class,ai_predict_value, etai_top_driverss’exécutent entièrement sur le calcul dont vous les soumettez, sans coût d’inférence séparé. -
vector_searchinterroge votre index IA Search via le service AI Search géré par Databricks.
Les coûts d’inférence des fonctions IA sont enregistrés dans le system.billing.usage tableau sous l’un des deux produits suivants :
-
ai_similarity,ai_fix_grammar,ai_mask,MODEL_SERVING,BATCH_INFERENCEetai_translatesont enregistrés sous le produitai_summarizeavec le type d’offreai_analyze_sentiment. - D’autres fonctions d’IA spécifiques à une tâche qui engagent des coûts d’inférence distincts sont enregistrées sous le
AI_FUNCTIONSproduit, notammentai_classify,ai_extract,ai_parse_document, etai_search.
Afficher les coûts des charges de travail d’inférence par lots
Les exemples suivants montrent comment filtrer les MODEL_SERVING enregistrements selon BATCH_INFERENCE le type d’offre en fonction des jobs, du calcul, des entrepôts SQL et des pipelines Lakeflow. Ces enregistrements incluent ai_query les charges de travail et les fonctions spécifiques à chaque tâche qui sont enregistrées sous MODEL_SERVING.
Consultez Surveiller les coûts de service de modèle pour obtenir des exemples généraux sur la façon d’afficher les coûts de vos charges de travail d’inférence par lots qui utilisent AI Functions.
Jobs
La requête suivante montre quelles tâches sont utilisées pour l’inférence par lots à l’aide de la table des systèmes system.workflow.jobs. Consultez Superviser les coûts et les performances des tâches à l'aide des tables système.
SELECT *
FROM system.billing.usage u
  JOIN system.workflow.jobs x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.job_id = x.job_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Compute
Les clusters suivants sont utilisés pour l’inférence par lots à l’aide de la system.compute.clusters table des systèmes.
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Pipelines déclaratifs Lakeflow Spark
L’exemple suivant montre les pipelines Lakeflow utilisés pour l’inférence par lots à l’aide de la table des systèmes system.lakeflow.pipelines.
SELECT *
FROM system.billing.usage u
  JOIN system.lakeflow.pipelines x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.dlt_pipeline_id = x.pipeline_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Entrepôt SQL
L’exemple suivant montre quels entrepôts SQL sont utilisés pour l’inférence par lots à l’aide de la system.compute.warehouses table des systèmes.
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Consultez les coûts enregistrés pour le AI_FUNCTIONS produit
L’exemple suivant montre comment interroger les coûts enregistrés pour le produit AI_FUNCTIONS. Pour filtrer une fonction spécifique, utilisez le champ product_features.ai_functions.ai_function. Par exemple, pour ne voir que ai_parse_document les coûts, ajoutez AND u.product_features.ai_functions.ai_function = "AI_PARSE_DOCUMENT".
SELECT *
FROM system.billing.usage u
WHERE u.workspace_id = <workspace_id>
  AND u.billing_origin_product = "AI_FUNCTIONS";
Voir le coût total de la fonction IA par utilisateur
Pour calculer le coût total d’inférence de la fonction IA, incluez l’utilisation des deux produits. La requête suivante indique le coût mensuel par utilisateur pour le mois en cours et les 12 mois précédents :
SELECT
  DATE_TRUNC('MONTH', u.usage_date)::DATE AS usage_month,
  COALESCE(
    u.identity_metadata.run_as,
    u.identity_metadata.run_by,
    'UNATTRIBUTED'
  ) AS principal,
  ROUND(
    SUM(u.usage_quantity * p.pricing.effective_list.default),
    2
  ) AS list_cost_usd
FROM system.billing.usage u
JOIN system.billing.list_prices p
  ON u.cloud = p.cloud
  AND u.sku_name = p.sku_name
  AND u.usage_unit = p.usage_unit
  AND u.usage_end_time >= p.price_start_time
  AND (p.price_end_time IS NULL OR u.usage_end_time < p.price_end_time)
WHERE p.currency_code = 'USD'
  AND u.usage_date >= ADD_MONTHS(DATE_TRUNC('MONTH', CURRENT_DATE()), -12)
  AND (
    (
      u.billing_origin_product = 'MODEL_SERVING'
      AND u.product_features.model_serving.offering_type = 'BATCH_INFERENCE'
    )
    OR u.billing_origin_product = 'AI_FUNCTIONS'
  )
GROUP BY 1, 2
ORDER BY 1 DESC, 3 DESC;