この記事では、Azure Databricks の Foundation Model API の概要について説明します。 これには、使用要件、サポートされているモデル、制限事項が含まれます。
Databricks Foundation Model API とは
Model Serving では、サービス エンドポイントから最新のオープン モデルにアクセスしてクエリを実行できる Foundation Model API がサポートされるようになりました。 これらのモデルは Databricks によってホストされており、独自のモデルデプロイを維持することなく、それらを使用するアプリケーションをすばやく簡単に構築できます。 Foundation Model API は、Databricks 指定サービス です。つまり、Databricks Geos を使用して、顧客のコンテンツを処理するときにデータ所在地を管理します。
Foundation Model API は、次のモードで提供されます。
トークン単位の支払い: これは Databricks で基礎モデルへのアクセスを開始する最も簡単な方法であり、Foundation Model API を使用して体験を開始するために推奨されます。 運用ワークロードの場合、Databricks では、負荷の下でより一貫性のあるパフォーマンスを必要とする待機時間に依存するワークロードに対して、優先度の高い トークンあたりの支払い (優先度モードとも呼ばれます) をお勧めします。
プロビジョニング済みスループット: このモードは、すべての運用ワークロード 、特に高スループット、パフォーマンスの保証、微調整されたモデル、または追加のセキュリティ要件を必要とするワークロードに推奨されます。 プロビジョニングされたスループット エンドポイントは、HIPAA などのコンプライアンス認定で利用できます。
AI Functions 最適化モデル: このモードは、バッチ推論ワークロードに推奨されます。 AI Functions を使用して、任意の AI または ML モデルを使用してバッチ推論を実行できます。
これらのモードとサポートされているモデルの使用方法についてのガイダンスは、Foundation Model API の使用に関する を参照してください。
Foundation Model API を使用すると、次の操作を行うことができます。
- リソースを増やす前に、一般化された LLM にクエリを実行してプロジェクトの有効性を確認します。
- カスタム モデルのトレーニングとデプロイに投資する前に、一般化された LLM にクエリを実行して、LLM ベースのアプリケーションの概念実証をすばやく作成します。
- 基本モデルとベクター インデックスを使用して、取得拡張生成 (RAG) を使用してチャットボットを構築します。
- 独自のモデルをオープンな代替手段に置き換えて、コストとパフォーマンスを最適化します。
- LLM を効率的に比較してユース ケースに最適な候補を確認するか、運用モデルをより適切なパフォーマンスでスワップします。
- 運用トラフィックの急増をサポートできる、SLA を基盤とするスケーラブルな LLM サービス ソリューションに基づいて、開発または運用用の LLM アプリケーションを構築します。
要件
- エンドポイント要求を認証するための Databricks API トークン。
- サーバーレス コンピューティング (プロビジョニング済みスループット モデルの場合)。
- 次のサポートされているリージョンのいずれかに含まれるワークスペース。
Foundation Model API を使用する
Foundation Model API を使用するには、複数のオプションがあります。
ほとんどのFoundation Model APIはOpenAIに対応しているので、OpenAIクライアントを使ってクエリを行えます。 UI、Foundation Models API Python SDK、MLflow Deployments SDK、または REST API を使用して、サポートされているモデルのクエリを実行することもできます。 OpenJevモデルは TypeSafe System One APIを使用しています。 Databricksは、互換性のあるモデルとの拡張的なやり取りにはOpenAIクライアントSDKまたはAPIの使用を推奨し、機能を試すにはUIを使うことを推奨しています。
スコア付けの例については、「 基礎モデルを使用 する」を参照してください。
トークンごとの支払い基盤モデル API
トークンごとの支払いモデルを提供する事前構成済みエンドポイントには、Azure Databricks ワークスペースでアクセスできます。 これらのトークンごとの支払いモデルは、作業を開始するために推奨されます。 ワークスペースでアクセスするには、ワークスペースサイドバーの 「AI Gateway 」をクリックしてください。 トークン課金モデルは「 モデル 」タブにシステム提供のモデルサービスとしてリストされています。 システム 提供モデルサービス を参照してください。
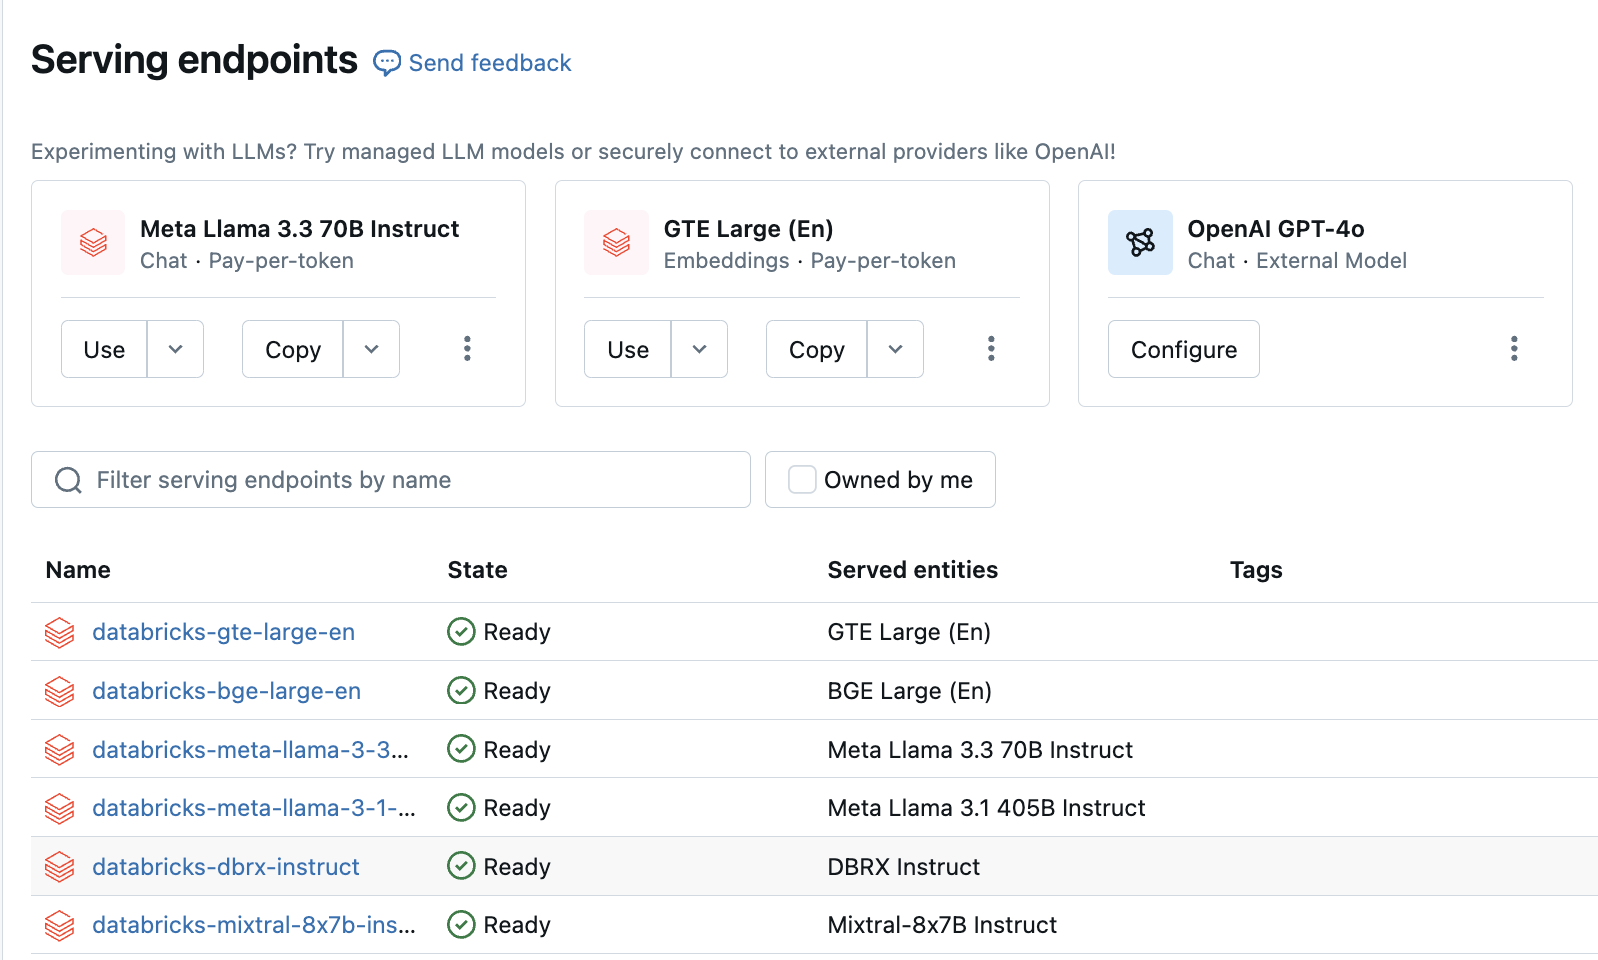
- サポートされているトークンごとの支払いモデル。
- Foundation Model API にクエリを実行する方法のガイダンスについては、「基礎 モデルを使用 する」を参照してください。
- 必要なパラメーターと構文については、Foundation モデル REST API リファレンス を参照してください。
優先トークン単位課金
優先度の高いトークンごとの支払い (優先度モードとも呼ばれます) は、待機時間が影響を受けやすいリアルタイム アプリケーション向けのトークンごとの支払い機能です。
service_tier パラメーターを "priority" に設定して要求を送信すると、Azure Databricksは、負荷の下でより一貫した待機時間を確保するために、標準のベスト エフォートのトークンごとの支払いトラフィックより前に要求を許可します。 優先度モードは要求ごとにオプトインされ、コミットメントは必要なく、トークンあたりの料金が高くなります。
Foundation Model APIs のトークンごとの優先課金を参照してください。
Provisioned throughput Foundation Model API
プロビジョニングされたスループットにより、パフォーマンスの保証を必要とする基盤モデルワークロードの推論が最適化されたエンドポイントが提供されます。 Databricks では、運用環境のワークロードに対してプロビジョニングされたスループットが推奨されます。
- プロビジョニング済みスループットでサポートされるモデル アーキテクチャ.
- プロビジョンドスループットモードで Foundation Model API をデプロイする手順については、オンデマンドプロビジョンドスループット Foundation Model API を参照してください。
プロビジョニングされたスループットのサポートには、次のものが含まれます。
- すべてのサイズの基本モデル. ベース モデルには Databricks Marketplace を使用してアクセスすることも、Hugging Face または別の外部ソースからダウンロードして Unity カタログに登録することもできます。 後者のアプローチは、サポートされているモデルの微調整されたバリアントで動作します。
- 独自のデータで微調整されたモデルなど、ベース モデルの微調整されたバリアントです。
- 完全にカスタマイズ可能な重みとトークナイザー。たとえば、ゼロからトレーニングされたものや事前トレーニングしたもの、基本モデル アーキテクチャを使用した他のバリエーション (たとえば、CodeLlama) などです。
バッチ推論用の AI 関数
詳細は 「AI関数を用いた非構造化データの変換」を参照してください。
AI Functions を使用してバッチ推論パイプラインを作成する方法については、「 バッチ推論パイプラインのデプロイ」 を参照してください。
制限
Foundation Model API の制限を参照してください。