Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
AI-functies zijn ingebouwde functies die je kunt gebruiken om LLM's of geavanceerde onderzoekstechnieken toe te passen op data die op Azure Databricks is opgeslagen voor datatransformatie en analyse. Ze kunnen worden uitgevoerd vanuit Databricks SQL, notebooks, Lakeflow-pijplijnen en werkstromen.
AI-functies zijn eenvoudig te gebruiken, snel en schaalbaar. Analisten kunnen ze gebruiken om gegevensinformatie toe te passen op hun eigen gegevens, terwijl data engineers, gegevenswetenschappers en machine learning-engineers ze kunnen gebruiken om batchpijplijnen op productieniveau te bouwen.
Wanneer je een AI-functie aanroept, draait je query op de compute waar je het vanaf indient, zoals een SQL-warehouse, notebook, cluster of pipeline. Afhankelijk van de functie kan de modelinferentie draaien op een aparte, door Databricks beheerde infrastructuur die naast die rekenkracht wordt gefactureerd. Zie Bekijk kosten voor AI-functie-workloads.
Requirements
- AI-functies zijn niet beschikbaar op Classic SQL-warehouses.
- Databricks Runtime 15.4 LTS of hoger is vereist. Databricks Runtime 18.2 of hoger wordt aanbevolen voor de beste prestaties en toegang tot de nieuwste functies.
Taakspecifiek en algemeen gebruik
AI-functies hebben taakspecifieke en algemene functies:
- Taakspecifieke AI-functies : speciaal gebouwde functies die zijn geoptimaliseerd voor een specifieke taak, zoals documentparsering, entiteitextractie, classificatie en sentimentanalyse. Deze functies worden mogelijk gemaakt door Azure Databricks-beheerde systemen die zijn ondersteund door onderzoek. Sommige functies omvatten UI-ervaringen. Zie taakspecifieke AI-functies voor ondersteunde functies en modellen.
-
ai_query— De algemene functie voor taak- en modelflexibiliteit. Geef een prompt op en kies een ondersteunde Foundation Model-API. Zie Gebruikai_query.
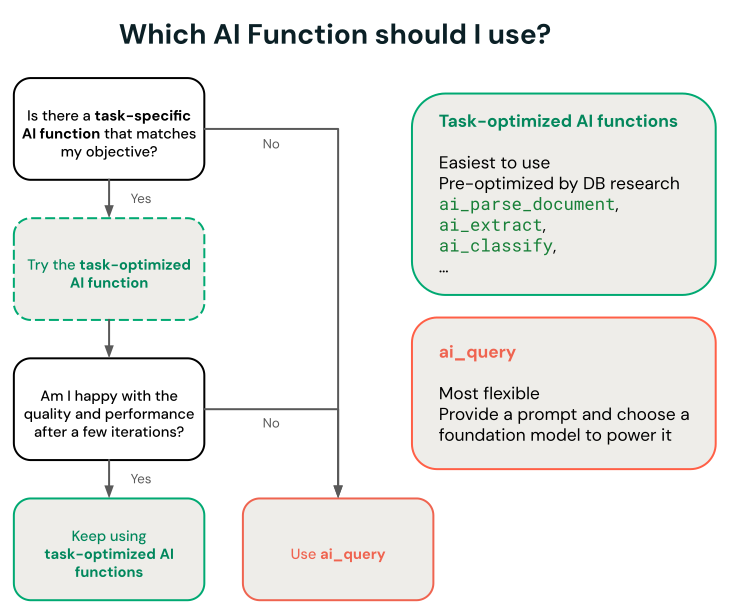
Als u wilt beperken tot welke taakspecifieke AI-functies uw organisatie toegang heeft, raadpleegt u machtigingen voor AI Functions Unity Catalog.
taakspecifieke AI-functies
Taakspecifieke functies zijn gericht op een bepaalde taak, zodat u routinetransformaties kunt automatiseren, zoals entiteitextractie, vertaling en classificatie. Databricks raadt deze functies aan om aan de slag te gaan, omdat ze een geavanceerde onderzoekstechnieken aanroepen die worden onderhouden door Databricks en geen aanpassingen vereisen.
Zie Klantbeoordelingen analyseren met BEHULP van AI Functions voor een voorbeeld.
De volgende functies zijn gegroepeerd op taak. Gebruik de SQL- en REST API-kolommen om de referentie voor elke interface te openen. Een streepje in de REST API-kolom betekent dat er geen speciale REST API-referentie wordt vermeld.
Intelligente documentverwerking:
| Functie | Beschrijving | SQL | REST API |
|---|---|---|---|
ai_parse_document |
Parseren van gestructureerde inhoud (tekst, tabellen, afbeeldingsbeschrijvingen) en indeling van ongestructureerde documenten met behulp van geavanceerde onderzoekstechnieken. | SQL-verwijzing | REST API-referentie |
ai_extract |
Extraheer gestructureerde velden uit documenten of tekst met behulp van een schema dat u definieert. | SQL-verwijzing | REST API-referentie |
ai_classify |
Classificeer invoertekst op basis van labels die u opgeeft met behulp van geavanceerde onderzoekstechnieken. | SQL-verwijzing | REST API-referentie |
ai_prep_search (Bèta) |
Transformeer geanalyseerde documenten of platte tekst en markdown in zoekklare chunks die geoptimaliseerd zijn voor AI-zoek- en RAG-pijplijnen. | SQL-verwijzing | — |
ai_search (Bèta) |
Haal gerangschikte, gededupliceerde documenten en een gegronde oplossing op voor een natuurlijke taalzoekopdracht over één of meer kennisbronnen. | SQL-verwijzing | — |
ai_enrich (Bèta) |
Genereer nieuwe kolommen voor elke rij vanuit een schema dat je definieert, optioneel gebaseerd op AI-zoekindexen of webzoeken. | SQL-verwijzing | — |
Tekst transformeren:
| Functie | Beschrijving | SQL | REST API |
|---|---|---|---|
ai_fix_grammar |
Correctie van grammaticale fouten in tekst met behulp van een ultramodern AI-model. | SQL-verwijzing | — |
ai_translate |
Vertaal tekst naar een gespecificeerde doeltaal met behulp van een ultramodern AI-model. | SQL-verwijzing | — |
ai_summarize |
Genereer een samenvatting van tekst met SQL en een state-of-the-art AI-model. | SQL-verwijzing | — |
ai_mask |
Masker bepaalde entiteiten in tekst met behulp van een ultramodern AI-model. | SQL-verwijzing | — |
Analyseer ongestructureerde tekst:
| Functie | Beschrijving | SQL | REST API |
|---|---|---|---|
ai_decide (Bèta) |
Beoordeel vragen aan de hand van tekst of gestructureerde data en geef kansen, keuzes of scores terug. | SQL-verwijzing | REST API-referentie |
ai_analyze_sentiment |
Voer sentimentanalyse uit op invoertekst met behulp van een ultramodern AI-model. | SQL-verwijzing | — |
ai_similarity |
Vergelijk twee strings en bereken de semantische gelijkenisscore met behulp van een ultramodern AI-model. | SQL-verwijzing | — |
Inhoud genereren. Zie Use ai_queryvoor aangepaste prompts of een specifiek model:
| Functie | Beschrijving | SQL | REST API |
|---|---|---|---|
ai_gen |
Beantwoord een door de gebruiker gegeven prompt met behulp van een ultramodern AI-model. | SQL-verwijzing | — |
Voorspel uitkomsten:
| Functie | Beschrijving | SQL | REST API |
|---|---|---|---|
ai_predict_class (Bèta) |
Train een classificatiemodel en voorspel klasselabels voor rijen waarbij de doelkolom is NULL. |
SQL-verwijzing | — |
ai_predict_value (Bèta) |
Train een regressiemodel en voorspel numerieke waarden voor rijen waarbij de doelkolom is NULL. |
SQL-verwijzing | — |
Tijdreeks voorspellen:
| Functie | Beschrijving | SQL | REST API |
|---|---|---|---|
ai_forecast |
Prognosegegevens tot een opgegeven horizon. Deze tabelwaardefunctie is ontworpen om tijdreeksgegevens in de toekomst te extrapoleren. | SQL-verwijzing | — |
ai_detect_anomalies (Bèta) |
Identificeer afwijkende waarden in historische tijdreeksgegevens en geef verwachte waarden, voorspellingsgrenzen en anomaliescores terug. | SQL-verwijzing | — |
Metrische wijzigingen analyseren:
| Functie | Beschrijving | SQL | REST API |
|---|---|---|---|
ai_top_drivers (Bèta) |
Rangschik dimensiewaarden die het meeste bijdragen aan een wijziging in een metrische waarde tussen een besturingsgroep en een testgroep. | SQL-verwijzing | — |
Zoeken met AI Search-insluitingen:
| Functie | Beschrijving | SQL | REST API |
|---|---|---|---|
vector_search |
Doorzoek en bevraag een AI Search-index met een geavanceerd AI-model. | SQL-verwijzing | REST API-referentie |
AI-functies gebruiken in productiewerkstromen
Voor grootschalige batchdeductie kunt u taakspecifieke AI-functies of de functie ai_query voor algemeen gebruik integreren in uw productiewerkstromen, zoals Lakeflow-pijplijnen, Databricks-werkstromen en Gestructureerd streamen. Dit maakt verwerking op schaal mogelijk op productieniveau.
Aanbevolen procedures voor AI-functies in productie:
Laat AI-functies uw workload op schaal afhandelen: AI Functions beheert automatisch parallelle uitvoering, nieuwe pogingen en schaalaanpassing. Het is raadzaam om uw volledige gegevensset in één query in te dienen in plaats van deze handmatig te splitsen in kleine batches. Prestaties kunnen mogelijk niet lineair worden geschaald van zeer kleine workloads naar grootschalige workloads.
Databricks-gehoste basismodellen gebruiken: Wanneer u de ai_query AI-functie gebruikt, gebruikt u door Databricks gehoste basismodellen (voorafgegaan door Databricks-), geen ingerichte doorvoer. Deze inrichtingsloze eindpunten worden volledig beheerd en werken het beste voor batchverwerking.
Zie Batch-inferentie-pijplijnen implementeren voor voorbeelden en details.
Voortgang van AI-functies bewaken
Als u wilt weten hoeveel deducties zijn voltooid of mislukt en prestatieproblemen hebben opgelost, kunt u de voortgang van AI-functies bewaken met behulp van de functie queryprofiel.
In Databricks Runtime 16.1 ML en hoger, vanuit het queryvenster van de SQL-editor in uw werkruimte:
- Selecteer de koppeling, Wordt uitgevoerd--- onderaan het venster Onbewerkte resultaten . Het prestatievenster wordt rechts weergegeven.
- Klik op Queryprofiel weergeven om prestatiedetails weer te geven.
- Klik op AI-query om metrische gegevens voor die specifieke query weer te geven, inclusief het aantal voltooide en mislukte deducties en de totale tijd die de aanvraag heeft geduurd.
Kosten voor AI-functieworkloads weergeven
De compute die je query uitvoert, wordt altijd gefactureerd, bijvoorbeeld een SQL-warehouse of jobcluster. Of er een extra modelinferentiekosten zijn, hangt af van de functie:
-
Taakspecifieke functies (bijvoorbeeld
ai_classify,ai_summarize, )ai_translatevoeren inferentie uit op door Databricks beheerde serverloze GPU-infrastructuur via Model Serving. Je richt deze infrastructuur niet zelf in, maar er worden wel kosten voor in rekening gebracht boven op de rekenkracht voor query’s. -
ai_querywordt gefactureerd voor het Model Serving eindpunt dat je aangeeft. Door Databricks gehoste endpoints voor foundation models worden op dezelfde manier gefactureerd als taakspecifieke functies; endpoints voor aangepaste modellen en provisioned throughput draaien op hun eigen toegewezen rekencapaciteit voor modelserving en worden dienovereenkomstig gefactureerd. -
ai_forecast,ai_detect_anomalies,ai_predict_class,ai_predict_valueenai_top_driversdraaien volledig op de rekenkracht vanwaaruit je ze indient, zonder afzonderlijke inferentiekosten. -
vector_searchzoekt je AI Search index via de door Databricks beheerde AI Search service.
De kosten van de inferentie van AI-functies worden in de system.billing.usage tabel weergegeven onder een van twee producten:
-
ai_similarity,ai_analyze_sentiment,ai_translate,ai_fix_grammar,ai_maskenMODEL_SERVINGworden geregistreerd onder hetBATCH_INFERENCE-product met het offertypeai_summarize. - Andere taakspecifieke AI-functies die aparte inferentiekosten veroorzaken, worden onder het
AI_FUNCTIONSproduct geregistreerd, waaronderai_classify,ai_extract,ai_parse_document, enai_search.
Kosten voor batch-inferentieworkloads weergeven
De volgende voorbeelden laten zien hoe records gefilterd MODEL_SERVING kunnen worden met het BATCH_INFERENCE aanbiedingstype op basis van job, compute, SQL-warehouses en Lakeflow-pijpleidingen. Deze records bevatten ai_query workloads en de taakspecifieke functies die onder MODEL_SERVINGworden vastgelegd.
Zie Monitor kosten van modelbediening voor algemene voorbeelden van hoe u kosten kunt bekijken voor uw batch-inference workloads die gebruikmaken van AI Functions.
Jobs
De volgende query laat zien welke taken worden gebruikt voor batch-inferentie met behulp van de system.workflow.jobs systeemtabel. Zie Taakkosten en prestaties bewaken met systeemtabellen.
SELECT *
FROM system.billing.usage u
  JOIN system.workflow.jobs x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.job_id = x.job_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Compute
Hieronder ziet u welke clusters worden gebruikt voor batchdeductie met behulp van de system.compute.clusters systeemtabel.
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Declaratieve Pijplijnen van Lakeflow Spark
Hieronder ziet u welke Lakeflow-pijplijnen worden gebruikt voor batchinferentie met behulp van de systeemtabel system.lakeflow.pipelines.
SELECT *
FROM system.billing.usage u
  JOIN system.lakeflow.pipelines x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.dlt_pipeline_id = x.pipeline_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
SQL Warehouse
Hieronder ziet u welke SQL-warehouses worden gebruikt voor batchdeductie met behulp van de system.compute.warehouses systeemtabel.
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Bekijk de kosten die onder het AI_FUNCTIONS product zijn geregistreerd
Het volgende voorbeeld laat zien hoe je kosten kunt opvragen die onder het AI_FUNCTIONS product zijn geregistreerd. Om te filteren op een specifieke functie, gebruik je het product_features.ai_functions.ai_function veld. Als u bijvoorbeeld alleen ai_parse_document kosten wilt zien, voegt u AND u.product_features.ai_functions.ai_function = "AI_PARSE_DOCUMENT" toe.
SELECT *
FROM system.billing.usage u
WHERE u.workspace_id = <workspace_id>
  AND u.billing_origin_product = "AI_FUNCTIONS";
Bekijk de totale kosten van de AI-functie per gebruiker
Om de totale kosten van de AI-functie-inferentie te berekenen, moet je het gebruik van beide producten meenemen. De volgende zoekopdracht geeft de maandelijkse lijstkosten per gebruiker terug voor de huidige maand en de voorgaande 12 maanden:
SELECT
  DATE_TRUNC('MONTH', u.usage_date)::DATE AS usage_month,
  COALESCE(
    u.identity_metadata.run_as,
    u.identity_metadata.run_by,
    'UNATTRIBUTED'
  ) AS principal,
  ROUND(
    SUM(u.usage_quantity * p.pricing.effective_list.default),
    2
  ) AS list_cost_usd
FROM system.billing.usage u
JOIN system.billing.list_prices p
  ON u.cloud = p.cloud
  AND u.sku_name = p.sku_name
  AND u.usage_unit = p.usage_unit
  AND u.usage_end_time >= p.price_start_time
  AND (p.price_end_time IS NULL OR u.usage_end_time < p.price_end_time)
WHERE p.currency_code = 'USD'
  AND u.usage_date >= ADD_MONTHS(DATE_TRUNC('MONTH', CURRENT_DATE()), -12)
  AND (
    (
      u.billing_origin_product = 'MODEL_SERVING'
      AND u.product_features.model_serving.offering_type = 'BATCH_INFERENCE'
    )
    OR u.billing_origin_product = 'AI_FUNCTIONS'
  )
GROUP BY 1, 2
ORDER BY 1 DESC, 3 DESC;