Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
AI-funktioner är inbyggda funktioner som du kan använda för att tillämpa LLM:er eller toppmoderna forskningstekniker på data lagrade på Azure Databricks för datatransformation och analys. De kan köras från Databricks SQL, anteckningsböcker, Lakeflow-pipelines och arbetsflöden.
AI Functions är enkla att använda, snabba och skalbara. Analytiker kan använda dem för att tillämpa dataintelligens på sina egna data, medan datatekniker, dataforskare och maskininlärningstekniker kan använda dem för att skapa batchpipelines i produktionsklass.
När du anropar en AI-funktion körs din fråga på den beräkning du skickar den från, till exempel ett SQL-lager, en notebook, kluster eller pipeline. Beroende på funktionen kan modellinferensen köras på separat Databricks-hanterad infrastruktur som faktureras utöver den beräkningen. Se Visa kostnader för AI-funktionsarbetsbelastningar.
Requirements
- AI-funktioner finns inte tillgängliga i klassiska SQL-lager.
- Databricks Runtime 15.4 LTS eller högre krävs. Databricks Runtime 18.2 eller högre rekommenderas för bästa prestanda och tillgång till de senaste funktionerna.
Uppgiftsspecifik och generell användning
AI Functions har uppgiftsspecifika och allmänna funktioner:
- Uppgiftsspecifika AI Functions – Specialbyggda funktioner som är optimerade för en specifik uppgift, till exempel dokumentparsning, entitetsextrahering, klassificering och attitydanalys. Dessa funktioner drivs av Azure Databricks-hanterade, forskningsstödda backend-system. Vissa funktioner omfattar användargränssnittsupplevelser. Se Uppgiftsspecifika AI-funktioner för funktioner och modeller som stöds.
-
ai_query— Allmännyttig funktion för flexibilitet i uppgifter och modeller. Ange en fråga och välj valfritt FOUNDATION Model API som stöds. Se Användai_query.
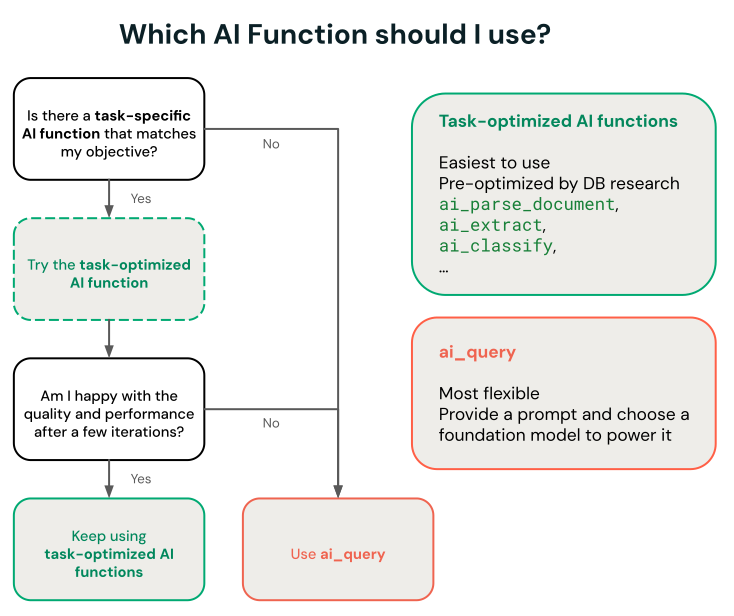
Om du vill begränsa vilka uppgiftsspecifika AI-funktioner din organisation får åtkomst till, se behörigheter för AI Functions i Unity Catalog.
uppgiftsspecifika AI-funktioner
Uppgiftsspecifika funktioner är begränsade till en viss uppgift så att du kan automatisera rutinmässiga transformeringar, till exempel entitetsextrahering, översättning och klassificering. Databricks rekommenderar dessa funktioner för att komma igång eftersom de anropar en toppmodern forskningsteknik som underhålls av Databricks och inte kräver någon anpassning.
Ett exempel finns i Analysera kundrecensioner med hjälp av AI Functions.
Följande funktioner grupperas efter aktivitet. Använd SQL- och REST API-kolumnerna för att öppna referensen för varje gränssnitt. Ett bindestreck i REST API-kolumnen betyder att ingen särskild referens för REST API anges.
Intelligent dokumentbearbetning:
| Funktion | Beskrivning | SQL | REST API |
|---|---|---|---|
ai_parse_document |
Parsa strukturerat innehåll (text, tabeller, bildbeskrivningar) och layout från ostrukturerade dokument med hjälp av toppmoderna forskningstekniker. | SQL-referens | Referens för REST-API |
ai_extract |
Extrahera strukturerade fält från dokument eller text med hjälp av ett schema som du definierar. | SQL-referens | Referens för REST-API |
ai_classify |
Klassificera indatatext enligt etiketter som du anger med hjälp av toppmoderna forskningstekniker. | SQL-referens | Referens för REST-API |
ai_prep_search (Beta) |
Omvandla parsade dokument eller oformaterad text och markdown till sökanpassade textsegment optimerade för AI-sökning och RAG-pipelines. | SQL-referens | — |
ai_search (Beta) |
Hämta rankade, deduplicerade dokument och ett grundat svar på en naturlig språkfråga över en eller flera kunskapskällor. | SQL-referens | — |
ai_enrich (Beta) |
Generera nya kolumner för varje rad från ett schema du definierar, valfritt baserat på AI-sökningsindex eller webbsökning. | SQL-referens | — |
Transformera text:
| Funktion | Beskrivning | SQL | REST API |
|---|---|---|---|
ai_fix_grammar |
Korrigera grammatiska fel i text med hjälp av en toppmodern AI-modell. | SQL-referens | — |
ai_translate |
Översätt text till ett specificerat målspråk med hjälp av en toppmodern AI-modell. | SQL-referens | — |
ai_summarize |
Generera en sammanfattning av texten med hjälp av SQL och en toppmodern AI-modell. | Referens för SQL | — |
ai_mask |
Maskera specificerade entiteter i text med hjälp av en toppmodern AI-modell. | SQL-referens | — |
Analysera ostrukturerad text:
| Funktion | Beskrivning | SQL | REST API |
|---|---|---|---|
ai_decide (Beta) |
Utvärdera frågor mot text eller strukturerad data och returnera sannolikheter, val eller poäng. | Referens för SQL | Referens för REST-API |
ai_analyze_sentiment |
Utför sentimentanalys på inmatad text med hjälp av en toppmodern AI-modell. | SQL-referens | — |
ai_similarity |
Jämför två strängar och beräkna det semantiska likhetsvärdet med hjälp av en toppmodern AI-modell. | SQL-referens | — |
Generera innehåll. För anpassade frågor eller en specifik modell, se Använd ai_query:
| Funktion | Beskrivning | SQL | REST API |
|---|---|---|---|
ai_gen |
Svara på en användargiven prompt med hjälp av en toppmodern AI-modell. | SQL-referens | — |
Förutsäga utfall:
| Funktion | Beskrivning | SQL | REST API |
|---|---|---|---|
ai_predict_class (Beta) |
Träna en klassificeringsmodell och förutsäg klassetiketter för rader där målkolumnen är NULL. |
SQL-referens | — |
ai_predict_value (Beta) |
Träna en regressionsmodell och förutsäg numeriska värden för rader där målkolumnen är NULL. |
SQL-referens | — |
Prognostidsserier:
| Funktion | Beskrivning | SQL | REST API |
|---|---|---|---|
ai_forecast |
Prognostisera data upp till en angiven horisont. Den här tabellvärdesfunktionen är utformad för att extrapolera tidsseriedata i framtiden. | SQL-referens | — |
ai_detect_anomalies (Beta) |
Identifiera avvikande värden i historiska tidsseriedata och returnera förväntade värden, prediktionsgränser och avvikelsepoäng. | SQL-referens | — |
Analysera måttändringar:
| Funktion | Beskrivning | SQL | REST API |
|---|---|---|---|
ai_top_drivers (Beta) |
Rangordna dimensionsvärden som bidrar mest till en ändring i ett mått mellan en kontrollgrupp och en testgrupp. | SQL-referens | — |
Sök med AI Search-inbäddningar:
| Funktion | Beskrivning | SQL | REST API |
|---|---|---|---|
vector_search |
Sök och sök i ett AI-sökindex med hjälp av en toppmodern AI-modell. | SQL-referens | Referens för REST-API |
Använda AI Functions i produktionsarbetsflöden
För storskalig batchinferens kan du integrera uppgiftsspecifika AI Functions eller den allmänna funktionen ai_query i dina produktionsarbetsflöden, till exempel Lakeflow-pipelines, Databricks-arbetsflöden och Structured Streaming. Detta möjliggör bearbetning i produktionsklass i stor skala.
Metodtips för AI-funktioner i produktion:
Låt AI Functions hantera din arbetsbelastning i stor skala: AI Functions hanterar automatiskt parallellisering, återförsök och skalning. Vi rekommenderar att du skickar din fullständiga datamängd i en enda fråga i stället för att dela upp den manuellt i små batchar. Prestanda kanske inte skalas linjärt från mycket små arbetsbelastningar till storskaliga arbetsbelastningar.
Använd Databricks-värdbaserade grundläggande modeller: När du använder ai_query AI-funktionen, använd Databricks-värdbaserade grundläggande modeller (med prefixet databricks-), inte reserverad bandbredd. Dessa slutpunkter utan behov av förtillstånd hanteras helt och hållet och fungerar bäst för batchbearbetning.
Se Distribuera batchinferenspipelines för exempel och detaljer.
Övervaka AI Functions-förlopp
För att förstå hur många slutsatsdragningar som har slutförts eller misslyckats och felsöka prestanda kan du övervaka förloppet för AI Functions med hjälp av frågeprofilfunktionen.
I Databricks Runtime 16.1 ML och senare, från SQL-redigerarens frågefönster i din arbetsyta:
- Välj länken Körning--- längst ned i fönstret Råresultat. Prestandafönstret visas till höger.
- Klicka på Visa frågeprofil för att se prestandainformation.
- Klicka på AI Query för att se mått för den specifika frågan, inklusive antalet slutförda och misslyckade slutsatsdragningar och den totala tid som begäran tog att slutföra.
Visa kostnader för AI-funktionsarbetsbelastningar
Den beräkning som kör din fråga faktureras alltid, till exempel ett SQL-lager eller jobbkluster. Om det finns en ytterligare modellinferenskostnad beror på funktionen:
-
Uppgiftsspecifika funktioner (till exempel
ai_classify,ai_summarize, )ai_translatekör inferenser på Databricks-hanterad serverlös GPU-infrastruktur via Model Serving. Du provisionerar inte denna infrastruktur, men den faktureras utöver din query compute. -
ai_queryfaktureras för den Model Serving-endpoint du angir. Databricks-hostade grundmodellslutpunkter faktureras som de uppgiftsspecifika funktionerna; anpassade modell- och provisionerade genomströmningsändpunkter körs på egen dedikerad servande beräkning och faktureras därefter. -
ai_forecast,ai_detect_anomalies,ai_predict_class,ai_predict_valueochai_top_driverskörs helt på de beräkningsresurser som du skickar dem från, utan någon separat kostnad för inferens. -
vector_searchgör frågor mot ditt AI Search-index via den Databricks-hanterade AI Search-tjänsten.
AI-funktionskostnader registreras som en del av MODEL_SERVING produkten under BATCH_INFERENCE erbjudandetypen. Se Visa kostnader för batchinferensarbetsbelastningar för en exempelfråga.
Anmärkning
För ai_parse_document, ai_extractoch ai_classify registreras kostnader som en del av AI_FUNCTIONS produkten. Se Översikt över kostnader för ai_parse_document körningar för en exempelfråga.
Visa kostnader för batch-inferensjobb
Följande exempel visar hur du filtrerar batchinferensarbetsbelastningar baserat på jobb,beräkning, SQL-lager och Lakeflow-pipelines.
Se Övervaka kostnader för modellserving för allmänna exempel på hur du visar kostnader för dina batchinferencearbetsbelastningar som använder AI Functions.
Jobb
Följande fråga visar vilka jobb som används för batchinferens med hjälp av systemtabellen system.workflow.jobs . Se Övervaka jobbkostnader och prestanda med systemtabeller.
SELECT *
FROM system.billing.usage u
  JOIN system.workflow.jobs x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.job_id = x.job_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Compute
Följande visar vilka kluster som används för batchinferens med hjälp av systemtabellen system.compute.clusters .
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Deklarativa pipelines för Lakeflow Spark
Nedan visas vilka Lakeflow-pipelines som används för batchinferens med systemtabellen system.lakeflow.pipelines.
SELECT *
FROM system.billing.usage u
  JOIN system.lakeflow.pipelines x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.dlt_pipeline_id = x.pipeline_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
SQL-lager
Följande visar vilka SQL-lager som används för batchinferens med hjälp av systemtabellen system.compute.warehouses .
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Visa kostnader för ai_parse_document körningar
I följande exempel visas hur man ställer frågor mot faktureringssystemets tabeller för att visa kostnader för ai_parse_document körningar.
SELECT *
FROM system.billing.usage u
WHERE u.workspace_id = <workspace_id>
  AND u.billing_origin_product = "AI_FUNCTIONS"
  AND u.product_features.ai_functions.ai_function = "AI_PARSE_DOCUMENT";