หมายเหตุ
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลอง ลงชื่อเข้าใช้หรือเปลี่ยนไดเรกทอรีได้
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลองเปลี่ยนไดเรกทอรีได้
ONNX (Open Neural Network Exchange) ให้รันไทม์แบบพกพาที่ปรับให้เหมาะสมกับฮาร์ดแวร์สําหรับโมเดลแมชชีนเลิร์นนิ่ง ด้วยการแปลงโมเดลเป็นรูปแบบ ONNX คุณสามารถเรียกใช้การอนุมานแบบแบตช์บน Spark ด้วยเวลาแฝงที่ต่ํากว่าและไม่ต้องขึ้นอยู่กับเฟรมเวิร์กการฝึกอบรมดั้งเดิมในเวลาคาดการณ์
ในบทความนี้ คุณฝึกแบบจําลอง LightGBM ด้วย SynapseML แปลงเป็นรูปแบบ ONNX และจากนั้น ใช้แบบจําลอง ONNX เพื่อทําการอนุมานบน Spark ใน Microsoft Fabric
ข้อกําหนดเบื้องต้น
รับการสมัครใช้งาน Microsoft Fabric หรือลงทะเบียนเพื่อทดลองใช้งาน Microsoft Fabric ฟรี
ลงชื่อเข้าใช้ Microsoft Fabric
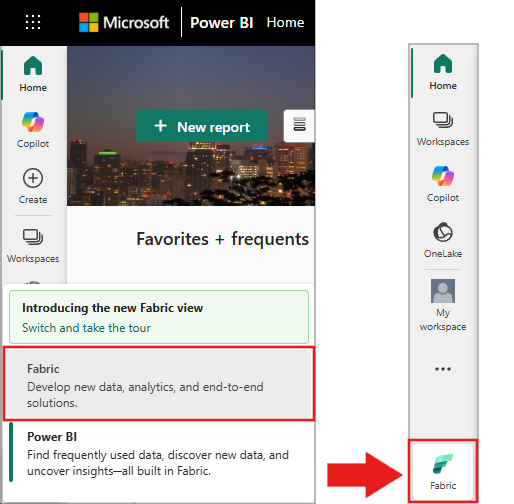
สลับไปยัง Fabric โดยใช้ตัวสลับประสบการณ์ที่ด้านซ้ายล่างของโฮมเพจของคุณ
- แนบสมุดบันทึกของคุณเข้ากับเลคเฮ้าส์ ทางด้านซ้ายของสมุดบันทึกของคุณ ให้เลือก เพิ่ม เพื่อเพิ่มเลคเฮาส์ที่มีอยู่หรือสร้างเลคเฮาส์
- Fabric Runtime 1.2 หรือใหม่กว่า
ติดตั้งแพ็คเกจที่จําเป็น
เรียกใช้เซลล์ต่อไปนี้ในสมุดบันทึกของคุณเพื่อติดตั้งแพคเกจที่จําเป็น แพคเกจ onnxmltools ไม่ได้ติดตั้งไว้ล่วงหน้าในรันไทม์ Fabric
%pip install onnxmltools --quiet
หลังจากการติดตั้งเสร็จสิ้น ให้ตรวจสอบว่าแพ็คเกจพร้อมใช้งาน:
import onnxmltools
import lightgbm
print(f"onnxmltools version: {onnxmltools.__version__}")
print(f"lightgbm version: {lightgbm.__version__}")
Note
แพคเกจ lightgbm ได้รับการติดตั้งไว้ล่วงหน้าใน Fabric Runtime 1.2 และใหม่กว่า คุณต้องติดตั้ง onnxmltoolsเท่านั้น
โหลดข้อมูลตัวอย่าง
โหลดชุดข้อมูลการคาดการณ์การล้มละลายจาก Azure Blob Storage สาธารณะ:
df = (
    spark.read.format("csv")
    .option("header", True)
    .option("inferSchema", True)
    .load(
        "wasbs://publicwasb@mmlspark.blob.core.windows.net/company_bankruptcy_prediction_data.csv"
    )
)

print(f"Rows: {df.count()}, Columns: {len(df.columns)}")
display(df.limit(5))
ตารางที่แสดงประกอบด้วยคอลัมน์เช่น:
| ล้มละลาย? | ธงรายได้สุทธิ | ส่วนของผู้ถือหุ้นที่มีภาระความรับผิด |
|---|---|---|
| 0 | 1.0 | 0.0165 |
| 0 | 1.0 | 0.0208 |
ฝึกโมเดล LightGBM
ใช้คอลัมน์VectorAssemblerเพื่อรวมคุณลักษณะ จากนั้นฝึก :LightGBMClassifier
from pyspark.ml.feature import VectorAssembler
from synapse.ml.lightgbm import LightGBMClassifier

feature_cols = df.columns[1:]
featurizer = VectorAssembler(inputCols=feature_cols, outputCol="features")

train_data = featurizer.transform(df)["Bankrupt?", "features"]

model = (
    LightGBMClassifier(featuresCol="features", labelCol="Bankrupt?")
    .setDataTransferMode("bulk")
    .setEarlyStoppingRound(300)
    .setLambdaL1(0.5)
    .setNumIterations(1000)
    .setNumThreads(-1)
    .setMaxDeltaStep(0.5)
    .setNumLeaves(31)
    .setMaxDepth(-1)
    .setBaggingFraction(0.7)
    .setFeatureFraction(0.7)
    .setBaggingFreq(2)
    .setObjective("binary")
    .setIsUnbalance(True)
    .setMinSumHessianInLeaf(20)
    .setMinGainToSplit(0.01)
)

model = model.fit(train_data)
ตรวจสอบโมเดลที่ผ่านการฝึกอบรมเรียบร้อยแล้ว:
print(f"Model type: {type(model).__name__}")
print(f"Number of features: {len(feature_cols)}")
แปลงแบบจําลองเป็นรูปแบบ ONNX
ส่งออกโมเดลที่ผ่านการฝึกอบรมไปยังบูสเตอร์ LightGBM จากนั้นแปลงเป็น ONNX:
import lightgbm as lgb
from typing import Union
from lightgbm import Booster, LGBMClassifier
from onnxmltools.convert import convert_lightgbm
from onnxmltools.convert.common.data_types import FloatTensorType


def convert_to_onnx(lgbm_model: Union[LGBMClassifier, Booster], input_size: int) -> bytes:
    initial_types = [("input", FloatTensorType([-1, input_size]))]
    onnx_model = convert_lightgbm(
        lgbm_model, initial_types=initial_types, target_opset=13
    )
    return onnx_model.SerializeToString()


booster_model_str = model.getLightGBMBooster().modelStr().get()
booster = lgb.Booster(model_str=booster_model_str)
model_payload_ml = convert_to_onnx(booster, len(feature_cols))
ตรวจสอบว่าการแปลง ONNX สําเร็จ:
print(f"ONNX model payload size: {len(model_payload_ml)} bytes")
assert len(model_payload_ml) > 0, "ONNX conversion failed: empty payload"
เอาต์พุตแสดงขนาดเพย์โหลดของโมเดล ONNX เป็นไบต์ (โดยทั่วไปประมาณ 800,000 ไบต์)
สำคัญ
ใช้สําหรับ from onnxmltools.convert.common.data_types import FloatTensorType คํานิยามประเภท เส้นทาง from onnxconverter_common.data_types import FloatTensorType การนําเข้าที่เก่ากว่าเข้ากันไม่ได้กับเวอร์ชันปัจจุบันของ onnxmltools.
โหลดและกําหนดค่าโมเดล ONNX
โหลดเพย์โหลด ONNX ลงใน SynapseML ONNXModel และตรวจสอบอินพุตและเอาต์พุตของโมเดล:
from synapse.ml.onnx import ONNXModel

onnx_ml = ONNXModel().setModelPayload(model_payload_ml)

print("Model inputs:" + str(onnx_ml.getModelInputs()))
print("Model outputs:" + str(onnx_ml.getModelOutputs()))
เอาต์พุตแสดงรายการโหนดอินพุตและเอาต์พุตของโมเดล
กําหนดค่าแบบจําลองโดยการแม็ปคอลัมน์อินพุตและเอาต์พุต การ FeedDict แมปชื่ออินพุตแบบจําลอง ONNX กับชื่อคอลัมน์ DataFrame การ FetchDict แมปชื่อคอลัมน์เอาต์พุตที่ต้องการกับชื่อเอาต์พุตแบบจําลอง ONNX:
onnx_ml = (
    onnx_ml.setDeviceType("CPU")
    .setFeedDict({"input": "features"})
    .setFetchDict({"probability": "probabilities", "prediction": "label"})
    .setMiniBatchSize(5000)
)
เรียกใช้การอนุมาน
สร้างข้อมูลทดสอบและแปลงผ่านโมเดล ONNX:
from pyspark.ml.feature import VectorAssembler
import pandas as pd
import numpy as np

n = 10000
m = 95
test = np.random.rand(n, m)
testPdf = pd.DataFrame(test)
cols = list(map(str, testPdf.columns))
testDf = spark.createDataFrame(testPdf)
testDf = testDf.repartition(4)
testDf = (
    VectorAssembler()
    .setInputCols(cols)
    .setOutputCol("features")
    .transform(testDf)
    .drop(*cols)
    .cache()
)

display(onnx_ml.transform(testDf))
Note
เนื่องจากข้อมูลการทดสอบถูกสร้างขึ้นแบบสุ่ม ค่าการคาดการณ์จึงไม่ได้แสดงถึงผลลัพธ์ในโลกแห่งความเป็นจริง ส่วนนี้แสดงให้เห็นว่าโมเดล ONNX ทํางานอย่างถูกต้องบน Spark
ผลลัพธ์ควรมีคอลัมน์สําหรับ features, predictionและ probability:
| คุณลักษณะ | การคาดคะเน | ความน่าจะเป็น |
|---|---|---|
{"type":1,"values":[0.105... |
0 | {"0":0.835... |
{"type":1,"values":[0.814... |
0 | {"0":0.658... |
ตรวจสอบผลลัพธ์ที่สร้างการอนุมาน:
results = onnx_ml.transform(testDf)
print(f"Result count: {results.count()}")
print(f"Output columns: {results.columns}")
assert "prediction" in results.columns, "Missing prediction column"
assert "probability" in results.columns, "Missing probability column"
ผลลัพธ์ยืนยันว่าแถวการทดสอบทั้งหมดได้รับการให้คะแนน และผลลัพธ์ DataFrame ประกอบด้วยfeaturesคอลัมน์ , predictionและprobability
แก้ไข ปัญหา
| ประเด็น | สาเหตุ | การแก้ปัญหา |
|---|---|---|
ModuleNotFoundError: No module named 'onnxmltools' |
แพคเกจไม่ได้ติดตั้งไว้ล่วงหน้าในรันไทม์ Fabric | เรียกใช้ %pip install onnxmltools --quiet และรีสตาร์ทเคอร์เนล Python |
RuntimeError: Operator LgbmClassifier got an input with a wrong type |
เส้นทางการนําเข้าไม่ถูกต้องสําหรับ FloatTensorType. |
ใช้ from onnxmltools.convert.common.data_types import FloatTensorType แทนการนําเข้าจาก onnxconverter_common.data_types. |
ModuleNotFoundError: No module named 'onnx.mapping' |
เข้ากันไม่ได้onnxmltoolsกับเวอร์ชัน 1.7.0 หรือก่อนหน้ากับแพ็คเกจปัจจุบันonnx |
เรียกใช้ %pip install onnxmltools --upgrade --quiet เพื่อติดตั้งเวอร์ชันที่เข้ากันได้ |
ONNX conversion returns empty payload |
การแยกสตริงโมเดลบูสเตอร์ล้มเหลว | ยืนยันว่า model.getLightGBMBooster().modelStr().get() ส่งคืนสตริงที่ไม่ว่างเปล่าก่อนการแปลง |
Feature (Column_) appears more than one time ระหว่าง model.fit() |
คอลัมน์ชุดข้อมูลที่มีอักขระพิเศษจะสร้างชื่อที่ซ้ํากันหลังจากการฆ่าเชื้อ LightGBM | เพิ่ม .setDataTransferMode("bulk") ใน LightGBMClassifier การกําหนดค่า โหมดจํานวนมากใช้ Apache Arrow และหลีกเลี่ยงปัญหาการฆ่าเชื้อชื่อคอลัมน์ |
AssertionError บน SparkContext ใน ONNXModel() |
เซสชัน Spark ไม่ได้เริ่มต้น | เรียกใช้รหัสนี้ในสมุดบันทึก Fabric ที่มีเลคเฮาส์แนบอยู่ ตัวแปร spark ถูกเตรียมใช้งานล่วงหน้าโดยรันไทม์ |
ล้างแหล่งข้อมูล
ถ้าคุณไม่ต้องการ DataFrame ทดสอบที่แคชไว้อีกต่อไป ให้ยกเลิกการคงอยู่เพื่อเพิ่มหน่วยความจําคลัสเตอร์:
testDf.unpersist()