หมายเหตุ
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลอง ลงชื่อเข้าใช้หรือเปลี่ยนไดเรกทอรีได้
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลองเปลี่ยนไดเรกทอรีได้
คุณสามารถใช้บริการ Azure OpenAI เพื่อแก้ปัญหาภาษาธรรมชาติจํานวนมากโดยแจ้ง API การเสร็จสมบูรณ์ เพื่อให้ง่ายต่อการปรับขนาดเวิร์กโฟลว์การแจ้งของคุณจากตัวอย่างไม่กี่ตัวอย่างไปจนถึงชุดข้อมูลตัวอย่างขนาดใหญ่ Azure บริการ OpenAI จะรวมเข้ากับไลบรารีแมชชีนเลิร์นนิงแบบกระจาย SynapseML เมื่อใช้การผสานรวมนี้ คุณสามารถใช้เฟรมเวิร์กการประมวลผลแบบกระจาย Apache Spark เพื่อประมวลผลข้อความแจ้งนับล้านด้วยบริการ OpenAI บทช่วยสอนนี้แสดงวิธีการใช้แบบจําลองภาษาขนาดใหญ่ในระดับแบบกระจายโดยใช้ Azure OpenAI และ Microsoft Fabric
ข้อกำหนดเบื้องต้น
ข้อกําหนดเบื้องต้นที่สําคัญสําหรับการเริ่มต้นใช้งานด่วนนี้ ได้แก่ ทรัพยากร Azure OpenAI ที่ใช้งานได้และคลัสเตอร์ Apache Spark ที่ติดตั้ง SynapseML
รับการสมัครใช้งาน Microsoft Fabric หรือลงทะเบียนเพื่อทดลองใช้ Microsoft Fabric ฟรี
ลงชื่อเข้าใช้ Microsoft Fabric
สลับไปยัง Fabric โดยใช้ตัวสลับประสบการณ์ที่ด้านซ้ายล่างของโฮมเพจของคุณ
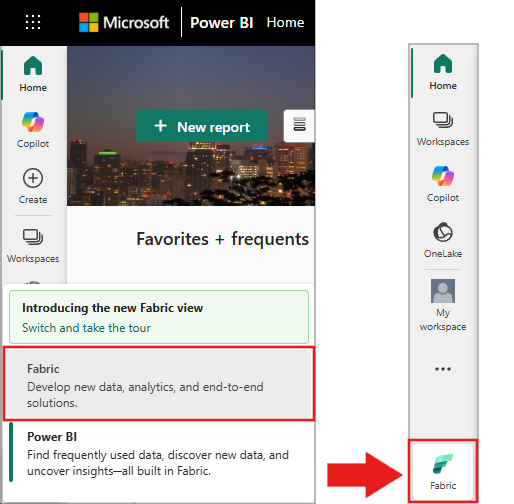
- ไปที่งาน Data Science ใน Microsoft Fabric
- สร้าง สมุดบันทึกใหม่
- ทรัพยากร OpenAI Azure - สร้างทรัพยากร
นําเข้าคู่มือนี้เป็นสมุดบันทึก
ขั้นตอนถัดไปคือการเพิ่มรหัสนี้ลงในคลัสเตอร์ Spark ของคุณ คุณสามารถสร้างสมุดบันทึกในแพลตฟอร์ม Spark ของคุณและคัดลอกรหัสลงในสมุดบันทึกนี้เพื่อเรียกใช้การสาธิตได้
- ดาวน์โหลดเดโมนี้เป็นสมุดบันทึก (เลือก Raw แล้วบันทึกไฟล์)
- นําเข้าไปยังพื้นที่ทํางาน Fabric
- ใช้คู่มือการติดตั้งเพื่อติดตั้ง SynapseML บนคลัสเตอร์ของคุณ ขั้นตอนนี้ต้องวางเซลล์พิเศษที่ด้านบนของสมุดบันทึกที่คุณนําเข้า
- เชื่อมต่อสมุดบันทึกของคุณกับคลัสเตอร์ และทําตาม แก้ไข และเรียกใช้เซลล์
กรอกข้อมูลบริการ
ถัดไป แก้ไขเซลล์ในสมุดบันทึกเพื่อชี้ไปยังบริการของคุณ ตั้งค่า service_name, deployment_name, และlocationkeyตัวแปรให้ตรงกับบริการ OpenAI ของคุณ:
import os
from pyspark.sql import SparkSession
from synapse.ml.core.platform import running_on_synapse, find_secret

# Bootstrap Spark Session
spark = SparkSession.builder.getOrCreate()

if running_on_synapse():
    from notebookutils.visualization import display

# Fill in the following lines with your service information
# Learn more about selecting which embedding model to choose: https://openai.com/blog/new-and-improved-embedding-model
service_name = "synapseml-openai"
deployment_name = "gpt-4.1-mini"
deployment_name_embeddings = "text-embedding-3-small"

key = find_secret(
    "openai-api-key"
)  # please replace this line with your key as a string

assert key is not None and service_name is not None
สร้างชุดข้อมูลของพร้อมท์
ถัดไป สร้าง DataFrame ที่ประกอบด้วยชุดของแถว โดยมีพรอมต์หนึ่งรายการต่อแถว
คุณยังสามารถโหลดข้อมูลได้โดยตรงจาก ADLS หรือฐานข้อมูลอื่นๆ สําหรับข้อมูลเพิ่มเติมเกี่ยวกับการโหลดและเตรียม Spark DataFrames โปรดดูคู่มือการโหลดข้อมูล Apache Spark
df = spark.createDataFrame(
    [
        ("Hello my name is",),
        ("The best code is code that's",),
        ("SynapseML is ",),
    ]
).toDF("prompt")
สร้างไคลเอ็นต์ OpenAIPrompt Apache Spark
เพื่อใช้บริการ Azure OpenAI กับ DataFrame ของคุณ ให้สร้างOpenAIPromptวัตถุที่ทําหน้าที่เป็นไคลเอนต์แบบกระจาย ตั้งค่าพารามิเตอร์บริการด้วยค่าเดียวหรือคอลัมน์ DataFrame โดยใช้ตัวตั้งค่าที่เหมาะสมบน OpenAIPrompt วัตถุ ในตัวอย่างนี้ ให้ตั้งค่า maxTokens เป็น 200 โทเค็นมีอักขระประมาณ 4 ตัว และขีดจํากัดนี้ใช้กับผลรวมของพรอมต์และผลลัพธ์ ตั้งค่า promptCol พารามิเตอร์ด้วยชื่อคอลัมน์พรอมต์ใน DataFrame
from synapse.ml.services.openai import OpenAIPrompt

completion = (
    OpenAIPrompt()
    .setSubscriptionKey(key)
    .setDeploymentName(deployment_name)
    .setCustomServiceName(service_name)
    .setMaxTokens(200)
    .setPromptCol("prompt")
    .setErrorCol("error")
    .setOutputCol("completions")
)
แปลง DataFrame โดยใช้ไคลเอนต์ OpenAIPrompt
หลังจากสร้าง DataFrame และไคลเอนต์พรอมต์แล้ว ให้แปลงชุดข้อมูลอินพุตของคุณและเพิ่มคอลัมน์ที่มีชื่อ completions ทั้งหมดตามข้อมูลที่บริการเพิ่มเข้ามา เลือกเพียงข้อความเพื่อความง่าย
from pyspark.sql.functions import col

completed_df = completion.transform(df).cache()
display(
    completed_df.select(
        col("prompt"),
        col("error"),
        col("completions.choices.text").getItem(0).alias("text"),
    )
)
ผลลัพธ์ของคุณควรมีลักษณะดังนี้ ข้อความที่เสร็จสมบูรณ์จะแตกต่างจากตัวอย่าง
| พร้อมท์ | ความผิดพลาด | ข้อความ |
|---|---|---|
| สวัสดี ชื่อของฉันคือ | null | Makaveli ฉันอายุ 18 ปี และฉันอยากเป็นแร็ปเปอร์เมื่อโตขึ้น ฉันชอบเขียนและทําเพลง ฉันมาจากลอสแองเจลิส แคลิฟอร์เนีย |
| รหัสที่ดีที่สุดคือรหัสที่เป็น | null | เข้าใจได้ นี่เป็นข้อความส่วนตัวและไม่มีคําตอบที่แน่ชัด |
| SynapseML คือ | null | อัลกอริทึมแมชชีนเลิร์นนิงที่สามารถเรียนรู้วิธีคาดการณ์ผลลัพธ์ในอนาคตของเหตุการณ์ |
ตัวอย่างการใช้งานเพิ่มเติม
การสร้างการฝังข้อความ
นอกเหนือจากการเติมข้อความแล้ว คุณยังสามารถฝังข้อความเพื่อใช้ในอัลกอริทึมดาวน์สตรีมหรือสถาปัตยกรรมการดึงข้อมูลเวกเตอร์ได้อีกด้วย ด้วยการสร้างการฝัง คุณสามารถค้นหาและดึงเอกสารจากคอลเลกชันขนาดใหญ่ได้ ใช้วิธีการนี้เมื่อวิศวกรรมพร้อมท์ไม่เพียงพอสําหรับงาน สําหรับข้อมูลเพิ่มเติมเกี่ยวกับการใช้งาน OpenAIEmbeddingโปรดดูคู่มือการฝัง
from synapse.ml.services.openai import OpenAIEmbedding

embedding = (
    OpenAIEmbedding()
    .setSubscriptionKey(key)
    .setDeploymentName(deployment_name_embeddings)
    .setCustomServiceName(service_name)
    .setTextCol("prompt")
    .setErrorCol("error")
    .setOutputCol("embeddings")
)

display(embedding.transform(df))
การแชทเสร็จสมบูรณ์
โมเดลเช่น GPT-4o และ GPT-4.1 เข้าใจการแชทแทนข้อความแจ้งเดียว ตัว OpenAIChatCompletion แปลงจะแสดงฟังก์ชันการทํางานนี้ในระดับมาตราส่วน
from synapse.ml.services.openai import OpenAIChatCompletion
from pyspark.sql import Row
from pyspark.sql.types import *


def make_message(role, content):
    return Row(role=role, content=content, name=role)


chat_df = spark.createDataFrame(
    [
        (
            [
                make_message(
                    "system", "You are an AI chatbot with red as your favorite color"
                ),
                make_message("user", "What's your favorite color"),
            ],
        ),
        (
            [
                make_message("system", "You are very excited"),
                make_message("user", "How are you today"),
            ],
        ),
    ]
).toDF("messages")


chat_completion = (
    OpenAIChatCompletion()
    .setSubscriptionKey(key)
    .setDeploymentName(deployment_name)
    .setCustomServiceName(service_name)
    .setMessagesCol("messages")
    .setErrorCol("error")
    .setOutputCol("chat_completions")
)

display(
    chat_completion.transform(chat_df).select(
        "messages", "chat_completions.choices.message.content"
    )
)
ปรับปรุงปริมาณงานด้วยการทําชุดงานคําขอ
ตัวอย่างทําให้หลายคําขอไปยังบริการ หนึ่งคําขอสําหรับแต่ละพร้อมท์ เมื่อต้องการดําเนินการพร้อมท์หลายรายการให้เสร็จสมบูรณ์ในคําขอเดียว ให้ใช้โหมดชุดงาน ขั้นแรก ใน OpenAIPrompt วัตถุ แทนที่จะตั้งค่าคอลัมน์ พรอมต์ เป็น "พร้อมท์" ให้ระบุ "batchPrompt" สําหรับคอลัมน์ BatchPrompt
สร้าง DataFrame พร้อมรายการพรอมต์ต่อแถว
batch_df = spark.createDataFrame(
    [
        (["The time has come", "Pleased to", "Today stocks", "Here's to"],),
        (["The only thing", "Ask not what", "Every litter", "I am"],),
    ]
).toDF("batchPrompt")
จากนั้นสร้าง OpenAIPrompt วัตถุ ให้ตั้งค่าคอลัมน์ batchPrompt แทนการตั้งค่าคอลัมน์ batchPrompt หากคอลัมน์ของคุณเป็นชนิดArray[String]
batch_completion = (
    OpenAIPrompt()
    .setSubscriptionKey(key)
    .setDeploymentName(deployment_name)
    .setCustomServiceName(service_name)
    .setMaxTokens(200)
    .setBatchPromptCol("batchPrompt")
    .setErrorCol("error")
    .setOutputCol("completions")
)
ในการเรียกให้แปลง จะมีการร้องขอต่อแถว เนื่องจากแต่ละแถวมีข้อความแจ้งหลายรายการ แต่ละคําขอจะส่งข้อความแจ้งทั้งหมดในแถวนั้น ผลลัพธ์ประกอบด้วยแถวสําหรับแต่ละแถวในคําขอ
completed_batch_df = batch_completion.transform(batch_df).cache()
display(completed_batch_df)
การใช้เครื่องมินิแบทเชอร์อัตโนมัติ
หากข้อมูลของคุณอยู่ในรูปแบบคอลัมน์ คุณสามารถเปลี่ยนเป็นรูปแบบแถวได้โดยใช้ SynapseML's FixedMiniBatcherTransformer.
from pyspark.sql.types import StringType
from synapse.ml.stages import FixedMiniBatchTransformer
from synapse.ml.core.spark import FluentAPI

completed_autobatch_df = (
    df.coalesce(
        1
    )  # Force a single partition so that our little 4-row DataFrame makes a batch of size 4, you can remove this step for large datasets
    .mlTransform(FixedMiniBatchTransformer(batchSize=4))
    .withColumnRenamed("prompt", "batchPrompt")
    .mlTransform(batch_completion)
)

display(completed_autobatch_df)
วิศวกรรมพร้อมท์สําหรับการแปล
บริการ OpenAI ของ Azure สามารถแก้ปัญหาภาษาธรรมชาติต่างๆ ได้มากมายผ่าน prompt engineering ตัวอย่างนี้แสดงข้อความแจ้งสําหรับการแปลภาษา:
translate_df = spark.createDataFrame(
    [
        ("Japanese: Ookina hako \nEnglish: Big box \nJapanese: Midori tako\nEnglish:",),
        (
            "French: Quel heure et il au Montreal? \nEnglish: What time is it in Montreal? \nFrench: Ou est le poulet? \nEnglish:",
        ),
    ]
).toDF("prompt")

display(completion.transform(translate_df))
พร้อมท์สําหรับการตอบคําถาม
ตัวอย่างนี้พร้อมท์โมเดลสําหรับการตอบคําถามความรู้ทั่วไป:
qa_df = spark.createDataFrame(
    [
        (
            "Q: Where is the Grand Canyon?\nA: The Grand Canyon is in Arizona.\n\nQ: What is the weight of the Burj Khalifa in kilograms?\nA:",
        )
    ]
).toDF("prompt")

display(completion.transform(qa_df))