Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Funkcje AI to wbudowane funkcje, które można wykorzystać do zastosowania LLM-ów lub nowoczesnych technik badawczych na danych przechowywanych w Azure Databricks do transformacji i analizy danych. Można je uruchamiać z Databricks SQL, notatników, potoków Lakeflow i Workflows.
Funkcje sztucznej inteligencji są proste w użyciu, szybkie i skalowalne. Analitycy mogą ich używać do stosowania analizy danych do własnych danych, podczas gdy inżynierowie danych, analitycy danych i inżynierowie uczenia maszynowego mogą ich używać do tworzenia potoków wsadowych klasy produkcyjnej.
Gdy wywołujesz funkcję AI, Twoje zapytanie jest uruchamiane w zasobach obliczeniowych, z których je wysyłasz, takich jak hurtownia SQL, notatnik, klaster lub potok danych. W zależności od funkcji wnioskowanie przez model może być uruchamiane na oddzielnej infrastrukturze zarządzanej przez Databricks, która jest rozliczana dodatkowo względem tego zasobu obliczeniowego. Zobacz koszty obciążeń funkcji AI.
Requirements
- Funkcje AI nie są dostępne w magazynach Classic SQL.
- Wymagany jest Databricks Runtime 15.4 LTS lub nowszy. Zaleca się wersję Databricks Runtime 18.2 lub nowszą dla najlepszej wydajności i dostępu do najnowszych funkcji.
Zadanie specyficzne i ogólnego przeznaczenia
Funkcje sztucznej inteligencji mają funkcje specyficzne dla zadań i ogólnego przeznaczenia:
- Funkcje sztucznej inteligencji specyficzne dla zadań — wbudowane funkcje przeznaczone do określonego zadania, takie jak analizowanie dokumentów, wyodrębnianie jednostek, klasyfikacja i analiza tonacji. Te funkcje są obsługiwane przez systemy zarządzane przez Azure Databricks, wspierane wynikami badań. Niektóre funkcje obejmują interakcje z interfejsem użytkownika. Zobacz Funkcje sztucznej inteligencji specyficzne dla zadań , aby zapoznać się z obsługiwanymi funkcjami i modelami.
-
ai_query— Funkcja ogólnego przeznaczenia na potrzeby zadań i elastyczności modelu. Podaj zapytanie i wybierz dowolny obsługiwany interfejs API modelu bazowego. Zobacz Użycieai_query.
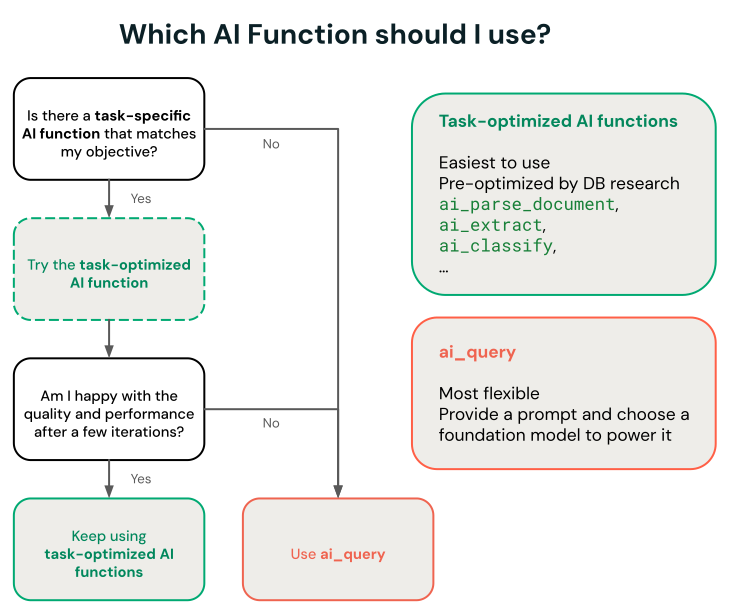
Aby ograniczyć, do których funkcji AI dla określonych zadań Twoja organizacja ma dostęp, zobacz uprawnienia Unity Catalog dla AI Functions.
funkcje sztucznej inteligencji specyficzne dla zadań
Funkcje specyficzne dla zadania są ograniczone do określonego zadania, dzięki czemu można zautomatyzować rutynowe przekształcenia, takie jak wyodrębnianie jednostek, tłumaczenie i klasyfikacja. Usługa Databricks zaleca te funkcje do rozpoczęcia pracy, ponieważ wywołują najnowocześniejsze techniki badawcze obsługiwane przez usługę Databricks i nie wymagają żadnych dostosowań.
Zobacz Analizowanie recenzji klientów za pomocą funkcji sztucznej inteligencji, aby zapoznać się z przykładem.
Następujące funkcje są pogrupowane według zadania. Użyj kolumn SQL i REST API, aby otworzyć referencję dla każdego interfejsu. Kreska w kolumnie REST API oznacza, że nie ma dedykowanego odniesienia REST API.
Inteligentne przetwarzanie dokumentów:
| Funkcja | Opis | SQL | interfejs API REST |
|---|---|---|---|
ai_parse_document |
Analizowanie zawartości ustrukturyzowanej (tekstu, tabel, opisów rysunków) i układu z dokumentów bez struktury przy użyciu najnowocześniejszych technik badawczych. | Dokumentacja referencyjna SQL | Dokumentacja interfejsu API REST |
ai_extract |
Wyodrębnij pola ustrukturyzowane z dokumentów lub tekstu przy użyciu zdefiniowanego schematu. | Dokumentacja referencyjna SQL | Dokumentacja interfejsu API REST |
ai_classify |
Klasyfikuj tekst wejściowy zgodnie z etykietami, które udostępniasz przy użyciu najnowocześniejszych technik badawczych. | Dokumentacja referencyjna SQL | Dokumentacja interfejsu API REST |
ai_prep_search (Wersja beta) |
Przekształcaj parsowane dokumenty lub zwykły tekst i Markdown w fragmenty gotowe do przeszukiwania, zoptymalizowane na potrzeby potoków AI Search i RAG. | Dokumentacja referencyjna SQL | — |
ai_search (Wersja beta) |
Pobierz uporządkowane, zdeduplikowane dokumenty oraz ugruntowaną odpowiedź na zapytanie w języku naturalnym nad jednym lub więcej źródłami wiedzy. | Dokumentacja referencyjna SQL | — |
ai_enrich (Wersja beta) |
Generuj nowe kolumny dla każdego wiersza na podstawie zdefiniowanego przez siebie schematu, opcjonalnie opartego na źródłach wiedzy, takich jak indeksy AI Search lub narzędzie wyszukiwania na zewnętrznym serwerze Model Context Protocol (MCP). | Dokumentacja referencyjna SQL | — |
Przekształć tekst:
| Funkcja | Opis | SQL | interfejs API REST |
|---|---|---|---|
ai_fix_grammar |
Koryguj błędy gramatyczne w tekście, korzystając z nowoczesnego modelu AI. | Dokumentacja referencyjna SQL | — |
ai_translate |
Przetłumacz tekst na określony język docelowy, korzystając z nowoczesnego modelu AI. | Dokumentacja referencyjna SQL | — |
ai_summarize |
Wygeneruj podsumowanie tekstu za pomocą SQL i nowoczesnego modelu AI. | Dokumentacja referencyjna SQL | — |
ai_mask |
Maskuj określone jednostki w tekście za pomocą nowoczesnego modelu AI. | Dokumentacja referencyjna SQL | — |
Analizuj tekst nieustrukturyzowany:
| Funkcja | Opis | SQL | interfejs API REST |
|---|---|---|---|
ai_decide (Wersja beta) |
Oceniaj pytania na podstawie tekstu lub danych strukturalnych i zwracaj prawdopodobieństwa, wybory lub wyniki. | Dokumentacja referencyjna SQL | Dokumentacja interfejsu API REST |
ai_analyze_sentiment |
Przeprowadz analizę sentymentu tekstu wejściowego, korzystając z nowoczesnego modelu AI. | Dokumentacja referencyjna SQL | — |
ai_similarity |
Porównaj dwa ciągi i oblicz wynik podobieństwa semantycznego za pomocą nowoczesnego modelu AI. | Dokumentacja referencyjna SQL | — |
Generowanie zawartości. Aby uzyskać monity niestandardowe lub określony model, zobacz sekcję Use ai_query:
| Funkcja | Opis | SQL | interfejs API REST |
|---|---|---|---|
ai_gen |
Odpowiedz na prompt użytkownika za pomocą nowoczesnego modelu AI. | Dokumentacja referencyjna SQL | — |
Przewiduj wyniki:
| Funkcja | Opis | SQL | interfejs API REST |
|---|---|---|---|
ai_predict_class (Wersja beta) |
Wytrenuj model klasyfikacji i przewiduj etykiety klas dla wierszy, gdzie kolumna docelowa to NULL. |
Dokumentacja referencyjna SQL | — |
ai_predict_value (Wersja beta) |
Wytrenuj model regresji i przewiduj wartości numeryczne dla wierszy, gdzie kolumna docelowa to NULL. |
Dokumentacja referencyjna SQL | — |
Seria czasowa prognozy:
| Funkcja | Opis | SQL | interfejs API REST |
|---|---|---|---|
ai_forecast |
Prognoza danych na określony horyzont. Ta funkcja o wartości tabeli została zaprojektowana w celu ekstrapolacji danych szeregów czasowych w przyszłości. | Dokumentacja referencyjna SQL | — |
ai_detect_anomalies (Wersja beta) |
Zidentyfikuj anomalne wartości w danych historycznych szeregów czasowych i zwracaj wartości oczekiwane, granice predykcji oraz wyniki anomalii. | Dokumentacja referencyjna SQL | — |
Analizowanie zmian metryk:
| Funkcja | Opis | SQL | interfejs API REST |
|---|---|---|---|
ai_top_drivers (Wersja beta) |
Klasyfikacja wartości wymiarów, które przyczyniają się najbardziej do zmiany metryki między grupą kontrolną a grupą testową. | Dokumentacja referencyjna SQL | — |
Wyszukiwanie za pomocą osadzania wyszukiwania sztucznej inteligencji:
| Funkcja | Opis | SQL | interfejs API REST |
|---|---|---|---|
vector_search |
Wyszukaj i zapytaj indeks AI Search za pomocą nowoczesnego modelu AI. | Dokumentacja referencyjna SQL | Dokumentacja interfejsu API REST |
Korzystanie z funkcji sztucznej inteligencji w przepływach pracy produkcyjnych
W przypadku inferencji wsadowej na dużą skalę można zintegrować funkcje AI przeznaczone do konkretnych zadań lub funkcję ogólnego przeznaczenia ai_query z produkcyjnymi przepływami pracy, takimi jak potoki Lakeflow, przepływy pracy Databricks i Structured Streaming. Umożliwia to przetwarzanie klasy produkcyjnej na dużą skalę.
Najlepsze rozwiązania dotyczące funkcji sztucznej inteligencji w środowisku produkcyjnym:
Pozwól usłudze AI Functions obsługiwać obciążenie na dużą skalę: Funkcje sztucznej inteligencji automatycznie zarządzają przetwarzaniem równoległym, ponawianiem prób i skalowaniem. Zaleca się przesłanie pełnego zestawu danych w jednym zapytaniu, a nie ręczne podzielenie go na małe partie. Wydajność może nie być skalowana liniowo z bardzo małych obciążeń do obciążeń na dużą skalę.
Korzystanie z modeli bazowych hostowanych w usłudze Databricks: W przypadku korzystania z funkcji AI ai_query, należy używać modeli bazowych hostowanych w usłudze Databricks (poprzedzonych prefiksem databricks-), a nie przepływności zapewnionej. Te punkty końcowe bez aprowizacji są w pełni zarządzane i działają najlepiej w przypadku przetwarzania wsadowego.
Zobacz Wdrażanie potoków wnioskowania wsadowego, aby uzyskać przykłady i szczegóły.
Monitorowanie postępu funkcji sztucznej inteligencji
Aby dowiedzieć się, ile wniosków zostało ukończonych lub zakończonych niepowodzeniem i rozwiązać problemy z wydajnością, możesz monitorować postęp funkcji sztucznej inteligencji przy użyciu funkcji profilu zapytania.
W środowisku Databricks Runtime 16.1 ML lub nowszym w oknie zapytania edytora SQL w obszarze roboczym:
- Wybierz link Running--- w dolnej części okna Raw results. Po prawej stronie zostanie wyświetlone okno wydajności .
- Kliknij pozycję Zobacz profil zapytania , aby wyświetlić szczegóły wydajności.
- Kliknij Zapytanie AI, aby wyświetlić metryki dla tego konkretnego zapytania, w tym liczbę ukończonych i nieudanych wnioskowań oraz całkowity czas realizacji żądania.
Wyświetlanie kosztów obciążeń funkcji sztucznej inteligencji
Zasoby obliczeniowe, na których uruchamiane jest Twoje zapytanie, są zawsze rozliczane, na przykład hurtownia SQL lub klaster zadań. To, czy istnieje dodatkowy koszt wnioskowania modelu, zależy od funkcji:
-
Funkcje specyficzne dla konkretnych zadań (na przykład
ai_classify,ai_summarize,ai_translate) wykonują wnioskowanie w bezserwerowej infrastrukturze GPU zarządzanej przez Databricks za pośrednictwem Model Serving. Nie wdrażasz tej infrastruktury, ale jej koszt jest naliczany dodatkowo do mocy obliczeniowej na potrzeby zapytań. -
ai_queryjest rozliczany za określony przez Ciebie punkt końcowy obsługi modelu. Punkty końcowe modelu bazowego hostowane w Databricks są rozliczane podobnie jak funkcje specyficzne dla zadań; niestandardowe modele i punkty docelowe przepustowości działają na własnym, dedykowanym obliczeniu obsługującym i są odpowiednio rozliczane. -
ai_forecast,ai_detect_anomalies,ai_predict_class,ai_predict_valueiai_top_driversdziałają całkowicie na mocy obliczeniowej, z której je uruchamiasz, bez oddzielnych kosztów inferencji. -
vector_searchwysyła zapytania do twojego indeksu AI Search za pośrednictwem usługi AI Search zarządzanej przez Databricks.
Koszty wnioskowania funkcji AI są zapisywane w system.billing.usage tabeli pod jednym z dwóch produktów:
-
ai_similarity,ai_fix_grammar,ai_mask,MODEL_SERVING,BATCH_INFERENCEorazai_translatesą rejestrowane dla produktuai_summarizeo typie ofertyai_analyze_sentiment. - Inne specyficzne dla zadań funkcje AI, które generują osobne koszty wnioskowania, są rejestrowane pod produktem
AI_FUNCTIONS, w tymai_classify,ai_extract,ai_parse_document, orazai_search.
Wyświetlanie kosztów zadań wnioskowania wsadowego
Poniższe przykłady pokazują, jak filtrować rekordy MODEL_SERVING według typu oferty BATCH_INFERENCE na podstawie zadania, compute, hurtowni SQL oraz potoków Lakeflow. Te rekordy obejmują ai_query obciążenia oraz funkcje specyficzne dla zadań, które są rejestrowane w MODEL_SERVING
Zobacz Monitorowanie kosztów serwowania modelu w celu zapoznania się z ogólnymi przykładami wyświetlania kosztów zadań wnioskowania wsadowego wykorzystujących funkcje sztucznej inteligencji.
Jobs
Poniższe zapytanie pokazuje, które zadania są używane do wnioskowania wsadowego przy użyciu tabeli systemów system.workflow.jobs. Zobacz Monitorowanie kosztów zadań i wydajności przy użyciu tabel systemowych.
SELECT *
FROM system.billing.usage u
  JOIN system.workflow.jobs x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.job_id = x.job_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Compute
Poniżej pokazano, które klastry są używane do wnioskowania wsadowego przy użyciu tabeli system.compute.clusters systems.
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Potoki deklaratywne platformy Spark w usłudze Lakeflow
Poniżej pokazano, które potoki Lakeflow są używane do inferencji wsadowej przy użyciu tabeli systemowej system.lakeflow.pipelines.
SELECT *
FROM system.billing.usage u
  JOIN system.lakeflow.pipelines x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.dlt_pipeline_id = x.pipeline_id
  WHERE u.usage_metadata.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
SQL Warehouse
Poniżej przedstawiono, które magazyny SQL są używane na potrzeby wnioskowania wsadowego za pomocą tabeli systems system.compute.warehouses.
SELECT *
FROM system.billing.usage u
  JOIN system.compute.clusters x
    ON u.workspace_id = x.workspace_id
    AND u.usage_metadata.cluster_id = x.cluster_id
  WHERE u.workspace_id = <workspace_id>
    AND u.billing_origin_product = "MODEL_SERVING"
    AND u.product_features.model_serving.offering_type = "BATCH_INFERENCE";
Zobacz koszty wpisane dla produktu AI_FUNCTIONS
Poniższy przykład pokazuje, jak wykonać zapytanie dotyczące kosztów zapisanych pod produktem AI_FUNCTIONS. Aby przefiltrować konkretną funkcję, użyj pola product_features.ai_functions.ai_function. Na przykład, aby zobaczyć tylko koszty ai_parse_document, dodaj AND u.product_features.ai_functions.ai_function = "AI_PARSE_DOCUMENT".
SELECT *
FROM system.billing.usage u
WHERE u.workspace_id = <workspace_id>
  AND u.billing_origin_product = "AI_FUNCTIONS";
Zobacz całkowity koszt funkcji AI według użytkownika
Aby obliczyć całkowity koszt wnioskowania funkcji AI, uwzględnij zużycie obu produktów. Następujące zapytanie zwraca miesięczny koszt cennikowy według użytkownika za bieżący miesiąc i poprzednie 12 miesięcy:
SELECT
  DATE_TRUNC('MONTH', u.usage_date)::DATE AS usage_month,
  COALESCE(
    u.identity_metadata.run_as,
    u.identity_metadata.run_by,
    'UNATTRIBUTED'
  ) AS principal,
  ROUND(
    SUM(u.usage_quantity * p.pricing.effective_list.default),
    2
  ) AS list_cost_usd
FROM system.billing.usage u
JOIN system.billing.list_prices p
  ON u.cloud = p.cloud
  AND u.sku_name = p.sku_name
  AND u.usage_unit = p.usage_unit
  AND u.usage_end_time >= p.price_start_time
  AND (p.price_end_time IS NULL OR u.usage_end_time < p.price_end_time)
WHERE p.currency_code = 'USD'
  AND u.usage_date >= ADD_MONTHS(DATE_TRUNC('MONTH', CURRENT_DATE()), -12)
  AND (
    (
      u.billing_origin_product = 'MODEL_SERVING'
      AND u.product_features.model_serving.offering_type = 'BATCH_INFERENCE'
    )
    OR u.billing_origin_product = 'AI_FUNCTIONS'
  )
GROUP BY 1, 2
ORDER BY 1 DESC, 3 DESC;